Concepts de base d'Ollama
Ollama est un framework d'apprentissage automatique localisé qui prend en charge plusieurs tâches de traitement du langage naturel (NLP), en se concentrant sur le chargement de modèles, l'inférence et les tâches de génération.
Avec Ollama, les utilisateurs peuvent interagir facilement avec de grands modèles pré-entraînés déployés localement.
1. Modèle
Dans Ollama, les modèles sont le composant central. Ce sont des modèles d'apprentissage automatique pré-entraînés qui peuvent effectuer différentes tâches, telles que la génération de texte, le résumé de texte, l'analyse de sentiments, la génération de dialogue, et plus encore.
Ollama prend en charge une variété de modèles pré-entraînés populaires. Les modèles courants incluent :
- deepseek-v3: Un grand modèle de langage fourni par DeepSeek, utilisé spécifiquement pour les tâches de génération de texte.
- LLama2: Un grand modèle de langage fourni par Meta, utilisé spécifiquement pour les tâches de génération de texte.
- GPT: Les modèles de la série GPT d'OpenAI, adaptés à un large éventail de tâches telles que la génération de dialogue et le raisonnement textuel.
- BERT: Modèles pré-entraînés utilisés pour la compréhension de phrases et les systèmes de questions-réponses.
- Autres modèles personnalisés: Les utilisateurs peuvent téléverser leurs propres modèles personnalisés et utiliser Ollama pour l'inférence.
Principales fonctions du modèle :
- Inférence: Génère des résultats de sortie en fonction des entrées de l'utilisateur.
- Ajustement fin: Les utilisateurs peuvent entraîner des modèles existants à l'aide de leurs propres données, personnalisant ainsi le modèle pour l'adapter à des tâches ou des domaines spécifiques.
Les modèles sont généralement des réseaux de neurones composés d'un grand nombre de paramètres. En s'entraînant sur de grandes quantités de données textuelles, ils peuvent apprendre des schémas linguistiques et effectuer une inférence efficace.
Les modèles pris en charge par Ollama sont accessibles à l'adresse :https://ollama.com/library
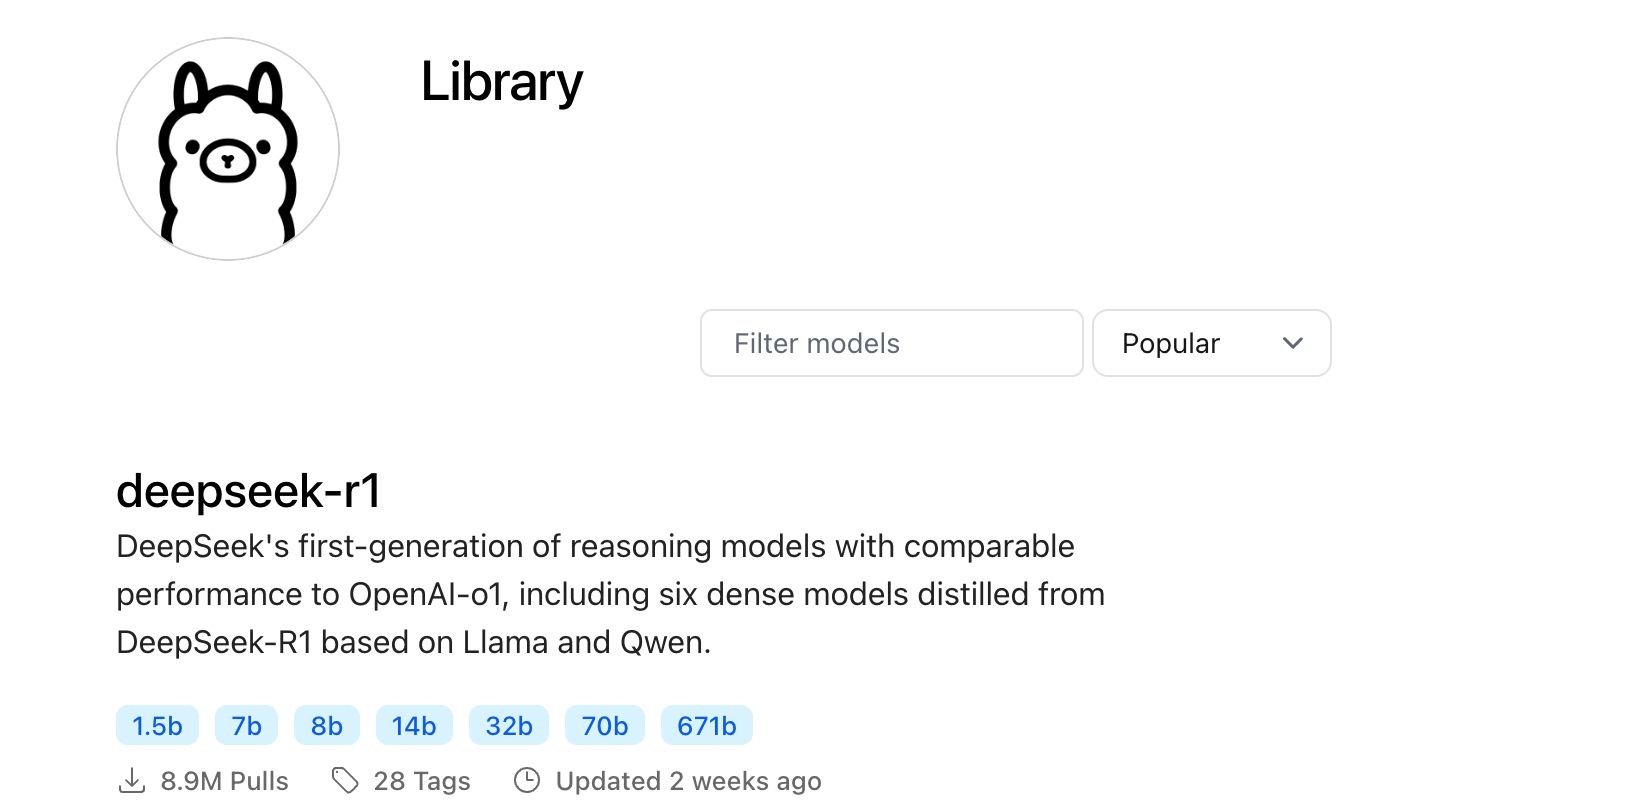
Cliquez sur un modèle pour afficher la commande de téléchargement :
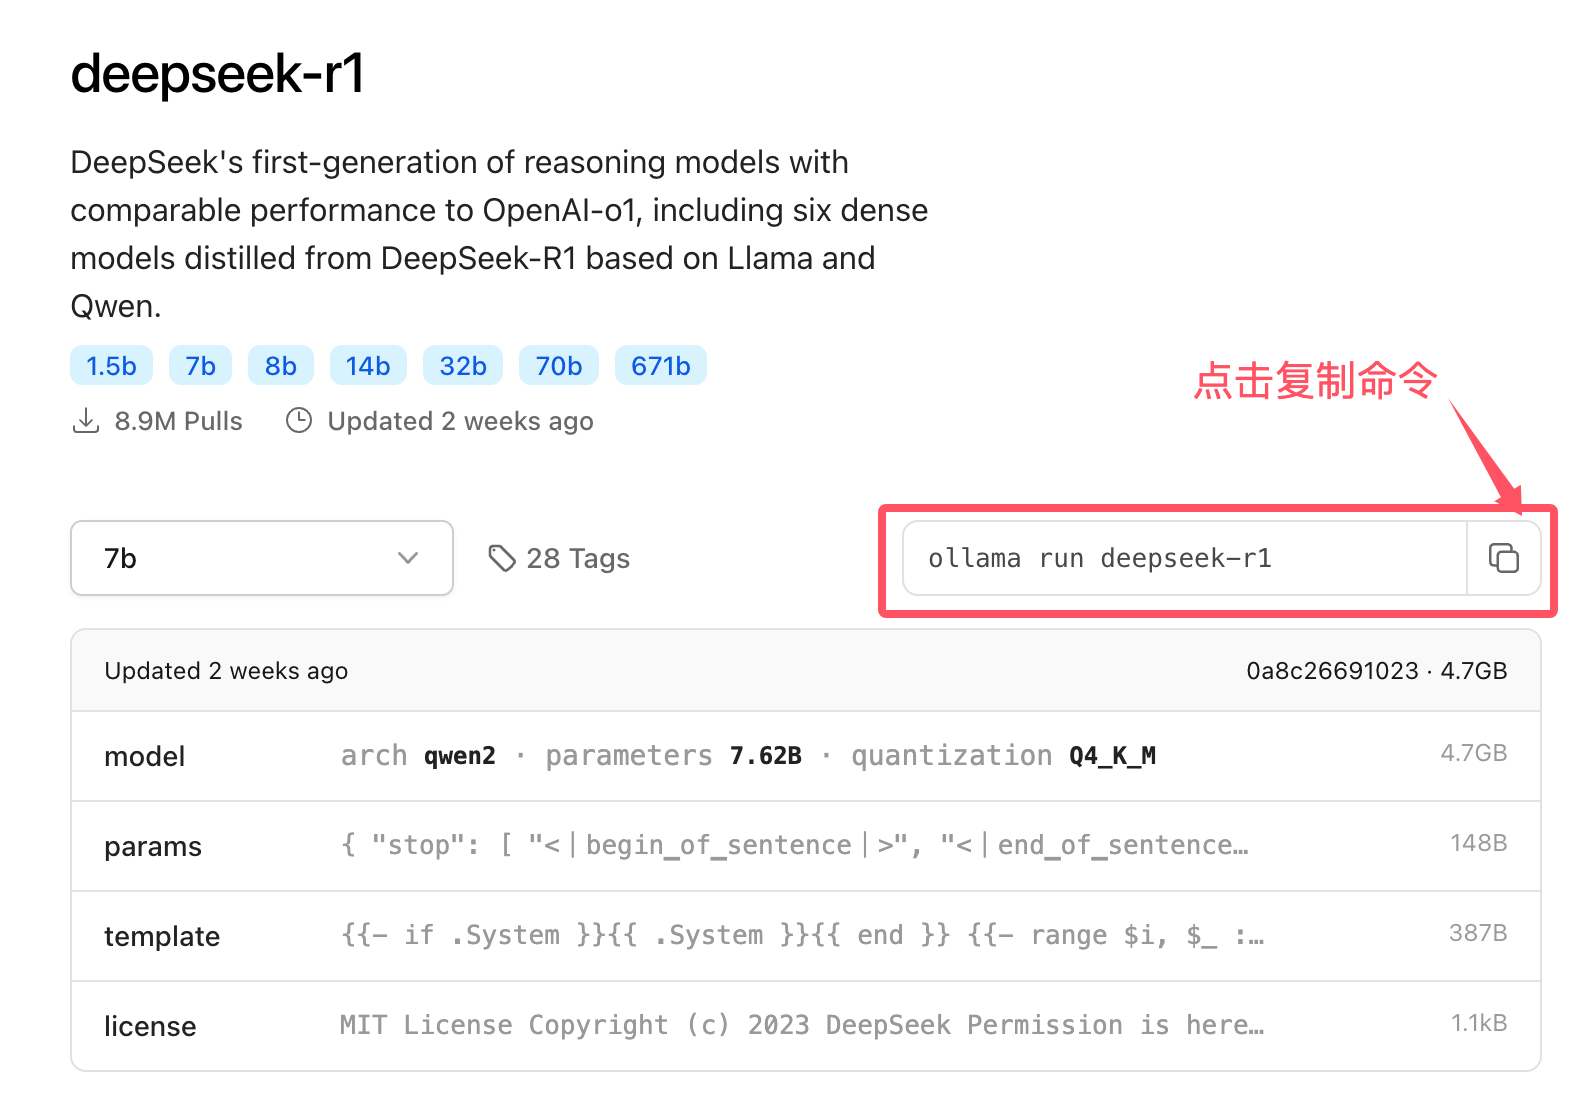
Le tableau suivant répertorie les commandes de téléchargement de certains modèles :
| Modèle | Parameters | Size | Commande de téléchargement |
|---|---|---|---|
| Llama 3.3 | 70B | 43GB | ollama run llama3.3 |
| Llama 3.2 | 3B | 2.0GB | ollama run llama3.2 |
| Llama 3.2 | 1B | 1.3GB | ollama run llama3.2:1b |
| Llama 3.2 Vision | 11B | 7.9GB | ollama run llama3.2-vision |
| Llama 3.2 Vision | 90B | 55GB | ollama run llama3.2-vision:90b |
| Llama 3.1 | 8B | 4.7GB | ollama run llama3.1 |
| Llama 3.1 | 405B | 231GB | ollama run llama3.1:405b |
| Phi 4 | 14B | 9.1GB | ollama run phi4 |
| Phi 3 Mini | 3.8B | 2.3GB | ollama run phi3 |
| Gemma 2 | 2B | 1.6GB | ollama run gemma2:2b |
| Gemma 2 | 9B | 5.5GB | ollama run gemma2 |
| Gemma 2 | 27B | 16GB | ollama run gemma2:27b |
| Mistral | 7B | 4.1GB | ollama run mistral |
| Moondream 2 | 1.4B | 829MB | ollama run moondream |
| Neural Chat | 7B | 4.1GB | ollama run neural-chat |
| Starling | 7B | 4.1GB | ollama run starling-lm |
| Code Llama | 7B | 3.8GB | ollama run codellama |
| Llama 2 Uncensored | 7B | 3.8GB | ollama run llama2-uncensored |
| LLaVA | 7B | 4.5GB | ollama run llava |
| Solar | 10.7B | 6.1GB | ollama run solar |
2. Tâche
Ollama prend en charge une variété de tâches NLP. Chaque tâche correspond à différents scénarios d'application du modèle, notamment mais sans s'y limiter les suivants :
- Génération de conversation: Génère des réponses conversationnelles naturelles grâce à l'interaction avec les utilisateurs.
- Génération de texte: Génère du texte en langage naturel à partir d'un prompt donné, comme la rédaction d'articles ou la génération d'histoires.
- Analyse de sentiment: Analyse le sentiment à l'égard d'un texte donné (par ex., positif, négatif, neutre).
- Résumé de texte: Compresse un texte long en un résumé concis.
- Traduction: Traduit le texte d'une langue vers une autre.
Grâce à l'outil en ligne de commande, les utilisateurs peuvent spécifier différentes tâches et charger différents modèles pour accomplir des tâches spécifiques.
3. Inférence
L'inférence désigne le processus de traitement d'une entrée sur un modèle entraîné et de génération d'une sortie.
Ollama fournit un outil en ligne de commande ou une API facile à utiliser, permettant aux utilisateurs de fournir rapidement une entrée au modèle et d'obtenir des résultats.
L'inférence est l'une des principales fonctions d'Ollama et constitue le cœur de l'interaction avec les modèles.
Processus d'inférence :
- Entrée: L'utilisateur fournit une entrée textuelle au modèle, qui peut être une question, une invite ou un contenu de conversation.
- Traitement du modèle: Le modèle utilise son réseau neuronal intégré pour générer une sortie appropriée en fonction de l'entrée.
- Sortie: Le modèle renvoie le contenu textuel généré, qui peut être une réponse, un article généré, un texte traduit, etc.
Ollama interagit avec les modèles locaux via API ou CLI, permettant aux utilisateurs de réaliser facilement des tâches d'inférence.
4. Réglage fin
Le réglage fin consiste à entraîner davantage un modèle pré-entraîné à partir de données propres à un domaine spécifique, afin que le modèle soit plus performant sur des tâches ou dans des domaines spécifiques.
Ollama prend en charge le réglage fin. Les utilisateurs peuvent utiliser leurs propres jeux de données pour affiner des modèles pré-entraînés afin de personnaliser la sortie du modèle.
Processus de réglage fin :
- Préparer le jeu de données: L'utilisateur prépare un jeu de données pour un domaine spécifique. Le format des données est généralement un fichier texte ou au format JSON.
- Charger un modèle pré-entraîné: Choisissez un modèle pré-entraîné adapté au fine-tuning, tel que Llama2 ou les modèles GPT.
- Entraîner: Entraînez le modèle à l'aide du jeu de données spécifique de l'utilisateur afin qu'il puisse mieux s'adapter à la tâche cible.
- Enregistrer et déployer: Une fois l'entraînement terminé, le modèle affiné peut être enregistré et déployé pour une utilisation future.
Le fine-tuning aide le modèle à devenir plus précis et plus efficace lorsqu'il traite des problèmes spécifiques à un domaine.
Autres extensions