Introduction à Ollama
Ollama est une plateforme open source de grands modèles de langage (LLM) qui permet aux utilisateurs d'exécuter, de gérer et d'interagir facilement avec de grands modèles de langage localement.
Ollama offre un moyen simple de charger et d'utiliser divers modèles de langage pré-entraînés, prenant en charge plusieurs tâches de traitement du langage naturel telles que la génération de texte, la traduction, l'écriture de code et la réponse aux questions.
La caractéristique d'Ollama est qu'il fournit non seulement des modèles et des ensembles d'outils prêts à l'emploi, mais aussi des interfaces et des API pratiques, ce qui permet de mettre rapidement en œuvre des tâches allant de la génération de texte et des systèmes de dialogue à l'analyse sémantique.
Contrairement à d'autres frameworks NLP, Ollama vise à simplifier les flux de travail des utilisateurs, faisant de l'apprentissage automatique un domaine qui n'est plus réservé aux développeurs ayant de solides compétences techniques.
Ollama prend en charge plusieurs options d'accélération matérielle, notamment l'inférence sur CPU pur et diverses architectures de calcul sous-jacentes (comme Apple Silicon), permettant une meilleure utilisation des différents types de ressources matérielles.
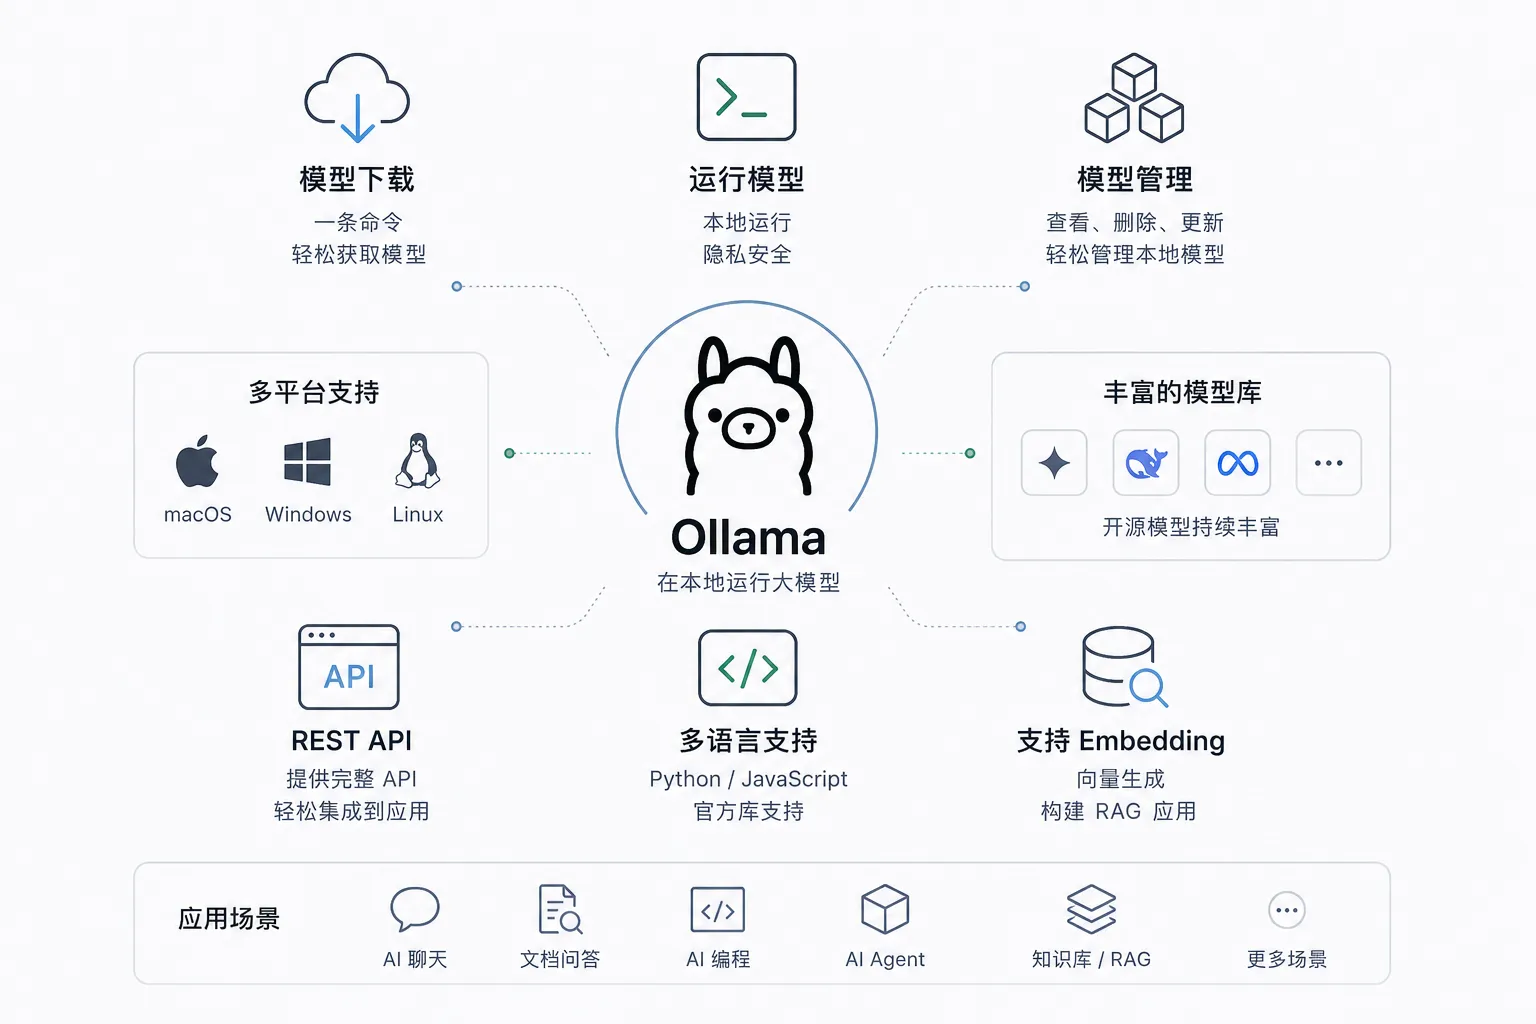
Ollama est un environnement d'exécution de modèles local composé de quatre parties.
| Composant | Description | Où |
|---|---|---|
| Outil en ligne de commande | Point d'entrée pour toutes les opérations quotidiennes telles que run, pull, list | La commande ollama dans le PATH système |
| Service en arrière-plan | S'exécute en permanence, est responsable du chargement et de l'inférence des modèles, et expose une API REST vers l'extérieur | Port local 11434 |
| Bibliothèque de modèles | Canaux de distribution officiels pour divers modèles open source, classés par tags de capacités | ollama.com/library |
| Stockage local | Poids et configurations des modèles téléchargés | Le dossier .ollama dans le répertoire utilisateur |
La nouvelle version fournit également deux points d'entrée plus conviviaux : taper directement ollama ouvre un menu interactif, et utiliser ollama launch connecte les modèles locaux à des outils tels que Claude Code et VS Code en un clic.
Fonctionnalités et caractéristiques principales
-
Prise en charge de plusieurs modèles de langage pré-entraînés
Ollama fournit une variété de modèles pré-entraînés prêts à l'emploi, notamment des modèles de langage de grande taille courants tels que GPT et BERT. Les utilisateurs peuvent facilement charger et utiliser ces modèles pour des tâches telles que la génération de texte, l'analyse de sentiments et la réponse aux questions. -
Intégration et utilisation faciles
Ollama fournit un outil en ligne de commande (CLI) et un SDK Python, ce qui simplifie l'intégration avec d'autres projets et services. Les développeurs n'ont pas à se soucier de dépendances ou de configurations complexes et peuvent intégrer rapidement Ollama dans des applications existantes. -
Déploiement local et utilisation hors ligne
Contrairement à certains services NLP basés sur le cloud, Ollama permet aux développeurs d'exécuter des modèles dans des environnements informatiques locaux. Cela signifie qu'il peut éliminer la dépendance à des serveurs externes, garantir la confidentialité des données et, pour les requêtes à forte concurrence, le déploiement hors ligne peut offrir une latence plus faible et une plus grande contrôlabilité. -
Prise en charge de l'affinage et de la personnalisation des modèles
Les utilisateurs peuvent non seulement utiliser les modèles pré-entraînés fournis par Ollama, mais aussi affiner des modèles sur cette base. Selon leurs besoins spécifiques, les développeurs peuvent réentraîner des modèles avec leurs propres données collectées afin d'optimiser les performances et la précision du modèle. -
Optimisation des performances
Ollama se concentre sur la performance, fournit un mécanisme d'inférence efficace, prend en charge le traitement par lots et gère efficacement la mémoire et les ressources de calcul. Cela lui permet de rester efficace lors du traitement de données à grande échelle. -
Prise en charge multiplateforme
Ollama prend en charge l'exécution sur plusieurs systèmes d'exploitation, notamment Windows, macOS et Linux. Cela garantit une expérience cohérente, que les développeurs déboguent dans un environnement local ou que les entreprises déploient en production. -
Open source et soutien de la communauté
Ollama est un projet open source, ce qui signifie que les développeurs peuvent consulter le code source, le modifier et l'optimiser, et contribuer au projet. De plus, Ollama dispose d'une communauté active, où les développeurs peuvent obtenir de l'aide et échanger des expériences avec d'autres.
Scénarios d'application
-
Création de contenu:
Aide les rédacteurs, journalistes et marketeurs à générer rapidement du contenu de haute qualité, comme des articles de blog, des textes publicitaires, et plus encore. -
Assistance à la programmation::
Aide les développeurs à générer du code, déboguer des programmes ou optimiser des structures de code. -
Éducation et recherche:
Assiste les étudiants et chercheurs dans l'apprentissage, la rédaction et la recherche, par exemple en générant des résumés d'articles ou en répondant à des questions. -
Communication interlangue:
Fournit des capacités de traduction de haute qualité pour aider les utilisateurs à franchir les barrières linguistiques. -
Assistant personnel:
Agit comme un assistant intelligent pour aider les utilisateurs à accomplir des tâches quotidiennes, comme rédiger des e-mails, générer des listes de tâches, et plus encore.
Pourquoi exécuter de grands modèles localement
L'exécution locale n'est pas une question de nostalgie ; elle repose sur quatre raisons solides.
Confidentialité: Les données ne quittent jamais l'appareil. Pour le contenu qui ne peut pas quitter la machine locale, comme les brouillons de contrat, les dossiers médicaux et le code privé, vous devez toujours peser les risques avant d'utiliser des API cloud, alors que l'inférence locale évite naturellement ce problème.
Coût: Pas de facturation par Token. Le téléchargement d'un modèle ne coûte qu'espace disque et électricité une fois, et le coût marginal tend vers zéro en usage intensif, ce qui est particulièrement adapté aux scénarios nécessitant un traitement par lots de texte.
Hors ligne: Aucune dépendance au réseau. Dans les environnements intranet, les salles serveurs ou les avions, tant que l'appareil est là, le modèle est là ; c'est une exigence absolue pour le déploiement sur site et les zones à mauvaise connectivité.
Contrôlabilité: Les versions et le comportement sont prévisibles. Les modèles locaux ne se mettent pas à jour en silence et ne modifient pas leur comportement ; les formats de sortie vérifiés aujourd'hui ne changeront pas demain. Pour les systèmes de production, cela compte plus que d'être « plus puissant ».
Bien sûr, pour être honnête : le plafond de capacités des modèles open source locaux est encore actuellement inférieur à celui des modèles phares du cloud. Choisir une solution locale, c'est viser « suffisamment bon, contrôlable et bon marché », pas « tout-puissant ».
Différences avec les API cloud et scénarios d'application
En mettant les deux approches côte à côte, les critères de sélection deviennent clairs.
| Dimension | Ollama en local | API cloud (OpenAI, Claude, etc.) |
|---|---|---|
| Emplacement des données | Ne quitte jamais la machine locale | Téléversé sur les serveurs du fournisseur |
| Source de calcul | Votre propre CPU / GPU | Centre de données du fournisseur |
| Modèle de coût | Téléchargement unique, utilisation gratuite | Facturation continue par Token |
| Puissance du modèle | Limité par le matériel local | Meilleurs modèles phares disponibles |
| Disponibilité hors ligne | Entièrement disponible | Indisponible |
| Coût de prise en main | Installer le logiciel une fois, configurer le matériel une fois | Prêt à l'emploi après inscription, mais il faut gérer les clés et les factures |
Les scénarios d'application deviennent également clairs : choisissez le local pour les appels sensibles à la confidentialité et à haute fréquence, les environnements hors ligne, ainsi que la validation d'apprentissage et de développement ; choisissez les API cloud lorsque vous avez besoin de capacités de modèles de premier ordre, d'un trafic élastique en rafale, ou que vous n'avez pas votre propre GPU.
Les deux ne sont pas ennemis ; les produits matures utilisent souvent une architecture hybride : les requêtes quotidiennes passent en local, et quelques tâches difficiles sont transmises au cloud.
Comparaison avec d'autres solutions locales
Exécuter des grands modèles localement ne se limite pas à Ollama ; chaque solution courante a son public.
| Solution | Positionnement | Facilité de prise en main | Public cible |
|---|---|---|---|
| Ollama | Un runtime qui exécute des modèles avec une seule commande + service API local | Faible | La plupart des développeurs, les équipes qui veulent une intégration rapide |
| llama.cpp | Le moteur d'inférence haute performance lui-même, avec de nombreux paramètres et un contrôle précis. | Élevée | Utilisateurs qui souhaitent approfondir les détails de l'inférence et personnaliser le déploiement |
| LM Studio | Une application de bureau dotée d'une interface graphique, avec navigation et téléchargement de modèles intégrés | Faible | Utilisateurs qui préfèrent une interface graphique et ne veulent pas utiliser la ligne de commande |
| vLLM | Un service d'inférence de qualité production à haut débit pour serveurs GPU | Élevée | Équipes disposant de services en ligne à forte concurrence et de ressources de calcul abondantes |
| GPT4All | Une application de bureau légère, axée sur la conversation avec des documents locaux | Faible | Utilisateurs ordinaires sans bagage technique |
Leur relation mérite d'être mentionnée : la capacité d'inférence sous-jacente d'Ollama provient de llama.cpp, qui peut être comprise comme un « wrapper facile à utiliser + orienté service + écosystème de bibliothèque de modèles » construit au-dessus de llama.cpp.
Ce tutoriel choisit Ollama comme fil conducteur en raison de son équilibre : commandes minimales, couverture complète de trois plateformes, et l'écosystème d'API et d'outils le plus complet. La comparaison est basée sur des informations publiques et l'état du projet en août 2026 ; toutes les solutions évoluent rapidement.
Modèles locaux vs Ollama Cloud
Les comparaisons précédentes portaient toutes sur « les clouds d'autres fournisseurs ». Ollama fournit lui-même aussi une solution cloud, ce qui complète les trois façons d'utiliser les grands modèles.

L'expérience d'utilisation d'Ollama Cloud est presque identique à celle en local : ajoutez le suffixe `:cloud` au nom du modèle, connectez-vous à votre compte et exécutez-le directement. Les commandes locales, les API et les intégrations d'outils fonctionnent telles quelles, sauf que l'inférence est transmise de manière transparente aux serveurs d'Ollama.
Exemples
ollama signin
# Exécutez des modèles cloud comme des modèles locaux, sans avoir besoin de télécharger les poids
ollama run qwen3.5:cloud
Sa valeur réside dans deux scénarios : les modèles ultra-grands que votre puissance de calcul locale ne peut pas gérer, et le fait de « tester si un modèle plus grand en vaut la peine » avant d'acheter un nouvel ordinateur.
Les modèles cloud disposent d'un mécanisme de retrait : l'équipe officielle retire périodiquement les anciens modèles cloud et annonce leurs remplaçants. Les workflows d'automatisation qui en dépendent doivent surveiller les annonces ; les modèles locaux restent sur votre disque pour toujours, sans être affectés. Ce sujet est entièrement traité dans le chapitre Déploiement hybride cloud.
Exigences matérielles et attentes
Une dernière chose : évaluez votre propre machine. Ollama est étonnamment indulgent concernant les exigences matérielles — il peut fonctionner uniquement sur un CPU pur, avec juste une différence d'un ordre de grandeur en vitesse.
Avec un GPU dédié (NVIDIA, AMD) ou une puce Apple Silicon, l'inférence est accélérée par GPU, et la vitesse de génération est généralement plusieurs à plusieurs dizaines de fois plus rapide qu'avec un CPU pur.
La taille de la fenêtre de contexte par défaut est automatiquement échelonnée par Ollama en fonction de la VRAM :
| Taille de la VRAM | Longueur de contexte par défaut |
|---|---|
| Moins de 24GiB | 4K |
| 24 ~ 48GiB | 32K |
| 48GiB et plus | 256K |
Regardez maintenant la correspondance attendue entre l'échelle des paramètres et l'appareil (en utilisant la famille qwen3.5 comme exemple) :https://ollama.com/library/qwen3.5):
| Spécifications du modèle | Taille du téléchargement | Configuration recommandée | Expérience attendue |
|---|---|---|---|
| qwen3.5:latest | Environ 6.6GB | 16GB de RAM ou 8GB de VRAM | Spécification par défaut, qualité et vitesse équilibrées |
| qwen3.5:0.8b | Environ 1.0GB | 8GB de RAM suffisent | Environnements de vérification, conversations légères |
| qwen3.5:4b | Environ 3.4GB | 16GB de RAM | Le juste équilibre pour un usage quotidien |
| qwen3.5:9b est équivalent à qwen3.5:latest | Environ 6.6GB | 16GB de RAM ou 8GB de VRAM | Spécification par défaut, qualité et vitesse équilibrées |
| qwen3.5:27b | Environ 17GB | 24GB de VRAM | Tâches exigeantes comme les documents longs et le code |
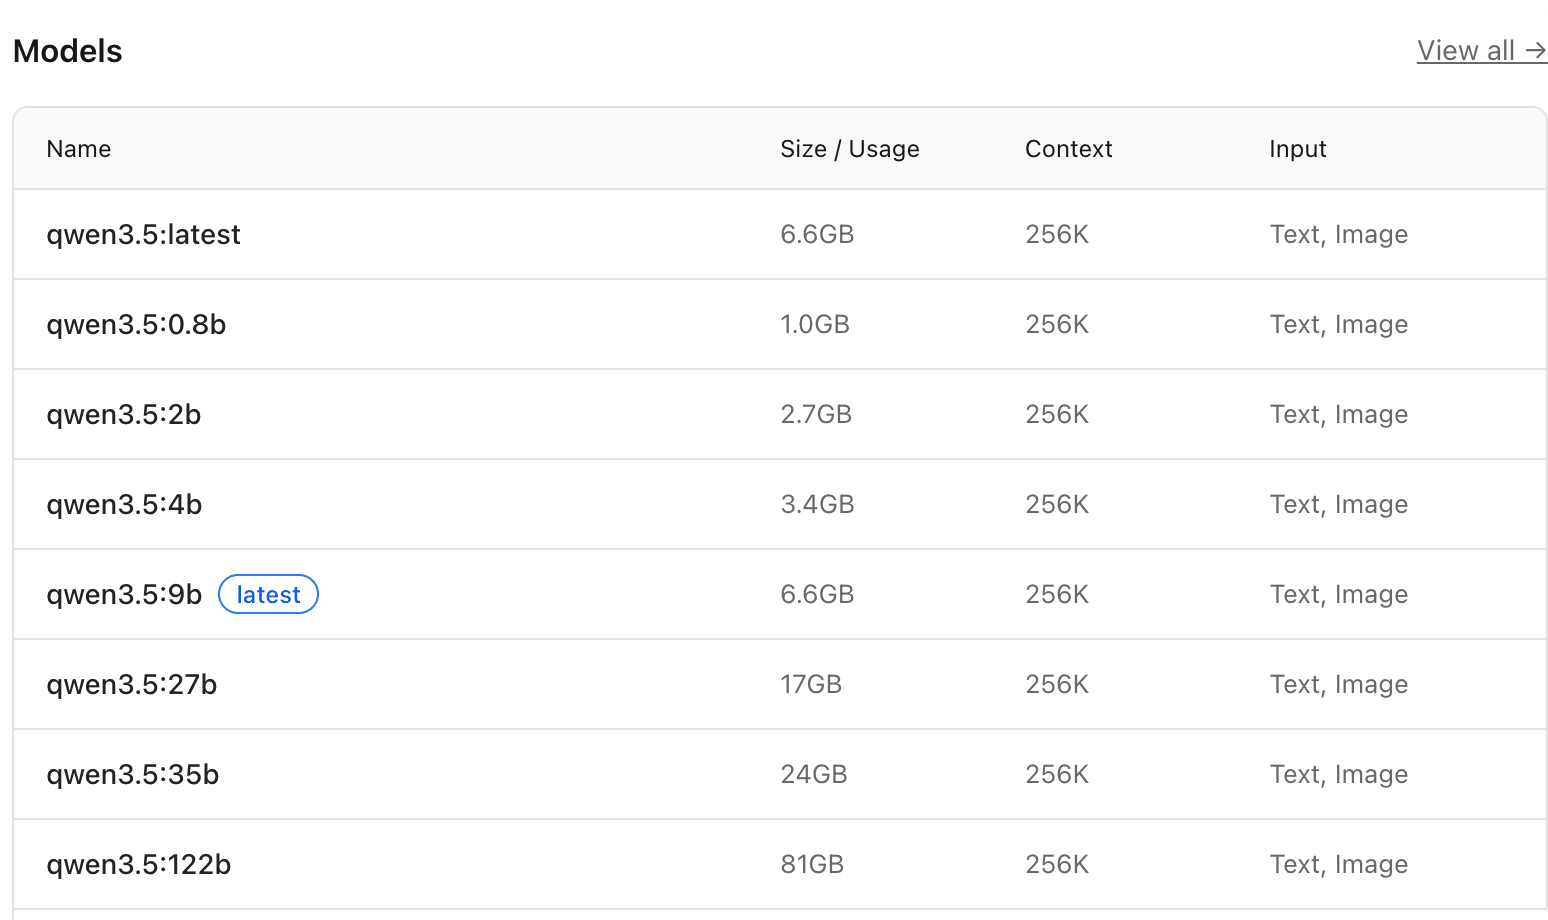
Une fois le modèle en cours d'exécution, utilisez la commandeollama pspour vérifier la colonne PROCESSOR et confirmer si le modèle s'exécute réellement entièrement sur le GPU. Cette étape de vérification sera utilisée de manière répétée dans le chapitre Gestion des modèles.
Autres extensionsNe vous découragez pas si votre configuration est vraiment limitée : la spécification 0.8b suffit pour exécuter la grande majorité des démos de commandes de ce tutoriel ; et lorsque vous avez réellement besoin d'un modèle plus grand, il existe la voie `:cloud` qui ne nécessite aucun matériel.