Outils Ollama et intégrations d'éditeurs
Ollama maintient un répertoire d'intégrations officiel : les agents de codage en terminal, les IDE courants, les assistants de bureau et les plateformes d'automatisation peuvent tous utiliser directement des modèles locaux.
Dans cette section, nous utiliseronsollama launchl'intégration en un clic, ou la configuration manuelle des variables d'environnement, pour brancher des modèles locaux dans votre chaîne d'outils quotidienne.
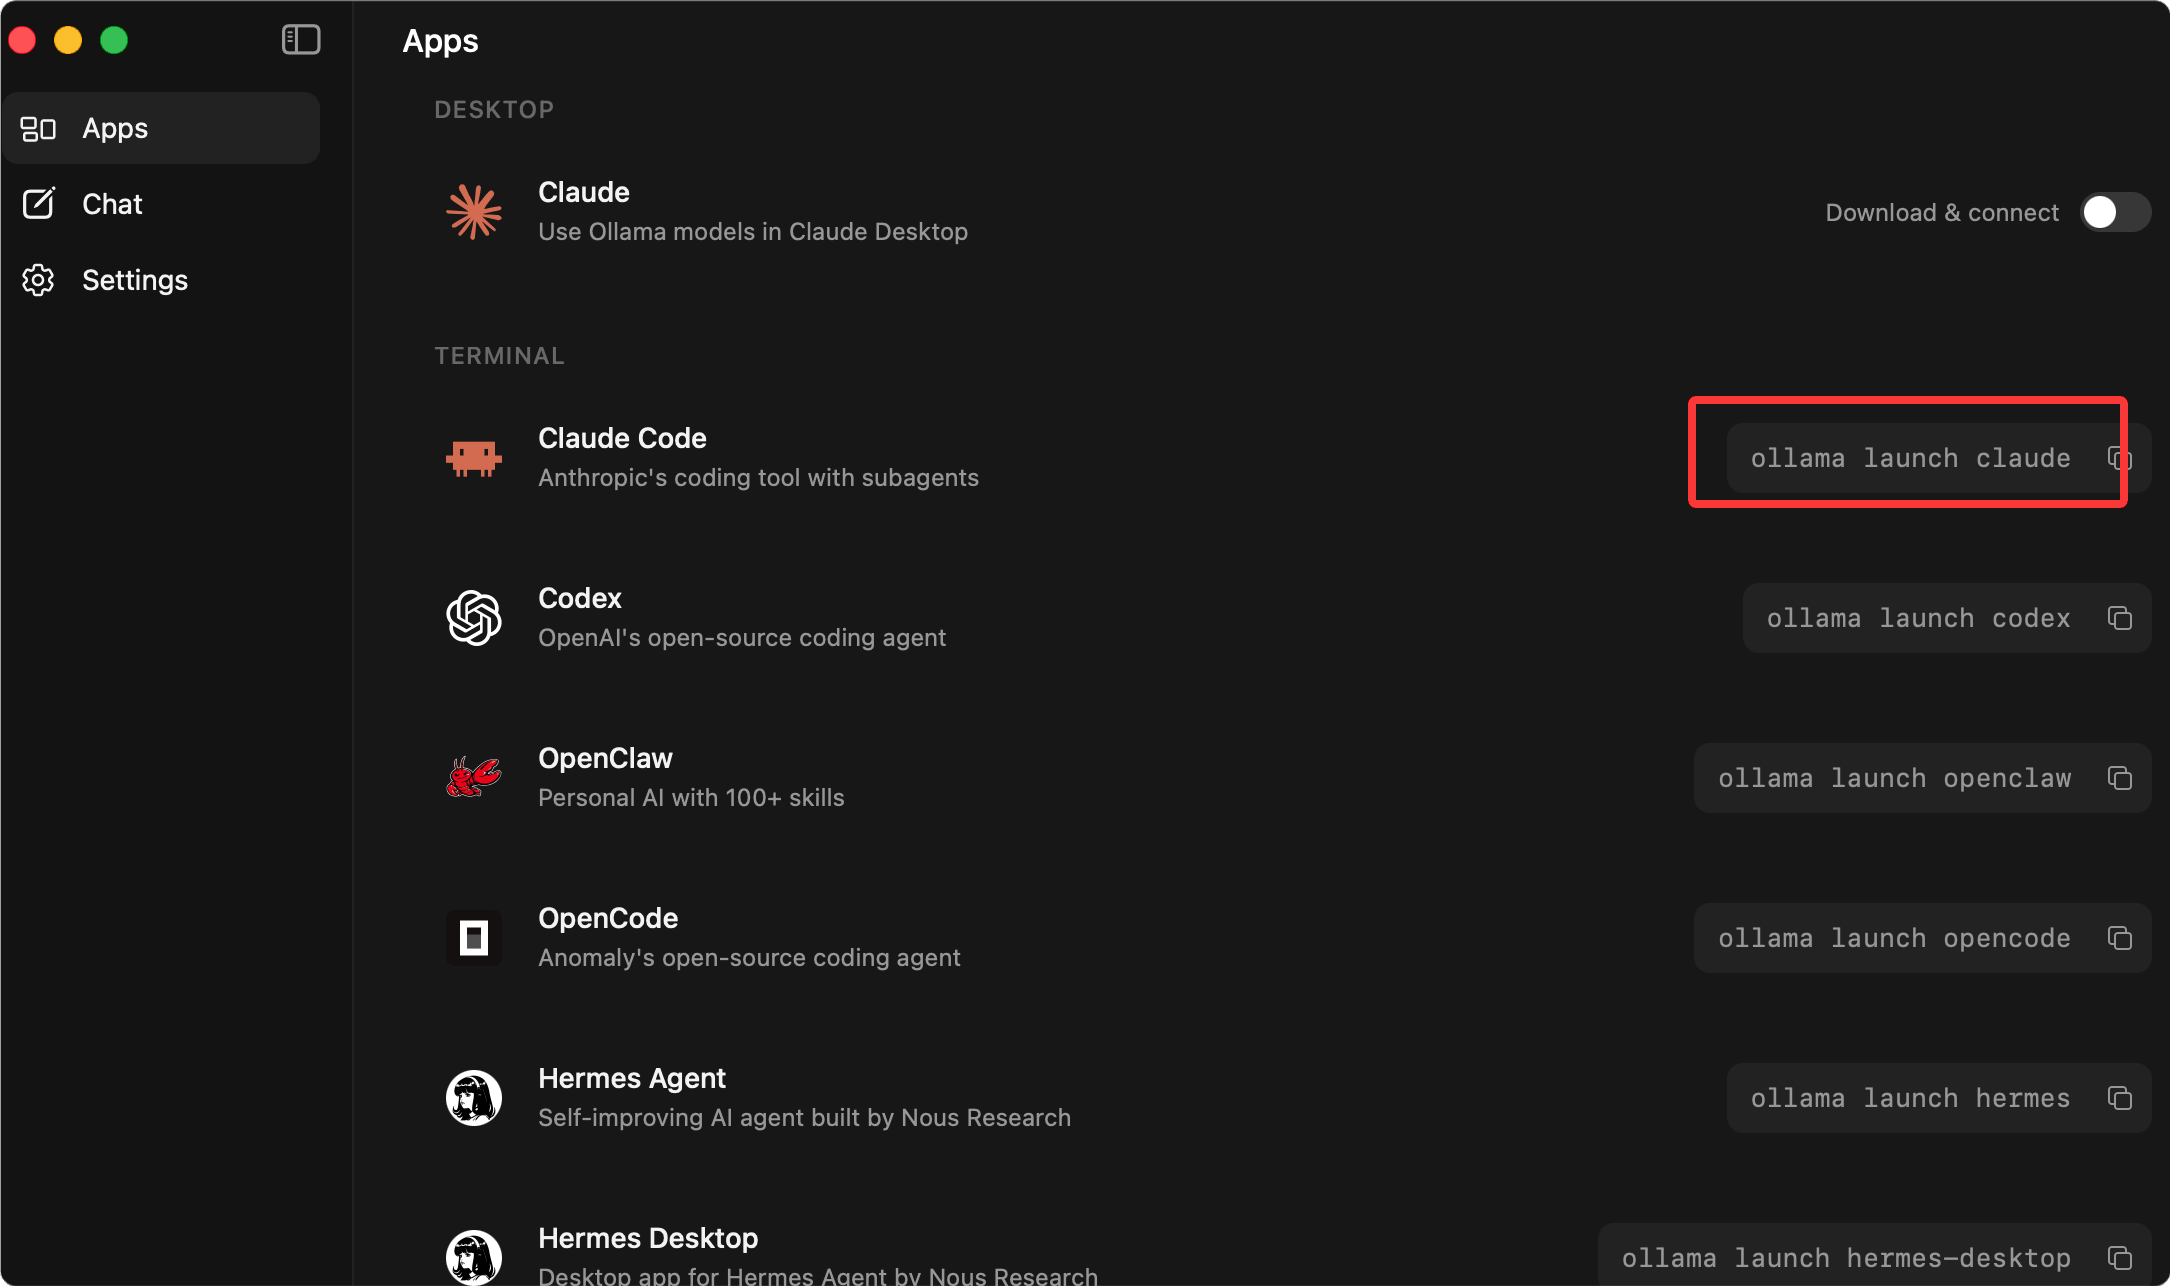
Aperçu de l'écosystème d'intégration
Les intégrations officielles sont divisées en trois catégories par cas d'usage, couvrant tout, du codage aux assistants quotidiens.

Toutes les intégrations suivent essentiellement le même chemin : pointer les requêtes de modèle de l'outil vers localhost:11434, ou vers des API compatibles OpenAI/Anthropic.
ollama launch: Intégration en un clic
launch est le point d'entrée unifié pour les intégrations, complétant interactivement quatre étapes: « sélectionner l'outil, sélectionner le modèle, écrire la configuration, démarrer. »
Exemple
ollama launch
# Démarrer directement une intégration spécifiée avec un modèle spécifié
ollama launch claude --model qwen3.5
# Générer uniquement la configuration, ne pas démarrer
ollama launch droid --config
Pour les scénarios non interactifs comme les scripts et la CI, utilisez --yes pour ignorer tous les sélecteurs ; le modèle doit être spécifié avec --model :
Exemple
# Les arguments après "--" sont transmis tels quels à Claude Code lui-même
ollama launch claude --model qwen3.5 --yes -- -p "Que fait ce dépôt ?"
Agents de codage en terminal
Les agents de codage en terminal constituent actuellement la catégorie d'intégration la plus active ; Ollama s'y connecte via le protocole de compatibilité de chaque fournisseur.
| Outil | Description |
|---|---|
| Claude Code | L'agent de codage d'Anthropic, connecté via l'API compatible avec Anthropic, prend en charge l'appel d'outils, les sous-tâches et la recherche web |
| OpenCode | Agent de codage open source ; modifie, exécute et itère sur le code |
| Codex | L'assistant de codage d'OpenAI, disponible à la fois en version CLI et en version de bureau |
| Copilot CLI | L'assistant de codage en ligne de commande de GitHub |
| Droid | Agent de codage IA par Factory |
| Goose | Agent d’automatisation open source avec prise en charge des extensions MCP |
| DeepSeek Harness | Framework d’agent open source de DeepSeek avec sous-tâches et recherche web |
| Cline CLI | Forme en ligne de commande de Cline |
Guide d’intégration de Claude Code
En utilisant le Claude Code le plus représentatif comme exemple, la méthode en un clic est la commande de lancement ci-dessus ; la configuration manuelle ne nécessite que deux variables d’environnement :
Exemple
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
# Démarrer avec n’importe quel modèle local
claude --model qwen3.5
Après intégration, le chat, l’édition de fichiers, l’exécution de commandes, l’entrée visuelle et la recherche web de Claude Code peuvent tous utiliser des modèles Ollama locaux ou cloud.
L'exigence stricte pour exécuter des agents de codage est la fenêtre de contexte : les sorties d'outils et les fichiers de code peuvent facilement atteindre des dizaines de milliers de tokens. La recommandation officielle est de définir le contexte au-dessus de 64K ; la dernière section de ce chapitre fournit la méthode de configuration.
IDE et éditeurs
Extension officielle VS Code
Ollama fournit une extension officielle pour VS Code, qui connecte les modèles locaux à VS Code Chat.
Effectuez l'intégration en trois étapes :
Étape 1 : installez l'extension Ollama depuis la place de marché ; elle découvre le service sur localhost:11434 par défaut.
Étape 2 : ouvrez le panneau Chat, trouvez la section Ollama dans le sélecteur de modèle sous la zone de saisie, puis choisissez un modèle.
Étape 3 : discutez et posez directement des questions ; les modèles locaux peuvent participer aux questions-réponses de codage.
Exemple
ollama pull qwen3.5
# Les modèles cloud nécessitent une connexion ; les modèles locaux ne nécessitent aucun compte
ollama signin
Si le modèle n'apparaît pas dans le sélecteur, dépannage dans l'ordre : confirmez qu'Ollama est en cours d'exécution, confirmez que ollama list affiche le modèle, exécutez Ollama: Refresh Models dans la palette de commandes, puis utilisez Ollama: Diagnose Models pour vérifier la sortie de diagnostic.
Autres éditeurs
| Outil | Form | Description |
|---|---|---|
| JetBrains | Plugin | Utiliser les modèles Ollama dans les IDE JetBrains IntelliJ |
| Cline / Roo Code | Plugin VS Code | Plugin de codage de style agent avec prise en charge des points de terminaison de modèles personnalisés |
| Zed | Configuration intégrée | Éditeur hautes performances avec prise en charge native des fournisseurs de modèles personnalisés |
| Xcode | Configuration intégrée | Outils de développement pour les plateformes Apple se connectant à des modèles locaux |
Assistants de bureau et automatisation
Les modèles locaux peuvent non seulement écrire du code, mais aussi servir d’assistants quotidiens et de moteurs d’automatisation.
| Outil | Rôle |
|---|---|
| Claude Desktop | Assistant de bureau Anthropic, prend en charge les modèles Ollama locaux et cloud |
| OpenClaw | Assistant personnel connecté aux applications de messagerie, gère les tâches quotidiennes |
| Hermes / Hermes Desktop | Agent open source avec compétences d'auto-amélioration et capacités de mémoire |
| n8n | Plateforme de workflow visuelle qui intègre Ollama dans les pipelines d'automatisation |
| Onyx | Plateforme de questions-réponses sur base de connaissances d'entreprise (scénarios RAG) |
| Marimo | Notebook Python réactif, les modèles peuvent être appelés dans les cellules |
Réglage du contexte pour les scénarios d'agent
Si un outil intégré est lent ou donne des réponses non pertinentes, il est probable que la fenêtre de contexte soit trop petite.
Le contenu web renvoyé par les outils, des fichiers de code entiers et l'historique d'agent multi-tours se disputent tous la fenêtre de contexte ; la valeur par défaut de 4K est loin d'être suffisante. La recommandation officielle est d'au moins 64,000 tokens pour la recherche web, les agents et les outils de codage.
Choisissez l'une des trois méthodes de configuration :
Exemple
# Méthode 2 : Définir globalement au démarrage du service
OLLAMA_CONTEXT_LENGTH=64000 ollama serve
# Méthode 3 : Intégrer dans un modèle dédié à l'aide d'un Modelfile
PARAMETER num_ctx 65536
Après l'avoir défini, vérifiez avec la colonne CONTEXT de ollama ps, puis consultez la colonne PROCESSOR pour confirmer que la VRAM peut toujours le contenir.
État de l'écosystème open source classique
Au-delà du répertoire d'intégration officiel, l'écosystème communautaire compte également un certain nombre de projets open source qui fonctionnent largement avec Ollama.
| Projet | Rôle | Status |
|---|---|---|
| LangChain / LlamaIndex | Framework de développement d'applications LLM avec des classes d'intégration Ollama intégrées | Maintenu par la communauté ; couramment utilisé pour le développement RAG |
| Open WebUI | Interface web auto-hébergée de type ChatGPT, connexion en un clic à Ollama local | Maintenu par la communauté ; couramment utilisé pour le partage au sein des équipes internes |
| Continue | Plugin d'assistant de codage IA open source | Maintenu par la communauté ; prend en charge les points de terminaison de modèles personnalisés |