Análisis completo de los marcos de aprendizaje profundo: de TensorFlow a la implementación de modelos
 Manual completo de comandos de Linux
Descripción general de los marcos de aprendizaje profundo
Los marcos de aprendizaje profundo son la piedra angular del desarrollo moderno de inteligencia artificial. Proporcionan un conjunto de herramientas e interfaces que permiten a los desarrolladores construir, entrenar e implementar modelos de redes neuronales de manera eficiente. Los marcos de aprendizaje profundo más populares incluyen:
- TensorFlow/Keras: Marco de nivel industrial desarrollado por Google, adecuado para entornos de producción
- PyTorch: Marco de investigación liderado por Facebook, con características destacadas de grafo computacional dinámico
- Biblioteca Transformers: Marco especializado en procesamiento de lenguaje natural lanzado por HuggingFace
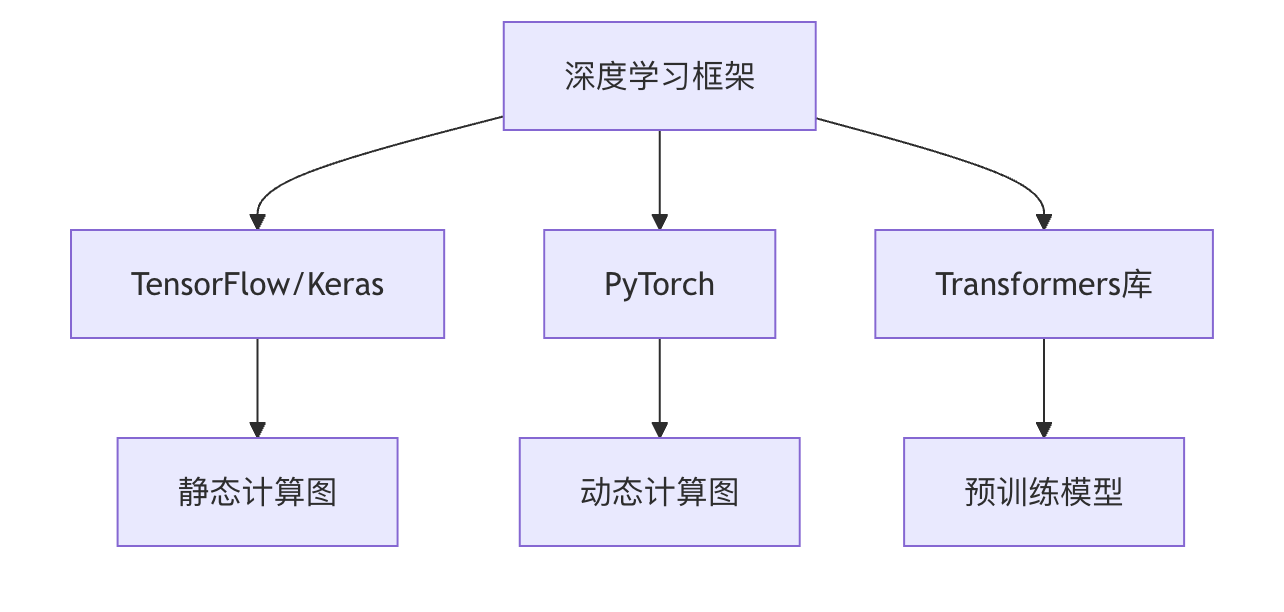
Explicación detallada de TensorFlow/Keras
Arquitectura principal
TensorFlow adopta un diseño en capas:
- API de frontend: Interfaces de lenguajes como Python, C++, etc.
- Grafo computacional: Representa las operaciones como un grafo acíclico dirigido (DAG)
- Entorno de ejecución distribuido: Ejecución en CPU/GPU/TPU
API de alto nivel de Keras
Keras, como la API de alto nivel oficial de TensorFlow, simplifica el proceso de construcción de modelos:
Ejemplo
from tensorflow.keras import layers
model = keras.Sequential([
layers.Dense(64, activation='relu', input_shape=(784,)),
layers.Dense(10, activation='softmax')
])
model.compile(optimizer='adam',
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
Comparación de características clave
| Característica | TensorFlow | Keras |
|---|---|---|
| Nivel de abstracción | Bajo nivel | Alto nivel |
| Facilidad de uso | Relativamente complejo | Simple |
| Flexibilidad | Alto | Media |
| Uso típico | Implementación en producción | Prototipado rápido |
Análisis profundo de PyTorch
Ventajas del grafo computacional dinámico
La característica principal de PyTorch es elgrafo computacional dinámico(Define-by-Run), lo que permite:
- Depuración más intuitiva (se pueden usar herramientas estándar de depuración de Python)
- La estructura de la red puede cambiar dinámicamente
- Más acorde con los hábitos de programación en Python
Ejemplo típico de construcción de modelos
Ejemplo
import torch.nn as nn
import torch.optim as optim
class Net(nn.Module):
def __init__(self):
super(Net, self).__init__()
self.fc1 = nn.Linear(784, 64)
self.fc2 = nn.Linear(64, 10)
def forward(self, x):
x = torch.relu(self.fc1(x))
x = torch.softmax(self.fc2(x), dim=1)
return x
model = Net()
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters())
Sistema de diferenciación automática
Principio de funcionamiento de la diferenciación automática en PyTorch:
- Registra el grafo de operaciones durante la propagación hacia adelante
- Calcula automáticamente los gradientes durante la propagación hacia atrás
- Mediante
.backward()se activa el cálculo de gradientes
Explicación especial de la biblioteca Transformers
Ecosistema de modelos preentrenados
HuggingFace Transformers ofrece una amplia variedad de modelos preentrenados:
- BERT (Google)
- GPT (OpenAI)
- RoBERTa (Facebook)
- T5 (Google)
Flujo de uso típico
Ejemplo
# Cargar el modelo preentrenado y el tokenizador
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
model = AutoModel.from_pretrained("bert-base-uncased")
# Procesamiento de texto
inputs = tokenizer("Hello world!", return_tensors="pt")
outputs = model(**inputs)
Modos de ajuste fino de modelos
Ejemplo
training_args = TrainingArguments(
output_dir='./results',
num_train_epochs=3,
per_device_train_batch_size=16
)
trainer = Trainer(
model=model,
args=training_args,
train_dataset=train_dataset
)
trainer.train()
Implementación y optimización de modelos
Comparación de opciones de implementación
| Opción | Escenario de aplicación | Cadena de herramientas |
|---|---|---|
| Servicio local | Aplicaciones internas de la empresa | Flask + ONNX |
| Implementación en la nube | Servicios de Internet | AWS SageMaker |
| Computación en el borde | Dispositivos IoT | TensorRT |
| Dispositivos móviles | Aplicaciones móviles | Core ML |
Técnicas de optimización de modelos
- **Cuantización (Quantization)**:
- Convertir FP32 a INT8
- Reduce el uso de memoria en un 75%
- Acelera la velocidad de inferencia
Ejemplo
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
**Poda (Pruning)**:
- Elimina conexiones neuronales no importantes
- Típicamente puede reducir los parámetros en un 60-90%
- Mantiene la precisión del modelo prácticamente sin cambios
Destilación de conocimiento:
- El modelo grande (teacher) guía al modelo pequeño (student)
- Conserva el conocimiento del modelo grande
- Reduce significativamente el tamaño del modelo
Guía de selección de marcos
Análisis de factores de decisión
Tipo de proyecto:
- Prototipo de investigación → PyTorch
- Sistema de producción → TensorFlow
- Tareas de NLP → Transformers
Habilidades del equipo:
- Dominio de Python → PyTorch
- Formación en Java/C++ → TensorFlow Serving
Entorno de hardware:
- TPU → TensorFlow
- Múltiples GPU → PyTorch Distributed
Recomendaciones de ruta de aprendizaje

Ejercicios prácticos
Ejercicio 1: Comparación de clasificación de imágenes
Implemente el mismo modelo CNN usando TensorFlow y PyTorch respectivamente, en el conjunto de datos CIFAR-10:
- Compare la complejidad del código
- Registre el tiempo de entrenamiento
- Pruebe la diferencia de precisión
Ejercicio 2: Conversión de modelos
Convierta un modelo de PyTorch a:
- Formato ONNX
- Formato TensorFlow Lite
- Compare la velocidad de inferencia antes y después de la conversión
Ejercicio 3: Práctica de optimización
Seleccione un modelo preentrenado:
- Aplique técnicas de cuantización
- Implemente la poda
- Mida los cambios en el tamaño del modelo y la velocidad de inferencia antes y después de la optimización
A través de este tutorial, ya debería haber dominado las características principales y los escenarios de aplicación de los marcos de aprendizaje profundo más populares. Se recomienda comenzar a aprender programación de aprendizaje profundo con PyTorch, y una vez que tenga una base sólida, expandirse a otros marcos según las necesidades del proyecto. Recuerde: los marcos son solo herramientas; el verdadero valor está en los problemas reales que resuelve con ellos.
Otras extensiones