TensorFlow-Beispiele – Regressionsprobleme
Was ist ein Regressionsproblem?
Regressionsprobleme sind eine wichtige Problemklasse im maschinellen Lernen, deren Ziel es ist, kontinuierliche Ausgabewerte vorherzusagen. Im Gegensatz zu Klassifikationsproblemen (Vorhersage diskreter Kategorien) sagen Regressionsprobleme numerische Werte innerhalb des Bereichs der reellen Zahlen voraus.
Häufige Beispiele für Regressionsprobleme
- Vorhersage von Hauspreisen: Preis anhand von Merkmalen wie Wohnfläche und Lage vorhersagen
- Aktienvorhersage: zukünftige Aktienkurse anhand historischer Daten vorhersagen
- Temperaturvorhersage: zukünftige Temperatur anhand meteorologischer Daten vorhersagen
Grundlegender Workflow zur Lösung von Regressionsproblemen mit TensorFlow
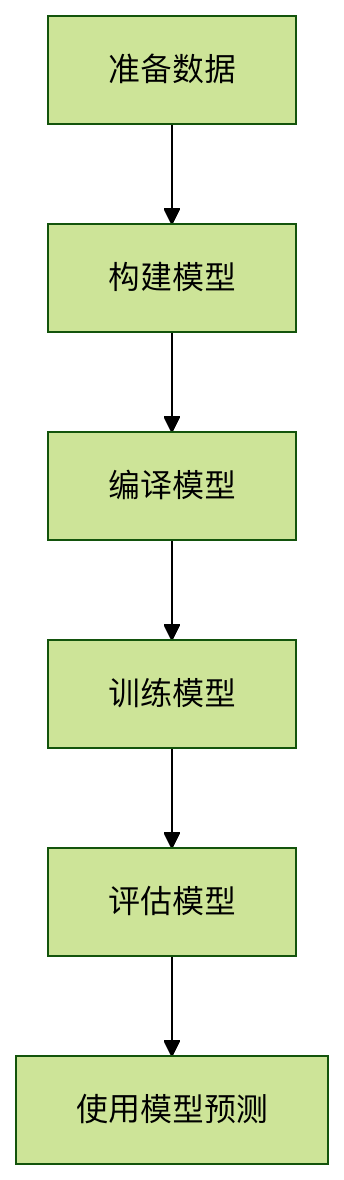
Praxis: Vorhersage der Boston-Hauspreise
1. Daten vorbereiten
Wir verwenden den klassischen Boston-Hauspreis-Datensatz, der 506 Beispiele enthält, jedes mit 13 Merkmalen:
Beispiel
from tensorflow.keras.datasets import boston_housing
# Daten laden
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Datenstandardisierung (wichtiger Schritt)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
# Daten laden
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Datenstandardisierung (wichtiger Schritt)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
2. Modell erstellen
Beispiel
from tensorflow.keras import models
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # Die Ausgabeschicht benötigt keine Aktivierungsfunktion
])
return model
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # Die Ausgabeschicht benötigt keine Aktivierungsfunktion
])
return model
Beschreibung der Modellstruktur
- Eingabeschicht: entspricht 13 Merkmalen
- Zwei verborgene Schichten: 64 Neuronen pro Schicht, mit ReLU-Aktivierungsfunktion
- Ausgabeschicht: 1 Neuron (Vorhersage des Hauspreises), ohne Aktivierungsfunktion
3. Modell kompilieren
Beispiel
model = build_model()
model.compile(optimizer='rmsprop',
loss='mse', # Mittlerer quadratischer Fehler
metrics=['mae']) # Mittlerer absoluter Fehler
model.compile(optimizer='rmsprop',
loss='mse', # Mittlerer quadratischer Fehler
metrics=['mae']) # Mittlerer absoluter Fehler
Beschreibung der Schlüsselparameter
- optimizer: Optimierer, steuert den Lernprozess
rmsprop: Standardwahl, geeignet für die meisten Probleme
- loss: Verlustfunktion, häufig in Regressionsproblemen verwendet
mse(Mittlerer quadratischer Fehler): Mittlerer quadratischer Fehler
- metrics: Evaluierungsmetrik
mae(Mittlerer absoluter Fehler): Mittlerer absoluter Fehler
4. Modell trainieren
Beispiel
history = model.fit(train_data, train_targets,
epochs=100,
batch_size=16,
validation_split=0.2)
epochs=100,
batch_size=16,
validation_split=0.2)
Parametererklärung
epochs: Anzahl der Trainingsepochenbatch_size: Batch-Größevalidation_split: Aufteilungsverhältnis für die Validierung
5. Das Modell bewerten
Beispiel
# Auf dem Testset auswerten
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"Testset-MAE: {test_mae_score}")
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"Testset-MAE: {test_mae_score}")
Die Evaluationsmetriken verstehen
- MAE (Mean Absolute Error): die durchschnittliche Differenz zwischen vorhergesagten und tatsächlichen Werten
- Zum Beispiel bedeutet MAE=2.5, dass die Vorhersage im Durchschnitt um $25,000 abweicht
- MSE (Mean Squared Error): bestraft größere Fehler stärker
6. Das Modell zur Vorhersage verwenden
Beispiel
# Vorhersagen für neue Daten treffen
sample = test_data[0] # Das erste Sample aus dem Testset nehmen
prediction = model.predict(sample.reshape(1, -1))
print(f"Vorhergesagter Preis: {prediction)
sample = test_data[0] # Das erste Sample aus dem Testset nehmen
prediction = model.predict(sample.reshape(1, -1))
print(f"Vorhergesagter Preis: {prediction)
Techniken zur Modelloptimierung
1. Die Netzwerkstruktur anpassen
Beispiel
# Ein tieferes Netzwerk kann besser abschneiden
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
2. K-fache Kreuzvalidierung verwenden
Beispiel
from sklearn.model_selection import KFold
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# In Trainings- und Validierungsmengen aufteilen
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Modell trainieren und evaluieren
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"Validierungs-MAE: {val_mae}")
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# In Trainings- und Validierungsmengen aufteilen
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Modell trainieren und evaluieren
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"Validierungs-MAE: {val_mae}")
3. Regularisierung hinzufügen, um Überanpassung zu verhindern
Beispiel
from tensorflow.keras import regularizers
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
Häufige Probleme und Lösungen
Problem 1: Die Modellleistung ist instabil
- Ursache: geringe Datenmenge oder Zufälligkeit bei der Initialisierung
- Lösung: Erhöhen Sie die Datenmenge oder verwenden Sie eine K-fache Kreuzvalidierung
Problem 2: Geringer Trainingsfehler, aber hoher Testfehler
- Ursache: Overfitting
- Lösung: Fügen Sie eine Dropout-Schicht oder L2-Regularisierung hinzu
Problem 3: Die vorhergesagten Werte weichen stark von den tatsächlichen Werten ab
- Ursache: Daten nicht normalisiert oder Netzwerkstruktur unangemessen
- Lösung: Überprüfen Sie die Schritte der Datenvorverarbeitung, passen Sie die Tiefe und Breite des Netzwerks an