Примеры TensorFlow — задачи регрессии
Что такое задача регрессии?
Задачи регрессии — важный класс задач в машинном обучении, цель которых — предсказывать непрерывные выходные значения. В отличие от задач классификации (предсказание дискретных категорий), задачи регрессии предсказывают числовые значения в диапазоне действительных чисел.
Распространённые примеры задач регрессии
- Прогнозирование цены дома: предсказать цену на основе таких признаков, как площадь дома и местоположение
- Прогнозирование акций: предсказать будущие цены акций на основе исторических данных
- Прогнозирование температуры: предсказать будущую температуру на основе метеорологических данных
Базовый рабочий процесс решения задач регрессии с помощью TensorFlow
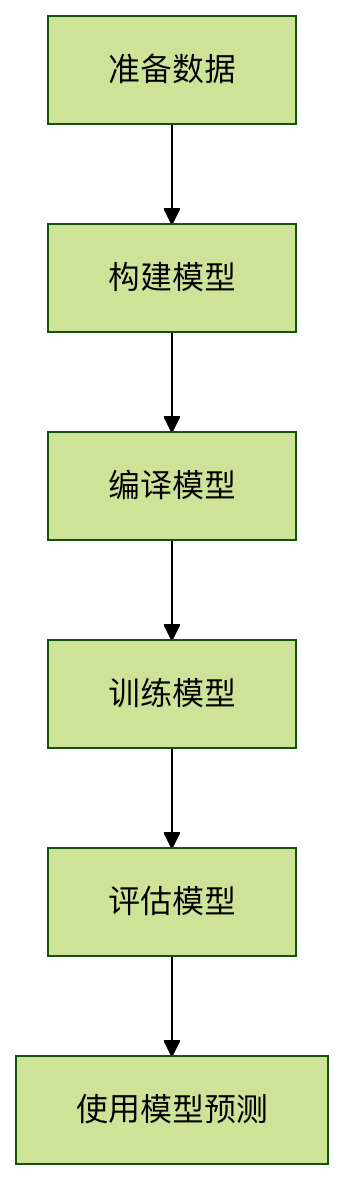
Практика: прогнозирование цен на жильё в Бостоне
1. Подготовьте данные
Мы будем использовать классический набор данных о ценах на жильё в Бостоне, который содержит 506 образцов, каждый с 13 признаками:
Пример
from tensorflow.keras.datasets import boston_housing
# Загрузить данные
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Стандартизация данных (важный шаг)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
# Загрузить данные
(train_data, train_targets), (test_data, test_targets) = boston_housing.load_data()
# Стандартизация данных (важный шаг)
mean = train_data.mean(axis=0)
train_data -= mean
std = train_data.std(axis=0)
train_data /= std
test_data -= mean
test_data /= std
2. Построение модели
Пример
from tensorflow.keras import models
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # Выходному слою не нужна функция активации
])
return model
from tensorflow.keras import layers
def build_model():
model = models.Sequential([
layers.Dense(64, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(1) # Выходному слою не нужна функция активации
])
return model
Описание структуры модели
- Входной слой: соответствует 13 признакам
- Два скрытых слоя: по 64 нейрона на слой, используется функция активации ReLU
- Выходной слой: 1 нейрон (предсказывает цену жилья), без функции активации
3. Скомпилировать модель
Пример
model = build_model()
model.compile(optimizer='rmsprop',
loss='mse', # Среднеквадратичная ошибка
metrics=['mae']) # Средняя абсолютная ошибка
model.compile(optimizer='rmsprop',
loss='mse', # Среднеквадратичная ошибка
metrics=['mae']) # Средняя абсолютная ошибка
Описание ключевых параметров
- optimizer: оптимизатор, управляет процессом обучения
rmsprop: выбор по умолчанию, подходящий для большинства задач
- loss: функция потерь, обычно используется в задачах регрессии
mse(Среднеквадратичная ошибка): Среднеквадратичная ошибка
- metrics: метрика оценки
mae(Средняя абсолютная ошибка): Средняя абсолютная ошибка
4. Обучите модель
Пример
history = model.fit(train_data, train_targets,
epochs=100,
batch_size=16,
validation_split=0.2)
epochs=100,
batch_size=16,
validation_split=0.2)
Пояснение параметров
epochs: количество эпох обученияbatch_size: размер пакетаvalidation_split: доля разбиения для валидации
5. Оценка модели
Пример
# Оценка на тестовом наборе
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"MAE на тестовом наборе: {test_mae_score}")
test_mse_score, test_mae_score = model.evaluate(test_data, test_targets)
print(f"MAE на тестовом наборе: {test_mae_score}")
Понимание метрик оценки
- MAE (средняя абсолютная ошибка): средняя разница между предсказанными и истинными значениями
- Например, MAE=2.5 означает, что предсказание отклоняется в среднем на $25,000
- MSE (средняя квадратичная ошибка): даёт больший штраф за большие ошибки
6. Использование модели для предсказания
Пример
# Сделать предсказания на новых данных
sample = test_data[0] # Возьмите первый образец из тестового набора
prediction = model.predict(sample.reshape(1, -1))
print(f"Предсказанная цена: {prediction)
sample = test_data[0] # Возьмите первый образец из тестового набора
prediction = model.predict(sample.reshape(1, -1))
print(f"Предсказанная цена: {prediction)
Методы оптимизации модели
1. Настройте структуру сети
Пример
# Более глубокая сеть может показать лучшие результаты
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
def build_deeper_model():
model = models.Sequential([
layers.Dense(128, activation='relu', input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu'),
layers.Dense(32, activation='relu'),
layers.Dense(1)
])
return model
2. Используйте K-кратную кросс-валидацию
Пример
from sklearn.model_selection import KFold
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# Разделение на обучающую и валидационную выборки
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Обучение и оценка модели
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"Validation MAE: {val_mae}")
k = 4
kf = KFold(n_splits=k)
for train_index, val_index in kf.split(train_data):
# Разделение на обучающую и валидационную выборки
partial_train_data = train_data[train_index]
partial_train_targets = train_targets[train_index]
val_data = train_data[val_index]
val_targets = train_targets[val_index]
# Обучение и оценка модели
model = build_model()
model.fit(partial_train_data, partial_train_targets,
epochs=100, batch_size=16, verbose=0)
val_mse, val_mae = model.evaluate(val_data, val_targets, verbose=0)
print(f"Validation MAE: {val_mae}")
3. Добавьте регуляризацию для предотвращения переобучения
Пример
from tensorflow.keras import regularizers
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
model = models.Sequential([
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001),
input_shape=(train_data.shape[1],)),
layers.Dense(64, activation='relu',
kernel_regularizer=regularizers.l2(0.001)),
layers.Dense(1)
])
Типичные проблемы и решения
Проблема 1: Производительность модели нестабильна
- Причина: небольшой объем данных или случайность при инициализации
- Решение: увеличьте объём данных или используйте K-кратную кросс-валидацию
Проблема 2: низкая ошибка обучения, но высокая ошибка тестирования
- Причина: переобучение
- Решение: добавьте слой Dropout или L2-регуляризацию
Проблема 3: предсказанные значения сильно отклоняются от фактических значений
- Причина: данные не стандартизированы или структура сети нерациональна
- Решение: проверьте этапы предварительной обработки данных, настройте глубину и ширину сети