API tf.data в TensorFlow
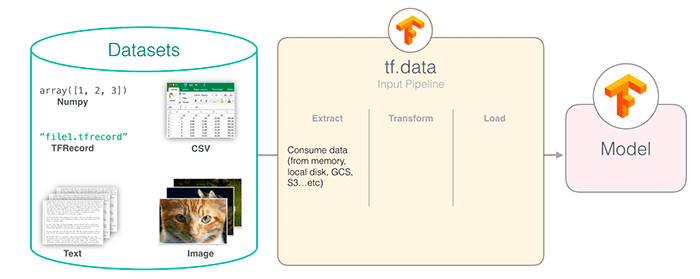
TensorFlow tf.data API — это эффективный инструмент построения конвейера ввода данных, предоставляемый TensorFlow и специально предназначенный для обработки крупномасштабных наборов данных.
tf.data API решает проблемы узких мест производительности традиционных методов загрузки данных, позволяя предварительной обработке данных и обучению модели выполняться параллельно.
Зачем нужен tf.data API
- Преимущества по производительности: в 10-100x раз быстрее традиционных методов
- Эффективность использования памяти: поддерживает потоковую обработку очень больших наборов данных
- Гибкость: составные операции преобразования данных
- Удобство использования: Чистый цепочечный интерфейс API
Основные концепции
Объект Dataset
Dataset — это основная абстракция API tf.data, представляющая последовательность элементов, где каждый элемент содержит один или несколько тензоров.
Три основных способа создать Dataset
1. Создание из данных в памяти
Пример
2. Создание из файлов
Пример
3. Создание из генераторов
Пример
for i in range(10):
yield i
dataset = tf.data.Dataset.from_generator(gen, output_types=tf.int32)
Операции преобразования данных
| Тип операции | Общие методы | Описание |
|---|---|---|
| Преобразование одного элемента | map, filter |
Обработка каждого элемента по отдельности |
| Преобразование нескольких элементов | batch, window |
Операции, затрагивающие несколько элементов |
| Глобальное преобразование | shuffle, repeat |
Влияет на поведение всего набора данных |
Подробное объяснение ключевых операций
1. Операция map
mapЭто наиболее часто используемая операция преобразования, используемая для применения пользовательских функций к каждому элементу.
Пример
dataset = dataset.map(lambda x: x**2)
# Типичное использование для обработки данных изображений
def process_image(image_path):
img = tf.io.read_file(image_path)
img = tf.image.decode_jpeg(img, channels=3)
img = tf.image.resize(img, [256, 256])
return img
image_dataset = image_dataset.map(process_image)
Лучшие практики:
- Используйте
num_parallel_callsпараметр для включения параллельной обработки - Для операций, интенсивно использующих CPU, установите
tf.data.experimental.AUTOTUNE
2. Пакетная операция
Объединяет несколько элементов в пакет.
Пример
batched_dataset = dataset.batch(32)
# Пакет с дополнением для последовательностей неравной длины
padded_batch = dataset.padded_batch(
32,
padded_shapes=([None], []),
padding_values=(0.0, 0)
)
3. Операция shuffle
Перемешивает порядок данных, что критически важно для обучения.
Пример
shuffled = dataset.shuffle(buffer_size=10000)
# Лучшая практика: buffer_size должен быть >= размера набора данных
full_shuffle = dataset.shuffle(buffer_size=len(dataset))
Советы по оптимизации производительности
Предварительная выборка
Совместите загрузку данных с выполнением модели:
Пример
Распараллеливание
Пример
process_func,
num_parallel_calls=tf.data.experimental.AUTOTUNE
)
Механизм кэширования
Пример
dataset = dataset.cache()
# Файловый кэш
dataset = dataset.cache(filename='/tmp/cache')
Полный пример
Конвейер данных для классификации изображений
Пример
dataset = tf.data.Dataset.list_files(file_pattern)
if is_training:
dataset = dataset.shuffle(10000)
dataset = dataset.map(
lambda x: load_and_preprocess_image(x),
num_parallel_calls=tf.data.experimental.AUTOTUNE
)
dataset = dataset.batch(batch_size)
if is_training:
dataset = dataset.repeat()
return dataset.prefetch(buffer_size=tf.data.experimental.AUTOTUNE)
def load_and_preprocess_image(path):
image = tf.io.read_file(path)
image = tf.image.decode_jpeg(image, channels=3)
image = tf.image.resize(image, [224, 224])
image = tf.cast(image, tf.float32) / 255.0 # Нормализация
return image
ЧАВО
Q1: Как обрабатывать очень большие наборы данных?
Решение:
- Используйте
tf.data.Dataset.list_filesдля создания файлового набора данных - Используйте чередующееся чтение (
interleave) для параллельной обработки нескольких файлов - Рассмотрите использование формата TFRecord для хранения данных
Вопрос 2: Почему мой конвейер данных работает медленно?
Шаги по устранению неполадок:
- Проверьте, используется ли prefetch (
prefetch) - Убедитесь, что для операции map установлен
num_parallel_calls - Проверьте, что buffer_size в shuffle достаточно велик
- Рассмотрите использование
tf.data.experimental.snapshotдля кэширования промежуточных результатов
Сводка лучших практик
- Раннее перемешивание: применяйте shuffle на раннем этапе конвейера данных
- Отложите батчинг: применяйте батчинг после применения map
- Используйте параллелизм: применяйте параллельные операции везде, где возможно
- Совмещайте выполнение: используйте prefetch, чтобы совместить загрузку данных и выполнение модели
- Кэшируйте разумно: кэшируйте данные, которые не меняются
Следуя этим принципам, вы можете создавать эффективные конвейеры ввода данных, полностью использовать вычислительную мощность GPU и значительно повысить эффективность обучения моделей.
Другие расширения