Советы по настройке модели TensorFlow
Настройка модели — важная часть рабочего процесса машинного обучения; она напрямую влияет на итоговую производительность модели. В TensorFlow мы можем использовать различные технические методы, чтобы повысить точность и способность модели к обобщению.
Почему необходима настройка модели
- Изначальные модели часто неидеальны: Первая обученная модель часто страдает от недообучения или переобучения
- Оптимизация использования ресурсов: Благодаря настройке можно достичь лучшей производительности при тех же вычислительных ресурсах
- Соответствие бизнес-требованиям: Разные сценарии применения предъявляют разные требования к моделям (например, точность против скорости)
1.2 Основные направления настройки
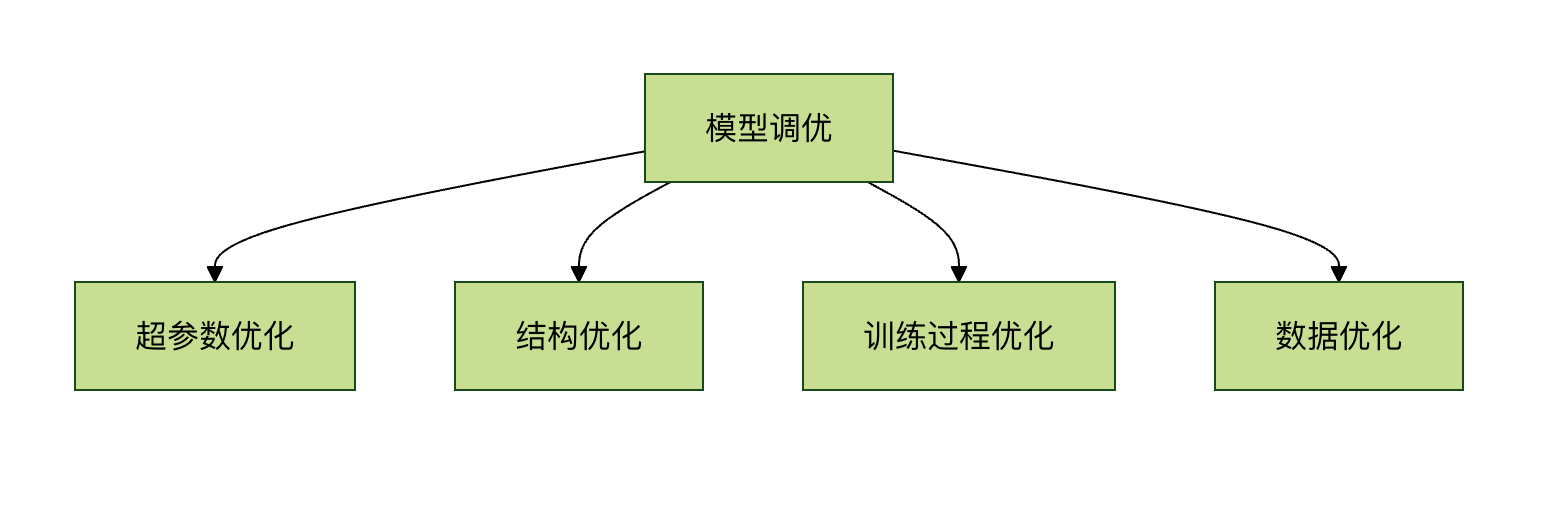
Методы настройки гиперпараметров
Настройка скорости обучения
Скорость обучения — один из наиболее критичных гиперпараметров, напрямую влияющий на скорость сходимости модели и итоговую производительность.
Настройка статической скорости обучения
Пример
optimizer = tf.keras.optimizers.Adam(learning_rate=0.001)
Стратегия динамической скорости обучения
Пример
initial_learning_rate = 0.1
lr_schedule = tf.keras.optimizers.schedules.ExponentialDecay(
initial_learning_rate,
decay_steps=10000,
decay_rate=0.96,
staircase=True)
optimizer = tf.keras.optimizers.SGD(learning_rate=lr_schedule)
Поиск скорости обучения
Пример
import keras_tuner as kt
def build_model(hp):
model = tf.keras.Sequential()
model.add(tf.keras.layers.Dense(10))
# Задайте диапазон поиска скорости обучения
hp_learning_rate = hp.Choice('learning_rate', values=[1e-2, 1e-3, 1e-4])
model.compile(optimizer=tf.keras.optimizers.Adam(learning_rate=hp_learning_rate),
loss='mse')
return model
tuner = kt.RandomSearch(build_model, objective='val_loss', max_trials=5)
Выбор размера батча
Размер батча влияет на стабильность обучения и использование памяти:
| Размер батча | Преимущества | Недостатки |
|---|---|---|
| Малый батч (16-64) | Быстрая сходимость, хорошая обобщающая способность | Нестабильное обучение |
| Средний батч (64-256) | Сбалансированный выбор | Требует больше памяти |
| Большой батч (256+) | Стабильное обучение | Может застрять в локальных оптимумах |
Оптимизация структуры модели
Настройка размера слоя и глубины
Методы настройки ширины
Пример
def build_model(hp):
model = tf.keras.Sequential()
# Поиск оптимального количества нейронов
hp_units = hp.Int('units', min_value=32, max_value=512, шаг=32)
model.add(tf.keras.layers.Dense(units=hp_units, activation='relu'))
model.add(tf.keras.layers.Dense(10))
model.compile(optimizer='adam', loss='mse')
return model
Стратегии настройки глубины
1. Начните с неглубокой сети и постепенно увеличивайте глубину.
2. Используйте остаточные соединения (ResNet) для решения проблемы исчезающего градиента в глубоких сетях.
Пример
def residual_block(x, filters):
сочетание клавиш = x
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Activation('relu')(x)
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Add()([shortcut, x])
return tf.keras.layers.Activation('relu')(x)
Методы регуляризации
Dropout
Пример
tf.keras.layers.Dense(128, activation='relu'),
tf.keras.layers.Dropout(0.5), # 50% нейронов будут случайно отключены
tf.keras.layers.Dense(10)
])
L1/L2-регуляризация
Пример
tf.keras.layers.Dense(64,
activation='relu',
kernel_regularizer=tf.keras.regularizers.l2(0.01))
Ранняя остановка
Пример
monitor='val_loss',
patience=5, # Остановить, если потеря на валидации не улучшается в течение 5 эпох подряд
restore_best_weights=True) # Восстановить лучшие веса
model.fit(x_train, y_train,
validation_data=(x_val, y_val),
epochs=100,
callbacks=[early_stopping])
Оптимизация процесса обучения
Аугментация данных
Пример
data_augmentation = tf.keras.Sequential([
tf.keras.layers.RandomFlip("horizontal"),
tf.keras.layers.RandomRotation(0.1),
tf.keras.layers.RandomZoom(0.1),
])
# Обучение с аугментированными данными
model.fit(data_augmentation(x_train), y_train, epochs=10)
Пакетная нормализация
Пример
tf.keras.layers.Dense(64),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('relu'),
tf.keras.layers.Dense(10)
])
Отсечение градиента
Пример
optimizer = tf.keras.optimizers.Adam(clipvalue=1.0)
Продвинутые методы настройки
Автоматизированная настройка гиперпараметров
Пример
tuner = kt.Hyperband(
build_model,
objective='val_accuracy',
max_epochs=10,
factor=3,
directory='my_dir',
project_name='intro_to_kt')
tuner.search(x_train, y_train, epochs=10, validation_data=(x_val, y_val))
best_model = tuner.get_best_models(num_models=1)[0]
Дистилляция модели
Пример
teacher = tf.keras.models.load_model('teacher_model.h5')
# Определение модели-студента
student = tf.keras.Sequential([...])
# Функция потерь дистилляции
def distillation_loss(y_true, y_pred, teacher_pred, temp=5.0):
return tf.keras.losses.kl_divergence(
tf.nn.softmax(teacher_pred/temp),
tf.nn.softmax(y_pred/temp))
Практические рекомендации по настройке
- Создайте базовый уровень: Сначала обучите простую модель в качестве базового уровня.
- Настраивайте один параметр за раз: Избегайте одновременного изменения нескольких параметров.
- Записывайте эксперименты: Используйте TensorBoard или MLflow для отслеживания экспериментов.
- Использование валидационной выборки: Убедитесь, что валидационная выборка отражает реальное распределение данных.
- Учитывайте вычислительные затраты: Балансируйте эффективность настройки и потребление ресурсов.
Пример
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir="./logs")
model.fit(x_train, y_train, epochs=10, callbacks=[tensorboard_callback])
Систематически применяя эти методы настройки, вы можете значительно улучшить производительность моделей TensorFlow. Помните, что настройка модели — это итеративный процесс, требующий терпения и тщательного планирования экспериментов.
Другие расширения