Производственная среда TensorFlow
Как ведущий отраслевой фреймворк машинного обучения, TensorFlow требует учёта множества факторов при переходе из экспериментальной среды в производственную.
В этой статье будут всесторонне рассмотрены ключевые аспекты использования TensorFlow в продакшен-среде, которые помогут разработчикам создавать стабильные и эффективные системы машинного обучения.
1. Оптимизация моделей
1.1 Квантование модели
Пример
# Пример квантования после обучения
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
import tensorflow as tf
converter = tf.lite.TFLiteConverter.from_saved_model(saved_model_dir)
converter.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_quant_model = converter.convert()
- 8-битное целочисленное квантование: уменьшает размер модели на 75%, повышает скорость инференса в 3-4 раза
- 16-битное квантование с плавающей запятой: повышение производительности на GPU, минимальная потеря точности
- Квантование динамического диапазона: квантует только веса, активации остаются с плавающей запятой во время инференса
1.2 Прореживание модели
Пример
# Прореживание с использованием TensorFlow Model Optimization Toolkit
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
pruning_params = {
'pruning_schedule': tfmot.sparsity.keras.PolynomialDecay(
initial_sparsity=0.50,
final_sparsity=0.90,
begin_step=0,
end_step=end_step)
}
model_for_pruning = tfmot.sparsity.keras.prune_low_magnitude(
original_model, **pruning_params)
- Удаляет связи нейронов, которые мало влияют на выходные данные
- Обычно сокращает количество параметров на 60% без существенного влияния на точность
- Требует тонкой настройки для восстановления части потерянной точности
1.3 Дистилляция моделей
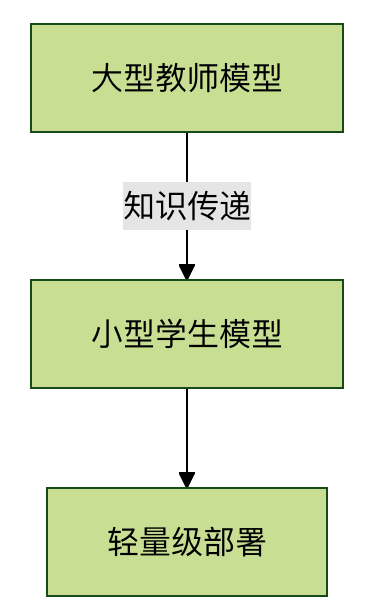
- Использует большую модель для управления обучением небольшой модели
- Сохраняет точность выше 90% при сокращении количества параметров на 90%
- Особенно подходит для сценариев развертывания на периферийных устройствах
2. Архитектура развертывания
2.1 Сравнение режимов обслуживания
| Метод развертывания | Задержка | Пропускная способность | Использование ресурсов | Применимые сценарии |
|---|---|---|---|---|
| TensorFlow Serving | Средняя | Высокая | Средняя | Облачные сервисы, высокая конкурентность |
| TFLite | Низкая | Средняя | Низкая | Мобильные/IoT-устройства |
| ONNX Runtime | Средняя | Высокая | Средняя | Единое развертывание в нескольких фреймворках |
| Собственный сервис gRPC | Настраиваемый | Настраиваемый | Настраиваемый | Сценарии с особыми требованиями |
2.2 Архитектура микросервисов
Пример
# Простой сервис модели на Flask
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
from flask import Flask, request
import tensorflow as tf
app = Flask(__name__)
model = tf.keras.models.load_model('path/to/model')
@app.route('/predict', methods=['POST'])
def predict():
data = request.json['data']
prediction = model.predict(data)
return {'prediction': prediction.tolist()}
- Контейнеризация: рекомендуется использовать Docker для упаковки модели и окружения
- Обнаружение сервисов: в сочетании с Kubernetes для автоматического масштабирования
- Интеграция мониторинга: система мониторинга Prometheus + Grafana
3. Оптимизация производительности
3.1 Аппаратное ускорение
Методы оптимизации GPU:
- Используйте
tf.config.optimizer.set_jit(True)Включите компиляцию XLA - Пакетная обработка входных данных (типичный размер батча 32-256)
- Используйте обучение со смешанной точностью (
tf.keras.mixed_precision)
Конфигурация TPU:
Пример
resolver = tf.distribute.cluster_resolver.TPUClusterResolver()
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
tf.config.experimental_connect_to_cluster(resolver)
tf.tpu.experimental.initialize_tpu_system(resolver)
strategy = tf.distribute.TPUStrategy(resolver)
3.2 Оптимизация графа
Пример
# Оптимизация конфигурации сессии
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
config = tf.compat.v1.ConfigProto()
config.graph_options.optimizer_options.global_jit_level = tf.compat.v1.OptimizerOptions.ON_1
config.gpu_options.allow_growth = True
session = tf.compat.v1.Session(config=config)
- Свёртка констант
- Слияние операций
- Удаление мёртвого кода
- Оптимизация памяти
4. Мониторинг и обслуживание
4.1 Ключевые метрики мониторинга
Системные метрики:
- Загрузка GPU/CPU
- Использование памяти
- Задержка запросов (P50/P90/P99)
Метрики модели:
- Распределение уверенности предсказаний
- Дрейф распределения входных данных
- Метрики деградации модели
4.2 Фреймворк A/B-тестирования
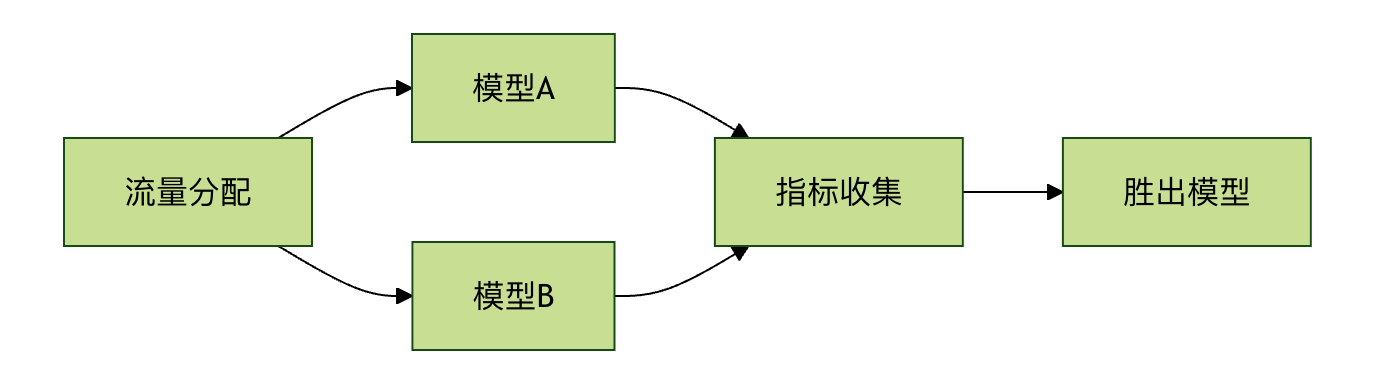
- Постепенное переключение трафика (5% → 50% → 100%)
- Многомерное сравнение метрик (бизнес-метрики + технические метрики)
- Механизм автоматического отката
5. Вопросы безопасности
5.1 Защита модели
- Используйте
tf.saved_model.saveЗашифрованные модели - Внедрите технологию водяных знаков для моделей
- Регулярно меняйте ключи развертывания
5.2 Проверка входных данных
Пример
# Пример проверки входных данных
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Входные данные должны быть массивом numpy")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Форма должна быть {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Входные данные содержат значения NaN")
def validate_input(input_data):
if not isinstance(input_data, np.ndarray):
raise ValueError("Входные данные должны быть массивом numpy")
if input_data.shape != EXPECTED_SHAPE:
raise ValueError(f"Форма должна быть {EXPECTED_SHAPE}")
if np.isnan(input_data).any():
raise ValueError("Входные данные содержат значения NaN")
- Проверка типов данных
- Проверка числового диапазона
- Фильтрация аномальных входных данных
6. Непрерывная интеграция и доставка
6.1 Проектирование ML-конвейера
Пример
# Простой конвейер, построенный с помощью TFX
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
from tfx.components import Trainer
from tfx.proto import trainer_pb2
trainer = Trainer(
module_file=module_file,
transformed_examples=transform.outputs['transformed_examples'],
schema=infer_schema.outputs['schema'],
train_args=trainer_pb2.TrainArgs(num_steps=10000),
eval_args=trainer_pb2.EvalArgs(num_steps=5000))
- Автоматизированное обучение модели
- Автоматизированная оценка модели
- Автоматизированное развертывание модели
6.2 Стратегия контроля версий
- Версия модели привязана к версии кода
- Сохранение снимков данных
- Полные записи экспериментов