R CSV ファイル
R は統計学の専門ツールとして、データのインポートとエクスポートを手動でしか行えないなら、その機能は意味をなしません。そのため R は、主流の表形式ストレージファイル(CSV、Excel、XML など)からデータを一括で取得することをサポートしています。
CSV テーブルデータの交換
CSV(Comma-Separated Values、CSV、区切り文字がカンマでなくてもよいため、文字区切り値とも呼ばれます)は、非常に人気のある表形式ストレージファイル形式であり、中規模または小規模のデータの保存に適しています。
ほとんどのソフトウェアがこのファイル形式をサポートしているため、データの保存と交換によく使用されます。
CSV は本質的にテキストであり、そのファイル形式は非常に単純です。データはテキストとして1行ずつ保存されるだけで、各レコードは区切り文字によってフィールドに分割され、各レコードは同じフィールドシーケンスを持ちます。
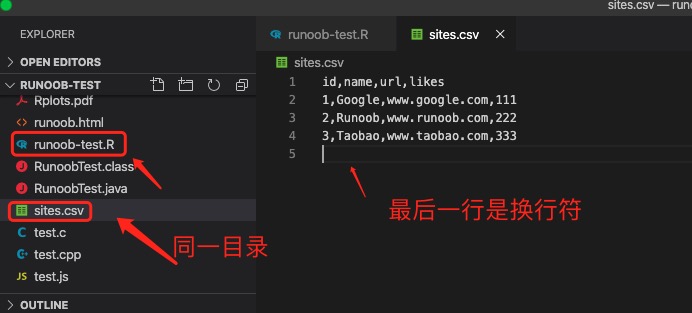
以下は簡単な sites.csv ファイルです(テストプログラムと同じディレクトリに格納されています):
id,name,url,likes
1,Google,www.google.com,111
2,サンプル,www.example.com,222
3,Taobao,www.taobao.com,333
CSV はカンマで列を分割します。データにカンマが含まれる場合は、データブロック全体をダブルクォーテーションで囲む必要があります。
注意:非英字の文字を含むテキストは、保存時のエンコーディングに注意してください。多くのコンピュータで UTF-8 エンコーディングが広く使用されているため、私は UTF-8 で保存しています。
注意:CSV ファイルの最後の行には空行を残す必要があります。そうしないと、プログラムの実行時に警告メッセージが表示されます。
Warning message:
In read.table(file = file, header = header, sep = sep, quote = quote,  :
  incomplete final line found by readTableHeader on 'sites.csv'
CSV ファイルの読み取り
次に、read.csv() 関数を使用して CSV ファイルのデータを読み取ることができます:
例
print(data)
encoding 属性を設定しない場合、read.csv 関数はデフォルトでオペレーティングシステムのデフォルト文字エンコーディングで読み取ります。Windows 中国語版システムを使用していて、システムのデフォルトエンコーディングを設定したことがない場合、システムのデフォルトエンコーディングは GBK です。そのため、エラーを防ぐために、できるだけ文字エンコーディングを統一してください。
上記のコードを実行すると、出力結果は次のとおりです:
  id   name            url likes
1  1 Google www.google.com   111
2  2 サンプル www.example.com   222
3  3 Taobao www.taobao.com   333
read.csv() 関数はデータフレームを返します。データの統計処理を簡単に行うことができます。次の例では、行数と列数を確認します:
例
print(is.data.frame(data)) # データフレームかどうかを確認
print(ncol(data)) # 列数
print(nrow(data)) # 行数
上記のコードを実行すると、出力結果は次のとおりです:
[1] TRUE
[1] 4
[1] 3
以下は、データフレーム内の likes フィールドが最大のデータを集計します:
例
# likes が最大のデータ
like <- max(data$likes)
print(like)
上記のコードを実行すると、出力結果は次のとおりです:
[1] 333
検索条件を指定することもできます。SQL の where 句のようにデータを照会できます。使用する関数はsubset()。
次の例では、likes が 222 のデータを検索します:
例
# likes が 222 のデータ
retval <- subset(data, likes == 222)
print(retval)
上記のコードを実行すると、出力結果は次のとおりです:
  id   name            url likes
2  2 サンプル www.example.com   222
注意:条件文では、等号は次を使用します==。
複数の条件では&区切り文字を使用します。次の例では、likes が 1 より大きく、name が サンプル のデータを検索します:
例
# likes が 1 より大きく name が サンプル のデータ
retval <- subset(data, likes > 1 & name=="サンプル")
print(retval)
上記のコードを実行すると、出力結果は次のとおりです:
  id   name            url likes
2  2 サンプル www.example.com   222
CSV ファイルとして保存
R 言語では、write.csv()関数を使用してデータを CSV ファイルとして保存できます。
上記の例に続いて、likes が 222 のデータを サンプル.csv ファイルに保存します:
例
# likes が 222 のデータ
retval <- subset(data, likes == 222)
# 新しいファイルに書き込む
write.csv(retval,"サンプル.csv")
newdata <- read.csv("サンプル.csv")
print(newdata)
上記のコードを実行すると、出力結果は次のとおりです:
 X id   name            url likes
1 2  2 サンプル www.example.com   222
X はデータセット newper に由来します。パラメータ row.names = FALSE でそれを削除できます:
例
# likes が 222 のデータ
retval <- subset(data, likes == 222)
# 新しいファイルに書き込む
write.csv(retval,"サンプル.csv", row.names = FALSE)
newdata <- read.csv("サンプル.csv")
print(newdata)
上記のコードを実行すると、出力結果は次のとおりです:
  id   name            url likes
1  2 サンプル www.example.com   222
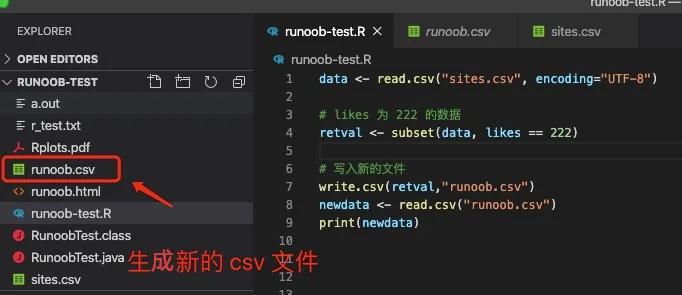
実行が完了すると、サンプル.csv ファイルが生成されたことを確認できます: