R CSV-Dateien
Als professionelles Statistikwerkzeug würde R bedeutungslos werden, wenn es Daten nur manuell importieren und exportieren könnte. Daher unterstützt R den stapelweisen Abruf von Daten aus Dateien gängiger tabellarischer Speicherformate (wie CSV, Excel, XML usw.).
Interaktion mit CSV-Tabellen
CSV (Comma-Separated Values, CSV, manchmal auch als zeichengetrennte Werte bezeichnet, da das Trennzeichen kein Komma sein muss) ist ein sehr beliebtes tabellarisches Speicherdateiformat, das sich zum Speichern kleiner oder mittelgroßer Daten eignet.
Da die meisten Softwareprogramme dieses Dateiformat unterstützen, wird es häufig zur Datenspeicherung und zum Datenaustausch verwendet.
CSV ist im Wesentlichen Text, und sein Dateiformat ist äußerst einfach: Daten werden Zeile für Zeile als Text gespeichert, jeder Datensatz wird durch Trennzeichen in Felder aufgeteilt, und jeder Datensatz hat die gleiche Feldreihenfolge.
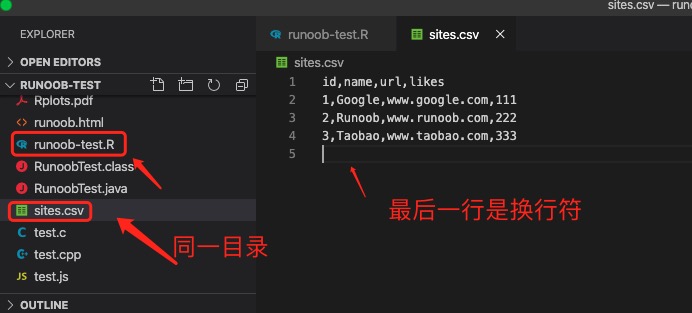
Das Folgende ist eine einfache sites.csv-Datei (im selben Verzeichnis wie das Testprogramm gespeichert):
id,name,url,likes
1,Google,www.google.com,111
2,Example,www.example.com,222
3,Taobao,www.taobao.com,333
CSV verwendet Kommas, um Spalten zu trennen. Wenn die Daten Kommas enthalten, muss der gesamte Datenblock in doppelte Anführungszeichen gesetzt werden.
Hinweis:Bei Text mit nicht-englischen Zeichen ist auf die gespeicherte Kodierung zu achten. Da viele Computer üblicherweise UTF-8-Kodierung verwenden, habe ich ihn mit UTF-8 gespeichert.
Hinweis:Die letzte Zeile der CSV-Datei muss eine leere Zeile behalten; andernfalls erzeugt das Programm eine Warnmeldung.
Warning message:
In read.table(file = file, header = header, sep = sep, quote = quote,  :
  incomplete final line found by readTableHeader on 'sites.csv'
CSV-Dateien lesen
Als Nächstes können wir die Funktion read.csv() verwenden, um Daten aus einer CSV-Datei zu lesen:
Beispiel
print(data)
Wenn das Attribut encoding nicht gesetzt ist, liest die Funktion read.csv mit der Standard-Textkodierung des Betriebssystems. Wenn Sie die chinesische Version von Windows verwenden und die Standardkodierung des Systems nicht festgelegt haben, sollte die Standardkodierung des Systems GBK sein. Versuchen Sie daher, die Textkodierung so weit wie möglich zu vereinheitlichen, um Fehler zu vermeiden.
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
  id   name            url likes
1  1 Google www.google.com   111
2  2 Example www.example.com   222
3  3 Taobao www.taobao.com   333
Die Funktion read.csv() gibt einen Data-Frame zurück, wodurch wir bequem statistische Verarbeitung mit den Daten durchführen können. Im folgenden Beispiel sehen wir uns die Anzahl der Zeilen und Spalten an:
Beispiel
print(is.data.frame(data)) # Prüfen, ob es sich um einen Data-Frame handelt
print(ncol(data)) # Anzahl der Spalten
print(nrow(data)) # Anzahl der Zeilen
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
[1] TRUE
[1] 4
[1] 3
Im Folgenden werden die Daten mit dem maximalen likes-Feld im Data Frame angezeigt:
Beispiel
# Daten mit den maximalen Likes
like <- max(data$likes)
print(like)
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
[1] 333
Wir können auch Suchbedingungen angeben, um Daten ähnlich der SQL-WHERE-Klausel abzufragen. Die zu verwendende Funktion istsubset()。
Das folgende Beispiel sucht Daten mit likes gleich 222:
Beispiel
# Daten mit likes gleich 222
retval <- subset(data, likes == 222)
print(retval)
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
  id   name            url likes
2  2 Example www.example.com   222
Hinweis: Bedingte Anweisungen verwenden gleich==。
Mehrere Bedingungen verwenden&als Trennzeichen. Das folgende Beispiel sucht Daten, bei denen likes größer als 1 ist und name gleich Example ist:
Beispiel
# Daten mit likes > 1 und name Example
retval <- subset(data, likes > 1 & name=="Example")
print(retval)
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
  id   name            url likes
2  2 Example www.example.com   222
Als CSV-Datei speichern
Die Sprache R kann diewrite.csv()-Funktion verwenden, um Daten als CSV-Datei zu speichern.
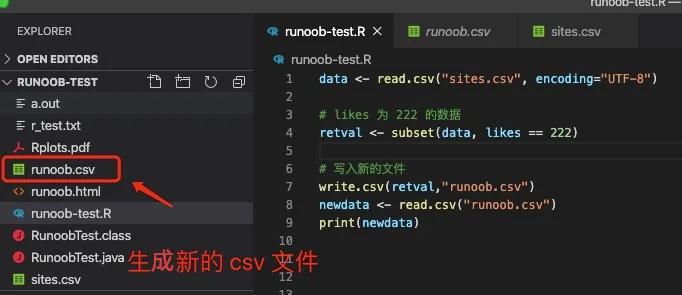
Im Anschluss an das obige Beispiel speichern wir die Daten mit likes gleich 222 in die Datei example.csv:
Beispiel
# Daten mit likes gleich 222
retval <- subset(data, likes == 222)
# In eine neue Datei schreiben
write.csv(retval,"example.csv")
newdata <- read.csv("example.csv")
print(newdata)
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
 X id   name            url likes
1 2  2 Example www.example.com   222
X stammt aus dem Datensatz newper, und es kann mit dem Parameter row.names = FALSE entfernt werden:
Beispiel
# Daten mit likes gleich 222
retval <- subset(data, likes == 222)
# In eine neue Datei schreiben
write.csv(retval,"example.csv", row.names = FALSE)
newdata <- read.csv("example.csv")
print(newdata)
Das Ausführen des obigen Codes erzeugt die folgende Ausgabe:
  id   name            url likes
1  2 Example www.example.com   222
Nach der Ausführung können wir sehen, dass die Datei example.csv erzeugt wird: