R データ型
データ型とは、異なる型の変数や関数を宣言するための広範なシステムのことです。
変数の型は、変数の格納に必要な領域と、格納されたビットパターンの解釈方法を決定します。
R言語の最も基本的なデータ型は主に3つあります:
- 数値
- 論理
- テキスト
数値定数には主に2種類あります:
| 一般型 | 123 -0.125 |
|---|---|
| 科学的記数法 | 1.23e2 -1.25E-1 |
論理型は、他の多くのプログラミング言語ではブール型(Boolean)と呼ばれることが多く、定数値は次のものだけです。TRUEとFALSE。
注意:R言語は大文字と小文字を区別するため、true や True は TRUE を表すことはできません。
最も直感的なデータ型はテキスト型です。テキストとは、他の言語でよく登場する文字列(String)であり、定数はダブルクォートで囲みます。R言語では、テキスト定数はシングルクォートでもダブルクォートでも囲むことができます。例:
例
[1] TRUE
R言語の変数の定義は、強い型付けの言語のような構文規則とは異なり、変数に名前とデータ型を明示的に設定する必要はありません。Rで代入演算子を使用するたびに、実際には新しい変数を定義しています:
例
b <- TRUE
b = "abc"
オブジェクト型で分類すると、以下の6種類になります(これらの型については後で詳しく説明します):
- ベクトル(vector)
- リスト(list)
- 行列(matrix)
- 配列(array)
- 因子(factor)
- データフレーム(data.frame)
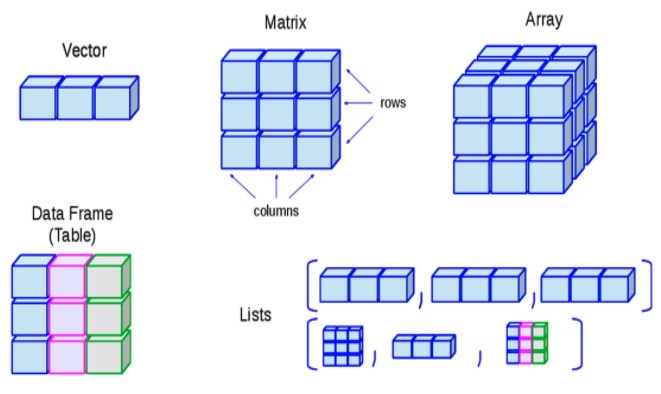
ベクトル
ベクトル(Vector)は、Java、Rust、C# など、プログラミング専用言語の標準ライブラリでよく提供されます。これは、ベクトルが数学演算において不可欠なツールだからです。最も一般的なベクトルは2次元ベクトルで、これは平面座標系で必ず使用されます。
ベクトルはデータ構造としては線形リストであり、配列とみなすことができます。
R言語ではベクトルが型として存在するため、ベクトルの操作がより簡単になります:
例
> b = c(5, 0)
> a + b
[1] 8 4
>
c()はベクトルを作成する関数です。
ここでは2つの2次元ベクトルを加算し、新しい2次元ベクトル (8, 4) を得ます。2次元ベクトルと3次元ベクトルを演算すると数学的な意味を失います。実行は停止しませんが、警告が出ます。
皆さんには、習慣としてこのような事態を避けることをお勧めします。
ベクトルの各要素は添え字(インデックス)で個別に取り出すことができます:
例
> a[2]
[1] 20
注意:R言語の「添え字」はオフセットを表すのではなく、「何番目」を表します。つまり、1から始まるのです!
Rではベクトルの一部を簡単に取り出すこともできます:
例
[1] 10 20 30 40
> a[c(1, 3, 5)] # 第1、3、5項を取り出す
[1] 10 30 50
> a[c(-1, -5)] # 第1項と第5項を除く
[1] 20 30 40
これら3つの部分取り出し方法が最も一般的です。
ベクトルはスカラー演算をサポートします:
例
[1] 0.6 0.7 0.8
> a = c(1,2)
> a ^ 2
[1] 1 4
前に説明した一般的な数学演算関数(sqrt、exp など)は、ベクトルに対するスカラー演算にも同様に使用できます。
「ベクトル」は線形リスト構造として、いくつかの一般的な線形リスト処理関数を備えているべきですが、Rは確かにこれらの関数を備えています:
ベクトルの並べ替え:
例
> sort(a)
[1] 1 2 3 4 5 6
> rev(a)
[1] 6 4 2 5 3 1
> order(a)
[1] 1 4 2 5 3 6
> a[order(a)]
[1] 1 2 3 4 5 6
order() 関数は、ベクトルを並べ替えた後の添え字ベクトルを返します。
ベクトルの統計
Rには非常に完全な統計関数があります:
| 関数名 | 意味 |
|---|---|
| sum | 合計 |
| mean | 平均 |
| var | 分散 |
| sd | 標準偏差 |
| min | 最小値 |
| max | 最大値 |
| range | 範囲(最小値と最大値) |
ベクトル統計の例:
例
[1] 15
> sd(1:5)
[1] 1.581139
> range(1:5)
[1] 1 5
ベクトルの生成
ベクトルの生成にはc()関数で生成でき、また min:max 演算子を使って連続したシーケンスを生成することもできます。
間隔のある等差数列を生成したい場合は、seq 関数を使用できます。 関数:
> seq(1, 9, 2)
[1] 1 3 5 7 9
seq は、m から n までの等差数列を生成することもできます。m、n、および数列の長さを指定するだけです:
> seq(0, 1, length.out=3)
[1] 0.0 0.5 1.0
rep は repeat(繰り返し)という意味で、繰り返し出現する数列を生成するために使用できます:
> rep(0, 5)
[1] 0 0 0 0 0
ベクトルでは NA と NULL がよく使われます。ここではこの2つの意味と違いを紹介します:
- NA は「欠損」を表し、NULL は「存在しない」ことを表します。
- NA の欠損はプレースホルダーのようなもので、ここには値がないが、位置は存在することを表します。
- NULL はデータが存在しないことを表します。
例で説明します:
例
[1] 2
> c(NA, NA, NULL, NA)
[1] NA NA NA
明らかに、NULL はベクトル内では何の意味も持ちません。
論理型
論理ベクトルは主にベクトルの論理演算に使用されます。例:
例
[1] FALSE FALSE TRUE
which 関数は非常に一般的な論理型ベクトル処理関数で、必要なデータの添え字をフィルタリングするために使用できます:
例
> b = a > 12
> print(b)
[1] FALSE FALSE TRUE
> which(b)
[1] 3
例えば、線形リストから60以上70未満のデータをフィルタリングする必要がある場合:
例
> print(vector[which(vector >= 60 & vector < 70)])
[1] 64 62 69
同様の関数として all と any があります:
例
[1] TRUE
> all(c(TRUE, TRUE, FALSE))
[1] FALSE
> any(c(TRUE, FALSE, FALSE))
[1] TRUE
> any(c(FALSE, FALSE, FALSE))
[1] FALSE
all() は論理ベクトルがすべて TRUE かどうかを確認するために使用し、any() は論理ベクトルに TRUE が含まれているかどうかを確認するために使用します。
文字列
文字列データ型自体は複雑ではありません。ここでは文字列の操作関数を中心に紹介します:
例
[1] "サンプル"
> tolower("サンプル") # 小文字に変換
[1] "サンプル"
> nchar("中文", type="bytes") # バイト長を取得
[1] 4
> nchar("中文", type="char") # 文字数をカウント
[1] 2
> substr("123456789", 1, 5) # 文字列を1から5まで切り出す
[1] "12345"
> substring("1234567890", 5) # 文字列を5から最後まで切り出す
[1] "567890"
> as.numeric("12") # 文字列を数値に変換
[1] 12
> as.character(12.34) # 数値を文字列に変換
[1] "12.34"
> strsplit("2019;10;1", ";") # 区切り文字で文字列を分割
[[1]]
[1] "2019" "10" "1"
> gsub("/", "-", "2019/10/1") # 文字列を置換
[1] "2019-10-1"
Windows コンピュータでは GBK エンコーディング標準が使用されるため、中国語の1文字は2バイトです。UTF-8 エンコーディングのコンピュータで実行する場合、中国語の1文字のバイト長は3になるはずです。
R は Perl 言語形式の正規表現をサポートしています:
例
[1] "$ $"
文字列の詳細については次を参照してください:R言語の文字列紹介。
行列
R言語は線形代数の研究のために行列型を提供しています。このデータ構造は他の言語の2次元配列によく似ていますが、Rは言語レベルの行列演算サポートを提供します。
まず行列の生成を見てみましょう:
例
> matrix(vector, 2, 3)
[,1] [,2] [,3]
[1,] 1 3 5
[2,] 2 4 6
行列の初期化内容はベクトルによって渡され、さらに行列が何行何列であるかを指定します。
ベクトルの値は行列に列ごとに格納されます。行ごとに格納するには、byrow 属性を指定する必要があります:
例
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 4 5 6
行列の各値は直接アクセスできます:
例
> m1[1,1] # 1行1列目
[1] 1
> m1[1,3] # 1行3列目
[1] 3
Rの行列では、各列と各行に名前を設定できます。この処理は文字列ベクトルを使って一括で行います:
例
> rownames(m1) = c("a", "b")
> m1
x y z
a 1 2 3
b 4 5 6
> m1["a", ]
x y z
1 2 3
行列の四則演算はベクトルとほぼ同じで、スカラーとの演算も、同じ規模の行列との対応する位置での演算も可能です。
行列の乗算:

例
> m2 = matrix(c(3, 4), 2, 1)
> m1 %*% m2
[,1]
[1,] 11
逆行列:

例
> solve(A)
[,1] [,2]
[1,] -2.0 1.0
[2,] 1.5 -0.5
solve()関数は線形代数方程式を解くために使用され、基本的な使い方はsolve(A,b)、ここで、Aは連立方程式の係数行列であり、b方程式のベクトルまたは行列です。
apply()関数は行列の各行または各列をベクトルとして操作できます:
例
[,1] [,2]
[1,] 1 2
[2,] 3 4
> apply(A, 1, sum) # 2番目のパラメータが1の場合は行ごとに操作し、sum() 関数を使用する
[1] 3 7
> apply(A, 2, sum) # 2番目のパラメータが2の場合は列ごとに操作する
[1] 4 6
マトリックスの詳細はこちらを参照:R 行列。
その他の拡張