Archivo CSV en R
R, como herramienta profesional de estadística, si solo pudiera importar y exportar datos manualmente, su funcionalidad no tendría sentido. Por lo tanto, R admite la obtención por lotes de datos desde formatos de archivo de almacenamiento tabular convencionales (por ejemplo, CSV, Excel, XML, etc.).
Intercambio de tablas CSV
CSV (Comma-Separated Values, CSV, a veces también llamado valores separados por caracteres, porque el carácter separador también puede no ser una coma) es un formato de archivo de almacenamiento de tablas muy popular. Este formato es adecuado para almacenar datos de escala pequeña o mediana.
Dado que la mayoría de los programas admiten este formato de archivo, se utiliza comúnmente para el almacenamiento e intercambio de datos.
CSV es esencialmente texto; su formato de archivo es extremadamente simple: los datos se guardan línea por línea como texto, cada registro se separa en campos mediante un delimitador, y cada registro tiene la misma secuencia de campos.
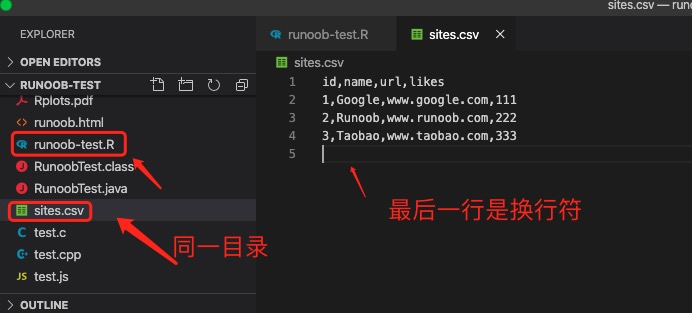
A continuación se muestra un archivo sites.csv simple (almacenado en el mismo directorio que el programa de prueba):
id,name,url,likes
1,Google,www.google.com,111
2,Ejemplo,www.example.com,222
3,Taobao,www.taobao.com,333
CSV usa comas para separar las columnas. Si los datos contienen comas, todo el bloque de datos debe encerrarse entre comillas dobles.
Nota:Para textos que contengan caracteres no ingleses, preste atención a la codificación al guardar. Dado que muchas computadoras usan comúnmente la codificación UTF-8, lo guardé usando UTF-8.
Nota:La última línea del archivo CSV debe conservar una línea vacía; de lo contrario, el programa mostrará una advertencia al ejecutarse.
Warning message:
In read.table(file = file, header = header, sep = sep, quote = quote,  :
  incomplete final line found by readTableHeader on 'sites.csv'
Leer archivo CSV
A continuación, podemos usar la función read.csv() para leer los datos del archivo CSV:
Ejemplo
print(data)
Si no se establece el atributo encoding, la función read.csv leerá por defecto con la codificación de texto predeterminada del sistema operativo. Si usa un sistema Windows en chino y no ha establecido la codificación predeterminada del sistema, la codificación predeterminada debería ser GBK. Por lo tanto, unifique la codificación de texto tanto como sea posible para evitar errores.
El resultado de ejecutar el código anterior es:
  id   name            url likes
1  1 Google www.google.com   111
2  2 Ejemplo www.example.com   222
3  3 Taobao www.taobao.com   333
La función read.csv() devuelve un data frame. Podemos realizar fácilmente el procesamiento estadístico de los datos. En el siguiente ejemplo, vemos el número de filas y columnas:
Ejemplo
print(is.data.frame(data)) # Verificar si es un data frame
print(ncol(data)) # Número de columnas
print(nrow(data)) # Número de filas
El resultado de ejecutar el código anterior es:
[1] TRUE
[1] 4
[1] 3
A continuación se obtienen los datos con el campo likes máximo en el data frame:
Ejemplo
# Datos con el mayor likes
like <- max(data$likes)
print(like)
El resultado de ejecutar el código anterior es:
[1] 333
También podemos especificar condiciones de búsqueda, consultando datos de manera similar a la cláusula WHERE de SQL. La función que se necesita es:subset()。
El siguiente ejemplo busca datos con likes igual a 222:
Ejemplo
# Datos con likes igual a 222
retval <- subset(data, likes == 222)
print(retval)
El resultado de ejecutar el código anterior es:
  id   name            url likes
2  2 Ejemplo www.example.com   222
Nota: la declaración de condición de igualdad usa==。
Para múltiples condiciones, use el&separador. El siguiente ejemplo busca datos donde likes sea mayor que 1 y name sea Ejemplo:
Ejemplo
# Datos donde likes es mayor que 1 y name es Ejemplo
retval <- subset(data, likes > 1 & name=="Ejemplo")
print(retval)
El resultado de ejecutar el código anterior es:
  id   name            url likes
2  2 Ejemplo www.example.com   222
Guardar como archivo CSV
El lenguaje R puede usar lawrite.csv()función para guardar datos como un archivo CSV.
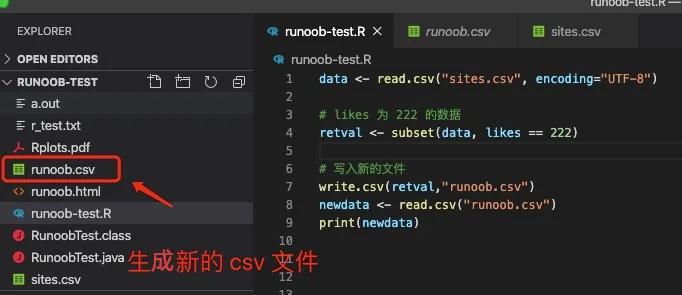
Continuando con el ejemplo anterior, guardamos los datos con likes igual a 222 en el archivo ejemplo.csv:
Ejemplo
# Datos con likes igual a 222
retval <- subset(data, likes == 222)
# Escribir en un nuevo archivo
write.csv(retval,"ejemplo.csv")
newdata <- read.csv("ejemplo.csv")
print(newdata)
El resultado de ejecutar el código anterior es:
 X id   name            url likes
1 2  2 Ejemplo www.example.com   222
X proviene del conjunto de datos newper, y se puede eliminar con el parámetro row.names = FALSE:
Ejemplo
# Datos con likes igual a 222
retval <- subset(data, likes == 222)
# Escribir en un nuevo archivo
write.csv(retval,"ejemplo.csv", row.names = FALSE)
newdata <- read.csv("ejemplo.csv")
print(newdata)
El resultado de ejecutar el código anterior es:
  id   name            url likes
1  2 Ejemplo www.example.com   222
Después de la ejecución, podemos ver que se ha generado el archivo ejemplo.csv: