Файлы CSV в R
Как профессиональный статистический инструмент, R стал бы бессмысленным, если бы мог только вручную импортировать и экспортировать данные. Поэтому R поддерживает пакетное извлечение данных из файлов основных табличных форматов хранения (таких как CSV, Excel, XML и т. д.).
Взаимодействие с таблицами CSV
CSV (Comma-Separated Values, CSV, иногда также называемый значениями, разделёнными символами, поскольку разделителем не обязательно должна быть запятая) — очень популярный формат файлов для хранения табличных данных, подходящий для хранения небольших или средних данных.
Поскольку большинство программ поддерживает этот формат файлов, он часто используется для хранения данных и взаимодействия с ними.
CSV по сути является текстом, и его формат файла чрезвычайно прост: данные сохраняются построчно в виде текста, каждая запись разделяется разделителями на поля, и каждая запись имеет одинаковую последовательность полей.
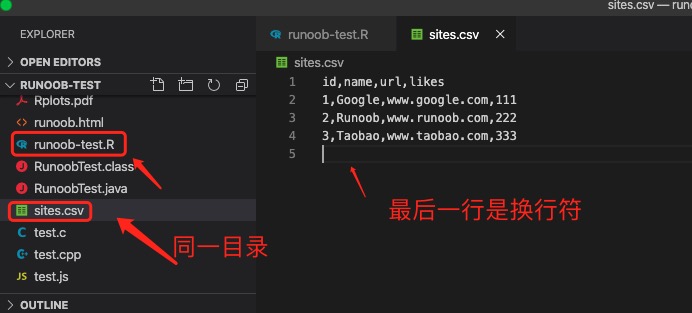
Ниже приведён простой файл sites.csv (хранящийся в том же каталоге, что и тестовая программа):
id,name,url,likes
1,Google,www.google.com,111
2,Example,www.example.com,222
3,Taobao,www.taobao.com,333
CSV использует запятые для разделения столбцов. Если данные содержат запятые, весь блок данных должен быть заключён в двойные кавычки.
Примечание:Для текста, содержащего неанглийские символы, обратите внимание на сохранённую кодировку. Поскольку многие компьютеры обычно используют кодировку UTF-8, я сохранил его в UTF-8.
Примечание:Последняя строка CSV-файла должна оставаться пустой; в противном случае программа выдаст предупреждающее сообщение.
Warning message:
In read.table(file = file, header = header, sep = sep, quote = quote,  :
  incomplete final line found by readTableHeader on 'sites.csv'
Чтение CSV-файлов
Далее мы можем использовать функцию read.csv() для чтения данных из CSV-файла:
Пример
print(data)
Если атрибут encoding не установлен, функция read.csv будет читать, используя кодировку текста по умолчанию операционной системы. Если вы используете китайскую версию Windows и не установили системную кодировку по умолчанию, то системная кодировка по умолчанию должна быть GBK. Поэтому, пожалуйста, постарайтесь унифицировать кодировку текста, насколько это возможно, чтобы избежать ошибок.
Выполнение приведенного выше кода дает следующий вывод:
  id   name            url likes
1  1 Google www.google.com   111
2  2 Example www.example.com   222
3  3 Taobao www.taobao.com   333
Функция read.csv() возвращает фрейм данных, позволяя нам удобно выполнять статистическую обработку данных. В следующем примере мы просматриваем количество строк и столбцов:
Пример
print(is.data.frame(data)) # Проверить, является ли это фреймом данных
print(ncol(data)) # Количество столбцов
print(nrow(data)) # Количество строк
Выполнение приведенного выше кода дает следующий вывод:
[1] TRUE
[1] 4
[1] 3
Ниже приведены данные с максимальным значением поля likes в датафрейме:
Пример
# Данные с максимальным значением likes
like <- max(data$likes)
print(like)
Выполнение приведенного выше кода дает следующий вывод:
[1] 333
Мы также можем задавать условия поиска для запроса данных, аналогично предложению WHERE в SQL. Используемая функция —subset()。
Следующий пример ищет данные, в которых likes равно 222:
Пример
# Данные со значением likes, равным 222
retval <- subset(data, likes == 222)
print(retval)
Выполнение приведенного выше кода дает следующий вывод:
  id   name            url likes
2  2 Example www.example.com   222
Примечание: В условных операторах используется равенство==。
Несколько условий используют&в качестве разделителя. В следующем примере выполняется поиск данных, где likes больше 1, а name равно Example:
Пример
# Данные с likes > 1 и name Example
retval <- subset(data, likes > 1 & name=="Example")
print(retval)
Выполнение приведенного выше кода дает следующий вывод:
  id   name            url likes
2  2 Example www.example.com   222
Сохранить как файл CSV
Язык R может использовать функциюwrite.csv()для сохранения данных в файл CSV.
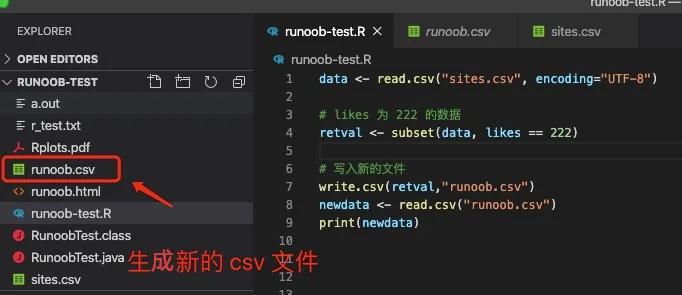
Продолжая предыдущий пример, мы сохраняем данные, где likes равно 222, в файл example.csv:
Пример
# Данные со значением likes, равным 222
retval <- subset(data, likes == 222)
# Запись в новый файл
write.csv(retval,"example.csv")
newdata <- read.csv("example.csv")
print(newdata)
Выполнение приведенного выше кода дает следующий вывод:
 X id   name            url likes
1 2  2 Example www.example.com   222
X берётся из набора данных newper, и его можно удалить с помощью параметра row.names = FALSE:
Пример
# Данные со значением likes, равным 222
retval <- subset(data, likes == 222)
# Запись в новый файл
write.csv(retval,"example.csv", row.names = FALSE)
newdata <- read.csv("example.csv")
print(newdata)
Выполнение приведенного выше кода дает следующий вывод:
  id   name            url likes
1  2 Example www.example.com   222
После выполнения мы видим, что создается файл example.csv: