R データ再形成
データフレームの結合
R 言語でデータフレームを結合するにはmerge()関数を使用します。
merge() 関数の構文は次のとおりです:
# S3 方法
merge(x, y, …)

# data.frame 的 S3 方法
merge(x, y, by = intersect(names(x), names(y)),
      by.x = by, by.y = by, all = FALSE, all.x = all, all.y = all,
      sort = TRUE, suffixes = c(".x",".y"), no.dups = TRUE,
      incomparables = NULL, …)
一般的なパラメータの説明:
- x, y: データフレーム
- by, by.x, by.y: 2つのデータフレームで一致する列名を指定します。デフォルトでは、2つのデータフレームで同じ列名を使用します。
- all: 論理値。all = L は all.x = L と all.y = L の簡略表記で、L は TRUE または FALSE にできます。
- all.x: 論理値、デフォルトは FALSE。TRUE の場合、y に対応する一致する行がなくても x 内の一致する行を表示し、y 内の一致しない行は NA で表されます。
- all.y: 論理値、デフォルトは FALSE。TRUE の場合、x に対応する一致する行がなくても y 内の一致する行を表示し、x 内の一致しない行は NA で表されます。
- sort: 論理値。列をソートするかどうか。
merge() 関数は SQL の JOIN 機能と非常に似ています:
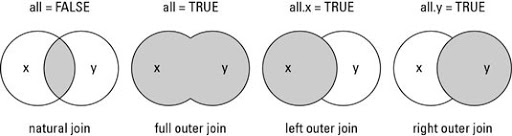
- Natural join または INNER JOIN: テーブルに少なくとも1つの一致がある場合、行を返します
- Left outer join または LEFT JOIN: 右テーブルに一致がなくても、左テーブルからすべての行を返します
- Right outer join または RIGHT JOIN: 左テーブルに一致がなくても、右テーブルからすべての行を返します
- Full outer join または FULL JOIN: いずれかのテーブルに一致が存在する限り、行を返します
例
# data frame 1
df1 = data.frame(SiteId = c(1:6), Site = c("Google","サンプル","Taobao","Facebook","Zhihu","Weibo"))
# data frame 2
df2 = data.frame(SiteId = c(2, 4, 6, 7, 8), Country = c("CN","USA","CN","USA","IN"))
# INNER JOIN
df1 = merge(x=df1,y=df2,by="SiteId")
print("----- INNER JOIN -----")
print(df1)
# FULL JOIN
df2 = merge(x=df1,y=df2,by="SiteId",all=TRUE)
print("----- FULL JOIN -----")
print(df2)
# LEFT JOIN
df3 = merge(x=df1,y=df2,by="SiteId",all.x=TRUE)
print("----- LEFT JOIN -----")
print(df3)
# RIGHT JOIN
df4 = merge(x=df1,y=df2,by="SiteId",all.y=TRUE)
print("----- RIGHT JOIN -----")
print(df4)
df1 = data.frame(SiteId = c(1:6), Site = c("Google","サンプル","Taobao","Facebook","Zhihu","Weibo"))
# data frame 2
df2 = data.frame(SiteId = c(2, 4, 6, 7, 8), Country = c("CN","USA","CN","USA","IN"))
# INNER JOIN
df1 = merge(x=df1,y=df2,by="SiteId")
print("----- INNER JOIN -----")
print(df1)
# FULL JOIN
df2 = merge(x=df1,y=df2,by="SiteId",all=TRUE)
print("----- FULL JOIN -----")
print(df2)
# LEFT JOIN
df3 = merge(x=df1,y=df2,by="SiteId",all.x=TRUE)
print("----- LEFT JOIN -----")
print(df3)
# RIGHT JOIN
df4 = merge(x=df1,y=df2,by="SiteId",all.y=TRUE)
print("----- RIGHT JOIN -----")
print(df4)
上記のコードを実行すると、出力結果は次のとおりです:
[1] "----- INNER JOIN -----"
  SiteId     Site Country
1      2   サンプル      CN
2      4 Facebook     USA
3      6    Weibo      CN
[1] "----- FULL JOIN -----"
  SiteId     Site Country.x Country.y
1      2   サンプル        CN        CN
2      4 Facebook       USA       USA
3      6    Weibo        CN        CN
4      7     <NA>      <NA>       USA
5      8     <NA>      <NA>        IN
[1] "----- LEFT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   サンプル      CN   サンプル        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
[1] "----- RIGHT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   サンプル      CN   サンプル        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
4      7     <NA>    <NA>     <NA>      <NA>       USA
5      8     <NA>    <NA>     <NA>      <NA>        IN
データの統合と分割
R 言語ではmelt()とcast()関数を使用してデータの統合と分割を行います。
- melt(): ワイド形式のデータをロング形式に変換します。
- cast(): ロング形式のデータをワイド形式に変換します。
次の図は、melt() 関数と cast() 関数の機能をよく示しています(後の例で詳しく説明します):
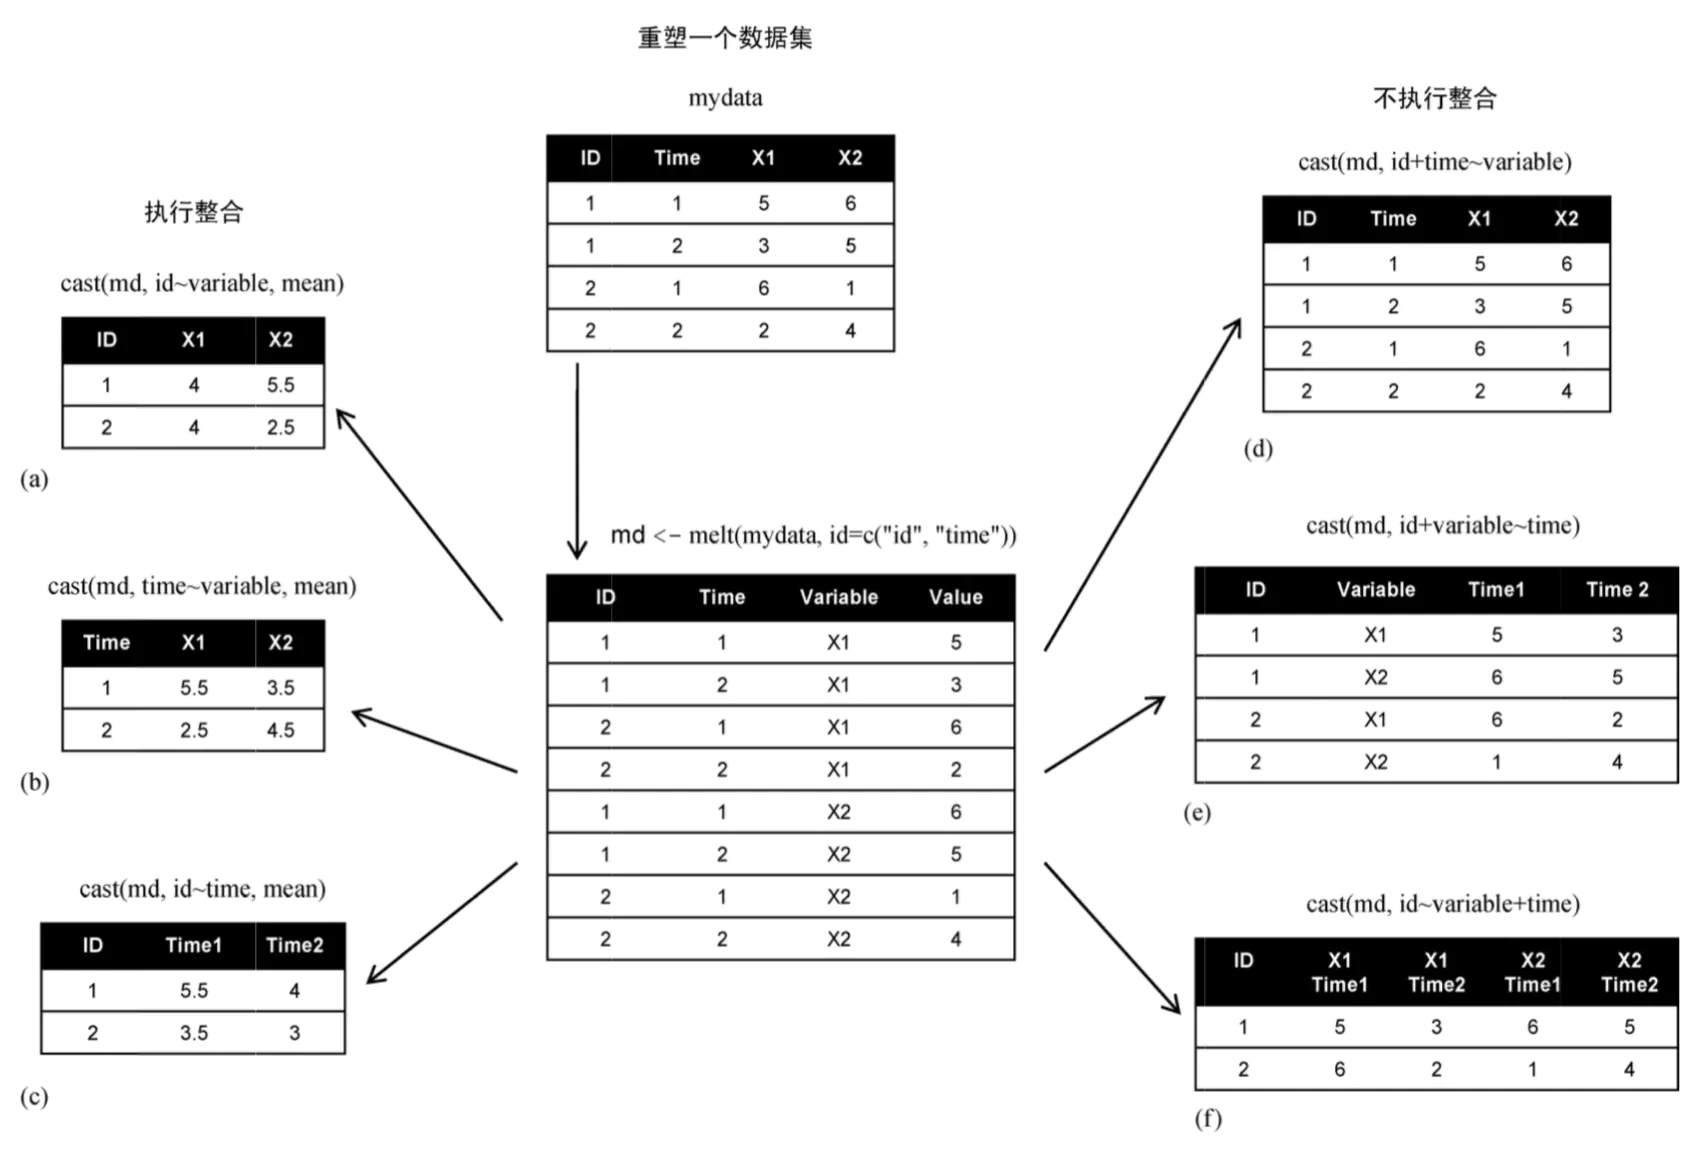
melt() はデータセットの各列を1つの列にスタックします。関数の構文は次のとおりです:
melt(data, ..., na.rm = FALSE, value.name = "value")
パラメータの説明:
- data: データセット。
- ...: 他のメソッドに渡す、または他のメソッドから渡されるその他のパラメータ。
- na.rm: データセット内の NA 値を削除するかどうか。
- value.name: 値を格納するための変数名。
以下の操作を行う前に、依存パッケージをインストールします:
# 安装库,MASS 包含很多统计相关的函数,工具和数据集
install.packages("MASS", repos = "https://mirrors.ustc.edu.cn/CRAN/")

#  melt() 和 cast() 函数需要对库
install.packages("reshape2", repos = "https://mirrors.ustc.edu.cn/CRAN/")
install.packages("reshape", repos = "https://mirrors.ustc.edu.cn/CRAN/")
テスト例:
例
# ライブラリをロード
library(MASS)
library(reshape2)
library(reshape)
# データフレームを作成
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# 元のデータフレーム
cat("元のデータフレーム:\n")
print(mydata)
# 統合
md <- melt(mydata, id = c("id","time"))
cat("\n統合後:\n")
print(md)
library(MASS)
library(reshape2)
library(reshape)
# データフレームを作成
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# 元のデータフレーム
cat("元のデータフレーム:\n")
print(mydata)
# 統合
md <- melt(mydata, id = c("id","time"))
cat("\n統合後:\n")
print(md)
上記のコードを実行すると、出力結果は次のとおりです:
原始数据框:
id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

整合后:
id time variable value
1  1    1       x1     5
2  1    2       x1     3
3  2    1       x1     6
4  2    2       x1     2
5  1    1       x2     6
6  1    2       x2     5
7  2    1       x2     1
8  2    2       x2     4
cast 関数は結合されたデータフレームを元に戻すために使用され、dcast() はデータフレームを返し、acast() はベクトル/行列/配列を返します。
cast() 関数の構文は次のとおりです:
dcast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
acast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
パラメータの説明:
- data: 結合されたデータフレーム。
- formula: 再形成するデータの形式。x ~ y 形式に似ており、x は行ラベル、y は列ラベルです。
- fun.aggregate: 集約関数。value 値を処理するために使用します。
- margins: 変数名のベクトル("grand\_col" と "grand\_row" を含めることができます)。マージンを計算するために使用します。TURE を設定するとすべてのマージンを計算します。
- subset: 結果を条件でフィルタリングします。形式は次のようなものですsubset = .(variable=="length")。
- drop: デフォルト値を保持するかどうか。
- value.var: 処理するフィールドを続けて指定します。
例
# ライブラリをロード
library(MASS)
library(reshape2)
library(reshape)
# データフレームを作成
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# 統合
md <- melt(mydata, id = c("id","time"))
# Print recasted dataset using cast() function
cast.data <- cast(md, id~variable, mean)
print(cast.data)
cat("\n")
time.cast <- cast(md, time~variable, mean)
print(time.cast)
cat("\n")
id.time <- cast(md, id~time, mean)
print(id.time)
cat("\n")
id.time.cast <- cast(md, id+time~variable)
print(id.time.cast)
cat("\n")
id.variable.time <- cast(md, id+variable~time)
print(id.variable.time)
cat("\n")
id.variable.time2 <- cast(md, id~variable+time)
print(id.variable.time2)
library(MASS)
library(reshape2)
library(reshape)
# データフレームを作成
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# 統合
md <- melt(mydata, id = c("id","time"))
# Print recasted dataset using cast() function
cast.data <- cast(md, id~variable, mean)
print(cast.data)
cat("\n")
time.cast <- cast(md, time~variable, mean)
print(time.cast)
cat("\n")
id.time <- cast(md, id~time, mean)
print(id.time)
cat("\n")
id.time.cast <- cast(md, id+time~variable)
print(id.time.cast)
cat("\n")
id.variable.time <- cast(md, id+variable~time)
print(id.variable.time)
cat("\n")
id.variable.time2 <- cast(md, id~variable+time)
print(id.variable.time2)
上記のコードを実行すると、出力結果は次のとおりです:
id x1  x2
1  1  4 5.5
2  2  4 2.5

  time  x1  x2
1    1 5.5 3.5
2    2 2.5 4.5

  id   1 2
1  1 5.5 4
2  2 3.5 3

  id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

  id variable 1 2
1  1       x1 5 3
2  1       x2 6 5
3  2       x1 6 2
4  2       x2 1 4

  id x1_1 x1_2 x2_1 x2_2
1  1    5    3    6    5
2  2    6    2    1    4
その他の拡張