Introducción a Ollama
Ollama es una plataforma de código abierto para modelos de lenguaje de gran tamaño (LLM) que permite a los usuarios ejecutar, gestionar e interactuar fácilmente con modelos de lenguaje de gran tamaño de forma local.
Ollama ofrece una forma sencilla de cargar y utilizar diversos modelos de lenguaje preentrenados, con soporte para múltiples tareas de procesamiento de lenguaje natural, como generación de texto, traducción, escritura de código, preguntas y respuestas, entre otras.
La característica de Ollama es que no solo ofrece modelos y herramientas listos para usar, sino que también proporciona una interfaz y una API convenientes, lo que permite implementar rápidamente tareas que van desde la generación de texto y los sistemas de diálogo hasta el análisis semántico.
A diferencia de otros frameworks de NLP, Ollama está diseñado para simplificar el flujo de trabajo de los usuarios, haciendo que el aprendizaje automático deje de ser un campo exclusivo de desarrolladores con profundos conocimientos técnicos.
Ollama admite múltiples opciones de aceleración por hardware, incluyendo inferencia solo con CPU y diversas arquitecturas de cómputo subyacentes (como Apple Silicon), lo que permite aprovechar mejor los diferentes tipos de recursos de hardware.
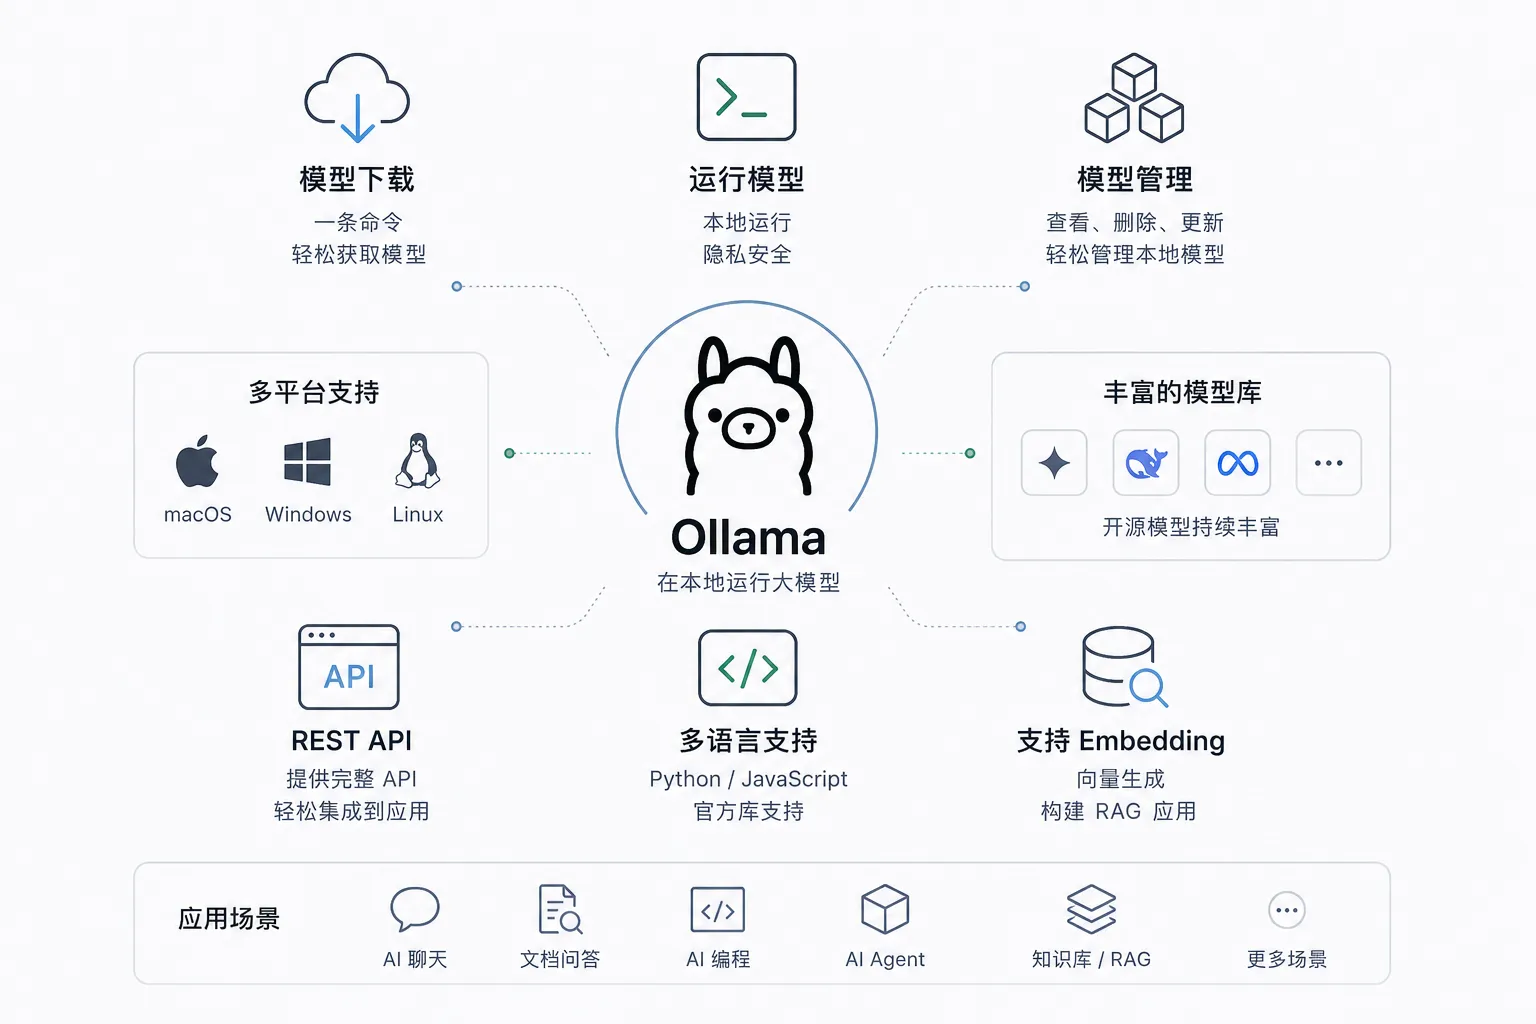
Ollama es un entorno de ejecución de modelos locales compuesto por cuatro partes.
| Componentes | Descripción | Ubicación |
|---|---|---|
| Herramienta de línea de comandos | El punto de entrada para todas las operaciones diarias como run, pull, list, etc. | El comando ollama en el PATH del sistema |
| Servicio en segundo plano | Se ejecuta de forma residente, se encarga de la carga de modelos y la inferencia, y ofrece una API REST al exterior. | Puerto local 11434 |
| Biblioteca de modelos | Los canales de distribución oficiales de los modelos de código abierto de diversos proveedores, clasificados por etiquetas de capacidad. | ollama.com/library |
| Almacenamiento local | Los pesos y la configuración de los modelos descargados | La carpeta .ollama en el directorio del usuario |
La nueva versión también ofrece dos accesos más amigables: escribir directamente ollama para abrir un menú interactivo, y usar ollama launch para conectar los modelos locales con herramientas como Claude Code, VS Code, etc., con un solo clic.
Funciones y características principales
-
Soporte para múltiples modelos de lenguaje preentrenados
Ollama ofrece múltiples modelos preentrenados listos para usar, incluyendo modelos de lenguaje de gran tamaño como GPT, BERT, etc. Los usuarios pueden cargar y utilizar fácilmente estos modelos para tareas como generación de texto, análisis de sentimientos, preguntas y respuestas. -
Fácil integración y uso
Ollama proporciona una herramienta de línea de comandos (CLI) y un SDK de Python que simplifican la integración con otros proyectos y servicios. Los desarrolladores no necesitan preocuparse por dependencias o configuraciones complejas y pueden integrar rápidamente Ollama en sus aplicaciones existentes. -
Implementación local y uso sin conexión
A diferencia de algunos servicios de NLP basados en la nube, Ollama permite a los desarrolladores ejecutar modelos en entornos de cómputo locales. Esto significa que se puede eliminar la dependencia de servidores externos, garantizar la privacidad de los datos y, para solicitudes de alta concurrencia, la implementación sin conexión puede ofrecer menor latencia y mayor control. -
Soporte para ajuste fino y personalización de modelos
Los usuarios no solo pueden utilizar los modelos preentrenados que ofrece Ollama, sino que también pueden realizar un ajuste fino de los modelos sobre esta base. Según sus necesidades específicas, los desarrolladores pueden reentrenar los modelos con sus propios datos recopilados para optimizar el rendimiento y la precisión de los modelos. -
Optimización del rendimiento
Ollama se centra en el rendimiento, ofrece un mecanismo de inferencia eficiente, admite procesamiento por lotes y gestiona eficazmente la memoria y los recursos computacionales. Esto le permite mantener una alta eficiencia al procesar grandes volúmenes de datos. -
Soporte multiplataforma
Ollama es compatible con varios sistemas operativos, incluyendo Windows, macOS y Linux. Así, tanto si los desarrolladores realizan depuraciones en entornos locales como si las empresas implementan en entornos de producción, obtienen una experiencia consistente. -
Código abierto y soporte de la comunidad
Ollama es un proyecto de código abierto, lo que significa que los desarrolladores pueden revisar el código fuente, realizar modificaciones y optimizaciones, y también contribuir al proyecto. Además, Ollama cuenta con una comunidad activa donde los desarrolladores pueden obtener ayuda e intercambiar experiencias con otras personas.
Casos de uso
-
Creación de contenido:
Ayuda a escritores, periodistas y profesionales de marketing a generar rápidamente contenido de alta calidad, como artículos de blog, textos publicitarios, etc. -
Asistencia en programación::
Ayuda a los desarrolladores a generar código, depurar programas u optimizar la estructura del código. -
Educación e investigación:
Asiste a estudiantes e investigadores en el aprendizaje, la escritura y la investigación, por ejemplo, generando resúmenes de artículos o resolviendo preguntas. -
Comunicación entre idiomas:
Ofrece funciones de traducción de alta calidad que ayudan a los usuarios a superar las barreras del idioma. -
Asistente personal:
Actúa como un asistente inteligente que ayuda a los usuarios a completar tareas diarias, como redactar correos electrónicos, generar listas de tareas pendientes, etc.
¿Por qué ejecutar modelos grandes localmente?
Ejecutar localmente no es nostalgia, sino cuatro razones muy concretas.
PrivacidadLos datos no salen del dispositivo. Contenidos como borradores de contratos, historiales médicos o código privado que no pueden salir de la máquina requieren siempre una reflexión antes de usar una API en la nube; la inferencia local, en cambio, no tiene este problema de forma inherente.
CostoNo hay cobro por Token. Descargar el modelo solo cuesta espacio en disco y electricidad una vez; en uso intensivo, el costo marginal se aproxima a cero. Esto resulta especialmente favorable para escenarios que requieren procesamiento de texto por lotes.
Sin conexiónNo depende de la red. En entornos de intranet, salas de servidores o aviones, mientras el dispositivo esté presente, el modelo estará disponible; esto es una necesidad clave para implementaciones en sitio y zonas con conectividad deficiente.
ControlLa versión y el comportamiento son predecibles. Los modelos locales no se actualizan silenciosamente ni cambian su comportamiento; el formato de salida que se verificó hoy no cambiará mañana. Para los sistemas de producción, esto es más importante que "ser más potente".
Por supuesto, hay que ser honestos: el límite de capacidad de los modelos locales de código abierto sigue siendo actualmente inferior al de los modelos insignia en la nube. Elegir una solución local es "suficiente, controlable y económico", no "todopoderoso".
Diferencias con las API en la nube y casos de uso adecuados
Al comparar los dos enfoques, los criterios de selección salen a la luz.
| Dimensión | Ollama local | API en la nube (OpenAI, Claude, etc.) |
|---|---|---|
| Ubicación de los datos | No sale de la máquina local | Se sube a los servidores del proveedor |
| Fuente de cómputo | Tu propia CPU / GPU | Centro de datos del proveedor |
| Modelo de costos | Descarga única, uso gratuito | Facturación continua por Token |
| Potencia del modelo | Limitada por el hardware local | Puede usar los modelos insignia más potentes |
| Disponible sin conexión | Totalmente disponible | No disponible |
| Costo de puesta en marcha | Instalar el software una vez, configurar el hardware una vez | Registrarse y listo, pero hay que gestionar las claves y la facturación |
Los casos de uso adecuados también quedan claros: para datos sensibles a la privacidad, llamadas de alta frecuencia, entornos sin conexión, aprendizaje y validación de desarrollo, elige local; para capacidades de modelos de primer nivel, tráfico elástico repentino o si no tienes tu propia GPU, elige la API en la nube.
No son enemigos; los productos maduros suelen tener una arquitectura híbrida: las solicitudes diarias van a local, y unas pocas tareas de alta dificultad se reenvían a la nube.
Comparación con otras soluciones locales
Ejecutar modelos grandes localmente no es exclusivo de Ollama; cada solución común tiene sus propios usuarios.
| Solución | Posicionamiento | Dificultad de aprendizaje | Público adecuado |
|---|---|---|---|
| Ollama | Un runtime que ejecuta modelos con un solo comando + servicio de API local | bajo | La mayoría de los desarrolladores, equipos que quieren integrar rápidamente |
| llama.cpp | El motor de inferencia de alto rendimiento en sí, con muchos parámetros y control de grano fino | Alto | Usuarios que quieren profundizar en los detalles de la inferencia y personalizar la implementación |
| LM Studio | Aplicación de escritorio con interfaz gráfica, que incluye exploración y descarga de modelos integradas | bajo | Usuarios que prefieren interfaz gráfica y no quieren tocar la línea de comandos |
| vLLM | Servicio de inferencia de nivel de producción y alto rendimiento orientado a servidores GPU | Alto | Equipos con servicios en línea de alta concurrencia y abundante capacidad de cómputo |
| GPT4All | Aplicación de escritorio ligera, centrada en el diálogo con documentos locales | bajo | Usuarios comunes sin formación técnica |
Su relación merece una mención: la capacidad de inferencia subyacente de Ollama proviene de llama.cpp; puede entenderse como una "envoltura fácil de usar + servicio + ecosistema de biblioteca de modelos" sobre llama.cpp.
Este tutorial elige Ollama como línea principal por su equilibrio: comandos extremadamente simples, cobertura completa en tres plataformas, y el ecosistema más completo de API y herramientas. La comparación se basa en documentación pública y el estado del proyecto en agosto de 2026; todas las soluciones están evolucionando rápidamente.
Modelos locales vs. Ollama Cloud
Lo que se comparó anteriormente eran "nubes de otros". Ollama también ofrece su propia solución en la nube, y así se completan las tres formas de utilizar modelos grandes.

La experiencia de uso de Ollama Cloud es casi idéntica a la local: añade el sufijo :cloud al nombre del modelo, inicia sesión y ejecútalo directamente. Los comandos, API e integraciones de herramientas locales siguen funcionando sin cambios, solo que la inferencia se reenvía de forma transparente a los servidores de Ollama.
Ejemplos
ollama signin
# Ejecuta modelos en la nube como modelos locales, sin necesidad de descargar pesos
ollama run qwen3.5:cloud
Su valor está en dos escenarios: modelos ultragrandes que la potencia de cálculo local no puede ejecutar, y "probar si vale la pena un modelo más grande" antes de comprar un ordenador nuevo.
Los modelos en la nube tienen un mecanismo de retiro: oficialmente se retiran periódicamente los modelos en la nube antiguos y se anuncian alternativas; los flujos de trabajo automatizados que dependen de ellos deben estar atentos a los avisos. Los modelos locales, en cambio, permanecen siempre en tu disco, sin verse afectados. Este tema se desarrolla por completo en el capítulo de despliegue híbrido en la nube.
Requisitos de hardware y expectativas
Una última cosa: evalúa tu propia máquina. Ollama es sorprendentemente tolerante con los requisitos de hardware; incluso solo con CPU puede ejecutarse, solo que la velocidad difiere en órdenes de magnitud.
Con una tarjeta gráfica dedicada (NVIDIA, AMD) o un chip Apple Silicon, la inferencia utiliza aceleración por GPU, y la velocidad de generación suele ser de varias a decenas de veces superior a la de solo CPU.
El valor predeterminado de la ventana de contexto lo clasifica automáticamente Ollama según la VRAM:
| Tamaño de VRAM | Longitud de contexto predeterminada |
|---|---|
| Menos de 24 GiB | 4K |
| 24 ~ 48GiB | 32K |
| 48 GiB o más | 256K |
Veamos ahora las expectativas de correspondencia entre la escala de parámetros y el dispositivo (con la familia qwen3.5 como ejemplohttps://ollama.com/library/qwen3.5):
| Especificación del modelo | Tamaño de descarga | Configuración recomendada | Expectativa de experiencia |
|---|---|---|---|
| qwen3.5:latest | Aproximadamente 6,6 GB | 16 GB de RAM o 8 GB de VRAM | Especificación predeterminada, equilibrio entre calidad y velocidad |
| qwen3.5:0.8b | Aproximadamente 1,0 GB | Con 8 GB de RAM es suficiente | Entorno de verificación, conversación ligera |
| qwen3.5:4b | Aproximadamente 3,4 GB | 16 GB de RAM | El punto óptimo para el uso diario |
| qwen3.5:9b es equivalente a qwen3.5:latest | Aproximadamente 6,6 GB | 16 GB de RAM o 8 GB de VRAM | Especificación predeterminada, equilibrio entre calidad y velocidad |
| qwen3.5:27b | Aproximadamente 17 GB | 24 GB de VRAM | Tareas de alta exigencia, como textos largos y código |
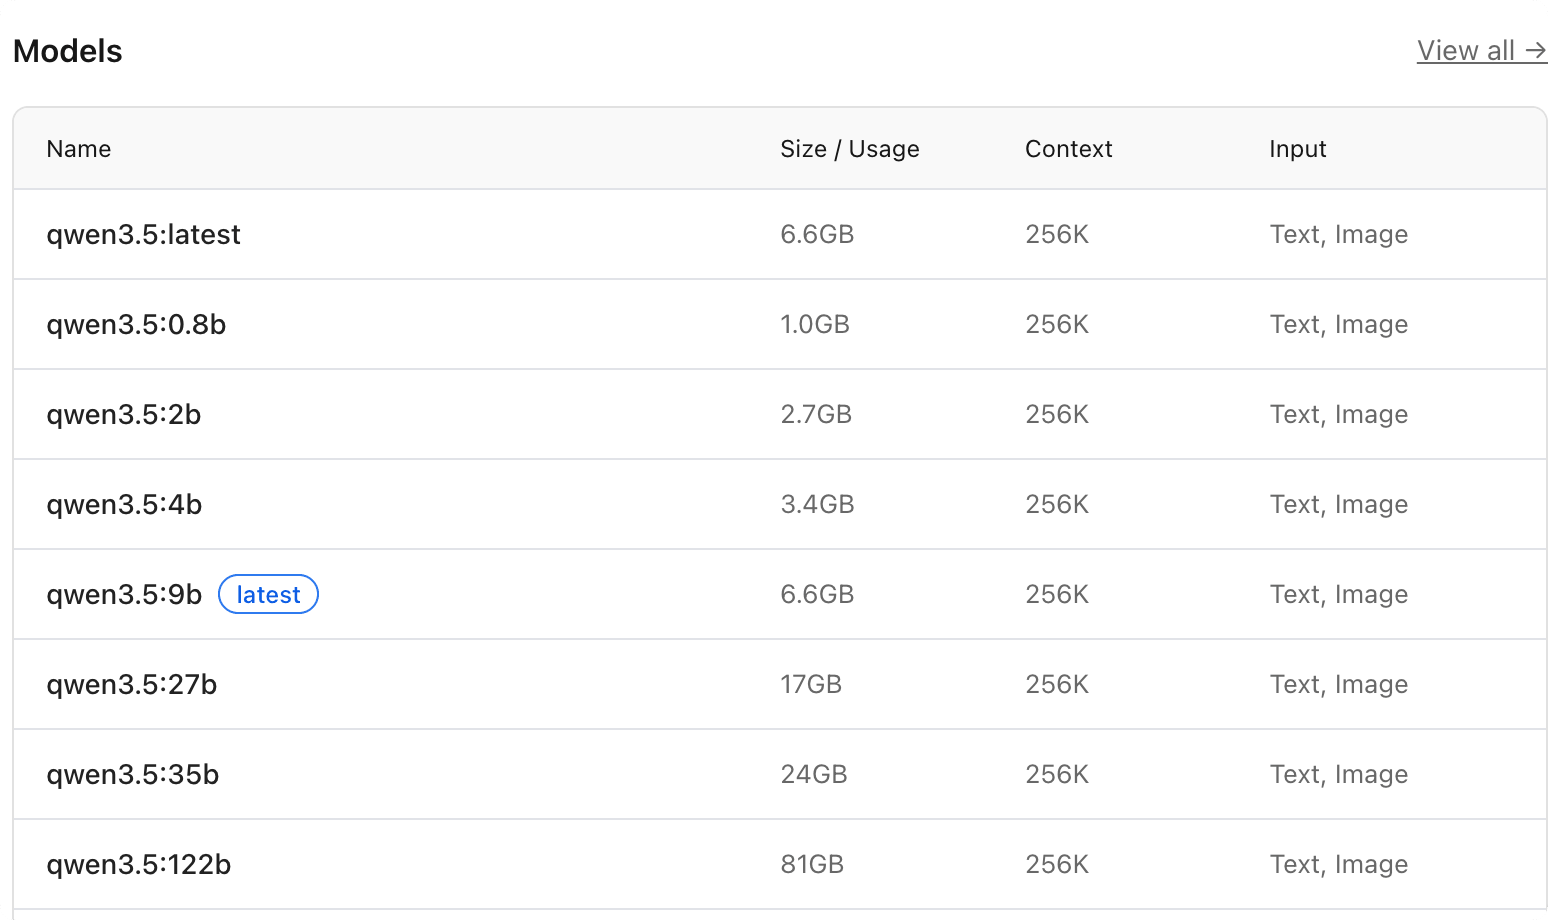
Una vez que el modelo esté en ejecución, usaollama psel comando para ver la columna PROCESSOR, y así confirmar si el modelo realmente se ejecuta por completo en la GPU. Esta acción de verificación se utilizará repetidamente en el capítulo de gestión de modelos.
Otras extensionesSi tu configuración es realmente limitada, no te desanimes: la especificación 0.8b es suficiente para ejecutar la gran mayoría de las demostraciones de comandos de este tutorial; si realmente surge la necesidad de un modelo grande, siempre está :cloud, una vía que no requiere hardware.