Tipps zur Optimierung von TensorFlow-Modellen
Modelloptimierung ist ein entscheidender Teil des Machine-Learning-Workflows; sie wirkt sich direkt auf die endgültige Leistung des Modells aus. In TensorFlow können wir eine Vielzahl technischer Methoden einsetzen, um die Genauigkeit und Generalisierungsfähigkeit des Modells zu verbessern.
Warum Modelloptimierung erforderlich ist
- Anfängliche Modelle sind oft nicht ideal: Das zuerst trainierte Modell leidet häufig unter Underfitting oder Overfitting
- Optimierung der Ressourcennutzung: Durch Tuning kann mit denselben Rechenressourcen eine bessere Leistung erzielt werden
- Abgleich mit Geschäftsanforderungen: Unterschiedliche Anwendungsszenarien haben unterschiedliche Anforderungen an Modelle (z. B. Genauigkeit vs. Geschwindigkeit)
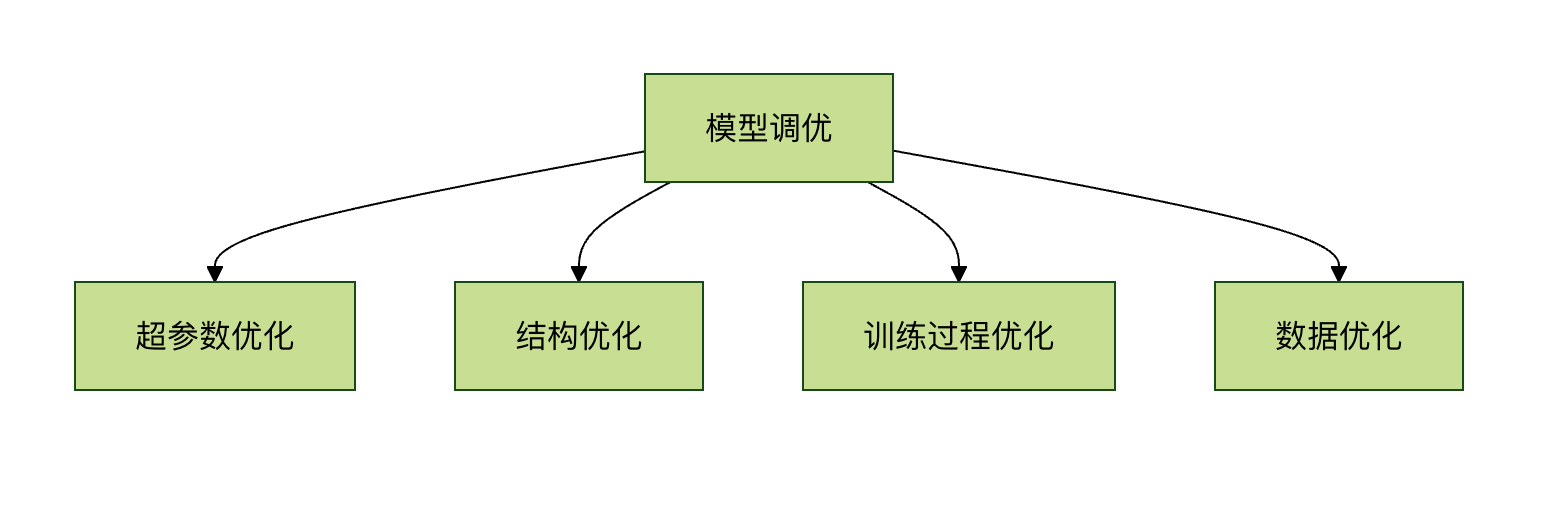
1.2 Hauptrichtungen des Tunings
Techniken zum Hyperparameter-Tuning
Anpassung der Lernrate
Die Lernrate ist einer der kritischsten Hyperparameter und beeinflusst direkt die Konvergenzgeschwindigkeit und die endgültige Leistung des Modells.
Statische Einstellung der Lernrate
Beispiel
optimizer = tf.keras.optimizers.Adam(learning_rate=0.001)
Dynamische Lernratenstrategie
Beispiel
initial_learning_rate = 0.1
lr_schedule = tf.keras.optimizers.schedules.ExponentialDecay(
initial_learning_rate,
decay_steps=10000,
decay_rate=0.96,
staircase=True)
optimizer = tf.keras.optimizers.SGD(learning_rate=lr_schedule)
Lernraten-Finder
Beispiel
import keras_tuner as kt
def build_model(hp):
model = tf.keras.Sequential()
model.add(tf.keras.layers.Dense(10))
# Suchbereich für die Lernrate festlegen
hp_learning_rate = hp.Choice('learning_rate', values=[1e-2, 1e-3, 1e-4])
model.compile(optimizer=tf.keras.optimizers.Adam(learning_rate=hp_learning_rate),
loss='mse')
return model
tuner = kt.RandomSearch(build_model, objective='val_loss', max_trials=5)
Auswahl der Batch-Größe
Die Batch-Größe beeinflusst Trainingsstabilität und Speicherverbrauch:
| Batch-Größe | Vorteile | Nachteile |
|---|---|---|
| Kleine Batch (16-64) | Schnelle Konvergenz, gute Generalisierung | Instabiles Training |
| Mittlere Batch (64-256) | Ausgewogene Wahl | Erfordert mehr Speicher |
| Große Batch (256+) | Stabiles Training | Kann in lokalen Optima stecken bleiben |
Optimierung der Modellstruktur
Anpassung von Schichtgröße und -tiefe
Techniken zur Breitenanpassung
Beispiel
def build_model(hp):
model = tf.keras.Sequential()
# Nach der optimalen Anzahl von Neuronen suchen
hp_units = hp.Int('units', min_value=32, max_value=512, Schrittweite=32)
model.add(tf.keras.layers.Dense(units=hp_units, activation='relu'))
model.add(tf.keras.layers.Dense(10))
model.compile(optimizer='adam', loss='mse')
return model
Strategien zur Tiefenanpassung
1. Beginnen Sie mit einem flachen Netzwerk und erhöhen Sie die Tiefe schrittweise.
2. Verwenden Sie Residualverbindungen (ResNet), um das Problem der verschwindenden Gradienten in tiefen Netzwerken zu lösen.
Beispiel
def residual_block(x, filters):
Tastenkürzel = x
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Activation('relu')(x)
x = tf.keras.layers.Conv2D(filters, (3,3), padding='same')(x)
x = tf.keras.layers.BatchNormalization()(x)
x = tf.keras.layers.Add()([shortcut, x])
return tf.keras.layers.Activation('relu')(x)
Regularisierungstechniken
Dropout
Beispiel
tf.keras.layers.Dense(128, activation='relu'),
tf.keras.layers.Dropout(0.5), # 50% der Neuronen werden zufällig deaktiviert
tf.keras.layers.Dense(10)
])
L1/L2-Regularisierung
Beispiel
tf.keras.layers.Dense(64,
activation='relu',
kernel_regularizer=tf.keras.regularizers.l2(0.01))
Frühzeitiges Stoppen
Beispiel
monitor='val_loss',
patience=5, # Stoppen, wenn sich der Validierungsverlust über 5 aufeinanderfolgende Epochen nicht verbessert
restore_best_weights=True) # Die besten Gewichte wiederherstellen
model.fit(x_train, y_train,
validation_data=(x_val, y_val),
epochs=100,
callbacks=[early_stopping])
Optimierung des Trainingsprozesses
Datenaugmentierung
Beispiel
data_augmentation = tf.keras.Sequential([
tf.keras.layers.RandomFlip("horizontal"),
tf.keras.layers.RandomRotation(0.1),
tf.keras.layers.RandomZoom(0.1),
])
# Mit augmentierten Daten trainieren
model.fit(data_augmentation(x_train), y_train, epochs=10)
Batch-Normalisierung
Beispiel
tf.keras.layers.Dense(64),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('relu'),
tf.keras.layers.Dense(10)
])
Gradienten-Clipping
Beispiel
optimizer = tf.keras.optimizers.Adam(clipvalue=1.0)
Fortgeschrittene Tuning-Techniken
Automatisiertes Hyperparameter-Tuning
Beispiel
tuner = kt.Hyperband(
build_model,
objective='val_accuracy',
max_epochs=10,
factor=3,
directory='my_dir',
project_name='intro_to_kt')
tuner.search(x_train, y_train, epochs=10, validation_data=(x_val, y_val))
best_model = tuner.get_best_models(num_models=1)[0]
Modell-Destillation
Beispiel
teacher = tf.keras.models.load_model('teacher_model.h5')
# Definition des Student-Modells
student = tf.keras.Sequential([...])
# Destillationsverlust
def distillation_loss(y_true, y_pred, teacher_pred, temp=5.0):
return tf.keras.losses.kl_divergence(
tf.nn.softmax(teacher_pred/temp),
tf.nn.softmax(y_pred/temp))
Praktische Tuning-Empfehlungen
- Eine Baseline festlegen: Trainieren Sie zuerst ein einfaches Modell als Baseline.
- Einen Parameter nach dem anderen anpassen: Vermeiden Sie, mehrere Parameter gleichzeitig zu ändern.
- Experimente aufzeichnen: Verwenden Sie TensorBoard oder MLflow, um Experimente zu verfolgen.
- Verwendung des Validierungssatzes: Stellen Sie sicher, dass der Validierungssatz die reale Datenverteilung repräsentiert.
- Rechenaufwand berücksichtigen: Wägen Sie Tuning-Effektivität und Ressourcenverbrauch gegeneinander ab.
Beispiel
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir="./logs")
model.fit(x_train, y_train, epochs=10, callbacks=[tensorboard_callback])
Durch die systematische Anwendung dieser Tuning-Techniken können Sie die Leistung von TensorFlow-Modellen erheblich verbessern. Denken Sie daran: Modell-Tuning ist ein iterativer Prozess, der Geduld und ein sorgfältiges experimentelles Design erfordert.
Andere Erweiterungen