TensorFlow Modelltraining
TensorFlow bietet einen vollständigen Satz von Werkzeugen zum Erstellen und Trainieren neuronaler Netzmodelle.
Modelltraining ist der Prozess der automatischen Anpassung von Modellparametern anhand von Daten, um Vorhersagefähigkeit zu erlangen.
Kernelemente des Modelltrainings
- Daten: Trainingsset, Validierungsset und Testset
- Modellarchitektur: die Schichtstruktur und Verbindungsmethoden des neuronalen Netzes
- Verlustfunktion: eine Metrik, die die Differenz zwischen Modellvorhersagen und wahren Werten misst
- Optimierer: ein Algorithmus zum Anpassen von Modellparametern
- Evaluationsmetriken: Standards zur Messung der Modellleistung
Trainingsworkflow
1. Datenvorbereitung
Beispiel
from tensorflow.keras import datasets
# Datensatz laden (mit MNIST als Beispiel) # Datenvorverarbeitung # In TensorFlow Dataset konvertieren
(train_images, train_labels), (test_images, test_labels) = datasets.mnist.load_data()
2. Modellkonstruktion
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
Beispiel
train_dataset = tf.data.Dataset.from_tensor_slices((train_images, train_labels))
train_dataset = train_dataset.shuffle(10000).batch(64)
2. Modellkonstruktion
Beispiel
Beispiel
model = models.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax')
])
Beschreibung der Kompilierungsparameter
model.summary()
3. Modellkompilierung
Beispiel
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
Beschreibung
| 'adam', 'sgd', 'rmsprop', etc. | Auswahl des Optimierer-Algorithmus | 'mse', 'categorical_crossentropy', etc. |
|---|---|---|
| optimizer | Verlustfunktionstyp | ['accuracy'], ['mse'], etc. |
| loss | Liste der Evaluierungsmetriken | 4. Modelltraining |
| metrics | Beispiel | Hauptparameter der fit()-Methode |
4. Modelltraining
Beispiel
epochs=10,
validation_data=(test_images, test_labels))
Beschreibung
| Eingabedaten | Trainingsdaten | Zieldaten |
|---|---|---|
| x | Label-Daten | Integer |
| y | Anzahl der Epochen | Integer |
| epochs | Batch-Größe | Tuple |
| batch_size | Validierungsdatensatz | Liste |
| validation_data | Callback-Liste | Visualisierung des Trainingsprozesses |
| callbacks | Trainingskurven | Beispiel |
Visualisierung des Trainingsprozesses
Trainingskurven
Beispiel
Benutzerdefinierte Trainingsschleife
plt.plot(history.history['accuracy'], label='Trainingsgenauigkeit')
plt.plot(history.history['val_accuracy'], label='Validierungsgenauigkeit')
plt.xlabel('Epoche')
plt.ylabel('Genauigkeit')
plt.legend()
plt.show()
Trainings-Flussdiagramm
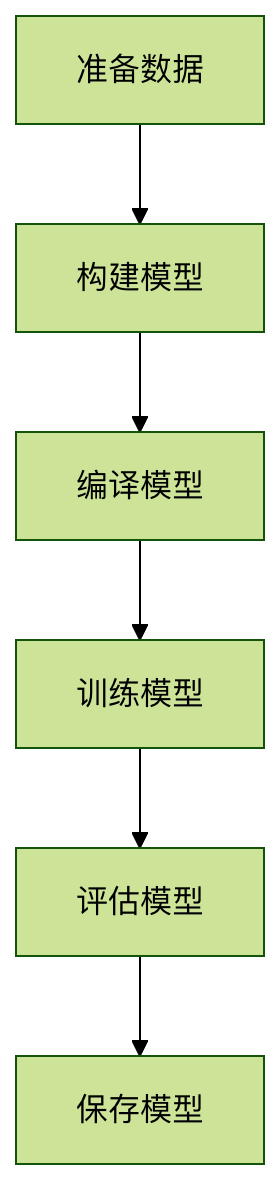
Fortgeschrittene Trainingstechniken
Benutzerdefinierte Trainingsschleife
Beispiel
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy()
optimizer = tf.keras.optimizers.Adam()
Häufige Probleme und Lösungen
@tf.function
def train_step(images, labels):
with tf.GradientTape() as tape:
predictions = model(images)
loss = loss_fn(labels, predictions)
gradients = tape.gradient(loss, model.trainable_variables)
optimizer.apply_gradients(zip(gradients, model.trainable_variables))
return loss
Trainings-Fehlerbehebungstabelle
for epoch in range(10):
for images, labels in train_dataset:
loss = train_step(images, labels)
print(f'Epoche {epoch}, Verlust: {loss.numpy()}')
Callbacks verwenden
Beispiel
Lösung
callbacks = [
ModelCheckpoint('best_model.h5', save_best_only=True),
EarlyStopping(patience=3, monitor='val_loss')
]
Loss nimmt nicht ab
model.fit(train_dataset,
epochs=20,
validation_data=(test_images, test_labels),
callbacks=callbacks)
Häufige Probleme und Lösungen
Trainings-Fehlerbehebungstabelle
| Genauigkeit schwankt stark | Batch-Größe ist ungeeignet | batch_size anpassen |
|---|---|---|
| Überanpassung (Overfitting) | Modell ist zu komplex | Regularisierung oder Dropout hinzufügen |
| Langsame Trainingsgeschwindigkeit | Hardware-Einschränkungen | Verwenden Sie GPU-Beschleunigung oder reduzieren Sie die Modellgröße |
| Tipps zur Leistungsoptimierung | Optimierung der Datenpipeline | Beispiel |
| # Prefetch und Cache verwenden, um das Laden von Daten zu beschleunigen | Mixed-Precision-Training | Beispiel |
Tipps zur Leistungsoptimierung
Beispiel:
Beispiel
Übung 1: Grundlegendes Training
train_dataset = train_dataset.cache().prefetch(buffer_size=tf.data.AUTOTUNE)
Verwenden Sie den Fashion MNIST-Datensatz, erstellen Sie ein CNN-Modell und schließen Sie das Training ab. Anforderungen::
Beispiel
policy = tf.keras.mixed_precision.Policy('mixed_float16')
tf.keras.mixed_precision.set_global_policy(policy)
Trainieren Sie 10 Epochen:
Beispiel
strategy = tf.distribute.MirroredStrategy()
with strategy.scope():
model = create_model()
model.compile(...)
Übungsaufgaben
Übung 1: Grundlegendes Training
Fügen Sie einen EarlyStopping-Callback hinzu
- Implementieren Sie einen Lernratenabfall
- ModelCheckpoint verwenden, um das beste Modell zu speichern
- Übung 3: Benutzerdefiniertes Training
Übung 2: Fortgeschrittene Techniken
Durch diesen Artikel sollten Sie den Kern-Workflow und die wichtigsten Techniken des TensorFlow-Modelltrainings beherrschen. In praktischen Anwendungen müssen Sie die Trainingsstrategie an das konkrete Problem und die Datenmerkmale anpassen. Es wird empfohlen, mit einem einfachen Modell zu beginnen, die Komplexität schrittweise zu erhöhen und durch Experimente die beste Trainingskonfiguration zu finden.
- Andere Erweiterungen
- KI denkt nach...
- TensorFlow Textdatenverarbeitung
Übung 3: Benutzerdefiniertes Training
Notizenliste
Klicken Sie hier, um Notizen zu teilen
Die Notiz muss eine Erweiterung dieses Artikels sein!
Artikel einreichen, hier klicken
Wie man den Registrierungseinladungscode erhält