TensorFlow モデルトレーニング
TensorFlow はニューラルネットワークモデルを構築・トレーニングするための完全なツールセットを提供します。
モデルトレーニングとは、データを通じてモデルが自動的にパラメータを調整し、予測能力を獲得するプロセスです。
モデルトレーニングの核心要素
- データ:トレーニングセット、検証セット、テストセット
- モデルアーキテクチャ:ニューラルネットワークの層構造と接続方式
- 損失関数:モデルの予測と実際の値の差異を測定する指標
- オプティマイザー:モデルのパラメータを調整するアルゴリズム
- 評価指標:モデルのパフォーマンスを測定する基準
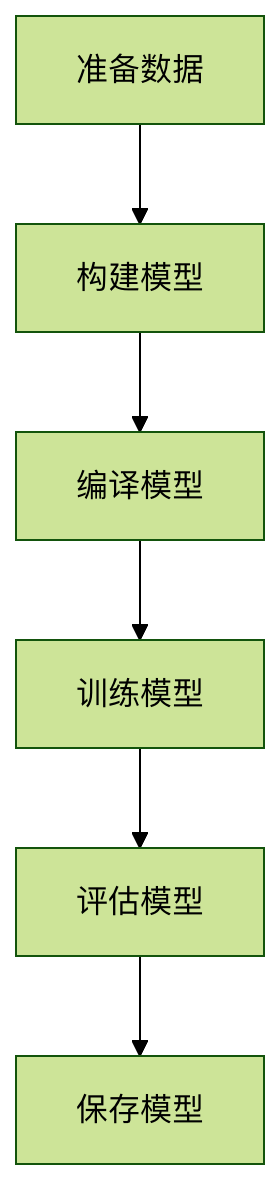
トレーニングフロー
1、データ準備
例
import tensorflow as tf
from tensorflow.keras import datasets
# データセットの読み込み(MNISTを例に)
(train_images, train_labels), (test_images, test_labels) = datasets.mnist.load_data()
# データ前処理
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
# TensorFlow Datasetに変換
train_dataset = tf.data.Dataset.from_tensor_slices((train_images, train_labels))
train_dataset = train_dataset.shuffle(10000).batch(64)
from tensorflow.keras import datasets
# データセットの読み込み(MNISTを例に)
(train_images, train_labels), (test_images, test_labels) = datasets.mnist.load_data()
# データ前処理
train_images = train_images.reshape((60000, 28, 28, 1)).astype('float32') / 255
test_images = test_images.reshape((10000, 28, 28, 1)).astype('float32') / 255
# TensorFlow Datasetに変換
train_dataset = tf.data.Dataset.from_tensor_slices((train_images, train_labels))
train_dataset = train_dataset.shuffle(10000).batch(64)
2、モデル構築
例
from tensorflow.keras import layers, models
# Sequentialモデルの構築
model = models.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax')
])
# モデル構造の確認
model.summary()
# Sequentialモデルの構築
model = models.Sequential([
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
layers.Conv2D(64, (3, 3), activation='relu'),
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10, activation='softmax')
])
# モデル構造の確認
model.summary()
3、モデルコンパイル
例
model.compile(optimizer='adam',
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
loss='sparse_categorical_crossentropy',
metrics=['accuracy'])
コンパイルパラメータの説明
| パラメータ | 選択可能な値 | 説明 |
|---|---|---|
| optimizer | 'adam', 'sgd', 'rmsprop' など | 最適化アルゴリズムの選択 |
| loss | 'mse', 'categorical_crossentropy' など | 損失関数のタイプ |
| metrics | ['accuracy'], ['mse'] など | 評価指標のリスト |
4、モデルトレーニング
例
history = model.fit(train_dataset,
epochs=10,
validation_data=(test_images, test_labels))
epochs=10,
validation_data=(test_images, test_labels))
fit() メソッドの主要パラメータ
| パラメータ | 型 | 説明 |
|---|---|---|
| x | 入力データ | トレーニングデータ |
| y | ターゲットデータ | ラベルデータ |
| epochs | 整数 | トレーニングエポック数 |
| batch_size | 整数 | バッチサイズ |
| validation_data | タプル | 検証データセット |
| callbacks | リスト | コールバック関数のリスト |
トレーニングプロセスの可視化
トレーニング曲線
例
import matplotlib.pyplot as plt
# トレーニングと検証の精度曲線を描画
plt.plot(history.history['accuracy'], label='Training Accuracy')
plt.plot(history.history['val_accuracy'], label='Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy')
plt.legend()
plt.show()
# トレーニングと検証の精度曲線を描画
plt.plot(history.history['accuracy'], label='Training Accuracy')
plt.plot(history.history['val_accuracy'], label='Validation Accuracy')
plt.xlabel('Epoch')
plt.ylabel('Accuracy')
plt.legend()
plt.show()
トレーニングフローチャート
高度なトレーニングテクニック
カスタムトレーニングループ
例
# 損失関数とオプティマイザーの定義
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy()
optimizer = tf.keras.optimizers.Adam()
# カスタムトレーニングステップ
@tf.function
def train_step(images, labels):
with tf.GradientTape() as tape:
predictions = model(images)
loss = loss_fn(labels, predictions)
gradients = tape.gradient(loss, model.trainable_variables)
optimizer.apply_gradients(zip(gradients, model.trainable_variables))
return loss
# カスタムトレーニングループ
for epoch in range(10):
for images, labels in train_dataset:
loss = train_step(images, labels)
print(f'Epoch {epoch}, Loss: {loss.numpy()}')
loss_fn = tf.keras.losses.SparseCategoricalCrossentropy()
optimizer = tf.keras.optimizers.Adam()
# カスタムトレーニングステップ
@tf.function
def train_step(images, labels):
with tf.GradientTape() as tape:
predictions = model(images)
loss = loss_fn(labels, predictions)
gradients = tape.gradient(loss, model.trainable_variables)
optimizer.apply_gradients(zip(gradients, model.trainable_variables))
return loss
# カスタムトレーニングループ
for epoch in range(10):
for images, labels in train_dataset:
loss = train_step(images, labels)
print(f'Epoch {epoch}, Loss: {loss.numpy()}')
コールバック関数の使用
例
from tensorflow.keras.callbacks import ModelCheckpoint, EarlyStopping
# コールバック関数の作成
callbacks = [
ModelCheckpoint('best_model.h5', save_best_only=True),
EarlyStopping(patience=3, monitor='val_loss')
]
# コールバックを使用したトレーニング
model.fit(train_dataset,
epochs=20,
validation_data=(test_images, test_labels),
callbacks=callbacks)
# コールバック関数の作成
callbacks = [
ModelCheckpoint('best_model.h5', save_best_only=True),
EarlyStopping(patience=3, monitor='val_loss')
]
# コールバックを使用したトレーニング
model.fit(train_dataset,
epochs=20,
validation_data=(test_images, test_labels),
callbacks=callbacks)
よくある問題と解決策
トレーニング問題トラブルシューティング表
| 問題の現象 | 考えられる原因 | 解決策 |
|---|---|---|
| 損失が減少しない | 学習率が高すぎる/低すぎる | 学習率を調整する |
| 精度の変動が大きい | バッチサイズが適切でない | batch_sizeを調整する |
| 過学習 | モデルが複雑すぎる | 正則化またはDropoutを追加する |
| トレーニング速度が遅い | ハードウェアの制限 | GPUアクセラレーションを使用するか、モデルを縮小する |
パフォーマンス最適化の提案
データパイプラインの最適化:
例
# prefetchとcacheを使用してデータ読み込みを高速化
train_dataset = train_dataset.cache().prefetch(buffer_size=tf.data.AUTOTUNE)
混合精度トレーニング:
例
policy = tf.keras.mixed_precision.Policy('mixed_float16')
tf.keras.mixed_precision.set_global_policy(policy)
分散トレーニング:
例
strategy = tf.distribute.MirroredStrategy()
with strategy.scope():
model = create_model()
model.compile(...)
実践演習
演習1:基礎トレーニング
Fashion MNISTデータセットを使用し、CNNモデルを構築してトレーニングを完了してください。要件:
- 少なくとも2つの畳み込み層を含む
- 10エポックトレーニングする
- トレーニング中の精度と損失の変化を記録する
演習2:高度なテクニック
演習1に基づいて:
- EarlyStoppingコールバックを追加する
- 学習率の減衰を実装する
- ModelCheckpointを使用して最良のモデルを保存する
演習3:カスタムトレーニング
カスタムトレーニングループを使用して演習1のタスクを実装し、fit()メソッドとの違いを比較してみてください。
この記事の学習を通じて、TensorFlowモデルトレーニングの核心的なフローと重要なテクニックを習得できたはずです。実際の応用では、具体的な問題やデータの特性に応じてトレーニング戦略を調整する必要があります。シンプルなモデルから始め、徐々に複雑さを増やし、実験を通じて最適なトレーニング構成を見つけることをお勧めします。
その他の拡張