TensorFlow Kernkonzepte
Der Name TensorFlow stammt von den Kernstrukturen, die es zur Verarbeitung von Daten verwendet – Tensor und Flow.
TensorFlow ist eine durchgängige Open-Source-Plattform für maschinelles Lernen. Ihre Kernvorteile sind:
- Flexibles Berechnungsgraphenmodell: unterstützt sowohl dynamische als auch statische Graphmodi
- Plattformübergreifende Bereitstellungsfähigkeit: kann auf CPU, GPU, TPU und mobilen Geräten ausgeführt werden
- Reichhaltiges Ökosystem: umfasst Teilprojekte wie TensorFlow Lite (mobil) und TensorFlow.js (Browser)
- Produktionsreif: bietet eine vollständige Toolchain von der Forschung bis zur Produktion
Kernkonzepte erklärt
Tensor
Ein Tensor ist die grundlegendste Datenstruktur in TensorFlow. Er kann alsein mehrdimensionales Arrayim verallgemeinerten Sinne verstanden werden.
Mathematisch ist ein Tensor eine multilineare Funktion, die verwendet werden kann, um lineare Beziehungen zwischen Vektoren, Skalaren und anderen Tensoren darzustellen.
Einfache Analogie:
- Skalar (0-dimensionaler Tensor): eine Zahl, wie zum Beispiel
5 - Vektor (1-dimensionaler Tensor): eine Liste von Zahlen, wie zum Beispiel
[1, 2, 3, 4] - Matrix (2-dimensionaler Tensor): eine Tabelle von Zahlen, wie zum Beispiel
[[1, 2], [3, 4]] - 3-dimensionaler Tensor: ein Würfel aus Zahlen, wie zum Beispiel ein Farbbild (Höhe × Breite × Farbkanäle)
- Höherdimensionale Tensoren: zum Beispiel Videodaten (Zeit × Höhe × Breite × Farbkanäle)
Wichtige Eigenschaften von Tensoren
Beispiel
import tensorflow as tf
# Erstelle einen 2x3-Matrix-Tensor
tensor = tf.constant([[1, 2, 3], [4, 5, 6]])
print(f"Form (Shape): {tensor.shape}") # (2, 3)
print(fDatentyp (Dtype): {tensor.dtype}) # int32
print(fRang (Rank): {tf.rank(tensor)}) # 2
print(fGerät (Device): {tensor.device}) # /job:localhost/replica:0/task:0/device:CPU:0
Erklärung der wichtigsten Eigenschaften:
Form: beschreibt die Größe jeder Dimension
(2, 3)repräsentiert eine Matrix mit 2 Zeilen und 3 Spalten(224, 224, 3)repräsentiert ein RGB-Bild mit 224×224 Pixeln
Datentyp (Dtype): der Typ der Daten im Tensor
tf.float32: 32-Bit-Gleitkommazahl (am häufigsten)tf.int32: 32-Bit-Ganzzahltf.bool: booleantf.string: string
Dimension / Rang: die Dimensionalität eines Tensors
- Skalar: Rang 0
- Vektor: Rang 1
- Matrix: Rang 2
Gerät: der Geräteort, an dem der Tensor gespeichert ist
- CPU:
/device:CPU:0 - GPU:
/device:GPU:0
Bedeutung von Tensoren im maschinellen Lernen
Datenrepräsentation:
- Eingabedaten: Bilder, Text und Audio können alle als Tensoren dargestellt werden
- Modellparameter: Gewichte und Bias-Werte sind Tensoren
- Zwischenergebnisse: alle Daten während der Berechnung sind Tensoren
- Ausgabeergebnisse: Vorhersageergebnisse, Loss-Werte usw.
Praktische Beispiele:
- Bildklassifikation: Form des Eingabe-Tensors
(batch_size, height, width, channels) - Textverarbeitung: Form des Eingabe-Tensors
(batch_size, sequence_length) - Zeitreihen: Form des Eingabe-Tensors
(batch_size, time_steps, features)
Berechnungsgraph
Ein Berechnungsgraph ist eine Graphstruktur, dieKnotenundKantenverwendet, um mathematische Operationen darzustellen:
- Knoten: repräsentiert mathematische Operationen (Addition, Multiplikation, Aktivierungsfunktionen usw.)
- Kante: repräsentiert den Pfad des Datenflusses (Tensoren)
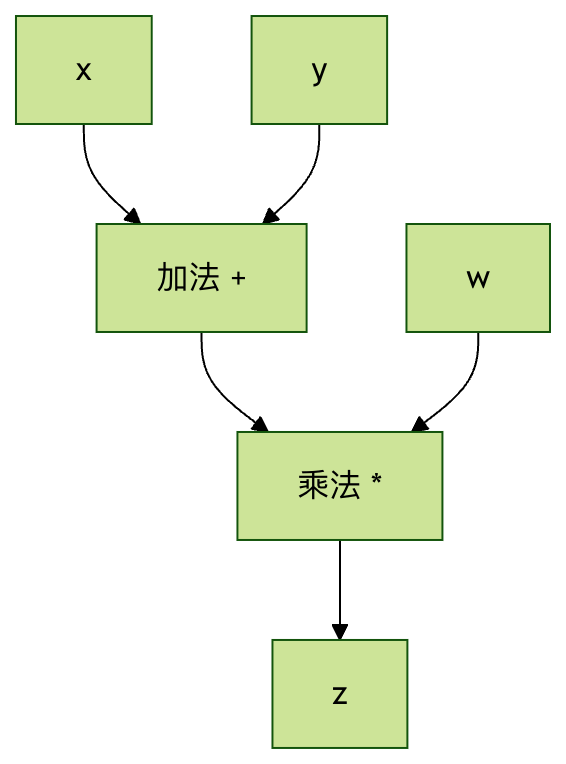
Einfaches Beispiel:
计算 z = (x + y) * w 的计算图:

x ──┐
    ├─→ [+] ──→ [×] ──→ z
y ──┘         ├
w ────────────┘
Vorteile von Berechnungsgraphen
1. Automatische Differenzierung:
- Kann Gradienten automatisch berechnen und Backpropagation implementieren
- Keine Notwendigkeit, komplexe Gradientenformeln manuell herzuleiten
2. Optimierungsmöglichkeiten:
- Compile-Time-Optimierung: Operationen zusammenführen, Redundanz eliminieren
- Laufzeitoptimierung: Speicherwiederverwendung, paralleles Rechnen
3. Visuelles Debugging:
- TensorBoard zur Visualisierung der Modellstruktur verwenden
- Komplexe Modelle einfacher verstehen und debuggen
4. Verteiltes Rechnen:
- Verschiedene Teile des Graphen können verschiedenen Geräten zugewiesen werden
- Unterstützt verteiltes Training über mehrere Maschinen hinweg
Statischer Graph vs dynamischer Graph
TensorFlow 1.x (statischer Graph):
Beispiel
import tensorflow.compat.v1 as tf
tf.disable_v2_behavior()
# Berechnungsgraphen definieren
x = tf.placeholder(tf.float32, shape=[None, 784])
W = tf.Variable(tf.random.normal([784, 10]))
b = tf.Variable(tf.zeros([10]))
y = tf.matmul(x, W) + b
# Sitzung erstellen und ausführen
with tf.Session() as sess:
sess.run(tf.global_variables_initializer())
result = sess.run(y, feed_dict={x: input_data})
TensorFlow 2.x (dynamischer Graph / Eager Execution):
Beispiel
import tensorflow as tf
# Operationen direkt ausführen
x = tf.constant([[1.0, 2.0, 3.0]])
W = tf.Variable(tf.random.normal([3, 2]))
b = tf.Variable(tf.zeros([2]))
y = tf.matmul(x, W) + b
print(y) # Ergebnis sofort erhalten
Session und Eager Execution
Session-Mechanismus in TensorFlow 1.x
In TensorFlow 1.x sind der Aufbau und die Ausführung des Berechnungsgraphen getrennt:
Zweistufiger Prozess:
- Konstruktionsphase: definiere den Berechnungsgraphen, führe aber keine Berechnung aus
- Ausführungsphase: den Graphen in einer Session ausführen und Ergebnisse erhalten
Die Rolle der Session:
- Die Ausführungsumgebung des Graphen verwalten
- Ressourcen zuweisen und verwalten (Speicher, Geräte)
- Den Kontext für die Ausführung des Graphen bereitstellen
3.2 Eager Execution in TensorFlow 2.x
TensorFlow 2.x aktiviert standardmäßig Eager Execution und macht TensorFlow dadurch "pythonischer":
Merkmale von Eager Execution:
- Sofortige Auswertung: Operationen werden unmittelbar nach der Definition ausgeführt
- Einfaches Debuggen: Python-Debugging-Tools können verwendet werden
- Intuitive Programmierung: genau wie das Schreiben von normalem Python-Code
Vergleichsbeispiel:
Beispiel
import tensorflow as tf
a = tf.constant(2.0)
b = tf.constant(3.0)
c = a + b
print(f"Result: {c}") # Ergebnis: 5.0
# Kann direkt auf den Wert zugreifen
print(f"c's numpy value: {c.numpy()}") # numpy-Wert von c: 5.0
Graph-Modus vs. Eager-Execution-Modus
Eager-Execution-Modus (Standard, geeignet für Entwicklung und Debugging):
- Operationen werden sofort ausgeführt
- Einfach zu debuggen und zu verstehen
- Etwas geringere Leistung
Graph-Modus (geeignet für den Produktionseinsatz):
- Den vollständigen Berechnungsgraphen vorab erstellen
- Bessere Optimierungsmöglichkeiten
- Höhere Ausführungseffizienz
Zum Graph-Modus wechseln:
Beispiel
def compute_function(x, y):
return x * y + x
# Diese Funktion wird in einen Graphen kompiliert
result = compute_function(tf.constant(2.0), tf.constant(3.0))
Variable und Konstante
Konstante
Eine Konstante istein unveränderlicherTensor, der nach der Erstellung nicht geändert werden kann:
Beispiel
scalar_const = tf.constant(3.14)
vector_const = tf.constant([1, 2, 3, 4])
matrix_const = tf.constant([[1, 2], [3, 4]])
# Der Wert einer Konstante kann nicht geändert werden
print(scalar_const) # tf.Tensor(3.14, shape=(), dtype=float32)
Verwendungen von Konstanten:
- Hyperparameter speichern (Lernrate, Batch-Größe usw.)
- Konfigurationsdaten speichern, die kein Training benötigen
- Als feste Werte in Berechnungen dienen
Variable
Eine Variable istein veränderbarerTensor, der typischerweise zum Speichern von Modellparametern verwendet wird:
Beispiel
weight = tf.Variable(tf.random.normal([2, 3]))
bias = tf.Variable(tf.zeros([3]))
print(f"Anfangsgewichte:\n{weight}")
# Den Wert der Variable ändern
weight.assign(tf.ones([2, 3]))
print(f"Geänderte Gewichte:\n{weight}")
# Partielles Update
weight[0, 0].assign(5.0)
print(f"Nach partiellem Update:\n{weight}")
Hauptmerkmale von Variablen:
- Zustandspersistenz: behält den Zustand während des Trainings bei
- Gradientenverfolgung: kann Gradienten in Bezug auf Variablen berechnen
- Optimierbar: kann durch Optimierungsalgorithmen aktualisiert werden
- Speicherbar: kann in Checkpoint-Dateien gespeichert werden
Anwendungsfälle: Variable vs. Konstante
| Eigenschaft | Variable | Konstante |
|---|---|---|
| Veränderbarkeit | Änderbar | Nicht änderbar |
| Hauptverwendung | Modellparameter (Gewichte, Bias-Werte) | Hyperparameter, Eingabedaten |
| Gradientenberechnung | Unterstützt | Nicht unterstützt |
| Speicherverbrauch | Dauerhafte Speicherung | Temporärer Speicher |
| Typische Beispiele | W = tf.Variable(...) |
learning_rate = tf.constant(0.01) |
Datenfluss und automatische Differenzierung
Vorwärtspropagation
Der Prozess, bei dem Daten von Eingabeknoten zu Ausgabeknoten im Berechnungsgraphen fließen:
Beispiel
import tensorflow as tf
# Eingabedaten
x = tf.constant([[1.0, 2.0]])
# Modellparameter
W1 = tf.Variable(tf.random.normal([2, 3]))
b1 = tf.Variable(tf.zeros([3]))
W2 = tf.Variable(tf.random.normal([3, 1]))
b2 = tf.Variable(tf.zeros([1]))
# Vorwärtspropagierung
hidden = tf.nn.relu(tf.matmul(x, W1) + b1) # Versteckte Schicht
output = tf.matmul(hidden, W2) + b2 # Ausgabeschicht
print(f"Endgültige Ausgabe: {output}")
Automatische Differenzierung
TensorFlow verwendetGradientTape, um Operationen aufzuzeichnen und automatisch Gradienten zu berechnen:
Beispiel
x = tf.Variable(3.0)
# Verwende GradientTape, um Operationen aufzuzeichnen
with tf.GradientTape() as tape:
y = x**2 + 2*x + 1 # y = x² + 2x + 1
# Berechne dy/dx
gradient = tape.gradient(y, x)
print(f"Wenn x=3, dy/dx = {gradient}") # Sollte 2x + 2 = 8 sein
Wie GradientTape funktioniert:
- Operationen aufzeichnen: Das Tape zeichnet alle Operationen innerhalb seines Kontexts auf
- Rückwärtsgraphen erstellen: erstellt einen umgekehrten Berechnungsgraphen zur Gradientenberechnung
- Gradienten berechnen: berechnet Gradienten unter Verwendung der Kettenregel
Integration der Konzepte in die Trainingsschleife
Beispiel
import tensorflow as tf
# Modell und Daten
model = tf.keras.Sequential([
tf.keras.layers.Dense(10, activation='relu'),
tf.keras.layers.Dense(1)
])
x_train = tf.random.normal([100, 5])
y_train = tf.random.normal([100, 1])
optimizer = tf.keras.optimizers.Adam(0.01)
# Trainingsschritt
@tf.function
def train_step(x, y):
with tf.GradientTape() as tape:
predictions = model(x)
loss = tf.keras.losses.mse(y, predictions)
gradients = tape.gradient(loss, model.trainable_variables)
optimizer.apply_gradients(zip(gradients, model.trainable_variables))
return loss
# Training ausführen
for epoch in range(10):
loss = train_step(x_train, y_train)
print(f"Epoch {epoch}: Loss = {loss:.4f}")
Zusammenfassung der Kernkonzepte
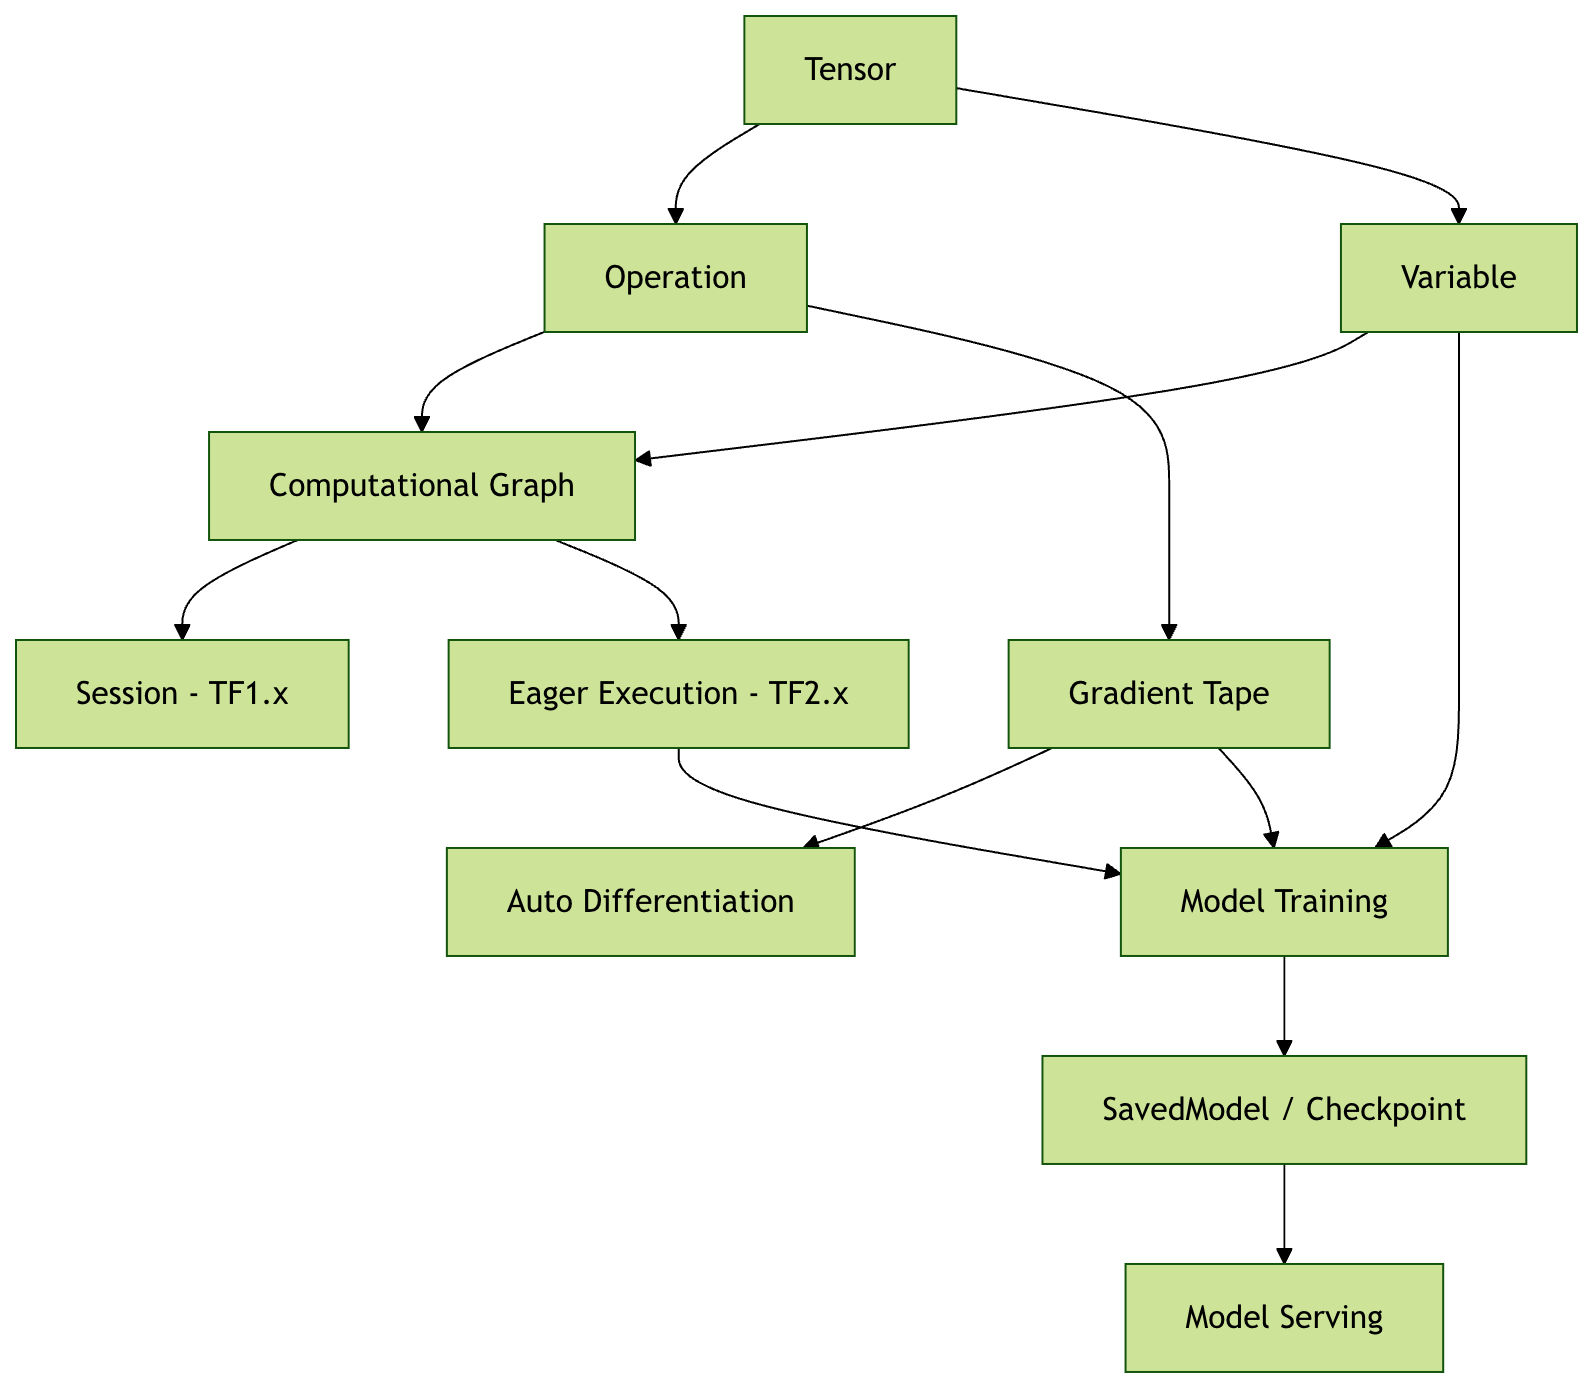
Diagramm der Konzeptbeziehungen
Beziehungen zwischen TensorFlow-Kernkonzepten:
输入数据 (Tensor) ──→ 计算图 (Graph) ──→ 输出结果 (Tensor)
      ↑                    ↓
   常量/变量            前向传播
      ↑                    ↓
   参数存储 ←──── 梯度更新 ←──── 自动微分
                              ↑
                        GradientTape