Типы данных R
Типы данных относятся к широкой системе, используемой для объявления переменных или функций разных типов.
Тип переменной определяет пространство, которое она занимает в памяти, и то, как интерпретируется сохранённый битовый шаблон.
В языке R в основном есть три самых базовых типа данных:
- Numeric
- Логический
- Текст
Существует в основном два типа числовых констант:
| Обычный тип | 123 -0.125 |
|---|---|
| Экспоненциальная запись | 1.23e2 -1.25E-1 |
Логический тип часто называют Boolean во многих других языках программирования, а его константные значения — толькоTRUEиFALSE。
Примечание:Язык R чувствителен к регистру; true или True не могут представлять TRUE.
Самый интуитивно понятный тип данных — это текстовый тип. Текст — это строка (String), часто встречающаяся в других языках, а константы заключаются в двойные кавычки. В R текстовые константы можно заключать как в одинарные, так и в двойные кавычки, например:
Пример
[1] ИСТИНА
Что касается определения переменных в R, в отличие от синтаксических правил некоторых строго типизированных языков, где нужно специально задавать имя и тип данных переменной, в R всякий раз, когда вы используете оператор присваивания, вы фактически определяете новую переменную:
Пример
b <- ИСТИНА
b = "abc"
В зависимости от типа объекта выделяют следующие 6 типов (они будут подробно рассмотрены позже):
- Вектор
- Список
- Matrix
- Массив
- Фактор
- Фрейм данных
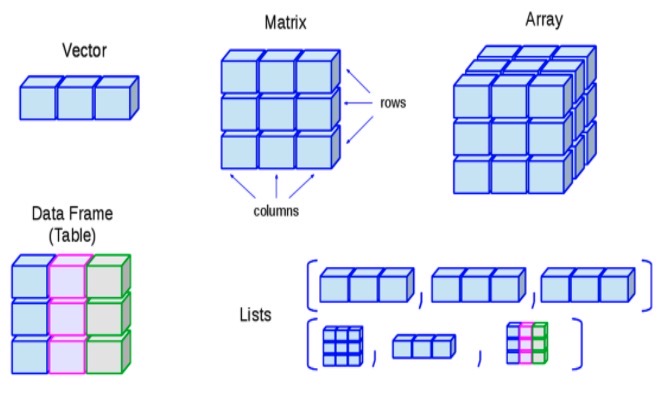
Вектор
Вектор часто предоставляется в стандартных библиотеках специализированных языков программирования, таких как Java, Rust и C#, потому что вектор — незаменимый инструмент в математических операциях; наиболее часто встречающийся нам вектор — двумерный вектор, который обязательно используется в плоской системе координат.
С точки зрения структуры данных вектор — это линейный список, который можно рассматривать как массив.
В R наличие вектора как типа упрощает операции над векторами:
Пример
> b = c(5, 0)
> a + b
[1] 8 4
>
c()это функция, создающая векторы.
Здесь два двумерных вектора складываются, чтобы получить новый двумерный вектор (8, 4). Если выполнить операцию над двумерным вектором и трёхмерным вектором, она потеряет математический смысл; хотя выполнение не остановится, будет выдано предупреждение.
Я советую всем выработать привычку не допускать возникновения такой ситуации.
Каждый элемент вектора можно извлечь отдельно по индексу:
Пример
> a[2]
[1] 20
Note:В R «индекс» не обозначает смещение, а обозначает порядковый номер, то есть начинается с 1!
R также может легко извлечь часть вектора:
Пример
[1] 10 20 30 40
> a[c(1, 3, 5)] # Извлечь элементы 1, 3, 5
[1] 10 30 50
> a[c(-1, -5)] # Удалить элементы 1 и 5
[1] 20 30 40
Эти три метода частичного извлечения используются чаще всего.
Векторы поддерживают скалярные вычисления:
Пример
[1] 0.6 0.7 0.8
> a = c(1,2)
> a ^ 2
[1] 1 4
Рассмотренные ранее часто используемые математические функции, такие как sqrt, exp и т. д., также могут применяться для скалярных операций над векторами.
Как структура линейного списка, "вектор" должен иметь некоторые общие функции обработки линейных списков; в R такие функции действительно есть:
Сортировка вектора:
Пример
> сортировка(a)
[1] 1 2 3 4 5 6
> rev(a)
[1] 6 4 2 5 3 1
> order(a)
[1] 1 4 2 5 3 6
> a[order(a)]
[1] 1 2 3 4 5 6
Функция order() возвращает вектор индексов после сортировки вектора.
Статистика вектора
В R есть очень полный набор статистических функций:
| Имя функции | Значение |
|---|---|
| sum | Sum |
| mean | Среднее |
| var | Вариантность |
| sd | Стандартное отклонение |
| min | Минимальное значение |
| max | Максимальное значение |
| range | Диапазон (максимальное и минимальное значения) |
Пример статистики вектора:
Пример
[1] 15
> sd(1:5)
[1] 1.581139
> range(1:5)
[1] 1 5
Генерация векторов
Векторы можно генерировать с помощьюc()функции, или использовать оператор min:max для генерации непрерывной последовательности.
Если вы хотите сгенерировать арифметическую последовательность с интервалами, можно использовать функцию seq :
> seq(1, 9, 2)
[1] 1 3 5 7 9
seq также может генерировать арифметическую последовательность от m до n, просто укажите m, n и длину последовательности:
> seq(0, 1, length.out=3)
[1] 0.0 0.5 1.0
rep означает «повторение» и может использоваться для генерации повторяющихся числовых последовательностей:
> rep(0, 5)
[1] 0 0 0 0 0
NA и NULL часто используются в векторах. Здесь мы познакомимся с этими двумя терминами и их различиями:
- NA обозначает «пропущенное значение», NULL обозначает «несуществующее».
- NA (пропущенное значение) — это как заполнитель, означающий, что здесь нет значения, но позиция существует.
- NULL означает, что данные не существуют.
Пояснение к примеру:
Пример
[1] 2
> c(NA, NA, NULL, NA)
[1] NA NA NA
Очевидно, NULL не имеет смысла в векторе.
Логический
Логические векторы в основном используются для логических операций над векторами, например:
Пример
[1] FALSE FALSE TRUE
Функция which — очень распространённая функция обработки логических векторов, которую можно использовать для фильтрации индексов нужных нам данных:
Пример
> b = a > 12
> print(b)
[1] FALSE FALSE TRUE
> which(b)
[1] 3
Например, нам нужно отфильтровать данные больше или равные 60 и меньше 70 из линейного списка:
Пример
> print(vector[which(vector >= 60 & vector < 70)])
[1] 64 62 69
Похожие функции включают all и any:
Пример
[1] ИСТИНА
> all(c(TRUE, TRUE, FALSE))
[1] FALSE
> any(c(TRUE, FALSE, FALSE))
[1] ИСТИНА
> any(c(FALSE, FALSE, FALSE))
[1] FALSE
all() используется для проверки, все ли элементы логического вектора равны TRUE, any() используется для проверки, содержит ли логический вектор TRUE.
String
Сам строковый тип данных не сложен; здесь мы сосредоточимся на представлении функций для работы со строками:
Пример
[1] "EXAMPLE"
> tolower("Example") # Преобразовать в нижний регистр
[1] "example"
> nchar(Chinese, type="bytes") # Подсчитать длину в байтах
[1] 4
> nchar(Chinese, type="char") # Подсчитать количество символов
[1] 2
> substr("123456789", 1, 5) # Извлечь подстроку, с 1 по 5
[1] "12345"
> substring("1234567890", 5) # Извлечь подстроку, с 5 до конца
[1] "567890"
> as.numeric("12") # Преобразовать строку в число
[1] 12
> as.character(12.34) # Преобразовать число в строку
[1] "12.34"
> strsplit("2019;10;1", ";") # Разделить строку по разделителю
[[1]]
[1] "2019" "10" "1"
> gsub("/", "-", "2019/10/1") # Заменить строку
[1] "2019-10-1"
На компьютерах с Windows используется стандарт кодировки GBK, поэтому один китайский иероглиф занимает два байта. Если работать на компьютере с кодировкой UTF-8, длина одного китайского иероглифа в байтах должна быть 3.
R поддерживает регулярные выражения в формате языка Perl:
Пример
[1] "$ $"
Для получения дополнительной информации о строках см.:Введение в строки в языке R。
Matrix
Язык R предоставляет тип матрицы для исследований в области линейной алгебры. Эта структура данных очень похожа на двумерные массивы в других языках, но R обеспечивает поддержку операций с матрицами на уровне языка.
Сначала рассмотрим создание матрицы:
Пример
> matrix(vector, 2, 3)
[,1] [,2] [,3]
[1,] 1 3 5
[2,] 2 4 6
Содержимое для инициализации матрицы передаётся вектором, а во-вторых, нужно указать, сколько строк и столбцов имеет матрица.
Значения в векторе заполняют матрицу по столбцам. Если вы хотите заполнять по строкам, нужно указать атрибут byrow:
Пример
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 4 5 6
Каждое значение в матрице можно получить напрямую:
Пример
> m1[1,1] # Строка 1, Столбец 1
[1] 1
> m1[1,3] # Строка 1, Столбец 3
[1] 3
В R каждой строке и каждому столбцу матрицы можно присвоить имя; это выполняется пакетно с помощью строкового вектора:
Пример
> rownames(m1) = c("a", "b")
> m1
x y z
a 1 2 3
b 4 5 6
> m1["a", ]
x y z
1 2 3
Четыре основные арифметические операции над матрицами в основном такие же, как и над векторами; их можно выполнять со скалярами или с матрицами одинакового размера по соответствующим позициям.
Умножение матриц:

Пример
> m2 = matrix(c(3, 4), 2, 1)
> m1 %*% m2
[,1]
[1,] 11
Обратная матрица:

Пример
> решить(A)
[,1] [,2]
[1,] -2.0 1.0
[2,] 1.5 -0.5
solve()-функция используется для решения уравнений линейной алгебры; базовое использование —solve(A,b), гдеA— матрица коэффициентов системы уравнений,b— вектор или матрица в уравнении.
apply()-функция позволяет рассматривать каждую строку или столбец матрицы как вектор для операций:
Пример
[,1] [,2]
[1,] 1 2
[2,] 3 4
> apply(A, 1, sum) # Второй параметр равен 1 для операции по строкам, используйте функцию sum()
[1] 3 7
> apply(A, 2, sum) # Второй параметр равен 2 для операции по столбцам
[1] 4 6
Для получения дополнительной информации о матрицах см.:Матрицы в R。
Другие расширения