R-Datentypen
Datentypen beziehen sich auf ein umfassendes System, das verwendet wird, um Variablen oder Funktionen unterschiedlicher Typen zu deklarieren.
Der Typ einer Variablen bestimmt den Speicherplatz, den sie belegt, und wie das gespeicherte Bitmuster interpretiert wird.
In der Sprache R gibt es hauptsächlich drei grundlegendste Datentypen:
- Numeric
- Logisch
- Text
Es gibt hauptsächlich zwei Arten von numerischen Konstanten:
| Allgemeiner Typ | 123 -0.125 |
|---|---|
| Wissenschaftliche Notation | 1.23e2 -1.25E-1 |
Der logische Typ wird in vielen anderen Programmiersprachen oft Boolean genannt, und seine Konstantenwerte sind nurTRUEundFALSE。
Hinweis:Die Sprache R unterscheidet zwischen Groß- und Kleinschreibung; true oder True können TRUE nicht darstellen.
Der intuitivste Datentyp ist der Texttyp. Text ist der String (String), den man oft in anderen Sprachen sieht, und Konstanten werden in doppelte Anführungszeichen gesetzt. In R können Textkonstanten entweder in einfache oder doppelte Anführungszeichen gesetzt werden, zum Beispiel:
Beispiel
[1] WAHR
Bei der Variablendefinition in R definieren Sie, wann immer Sie einen Zuweisungsoperator verwenden, tatsächlich eine neue Variable, im Gegensatz zu den Syntaxregeln in einigen stark typisierten Sprachen, bei denen Sie einen Namen und einen Datentyp für eine Variable explizit festlegen müssen:
Beispiel
b <- WAHR
b = "abc"
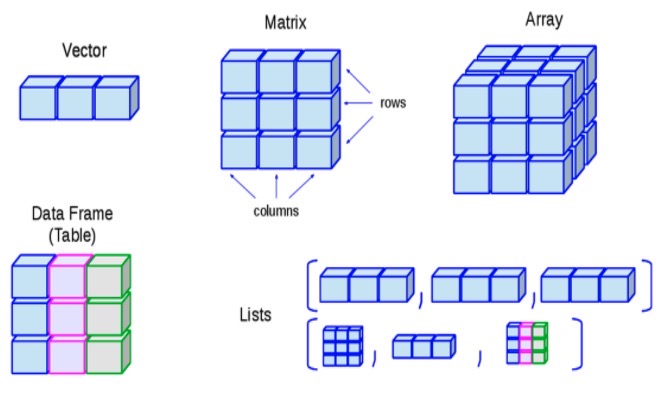
Nach Objekttyp unterteilt gibt es die folgenden 6 Typen (diese werden später ausführlich vorgestellt):
- Vektor
- Liste
- Matrix
- Array
- Faktor
- Datenrahmen
Vektor
Der Vektor wird oft in den Standardbibliotheken spezialisierter Programmiersprachen wie Java, Rust und C# bereitgestellt, weil der Vektor ein unverzichtbares Werkzeug in mathematischen Operationen ist — der häufigste Vektor, dem wir begegnen, ist der zweidimensionale Vektor, der notwendigerweise in einem ebenen Koordinatensystem verwendet wird.
Aus Sicht der Datenstruktur ist ein Vektor eine lineare Liste, die als Array betrachtet werden kann.
In R erleichtert die Existenz des Vektors als Typ die Vektoroperationen:
Beispiel
> b = c(5, 0)
> a + b
[1] 8 4
>
c()ist eine Funktion, die Vektoren erstellt.
Hier werden zwei zweidimensionale Vektoren addiert, um einen neuen zweidimensionalen Vektor (8, 4) zu erhalten. Wenn Sie eine Operation mit einem zweidimensionalen Vektor und einem dreidimensionalen Vektor durchführen, verliert dies die mathematische Bedeutung; obwohl die Ausführung nicht stoppt, wird eine Warnung ausgegeben.
Ich schlage vor, dass sich jeder angewöhnt, diese Situation zu verhindern.
Jedes Element in einem Vektor kann einzeln über den Index extrahiert werden:
Beispiel
> a[2]
[1] 20
Hinweis:In R stellt der "Index" keinen Offset dar, sondern die Ordnungsposition, das heißt, er beginnt bei 1!
R kann auch leicht einen Teil eines Vektors extrahieren:
Beispiel
[1] 10 20 30 40
> a[c(1, 3, 5)] # Extrahiere Elemente 1, 3, 5
[1] 10 30 50
> a[c(-1, -5)] # Entferne Elemente 1 und 5
[1] 20 30 40
Diese drei Methoden zur partiellen Extraktion sind die am häufigsten verwendeten.
Vektoren unterstützen Skalarberechnungen:
Beispiel
[1] 0.6 0.7 0.8
> a = c(1,2)
> a ^ 2
[1] 1 4
Die zuvor beschriebenen häufig verwendeten mathematischen Funktionen wie sqrt, exp usw. können auch für Skalaroperationen auf Vektoren verwendet werden.
Als lineare Listenstruktur sollte "vector" einige gängige Funktionen zur Verarbeitung linearer Listen besitzen; R besitzt diese Funktionen tatsächlich:
Sortieren von Vektoren:
Beispiel
> sortieren(a)
[1] 1 2 3 4 5 6
> rev(a)
[1] 6 4 2 5 3 1
> order(a)
[1] 1 4 2 5 3 6
> a[order(a)]
[1] 1 2 3 4 5 6
Die Funktion order() gibt nach dem Sortieren des Vektors einen Indexvektor zurück.
Vektorstatistik
R verfügt über sehr umfassende statistische Funktionen:
| Funktionsname | Bedeutung |
|---|---|
| sum | Sum |
| mean | Durchschnittlich |
| var | Varianz |
| sd | Standardabweichung |
| min | Minimaler Wert |
| max | Maximaler Wert |
| range | Bereich (Maximal- und Minimalwerte) |
Beispiel für Vektorstatistiken:
Beispiel
[1] 15
> sd(1:5)
[1] 1.581139
> range(1:5)
[1] 1 5
Vektorgenerierung
Vektoren können mithilfe derc()Funktion erzeugt werden, oder verwenden Sie den min:max-Operator, um eine fortlaufende Sequenz zu erzeugen.
Wenn Sie eine arithmetische Folge mit Intervallen erzeugen möchten, können Sie die seq Funktion verwenden:
> seq(1, 9, 2)
[1] 1 3 5 7 9
seq kann auch eine arithmetische Folge von m bis n erzeugen; geben Sie einfach m, n und die Länge der Folge an:
> seq(0, 1, length.out=3)
[1] 0.0 0.5 1.0
rep bedeutet wiederholen und kann verwendet werden, um wiederholte Zahlenfolgen zu erzeugen:
> rep(0, 5)
[1] 0 0 0 0 0
NA und NULL werden häufig in Vektoren verwendet. Hier stellen wir diese beiden Begriffe und ihre Unterschiede vor:
- NA steht für "fehlend", NULL steht für "nicht vorhanden".
- NA fehlend ist wie ein Platzhalter; das bedeutet, dass hier kein Wert vorhanden ist, aber die Position existiert.
- NULL bedeutet, dass die Daten nicht existieren.
Beispielerklärung:
Beispiel
[1] 2
> c(NA, NA, NULL, NA)
[1] NA NA NA
Offensichtlich hat NULL in einem Vektor keine Bedeutung.
Logisch
Logische Vektoren werden hauptsächlich für logische Operationen auf Vektoren verwendet, zum Beispiel:
Beispiel
[1] FALSE FALSE TRUE
Die Funktion which ist eine sehr verbreitete Funktion zur Verarbeitung logischer Vektoren, mit der die Indizes der benötigten Daten gefiltert werden können:
Beispiel
> b = a > 12
> print(b)
[1] FALSE FALSE TRUE
> which(b)
[1] 3
Zum Beispiel müssen wir aus einer linearen Liste Daten filtern, die größer oder gleich 60 und kleiner als 70 sind:
Beispiel
> print(vector[which(vector >= 60 & vector < 70)])
[1] 64 62 69
Ähnliche Funktionen sind all und any:
Beispiel
[1] WAHR
> all(c(TRUE, TRUE, FALSE))
[1] FALSE
> any(c(TRUE, FALSE, FALSE))
[1] WAHR
> any(c(FALSE, FALSE, FALSE))
[1] FALSE
all() wird verwendet, um zu prüfen, ob ein logischer Vektor vollständig TRUE ist; any() wird verwendet, um zu prüfen, ob ein logischer Vektor TRUE enthält.
String
Der String-Datentyp selbst ist nicht kompliziert; hier konzentrieren wir uns auf die Einführung von String-Operationsfunktionen:
Beispiel
[1] "BEISPIEL"
> tolower("Example") # In Kleinbuchstaben umwandeln
[1] "example"
> nchar(Chinese, type="bytes") # Byte-Länge zählen
[1] 4
> nchar(Chinese, type="char") # Anzahl der Zeichen zählen
[1] 2
> substr("123456789", 1, 5) # Teilzeichenkette extrahieren, von 1 bis 5
[1] "12345"
> substring("1234567890", 5) # Teilzeichenkette extrahieren, von 5 bis Ende
[1] "567890"
> as.numeric("12") # Zeichenkette in Zahl umwandeln
[1] 12
> as.character(12.34) # Zahl in Zeichenkette umwandeln
[1] "12.34"
> strsplit("2019;10;1", ";") # Zeichenkette nach Trennzeichen aufteilen
[[1]]
[1] "2019" "10" "1"
> gsub("/", "-", "2019/10/1") # Zeichenkette ersetzen
[1] "2019-10-1"
Auf Windows-Computern wird der GBK-Kodierungsstandard verwendet, daher sind ein chinesisches Zeichen zwei Bytes. Bei der Ausführung auf einem Computer mit UTF-8-Kodierung sollte die Bytelänge eines einzelnen chinesischen Zeichens 3 betragen.
R unterstützt reguläre Ausdrücke im Perl-Sprachformat:
Beispiel
[1] "$ $"
Weitere Informationen zu Zeichenketten finden Sie unter:Einführung in Zeichenketten in der Sprache R。
Matrix
Die Sprache R bietet einen Matrix-Typ für die Forschung im Bereich der linearen Algebra. Diese Datenstruktur ist zweidimensionalen Arrays in anderen Sprachen sehr ähnlich, aber R bietet Unterstützung auf Sprachebene für Matrixoperationen.
Sehen wir uns zunächst die Matrixerzeugung an:
Beispiel
> matrix(vector, 2, 3)
[,1] [,2] [,3]
[1,] 1 3 5
[2,] 2 4 6
Der Initialisierungsinhalt der Matrix wird durch einen Vektor übergeben, und zweitens muss angegeben werden, wie viele Zeilen und Spalten die Matrix hat.
Werte im Vektor füllen die Matrix spaltenweise. Wenn Sie zeilenweise füllen möchten, müssen Sie das Attribut byrow angeben:
Beispiel
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 4 5 6
Auf jeden Wert in der Matrix kann direkt zugegriffen werden:
Beispiel
> m1[1,1] # Zeile 1, Spalte 1
[1] 1
> m1[1,3] # Zeile 1, Spalte 3
[1] 3
In R kann jede Spalte und jede Zeile einer Matrix benannt werden; dieser Vorgang erfolgt stapelweise über einen Zeichenkettenvektor:
Beispiel
> rownames(m1) = c("a", "b")
> m1
x y z
a 1 2 3
b 4 5 6
> m1["a", ]
x y z
1 2 3
Die vier Grundrechenarten für Matrizen sind im Wesentlichen dieselben wie für Vektoren; sie können mit Skalaren oder mit Matrizen derselben Größe an den entsprechenden Positionen ausgeführt werden.
Matrixmultiplikation:

Beispiel
> m2 = matrix(c(3, 4), 2, 1)
> m1 %*% m2
[,1]
[1,] 11
Inverse Matrix:

Beispiel
> Lösen(A)
[,1] [,2]
[1,] -2.0 1.0
[2,] 1.5 -0.5
solve()-Funktion wird verwendet, um Gleichungen der linearen Algebra zu lösen; die grundlegende Verwendung istsolve(A,b), wobeiAdie Koeffizientenmatrix des Gleichungssystems ist,bder Vektor oder die Matrix in der Gleichung.
apply()-Funktion kann jede Zeile oder Spalte einer Matrix als Vektor für Operationen behandeln:
Beispiel
[,1] [,2]
[1,] 1 2
[2,] 3 4
> apply(A, 1, sum) # Der zweite Parameter ist 1 für zeilenweise Operation, verwende die Funktion sum()
[1] 3 7
> apply(A, 2, sum) # Der zweite Parameter ist 2 für spaltenweise Operation
[1] 4 6
Weitere Informationen zu Matrizen finden Sie unter:R-Matrix。
Weitere Erweiterungen