Ollama Cloud ローカルとクラウドのハイブリッド
ローカルのVRAMが足りないのに、数百Bパラメータの超大規模モデルを使いたい?Ollama Cloud は第三の選択肢を提供します。モデルはクラウド上のGPUで動作し、あなたのコードやツールチェーンは何の変化も感じません。
この章では、Cloud モデルの実行方法、API への直接接続、完全ローカルモード、退役メカニズムを紹介し、最後にハイブリッド利用の選定戦略を示します。
Cloud モデルとは
Cloud モデルは Ollama の新しいモデル形態です。重みは Ollama のクラウドに保存され、推論は公式 GPU クラスタで実行され、ローカルはリクエストの転送のみを担当します。
これが解決する課題は非常に具体的です。数百Bのフラッグシップオープンソースモデルは、往々にして数百GBのVRAMを必要とし、個人や小規模チームではローカルにデプロイできませんが、それを利用したいニーズは実際に存在します。
利用可能な Cloud モデルはモデルライブラリで cloud タグが付いています。qwen3.5 ファミリーを例にとると、フラッグシップ仕様は qwen3.5:cloud です。
Cloud モデルを実行する4つの方法
まず一度だけの準備を完了します:Ollama アカウントを登録してログインし、cloud タグをプルします(これは単なる「ポインタ」であり、重みはダウンロードされません)。
Ollama アカウントでログインします(クラウドモデルに必要):
ollama signin
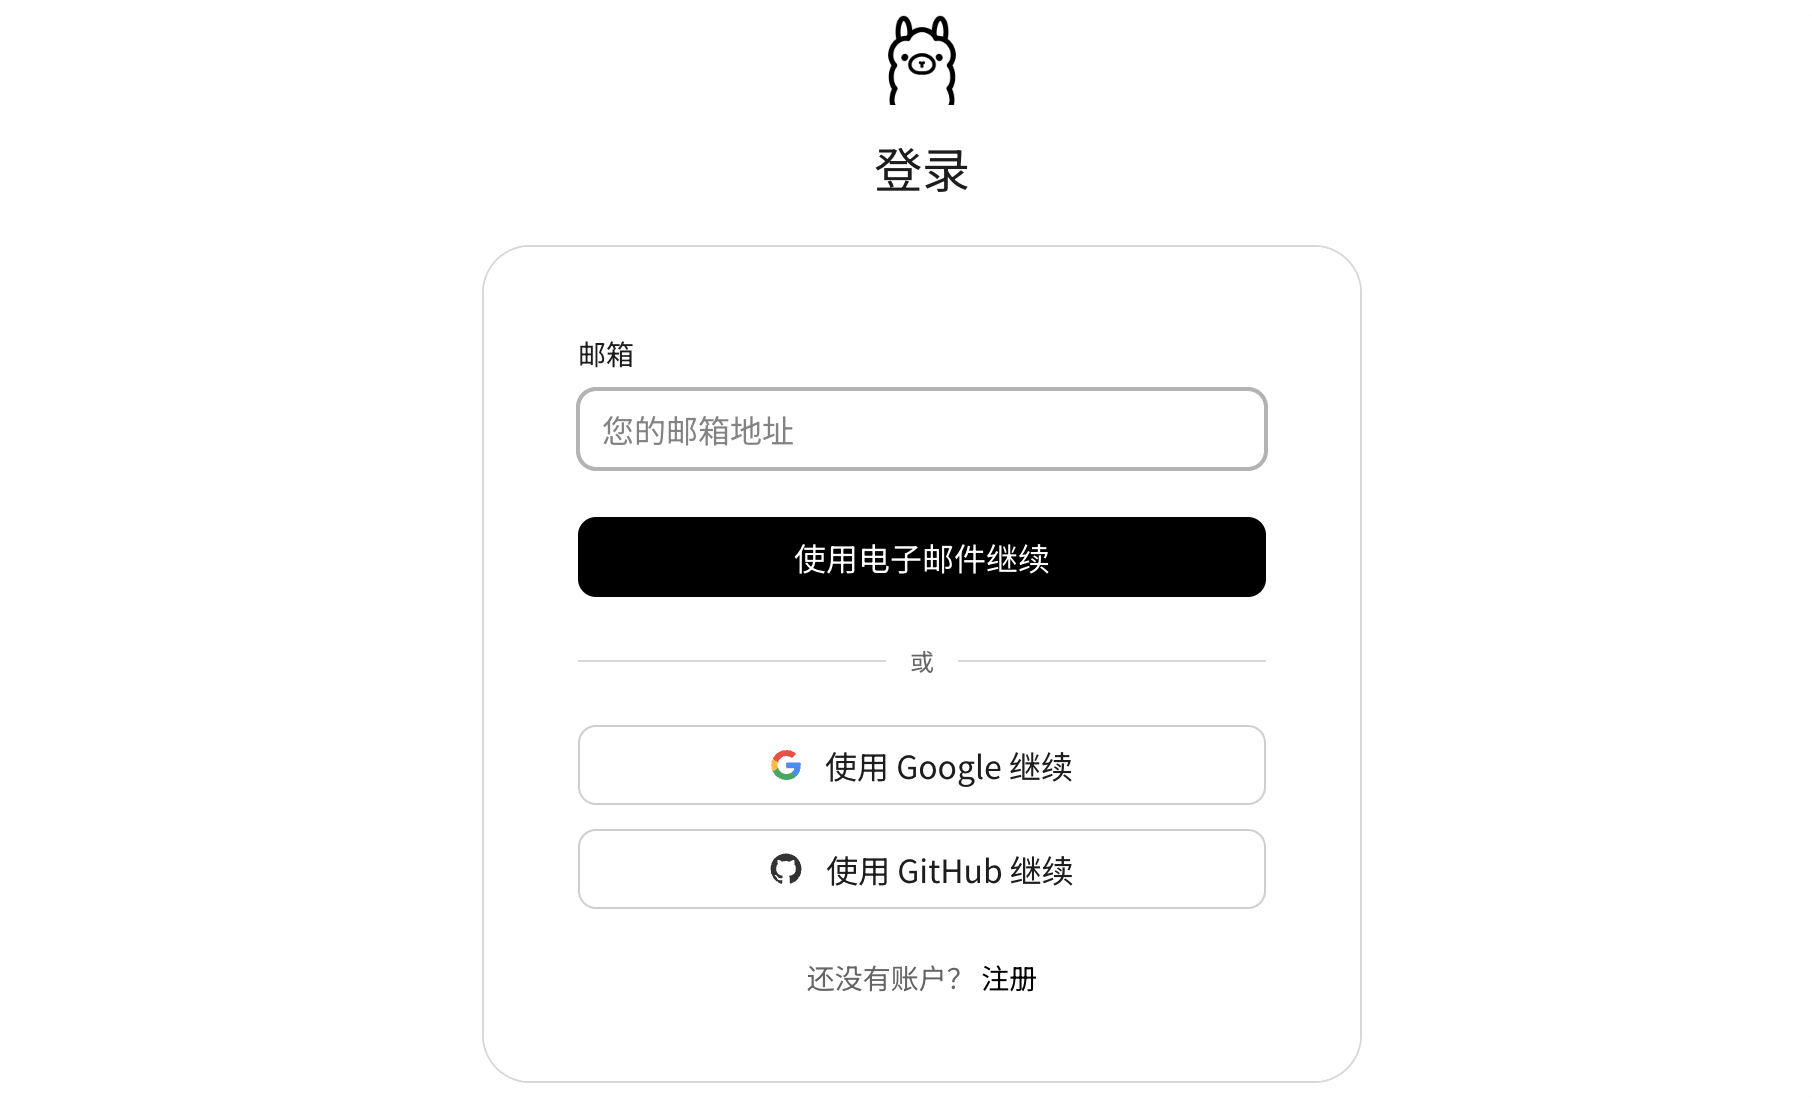
ブラウザに表示されるログインウィンドウでメールアドレスを入力するだけです(後で携帯電話での認証が必要な場合は、中国国内の携帯電話でOKです):
cloud タグをプルします。ほぼ瞬時に完了します:
ollama pull qwen3.5:cloud
実行します。ローカルモデルとまったく同じ体験です:
ollama run qwen3.5:cloud
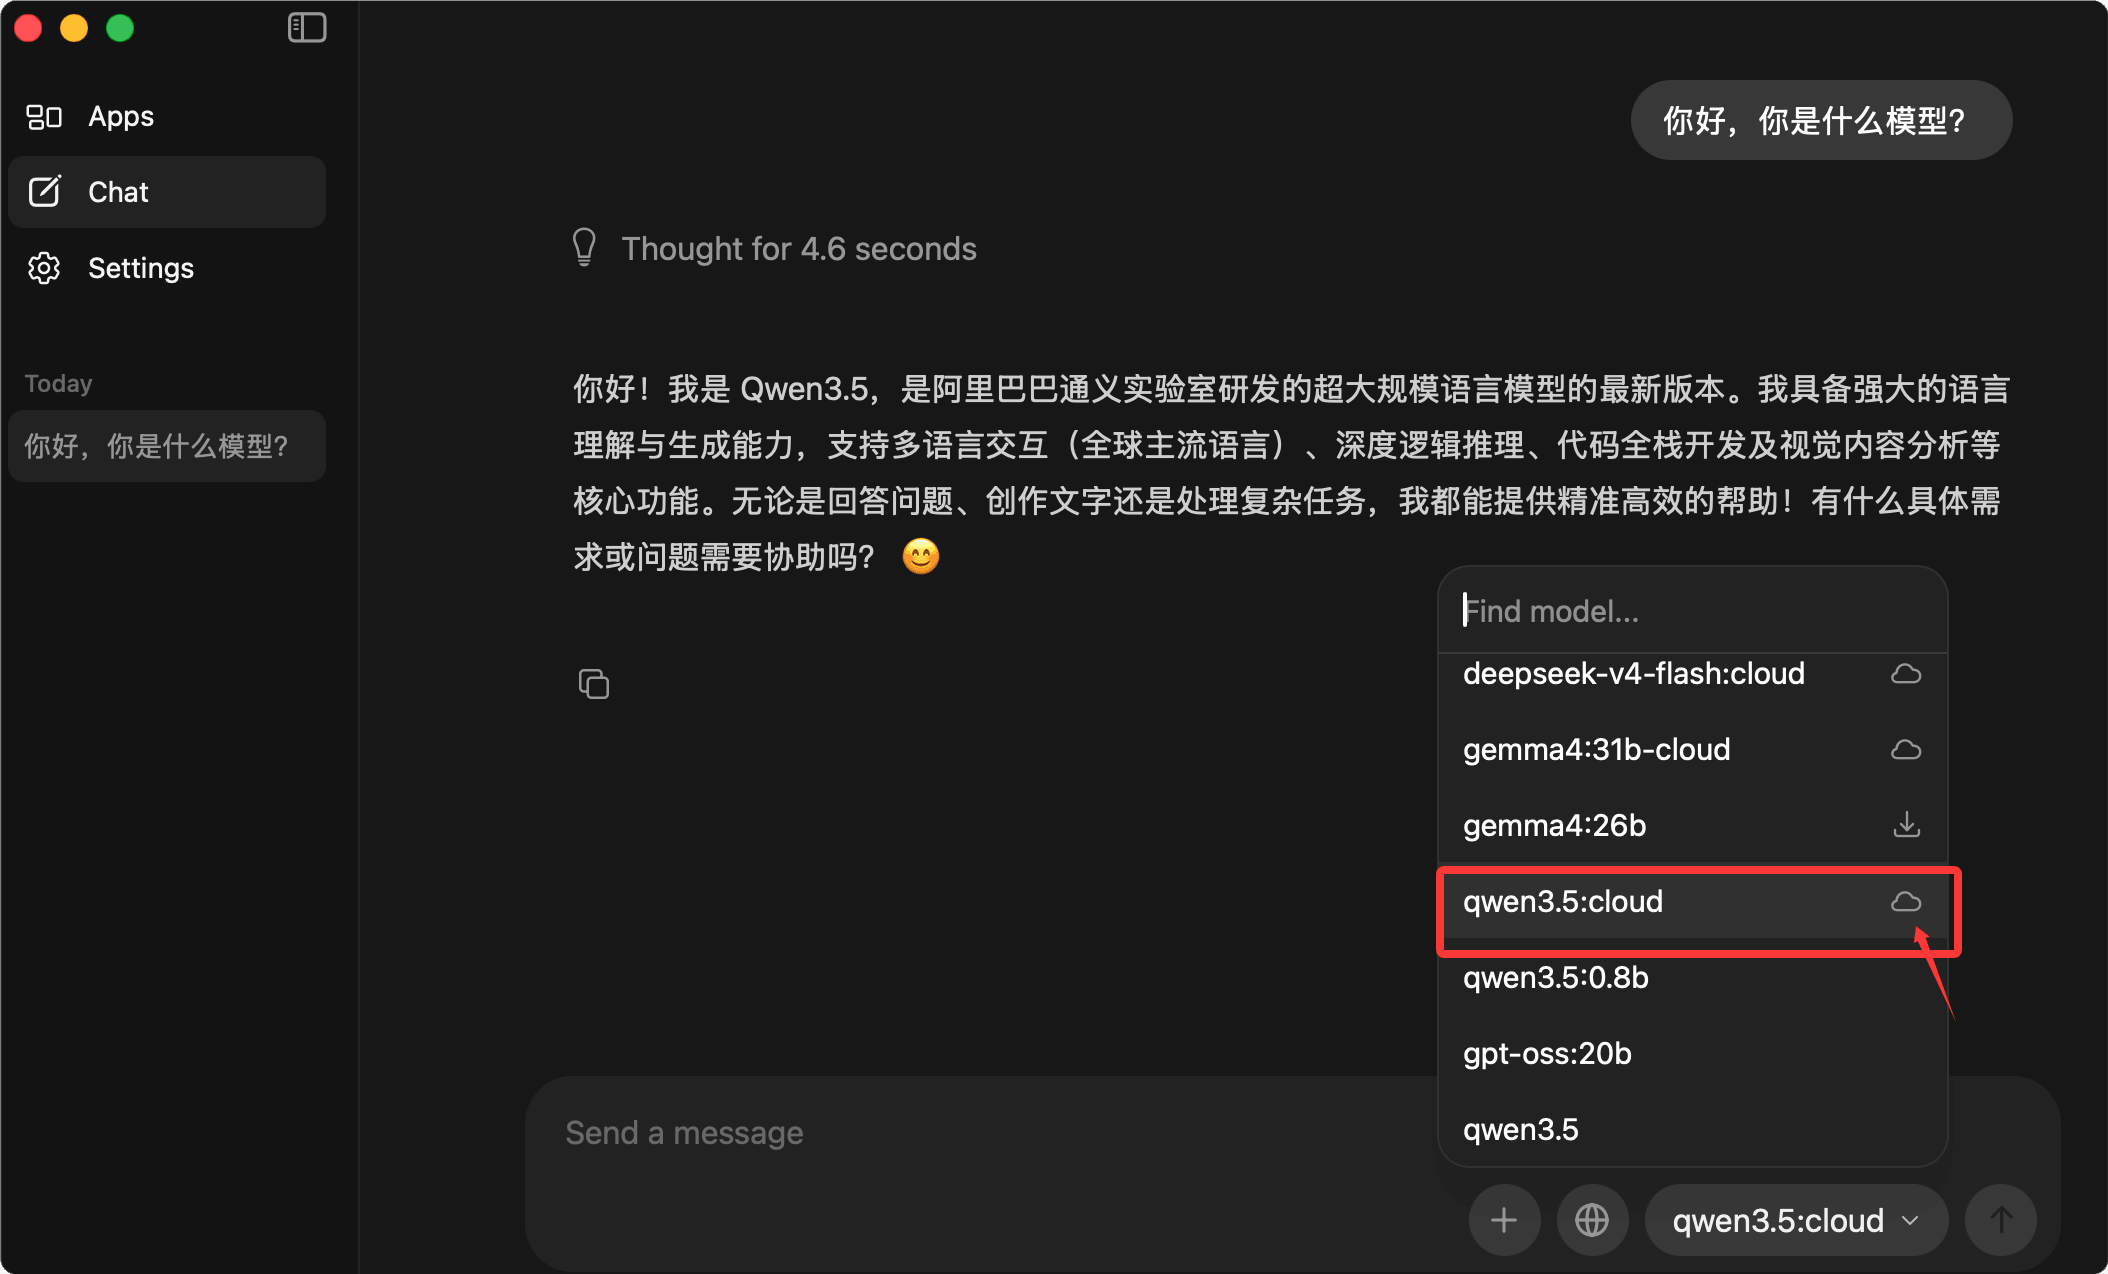
インターフェースにクラウドのアイコンが表示されます:
Python 呼び出し
例
# ローカルモデルとの唯一の違い:モデル名に :cloud が付く
stream = chat(
model='qwen3.5:cloud',
messages=[{'role': 'user', 'content': 'サンプル を一言で紹介してください'}],
stream=True,
)
for chunk in stream:
print(chunk.message.content, end='', flush=True)
JavaScript 呼び出し
例
const response = await ollama.chat({
model: 'qwen3.5:cloud',
messages: [{ role: 'user', content: 'サンプル を一言で紹介してください' }],
stream: true,
})
for await (const chunk of response) {
process.stdout.write(chunk.message.content)
}
curl 呼び出し
例
"model": "qwen3.5:cloud",
"messages": [{ "role": "user", "content": "サンプル を一言で紹介してください" }],
"stream": false
}'
透過転送:ローカル API でもクラウドモデルを呼び出せる
Cloud の優れた点は、転送ロジックが完全にローカルサービスによって処理されることです。

localhost:11434 に :cloud モデルをリクエストすると、ローカルサービスがクラウドへの認証と転送を自動的に完了します。アプリケーションコード、Agent ツール、エディタ統合はまったく意識する必要がありません。
これは、既存の統合がすぐに大規模モデルの能力を利用できることを意味します。Claude Code のモデル名を qwen3.5:cloud に変更するだけで、同じツールチェーンがフラッグシップ仕様に切り替わります。
現在、既知の機能制限が1つあります:Cloud モデルは構造化出力(format パラメータ)をまだサポートしていません。JSON Schema による制約が必要なタスクは、ローカルモデルに割り当てるか、アプリケーション層で自分で解析する必要があります。
ollama.com/api への直接接続
ローカルサービス経由の転送に加えて、ローカルをスキップしてクラウド API を直接呼び出すこともできます。サーバーに Ollama がインストールされていないシナリオに適しています。
まず公式サイトの設定ページで API Key を作成し、その後 Bearer 方式で送信します:
例
curl https://ollama.com/api/chat \
-H "Authorization: Bearer $OLLAMA_API_KEY" \
-d '{
"model": "qwen3.5",
"messages": [{ "role": "user", "content": "サンプル を一言で紹介してください" }],
"stream": false
}'
# クラウドでも利用可能なモデルを一覧表示できる
curl https://ollama.com/api/tags
公式 SDK も host と認証ヘッダーの指定をサポートしています。接続方法はプログラミング接続の章の Client(host=...) の例を参照し、host を https://ollama.com に変更するだけです。
API Key は現在のところ有効期限がありませんが、いつでも公式サイトの設定ページで失効させることができます。これはクラウド利用の認証情報に相当するため、コードリポジトリにコミットしないでください。
完全ローカルモード:クラウドを完全に無効化
データの外部送信を一切許容しないチームは、Ollama のクラウド機能をすべて無効化して、純粋なローカルソフトウェアにすることができます。
2つの無効化方法のいずれかを選択し、変更後 Ollama を再起動すると有効になります:
例
# { "disable_ollama_cloud": true }
# 方法2:環境変数
OLLAMA_NO_CLOUD=1 ollama serve
# 有効化後、ログに「Ollama cloud disabled: true」が表示されます
クラウド機能を無効化すると、クラウドモデルとオンライン検索機能の両方が失われますが、ローカルモデルのすべての機能には影響しません。ファイアウォールで送信トラフィックをブロックすれば、完全に物理的に分離されたモデルサービスを構築できます。
クラウドモデルの退役メカニズム
クラウドモデルにはライフサイクルがあります。より強力なオープンソースモデルのリリースに伴い、公式は定期的に古いクラウドモデルを退役させ、メールと公式サイトのアナウンスで事前に通知し、推奨される代替モデルも示します。
公式アナウンスの形式は「退役日 - モデル - 推奨代替」の対応表です。例えば、あるクラウドモデルがいつ廃止され、どの新バージョンに移行するかが示されるので、そのとおりにモデル名を変更するだけです。
エンジニアリング上の2つのアドバイス:
1つ目は、自動化プロセスでクラウドモデルを参照する際、モデル名をハードコードせず設定項目にすることです。退役時の切り替えでは設定を変更するだけで済みます。
2つ目は、重要な業務には同等の能力を持つローカル代替モデルを準備しておき、クラウドモデルの退役やネットワーク異常時にすぐにダウングレードできるようにすることです。
退役はクラウドモデルにのみ適用されます。ローカルにダウンロードしたモデルの重みは常に使用可能であり、これが本チュートリアルが常にローカルを主軸とすることを強調している理由です。
選定戦略:いつどれを使うか
| シナリオ | 推奨ソリューション | 理由 |
|---|---|---|
| VRAMに収まる日常的なタスク | ローカルモデル | ゼロコスト、ゼロレイテンシ、データがデバイスから出ない |
| プライバシー機密データ | ローカルモデル(または完全ローカルモード) | コンプライアンスと制御が可能 |
| 超大規模モデルのニーズ / GPU デバイスなし | Cloud モデル | ハードウェア投資不要、ツールチェーンは変更なし |
| 新モデルの試用 | まず Cloud で試し、価値を確認してからローカル化 | 試用のためのハードウェア購入を回避 |
| 長期的な自動化プロセス | ローカル主体 + クラウド予備 | クラウドには退役メカニズムがあり、ローカルにはそのリスクがない |
ハイブリッドアーキテクチャのベストプラクティスを一言で:日常のトラフィックはローカル、重量タスクは必要に応じて :cloud、モデル名はすべて設定ファイルに。
その他の拡張