Conceptos básicos de Ollama
Ollama es un framework de aprendizaje automático localizado que admite múltiples tareas de procesamiento de lenguaje natural (NLP), centrado en la carga de modelos, la inferencia y las tareas de generación.
Con Ollama, los usuarios pueden interactuar fácilmente con grandes modelos preentrenados implementados localmente.
1. Modelo
En Ollama, los modelos son el componente central. Son modelos de aprendizaje automático preentrenados que pueden realizar diferentes tareas, como generación de texto, resumen de texto, análisis de sentimientos, generación de diálogos, etc.
Ollama admite varios modelos preentrenados populares; algunos modelos comunes son:
- deepseek-v3: modelo de lenguaje grande proporcionado por DeepSeek, especializado en tareas de generación de texto.
- LLama2: modelo de lenguaje grande proporcionado por Meta, especializado en tareas de generación de texto.
- GPT: modelos de la serie GPT de OpenAI, adecuados para una amplia gama de tareas como generación de diálogos y razonamiento de texto.
- BERT: modelos preentrenados para comprensión de oraciones y sistemas de preguntas y respuestas.
- Otros modelos personalizados: los usuarios pueden cargar sus propios modelos personalizados y utilizar Ollama para la inferencia.
Funciones principales de los modelos:
- Inferencia: generar resultados de salida según la entrada del usuario.
- Ajuste fino (Fine-tuning): los usuarios pueden entrenar el modelo con sus propios datos basándose en un modelo existente, personalizándolo así para tareas o dominios específicos.
Los modelos suelen ser redes neuronales compuestas por una gran cantidad de parámetros. Al entrenarse con grandes volúmenes de datos de texto, pueden aprender patrones del lenguaje y realizar inferencias eficientes.
Los modelos compatibles con Ollama se pueden consultar en:https://ollama.com/library
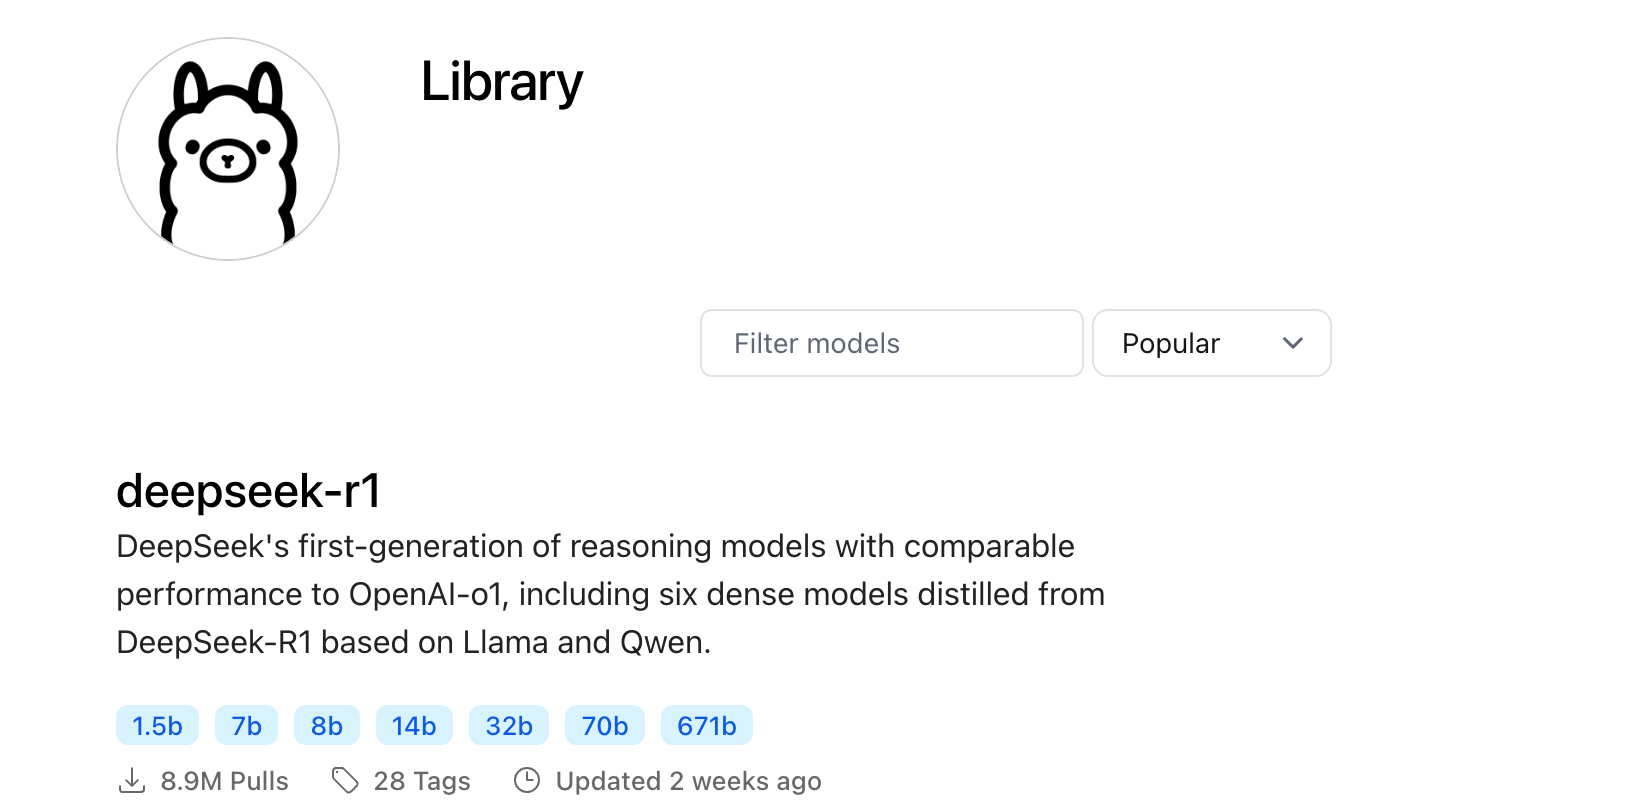
Haz clic en un modelo para ver el comando de descarga:
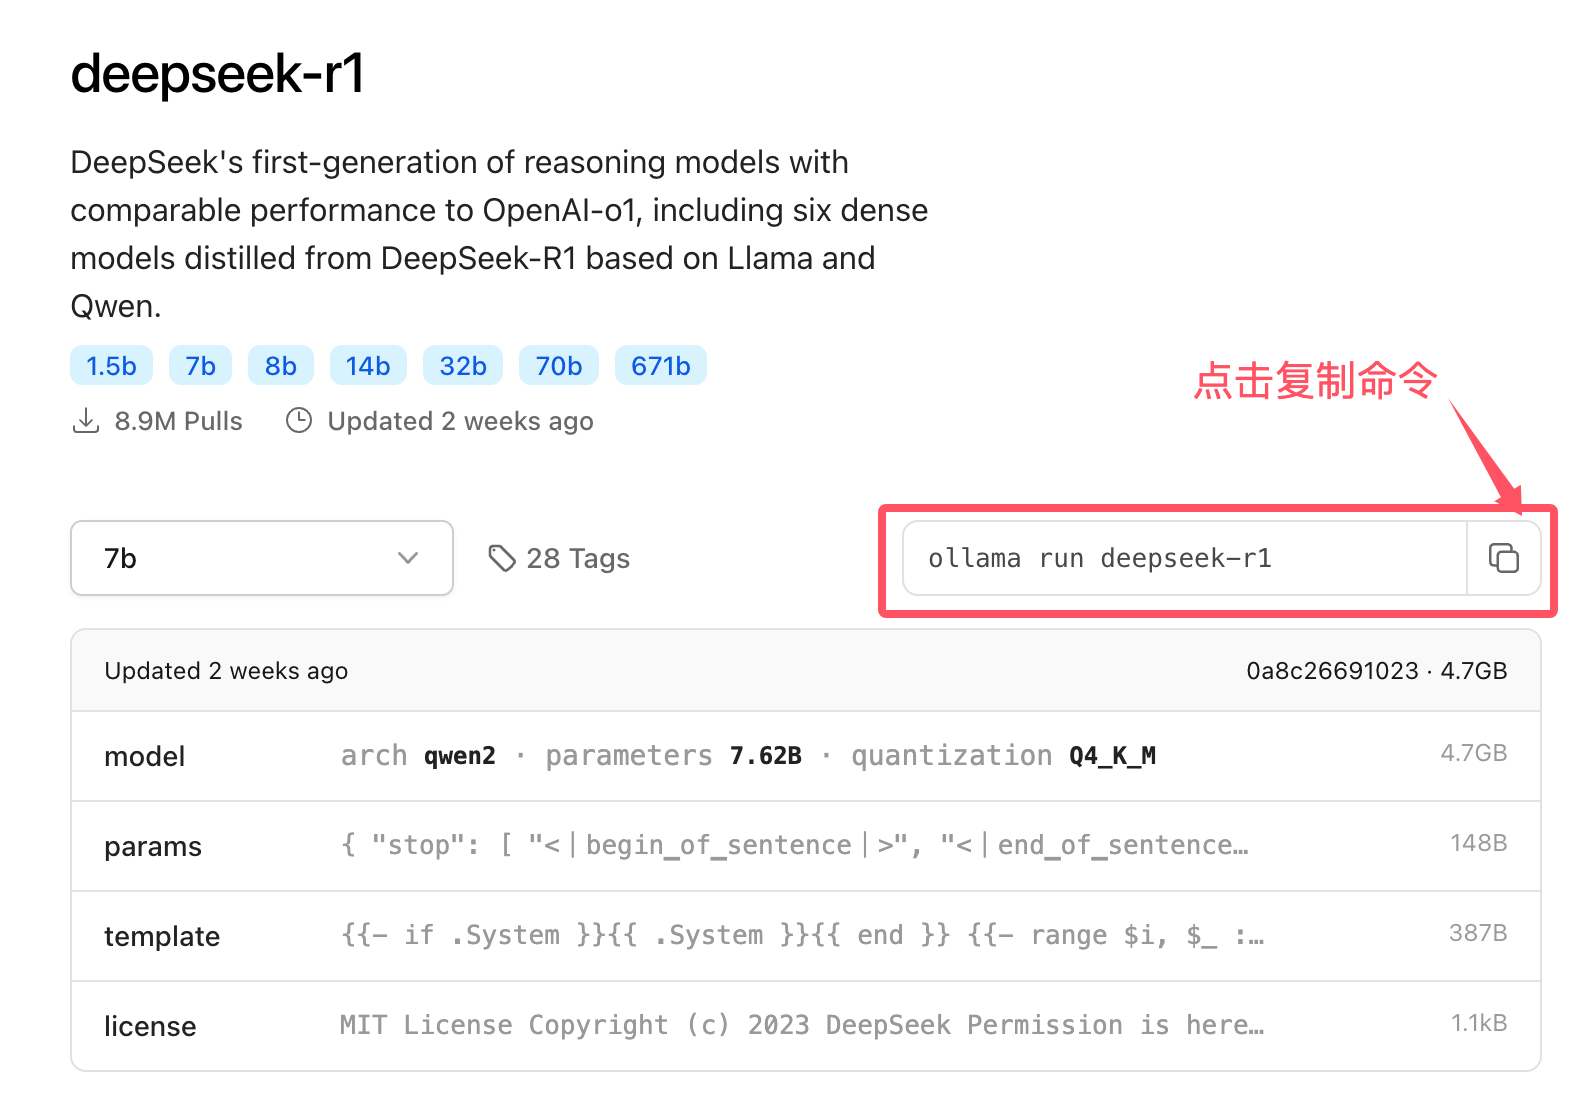
La siguiente tabla enumera los comandos de descarga de algunos modelos:
| Modelo | Parámetros | Tamaño | Comando de descarga |
|---|---|---|---|
| Llama 3.3 | 70B | 43GB | ollama run llama3.3 |
| Llama 3.2 | 3B | 2.0GB | ollama run llama3.2 |
| Llama 3.2 | 1B | 1.3GB | ollama run llama3.2:1b |
| Llama 3.2 Vision | 11B | 7.9GB | ollama run llama3.2-vision |
| Llama 3.2 Vision | 90B | 55GB | ollama run llama3.2-vision:90b |
| Llama 3.1 | 8B | 4.7GB | ollama run llama3.1 |
| Llama 3.1 | 405B | 231GB | ollama run llama3.1:405b |
| Phi 4 | 14B | 9.1GB | ollama run phi4 |
| Phi 3 Mini | 3.8B | 2.3GB | ollama run phi3 |
| Gemma 2 | 2B | 1.6GB | ollama run gemma2:2b |
| Gemma 2 | 9B | 5.5GB | ollama run gemma2 |
| Gemma 2 | 27B | 16GB | ollama run gemma2:27b |
| Mistral | 7B | 4.1GB | ollama run mistral |
| Moondream 2 | 1.4B | 829MB | ollama run moondream |
| Neural Chat | 7B | 4.1GB | ollama run neural-chat |
| Starling | 7B | 4.1GB | ollama run starling-lm |
| Code Llama | 7B | 3.8GB | ollama run codellama |
| Llama 2 Uncensored | 7B | 3.8GB | ollama run llama2-uncensored |
| LLaVA | 7B | 4.5GB | ollama run llava |
| Solar | 10.7B | 6.1GB | ollama run solar |
2. Tarea
Ollama admite múltiples tareas de NLP. Cada tarea corresponde a un escenario de aplicación diferente del modelo; incluye principalmente, entre otras, las siguientes:
- Generación de diálogos (Chat Generation): generar respuestas de conversación naturales mediante la interacción con el usuario.
- Generación de texto (Text Generation): generar texto en lenguaje natural a partir de una indicación dada, como escribir artículos, generar historias, etc.
- Análisis de sentimientos (Sentiment Analysis): analizar la tendencia emocional de un texto dado (por ejemplo, positiva, negativa, neutral).
- Resumen de texto (Text Summarization): comprimir textos largos en resúmenes concisos.
- Traducción (Translation): traducir texto de un idioma a otro.
Mediante la herramienta de línea de comandos, los usuarios pueden especificar diferentes tareas y cargar diferentes modelos para completar una tarea concreta.
3. Inferencia
La inferencia es el proceso de procesar entradas en un modelo ya entrenado para generar salidas.
Ollama proporciona una herramienta de línea de comandos o API fácil de usar, que permite a los usuarios proporcionar entradas al modelo rápidamente y obtener resultados.
La inferencia es una de las funciones principales de Ollama y el núcleo de la interacción con los modelos.
Proceso de inferencia:
- Entrada: el usuario proporciona una entrada de texto al modelo, que puede ser una pregunta, una indicación o contenido de una conversación.
- Procesamiento del modelo: el modelo, mediante su red neuronal integrada, genera una salida adecuada según la entrada.
- Salida: el modelo devuelve el contenido de texto generado, que puede ser una respuesta, un artículo generado, texto traducido, etc.
Ollama interactúa con modelos locales a través de API o CLI, lo que permite a los usuarios realizar tareas de inferencia fácilmente.
4. Ajuste fino (Fine-tuning)
El ajuste fino se refiere a entrenar adicionalmente un modelo ya preentrenado con datos de un dominio específico, para que el modelo tenga un mejor rendimiento en una tarea o campo determinado.
Ollama admite el ajuste fino; los usuarios pueden ajustar modelos preentrenados con sus propios conjuntos de datos para personalizar las salidas del modelo.
Proceso de ajuste fino:
- Preparar el conjunto de datos: el usuario prepara un conjunto de datos de un dominio específico; el formato de datos suele ser archivos de texto o formato JSON.
- Cargar el modelo preentrenado: elegir un modelo preentrenado adecuado para el ajuste fino, como LLama2 o modelos GPT.
- Entrenamiento: entrenar el modelo con el conjunto de datos específico del usuario para que pueda adaptarse mejor a la tarea objetivo.
- Guardar e implementar: una vez finalizado el entrenamiento, el modelo ajustado se puede guardar e implementar para su uso posterior.
El ajuste fino ayuda a que el modelo sea más preciso y eficiente al abordar problemas de dominios específicos.
Otras extensiones