TensorFlow 実例 - 画像分類プロジェクト
画像分類はコンピュータビジョンにおいて最も基礎的かつ重要なタスクの一つです。このプロジェクトでは、TensorFlow フレームワークを使用して、異なるカテゴリの画像を認識できる深層学習モデルを構築します。
画像分類とは
画像分類とは、コンピュータが画像内の主要な物体が属するカテゴリを自動的に識別する技術です。例えば:
- 写真が猫か犬かを識別する
- 異なる種類の花を区別する
- 医療画像の病変タイプを判定する
技術選定
以下の技術スタックを使用します:
- TensorFlow:Google が開発した主流の深層学習フレームワーク
- Keras:TensorFlow の高レベルAPIで、モデル構築を簡素化する
- Matplotlib:トレーニングプロセスと結果の可視化に使用される
環境準備
必要なライブラリのインストール
pip install tensorflow matplotlib numpy
インストールの検証
import tensorflow as tf
print(f"TensorFlow 版本: {tf.__version__}")
データセットの準備
古典的な CIFAR-10 データセットを使用します。10カテゴリ、6万枚の32x32カラー画像が含まれます。
データセットの読み込み
実例
from tensorflow.keras.datasets import cifar10
# データの読み込み
(train_images, train_labels), (test_images, test_labels) = cifar10.load_data()
# カテゴリ名
class_names = ['飛行機', '自動車', '鳥', '猫', '鹿',
'犬', 'カエル', '馬', '船', 'トラック']
# データの読み込み
(train_images, train_labels), (test_images, test_labels) = cifar10.load_data()
# カテゴリ名
class_names = ['飛行機', '自動車', '鳥', '猫', '鹿',
'犬', 'カエル', '馬', '船', 'トラック']
3.2 データ前処理
実例
# ピクセル値を0-1の範囲に正規化
train_images = train_images / 255.0
test_images = test_images / 255.0
# データの形状を確認
print("トレーニングセットの画像形状:", train_images.shape)
print("トレーニングセットのラベル形状:", train_labels.shape)
train_images = train_images / 255.0
test_images = test_images / 255.0
# データの形状を確認
print("トレーニングセットの画像形状:", train_images.shape)
print("トレーニングセットのラベル形状:", train_labels.shape)
4. モデルの構築
4.1 モデルアーキテクチャ
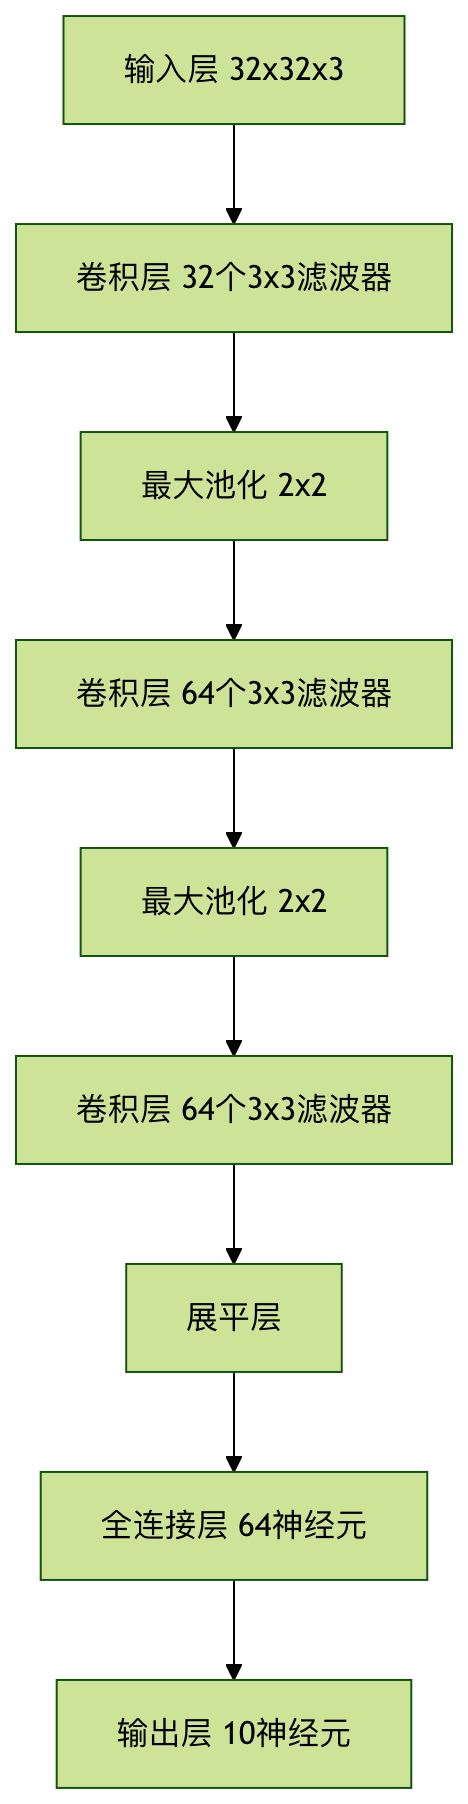
畳み込みニューラルネットワーク(CNN)を構築します。これは画像タスクを処理する古典的な構造です。
実例
from tensorflow.keras import layers, models
model = models.Sequential([
# 畳み込み層1
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(32, 32, 3)),
layers.MaxPooling2D((2, 2)),
# 畳み込み層2
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
# 畳み込み層3
layers.Conv2D(64, (3, 3), activation='relu'),
# 全結合層
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10) # 出力層、10カテゴリ
])
model = models.Sequential([
# 畳み込み層1
layers.Conv2D(32, (3, 3), activation='relu', input_shape=(32, 32, 3)),
layers.MaxPooling2D((2, 2)),
# 畳み込み層2
layers.Conv2D(64, (3, 3), activation='relu'),
layers.MaxPooling2D((2, 2)),
# 畳み込み層3
layers.Conv2D(64, (3, 3), activation='relu'),
# 全結合層
layers.Flatten(),
layers.Dense(64, activation='relu'),
layers.Dense(10) # 出力層、10カテゴリ
])
モデル構造の可視化
モデルのトレーニング
モデルのコンパイル
実例
model.compile(optimizer='adam',
loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
metrics=['accuracy'])
loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
metrics=['accuracy'])
トレーニングの開始
実例
history = model.fit(train_images, train_labels, epochs=10,
validation_data=(test_images, test_labels))
validation_data=(test_images, test_labels))
トレーニングプロセスの可視化
実例
import matplotlib.pyplot as plt
plt.plot(history.history['accuracy'], label='トレーニング精度')
plt.plot(history.history['val_accuracy'], label='検証精度')
plt.xlabel('Epoch')
plt.ylabel('Accuracy')
plt.ylim([0, 1])
plt.legend(loc='lower right')
plt.show()
plt.plot(history.history['accuracy'], label='トレーニング精度')
plt.plot(history.history['val_accuracy'], label='検証精度')
plt.xlabel('Epoch')
plt.ylabel('Accuracy')
plt.ylim([0, 1])
plt.legend(loc='lower right')
plt.show()
モデルの評価と予測
テストセットの性能評価
実例
test_loss, test_acc = model.evaluate(test_images, test_labels, verbose=2)
print(f'\nテスト精度: {test_acc}')
print(f'\nテスト精度: {test_acc}')
予測の実行
実例
import numpy as np
# softmax層を追加して出力を確率にする
probability_model = tf.keras.Sequential([model, layers.Softmax()])
# テストセットの最初の5枚の画像を予測
predictions = probability_model.predict(test_images[:5])
# 予測結果を表示
for i in range(5):
predicted_label = np.argmax(predictions[i])
true_label = test_labels[i][0]
print(f"予測: {class_names[predicted_label]} | 実際: {class_names[true_label]}")
# softmax層を追加して出力を確率にする
probability_model = tf.keras.Sequential([model, layers.Softmax()])
# テストセットの最初の5枚の画像を予測
predictions = probability_model.predict(test_images[:5])
# 予測結果を表示
for i in range(5):
predicted_label = np.argmax(predictions[i])
true_label = test_labels[i][0]
print(f"予測: {class_names[predicted_label]} | 実際: {class_names[true_label]}")
プロジェクト拡張の提案
モデル性能を向上させる方法
- ネットワークの深さを増やす(畳み込み層を増やす)
- データ拡張技術を使用する
- 異なるオプティマイザと学習率を試す
- バッチ正規化層を追加する
実用化の方向性
- 医用画像解析
- 自動運転における物体認識
- 工業用品質検査システム
- セキュリティ監視システム
8. よくある質問と回答
Q1: なぜCNNを選ぶのか?普通のニューラルネットワークではなく?
A: CNNは局所結合と重み共有により、画像の空間的特徴をより適切に捉えることができ、パラメータも少なくなります。
Q2: 適切なエポック数はどう選ぶか?
A: 検証セットの精度を観察し、向上しなくなったらトレーニングを停止して過学習を防ぎます。
Q3: メモリ不足エラーが発生した場合はどうすればよいか?
A: バッチサイズを小さくするか、画像サイズをより小さくします。
その他の拡張