R-Datenumformung
Datenrahmen zusammenführen
Die R-Sprache führt Datenrahmen mit dermerge()-Funktion zusammen.
Das Syntaxformat der Funktion merge() ist wie folgt:
# S3 方法
merge(x, y, …)

# data.frame 的 S3 方法
merge(x, y, by = intersect(names(x), names(y)),
      by.x = by, by.y = by, all = FALSE, all.x = all, all.y = all,
      sort = TRUE, suffixes = c(".x",".y"), no.dups = TRUE,
      incomparables = NULL, …)
Allgemeine Parameterbeschreibung:
- x, y: Datenrahmen.
- by, by.x, by.y: geben die Namen der übereinstimmenden Spalten in den beiden Datenrahmen an. Standardmäßig werden die gleichen Spaltennamen in den beiden Datenrahmen verwendet.
- all: logischer Wert; all = L ist eine Kurzform für all.x = L und all.y = L, wobei L TRUE oder FALSE sein kann.
- all.x: logischer Wert, Standard ist FALSE. Wenn TRUE, werden die übereinstimmenden Zeilen in x angezeigt, auch wenn es keine entsprechenden übereinstimmenden Zeilen in y gibt; Zeilen in y ohne Übereinstimmungen werden als NA dargestellt.
- all.y: logischer Wert, Standard ist FALSE. Wenn TRUE, werden die übereinstimmenden Zeilen in y angezeigt, auch wenn es keine entsprechenden übereinstimmenden Zeilen in x gibt; Zeilen in x ohne Übereinstimmungen werden als NA dargestellt.
- sort: logischer Wert, ob die Spalten sortiert werden sollen.
Die Funktion merge() ist der JOIN-Funktionalität in SQL sehr ähnlich:
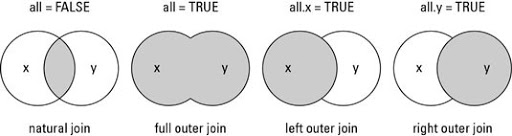
- Natural Join oder INNER JOIN: Wenn es mindestens eine Übereinstimmung in den Tabellen gibt, werden Zeilen zurückgegeben
- Left Outer Join oder LEFT JOIN: gibt alle Zeilen aus der linken Tabelle zurück, auch wenn es keine Übereinstimmungen in der rechten Tabelle gibt.
- Right Outer Join oder RIGHT JOIN: gibt alle Zeilen aus der rechten Tabelle zurück, auch wenn es keine Übereinstimmungen in der linken Tabelle gibt.
- Full Outer Join oder FULL JOIN: gibt Zeilen zurück, solange es eine Übereinstimmung in einer der Tabellen gibt.
Beispiel
df1 = data.frame(SiteId = c(1:6), Site = c("Google","Example","Taobao","Facebook","Zhihu","Weibo"))
# Datenframe 2
df2 = data.frame(SiteId = c(2, 4, 6, 7, 8), Country = c("CN","USA","CN","USA","IN"))
# INNER JOIN
df1 = merge(x=df1,y=df2,by="SiteId")
print("----- INNER JOIN -----")
print(df1)
# FULL JOIN
df2 = merge(x=df1,y=df2,by="SiteId",all=TRUE)
print("----- FULL JOIN -----")
print(df2)
# LEFT JOIN
df3 = merge(x=df1,y=df2,by="SiteId",all.x=TRUE)
print("----- LEFT JOIN -----")
print(df3)
# RIGHT JOIN
df4 = merge(x=df1,y=df2,by="SiteId",all.y=TRUE)
print("----- RIGHT JOIN -----")
print(df4)
Die Ausführung des obigen Codes liefert das folgende Ergebnis:
[1] "----- INNER JOIN -----"
  SiteId     Site Country
1      2   Example      CN
2      4 Facebook     USA
3      6    Weibo      CN
[1] "----- FULL JOIN -----"
  SiteId     Site Country.x Country.y
1      2   Example        CN        CN
2      4 Facebook       USA       USA
3      6    Weibo        CN        CN
4      7     <NA>      <NA>       USA
5      8     <NA>      <NA>        IN
[1] "----- LEFT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Example      CN   Example        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
[1] "----- RIGHT JOIN -----"
  SiteId   Site.x Country   Site.y Country.x Country.y
1      2   Example      CN   Example        CN        CN
2      4 Facebook     USA Facebook       USA       USA
3      6    Weibo      CN    Weibo        CN        CN
4      7     <NA>    <NA>     <NA>      <NA>       USA
5      8     <NA>    <NA>     <NA>      <NA>        IN
Datenaggregation und -aufteilung
Die Sprache R verwendetmelt()undcast()Funktionen, um Daten zu aggregieren und aufzuteilen.
- melt(): wandelt Daten im breiten Format in Daten im langen Format um.
- cast(): wandelt Daten im langen Format in Daten im breiten Format um.
Das folgende Diagramm zeigt deutlich die Funktionsweise der Funktionen melt() und cast() (die folgenden Beispiele erklären dies im Detail):
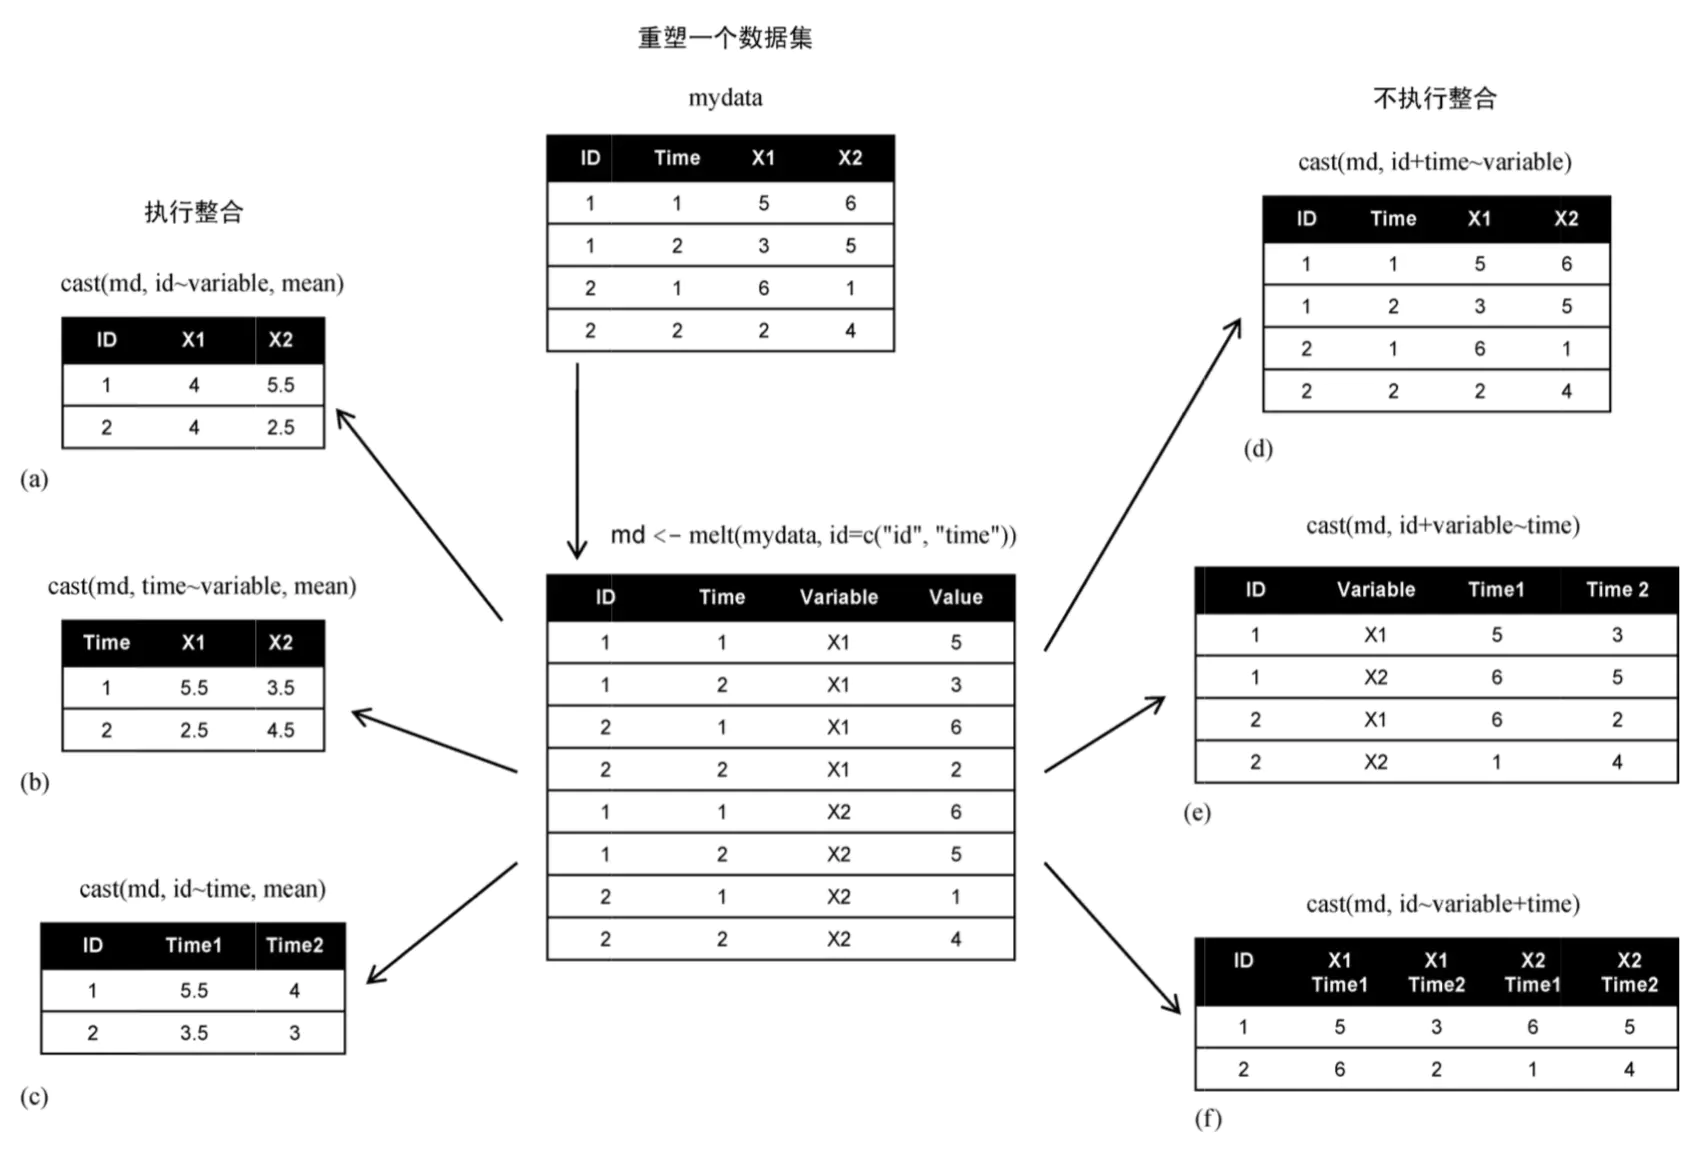
melt() stapelt jede Spalte des Datensatzes in einer einzigen Spalte. Das Syntaxformat der Funktion ist:
melt(data, ..., na.rm = FALSE, value.name = "value")
Parameter description:
- data: Datensatz.
- ...: zusätzliche Argumente, die an andere Methoden übergeben oder von anderen Methoden empfangen werden.
- na.rm: ob NA-Werte aus dem Datensatz entfernt werden sollen.
- value.name: ein Variablenname, der zum Speichern von Werten verwendet wird.
Bevor wir die folgenden Operationen ausführen, installieren wir zuerst die Abhängigkeitspakete:
# 安装库,MASS 包含很多统计相关的函数,工具和数据集
install.packages("MASS", repos = "https://mirrors.ustc.edu.cn/CRAN/")

#  melt() 和 cast() 函数需要对库
install.packages("reshape2", repos = "https://mirrors.ustc.edu.cn/CRAN/")
install.packages("reshape", repos = "https://mirrors.ustc.edu.cn/CRAN/")
Testbeispiel:
Beispiel
library(MASS)
library(reshape2)
library(reshape)
# Datenrahmen erstellen
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Ursprünglicher Datenrahmen
cat("Ursprünglicher Datenrahmen:\n")
print(mydata)
# Aggregieren
md <- melt(mydata, id = c("id","time"))
cat("\nNach der Aggregation:\n")
print(md)
Die Ausführung des obigen Codes liefert das folgende Ergebnis:
原始数据框:
id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

整合后:
id time variable value
1  1    1       x1     5
2  1    2       x1     3
3  2    1       x1     6
4  2    2       x1     2
5  1    1       x2     6
6  1    2       x2     5
7  2    1       x2     1
8  2    2       x2     4
Die cast-Funktion wird verwendet, um den zusammengeführten Datenrahmen wiederherzustellen; dcast() gibt einen Datenrahmen zurück, und acast() gibt einen Vektor/eine Matrix/ein Array zurück.
Das Syntaxformat der Funktion cast() ist:
dcast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
acast(
  data,
  formula,
  fun.aggregate = NULL,
  ...,
  margins = NULL,
  subset = NULL,
  fill = NULL,
  drop = TRUE,
  value.var = guess_value(data)
)
Parameter description:
- data: der zusammengeführte Data Frame.
- formula: das Format der umgeformten Daten, ähnlich dem x ~ y-Format, wobei x die Zeilenbeschriftung und y die Spaltenbeschriftung ist.
- fun.aggregate: Aggregatfunktion, die zur Verarbeitung der value-Werte verwendet wird.
- margins: ein Vektor von Variablennamen (kann "grand_col" und "grand_row" enthalten), der zur Berechnung von Randwerten verwendet wird; auf TRUE setzen, um alle Randwerte zu berechnen.
- subset: filtert das Ergebnis anhand von Bedingungen, mit einem Format ähnlich wiesubset = .(variable=="length")。
- drop: ob der Standardwert beibehalten werden soll.
- value.var: gefolgt von dem zu verarbeitenden Feld.
Beispiel
library(MASS)
library(reshape2)
library(reshape)
# Datenrahmen erstellen
id<- c(1, 1, 2, 2)
time <- c(1, 2, 1, 2)
x1 <- c(5, 3, 6, 2)
x2 <- c(6, 5, 1, 4)
mydata <- data.frame(id, time, x1, x2)
# Aggregieren
md <- melt(mydata, id = c("id","time"))
# Umgeformten Datensatz mit der Funktion cast() ausgeben
cast.data <- cast(md, id~variable, mean)
print(cast.data)
cat("\n")
time.cast <- cast(md, time~variable, mean)
print(time.cast)
cat("\n")
id.time <- cast(md, id~time, mean)
print(id.time)
cat("\n")
id.time.cast <- cast(md, id+time~variable)
print(id.time.cast)
cat("\n")
id.variable.time <- cast(md, id+variable~time)
print(id.variable.time)
cat("\n")
id.variable.time2 <- cast(md, id~variable+time)
print(id.variable.time2)
Die Ausführung des obigen Codes liefert das folgende Ergebnis:
id x1  x2
1  1  4 5.5
2  2  4 2.5

  time  x1  x2
1    1 5.5 3.5
2    2 2.5 4.5

  id   1 2
1  1 5.5 4
2  2 3.5 3

  id time x1 x2
1  1    1  5  6
2  1    2  3  5
3  2    1  6  1
4  2    2  2  4

  id variable 1 2
1  1       x1 5 3
2  1       x2 6 5
3  2       x1 6 2
4  2       x2 1 4

  id x1_1 x1_2 x2_1 x2_2
1  1    5    3    6    5
2  2    6    2    1    4
Weitere Erweiterungen