Hermes Agent Sitzungslebenszyklus und geplante Aufgaben
Richtlinie zum Zurücksetzen der Sitzung
Die Reset-Richtlinie steuert, wann eine Sitzung automatisch "das Gedächtnis verliert" — sie erhält eine neue session_id und der alte Kontext wird archiviert.
Eine sinnvolle Konfiguration der Reset-Richtlinie verhindert, dass der Agent-Kontext unbegrenzt wächst, während sichergestellt wird, dass die Benutzererfahrung nicht beeinträchtigt wird.
Vier Reset-Modi
| Mode | Verhalten | Anwendbare Szenarien |
|---|---|---|
| none | Kein automatischer Reset; der Kontext wird ausschließlich durch den Komprimierungsmechanismus verwaltet. | Szenarien, die einen lang andauernden kontinuierlichen Kontext erfordern |
| idle | Automatisch zurücksetzen nach mehr als N Minuten Inaktivität | Gelegentlich genutzte Agenten |
| täglich | Täglich zu einer festgelegten Zeit automatisch zurücksetzen | Für tägliche Routineaufgaben verwendete Agenten |
| both | Inaktivitäts-Timeout oder täglicher Reset – je nachdem, was zuerst ausgelöst wird, greift. | Die meisten Szenarien (Standard empfohlen) |
Reset-Richtlinie konfigurieren
Beispiel
session_reset:
mode: both # none | idle | daily | both
at_hour: 4 # Tägliche Reset-Zeit (4 Uhr, lokale Zeit)
idle_minutes: 1440 # Inaktivitäts-Timeout (1440 Minuten = 24 Stunden)
notify: true # Benutzer bei Reset benachrichtigen
# Reset-Richtlinie pro Plattform anpassen
platforms:
telegram:
session_reset:
mode: idle
idle_minutes: 720 # Telegram-Sitzung wird nach 12 Stunden Inaktivität zurückgesetzt
slack:
session_reset:
mode: none # Slack-Unterhaltungen werden nie automatisch zurückgesetzt
Auswirkung eines Resets
Wenn eine Sitzung einen Reset auslöst, geschieht Folgendes:
- Alte Sitzungen werden in SQLite als beendet markiert (Grund: "session_reset")
- Eine neue session_id wird generiert (Format: YYYYMMDD_HHMMSS_8-stelliger zufälliger Hex-Wert)
- Das was_auto_reset der neuen SessionEntry wird auf true gesetzt
- Zwischengespeicherte Agent-Instanzen werden bereinigt
- Der Benutzer sieht in der nächsten Nachricht den Hinweis "Sitzung wurde zurückgesetzt"
Sitzungen mit aktiven Hintergrundprozessen werden niemals zurückgesetzt. Hermes prüft den has_active_processes-Callback, um sicherzustellen, dass laufende Aufgaben nie unterbrochen werden.
Wiederherstellungsmechanismus nach Neustart
Der Wiederherstellungsmechanismus nach Neustart des Hermes Gateway stellt sicher, dass laufende Sitzungen nach einem unerwarteten Absturz oder einem geplanten Neustart nicht verloren gehen.
Zwei Wiederherstellungsmarker
| Bezeichnung | Auslöseszenario | Verhalten | Schweregradstufe |
|---|---|---|---|
| resume_pending | Absturzwiederherstellung, Drain-Timeout | session_id beibehalten und das Gespräch beim nächsten Besuch fortsetzen. | sanfte Wiederherstellung |
| suspended | /stop-Befehl oder 3 aufeinanderfolgende Neustartfehler. | Erzwungenes Zurücksetzen, neue session_id generieren. | harter Reset |
Wiederherstellungsprozess beim Start
Wenn das Gateway startet, läuft der Wiederherstellungsprozess wie folgt ab:
Schritt 1: Den .clean_shutdown-Marker prüfen.
Wenn er vorhanden ist, war das vorherige Herunterfahren sauber, sodass der Wiederherstellungsprozess übersprungen wird.
Schritt 2: Wenn der Marker .clean_shutdown nicht existiert, war die vorherige Beendigung abnormal.
Gateway ruft suspend_recently_active() auf und markiert Sitzungen, die innerhalb der letzten 120 Sekunden aktiv waren, als resume_pending.
Schritt 3: Festgefahrene Schleife (Endlosschleife) erkennen.
Wenn eine Sitzung nach 3 aufeinanderfolgenden Neustarts noch aktiv ist, hängt sie möglicherweise in einer Endlosschleife fest; das Gateway markiert sie als suspended.
Schritt 4: Ausstehende Sitzungen wieder aufnehmen.
Gateway erzeugt ein MessageEvent für jede resume_pending-Sitzung und veranlasst den Agenten, automatisch fortzufahren.
Drain-Timeout-Marker
Während eines sauberen Herunterfahrens/Neustarts markiert das Gateway eine Sitzung, die gerade verarbeitet wird, aber die Drain-Wartezeit überschreitet, als resume_pending.
Gründe für die Markierung in verschiedenen Szenarien:
| Markierungsgrund | Bedeutung |
|---|---|
| restart_timeout | Drain-Timeout beim Neustart |
| shutdown_timeout | Drain-Timeout beim Herunterfahren |
| restart_interrupted | Crash-Wiederherstellung (ausgelöst von suspend_recently_active) |
Der resume_pending-Marker wird bei get_or_create_session() nicht gelöscht – erst nach der nächsten erfolgreichen Agent-Antwort. Wenn die wiederhergestellte Sitzung erneut unterbrochen wird, bleibt der Marker erhalten, was einen erneuten Versuch beim nächsten Neustart ermöglicht. Nach 3 aufeinanderfolgenden Fehlern wird sie in den Zustand suspended versetzt.
Nachrichtenwarteschlangen-Mechanismus
Wenn ein Benutzer mehrere Nachrichten hintereinander sendet, während eine Nachricht verarbeitet wird, stellt der Nachrichtenwarteschlangen-Mechanismus des Gateways sicher, dass Nachrichten nicht verloren gehen.
Warteschlangenstruktur
Das Gateway verwendet ein zweistufiges Warteschlangendesign:
- Einzel-Slot ausstehend (_messages): Jede Sitzung hat nur einen "next"-Slot; wiederholte Sendevorgänge überschreiben ihn.
- Überlaufwarteschlange (_queued_events): Wenn der Slot belegt ist, werden nachfolgende Nachrichten an das Ende der Überlaufwarteschlange angehängt.
/queue-Befehl
Der /queue-Befehl ermöglicht es dir, Aufgaben in Stapeln einzureichen, und jede Aufgabe erzeugt einen vollständigen Agent-Turn.
Beispiel
/queue überprüfe den Codestil von src/main.py
/queue as src/Schreibe Unit-Tests für utils.py
/queue aktualisiere die Installationsanweisungen in README.md
Jede Aufgabe in der Warteschlange wird in FIFO-Reihenfolge ausgeführt, wobei jede Aufgabe einen vollständigen Agent-Turn erzeugt; sie werden nicht zusammengeführt.
Verwende den /new- oder /reset-Befehl, um die Nachrichtenwarteschlange der aktuellen Sitzung zu leeren.
Wenn du mehrere Nachrichten hintereinander sendest, während der Agent beschäftigt ist, werden die dazwischenliegenden überschrieben (nur die letzte wird beibehalten); Nachrichten im /queue-Befehl werden nicht überschrieben — jede /queue-Aufgabe wird der Reihe nach ausgeführt.
Geplante Aufgaben (Cron)
Hermes bietet erstklassige Unterstützung für geplante Aufgaben, sodass du den Agenten so konfigurieren kannst, dass er bestimmte Aufgaben regelmäßig ausführt.
Geplante Aufgaben können an einen Skill gebunden werden und die Ergebnisse an eine angegebene Plattform liefern.
Geplante Aufgaben konfigurieren
Geplante Aufgaben werden in jobs.json definiert und unterstützen mehrere Zeitplanformate.
{
  "jobs": [
    {
      "id": "daily-news-summary",
      "schedule": "0 8 * * *",
      "description": "每天早上 8 点抓取 AI 行业新闻并生成摘要",
      "skill": "ai-news-summarizer",
      "deliver_to": {
        "platform": "telegram",
        "chat_id": "-1001234567890"
      }
    },
    {
      "id": "weekly-code-review",
      "schedule": "0 10 * * 1",
      "description": "每周一早上 10 点审查项目代码变更",
      "skill": "code-review-assistant",
      "deliver_to": {
        "platform": "discord",
        "chat_id": "123456789"
      }
    },
    {
      "id": "health-check",
      "schedule": "*/30 * * * *",
      "description": "每 30 分钟检查服务器健康状态",
      "skill": "server-health-checker",
      "deliver_to": {
        "platform": "telegram",
        "chat_id": "123456789"
      }
    }
  ]
}
Unterstützte Zeitplanformate
| Formatierung | Beispiel | Beschreibung |
|---|---|---|
| Cron-Ausdruck | 0 8 * * * | Standard-Cron-Ausdruck mit 5 Feldern |
| Intervall | 30m | Alle 30 Minuten |
| Relative Zeit | +90s | Einmal nach 90 Sekunden ausführen |
| Wiederholungsanzahl | repeat.times: 5 | Nach 5 Ausführungen automatisch beenden |
Kann in der Desktop-Version konfiguriert werden; klicken Sie unten links auf "Schedule":
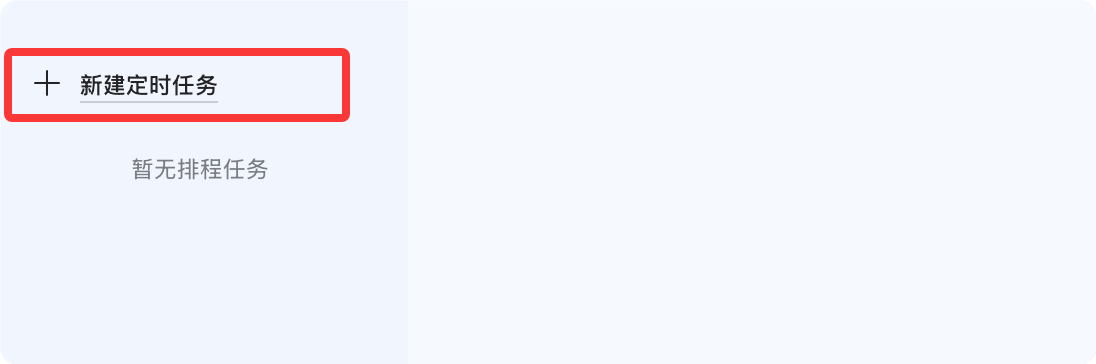
Klicken Sie auf "Create Scheduled Task":
Aufgabe erstellen:
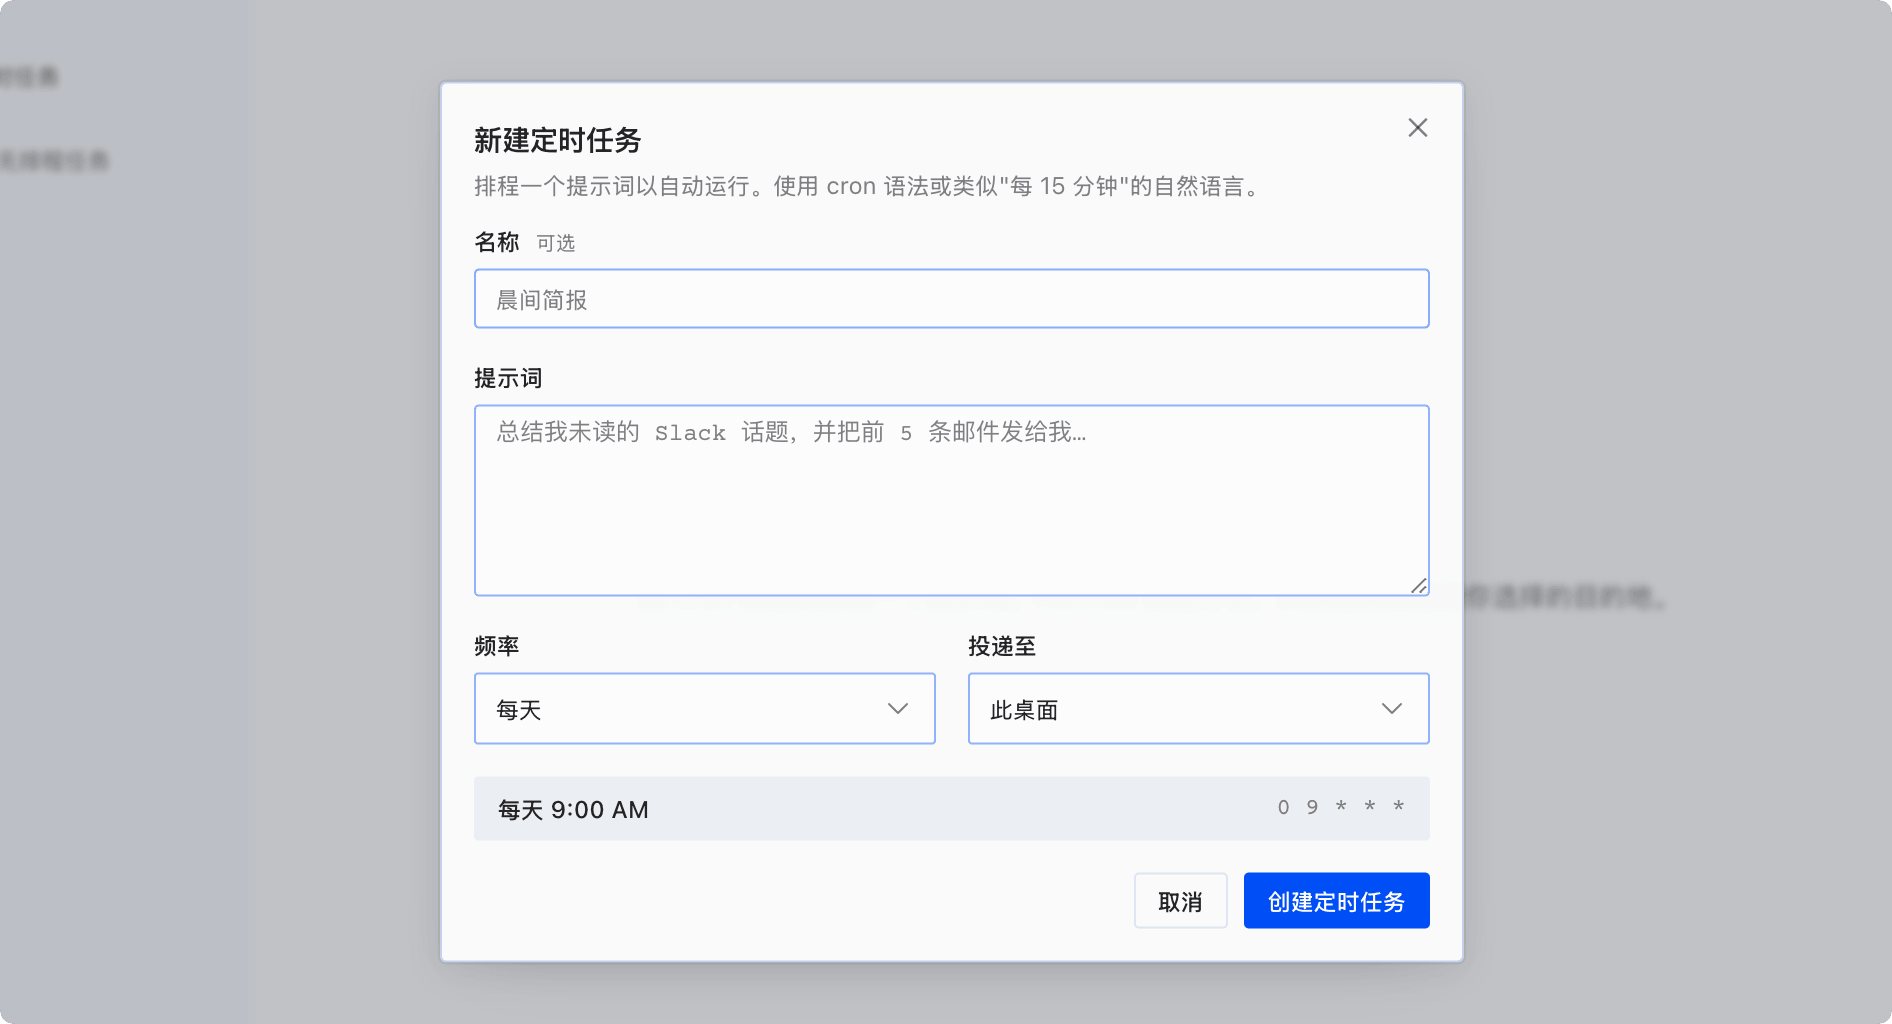
Nachdem eine geplante Aufgabe an einen Skill gebunden wurde, wird die Ausgabe automatisch gemäß dem im Skill definierten Ausgabeformat formatiert. Dadurch wird sichergestellt, dass die Darstellung konsistent und lesbar ist, wenn Ergebnisse geplanter Aufgaben an eine Messaging-Plattform übermittelt werden.
Chronos-verwalteter Cron (Erweitert)
Chronos ist Hermes’ verwaltete Lösung für geplante Aufgaben, die speziell für Scale-to-Zero-Bereitstellungsmodelle konzipiert wurde.
Wenn Ihr Gateway im Leerlauf vollständig gestoppt ist, kann Chronos dennoch sicherstellen, dass geplante Aufgaben rechtzeitig ausgelöst werden.
Warum wird Chronos benötigt?
Der integrierte Cron-Ticker erfordert, dass der Gateway-Prozess kontinuierlich läuft – wenn das Gateway auf null herunterskaliert wird, werden geplante Aufgaben nicht ausgelöst.
Chronos delegiert die Verwaltung geplanter Aufgaben an NAS (Nous Account Service), der das Gateway über einen externen Scheduler aufweckt, wenn eine Aufgabe ausgelöst wird.
Chronos-Workflow
Chronos’ Workflow ist in vier Schritte unterteilt:
Schritt 1: Der Agent berechnet die nächste Auslösezeit und registriert einen One-Shot-Timer bei NAS.
Schritt 2: NAS verwendet einen externen Scheduler (z. B. die geplanten Trigger von Fly Machines), um zur angegebenen Zeit einen Callback auszulösen.
Schritt 3: Der externe Scheduler ruft über einen Callback NAS auf, und NAS generiert ein kurzlebiges JWT-Token.
Schritt 4: NAS ruft den /api/cron/fire-Endpunkt des Agenten mithilfe eines JWT-Tokens auf. Der Agent verifiziert es, führt die Aufgabe aus und registriert den nächsten One-Shot-Timer erneut.
At-most-once-Garantie
Chronos verwendet CAS-Operationen (Compare-And-Set) auf Store-Ebene, um sicherzustellen, dass jede geplante Aufgabe nur einmal ausgeführt wird.
Selbst wenn der Scheduler aufgrund von Netzwerk-Wiederholungsversuchen doppelte Auslöseanfragen sendet, kann der Agent über CAS deduplizieren, wodurch sichergestellt wird, dass Aufgaben nicht wiederholt ausgeführt werden.
Chronos konfigurieren
Beispiel
cron:
provider: "chronos" # Chronos anstelle des eingebauten Tickers verwenden
chronos:
portal_url: "https://portal.nousresearch.com"
callback_url: "https://my-agent.fly.dev" # Öffentlich erreichbare URL des Agenten
expected_audience: "agent:inst_abc123" # Audience für JWT-Validierung
nas_jwks_url: "https://portal.nousresearch.com/.well-known/jwks.json"
Weitere ErweiterungenChronos ist die empfohlene Planungslösung für verwaltete Hermes-Bereitstellungen. Wenn Sie eine selbstgehostete Bereitstellung verwenden und Ihr Gateway niemals auf null herunterskaliert, ist der integrierte Cron-Ticker vollkommen ausreichend. Wenn callback_url leer ist oder der Agent keinen Nous-Login hat, fällt das System automatisch auf den integrierten Ticker zurück.