Hermes Agent セッションのライフサイクルとスケジュールタスク
セッションリセットポリシー
リセットポリシーは、セッションがいつ自動的に「記憶喪失」になるかを制御します。つまり、新しい session_id を取得し、古いコンテキストはアーカイブされます。
リセットポリシーを適切に設定することで、Agent のコンテキストが無限に膨張するのを防ぎ、同時にユーザーエクスペリエンスへの影響を防ぐことができます。
4つのリセットモード
| モード | 動作 | 適用シナリオ |
|---|---|---|
| none | 自動リセットなし、コンテキストは圧縮メカニズムのみで管理される | 長期的な連続コンテキストが必要なシナリオ |
| idle | アイドル状態がN分を超えると自動リセット | たまにしか使わない Agent |
| daily | 毎日指定時刻に自動リセット | 毎日ルーチンとして使用する Agent |
| both | アイドルタイムアウトまたは毎日リセットのうち、先にトリガーされた方を実行 | ほとんどのシナリオ(デフォルト推奨) |
リセットポリシーの設定
例
session_reset:
mode: both # none | idle | daily | both
at_hour: 4 # 毎日リセット時刻(午前4時、ローカルタイム)
idle_minutes: 1440 # アイドルタイムアウト(1440分 = 24時間)
notify: true # リセット時にユーザーへ通知
# プラットフォームごとにリセットポリシーをカスタマイズ
platforms:
telegram:
session_reset:
mode: idle
idle_minutes: 720 # Telegram セッションは12時間アイドル後にリセット
slack:
session_reset:
mode: none # Slack セッションは自動リセットなし
リセットの効果
セッションがリセットをトリガーすると、次のことが発生します:
- 旧セッションは SQLite で終了としてマークされます(reason: "session_reset")
- 新しい session_id が生成されます(形式:YYYYMMDD_HHMMSS_8桁のランダムhex)
- 新しい SessionEntry の was_auto_reset フラグが true に設定されます
- キャッシュされた Agent インスタンスはクリーンアップされます
- ユーザーは次のメッセージで「セッションはリセットされました」という通知を受け取ります
アクティブなバックグラウンドプロセスを持つセッションは、決してリセットされません。Hermes は has_active_processes コールバックをチェックして、実行中のタスクを中断しないことを保証します。
再起動復旧メカニズム
Hermes Gateway の再起動復旧メカニズムは、予期しないクラッシュや計画的な再起動後も、進行中のセッションが失われないことを保証します。
2種類の復旧フラグ
| フラグ | トリガーシナリオ | 動作 | 重大度 |
|---|---|---|---|
| resume_pending | クラッシュ復旧、drain タイムアウト | session_id を保持し、次回アクセス時に会話を継続 | ソフト復旧 |
| suspended | /stop コマンド、3回連続の再起動失敗 | 強制リセットし、新しい session_id を生成 | ハードリセット |
起動時復旧フロー
Gateway が起動するとき、復旧フローは次のとおりです:
ステップ1:.clean_shutdown フラグを確認します。
存在する場合、前回は正常にシャットダウンされたことを意味するため、復旧フローをスキップします。
ステップ2:.clean_shutdown フラグが存在しない場合、前回は異常終了したことを意味します。
Gateway は suspend_recently_active() を呼び出し、直近120秒以内にアクティブだったセッションを resume_pending としてマークします。
ステップ3:stuck-loop(スタックループ)を検出します。
あるセッションが3回連続の再起動後もアクティブな状態にある場合、無限ループに陥っている可能性があるため、Gateway はそれを suspended としてマークします。
ステップ4:保留中(resume_pending)のセッションを復旧します。
Gateway は各 resume_pending セッションに対して MessageEvent を合成し、Agent が自動的に続行するようにトリガーします。
Drain タイムアウトフラグ
正常なシャットダウン/再起動の過程で、あるセッションが処理中であるにもかかわらず drain 待機時間を超えた場合、Gateway はそれを resume_pending としてマークします。
さまざまなシナリオでのフラグの理由:
| フラグの理由 | 意味 |
|---|---|
| restart_timeout | 再起動中の drain タイムアウト |
| shutdown_timeout | シャットダウン中の drain タイムアウト |
| restart_interrupted | クラッシュ復旧(suspend_recently_active からトリガー) |
resume_pending フラグは get_or_create_session() の時点ではクリアされません。次回の Agent の応答が成功した後にクリアされます。復旧したセッションが再び中断された場合、フラグは保持され、次回の再起動時に再試行できます。3回連続で失敗すると suspended に昇格します。
メッセージキューメカニズム
ユーザーが Agent によるメッセージ処理中に複数のメッセージを連続して送信した場合、Gateway のメッセージキューメカニズムにより、メッセージが失われないことが保証されます。
キューの構造
Gateway は2レベルのキューデザインを使用します:
- シングルスロット pending(_pending_messages):各セッションには「次の1件」スロットのみがあり、再送信すると上書きされます
- オーバーフローキュー(_queued_events):スロットが使用中の場合、後続のメッセージはオーバーフローキューの末尾に追加されます
/queue コマンド
/queue コマンドを使うと、タスクを一括で提出でき、各タスクが完全な Agent ターンを生成します。
例
/queue src をレビュー/main.py のコードスタイル
/queue src 向けに/utils.py のユニットテストを作成
/queue README.md のインストール手順を更新
キュー内の各タスクは FIFO 順に実行され、各タスクは完全な Agent ターンを生成し、マージされることはありません。
/new または /reset コマンドを使用すると、現在のセッションのメッセージキューをクリアできます。
Agent がメッセージを処理している間に複数のメッセージを連続して送信すると、途中のメッセージは上書きされます(最後の1件のみ保持)。一方、/queue コマンドのメッセージは上書きされません。各 /queue タスクは順番に実行されます。
スケジュールタスク(Cron)
Hermes にはファーストクラスのスケジュールタスクサポートが組み込まれており、Agent が定期的に特定のタスクを実行するように設定できます。
スケジュールタスクは Skill にバインドでき、結果を指定したプラットフォームに配信できます。
スケジュールタスクの設定
スケジュールタスクは jobs.json で定義され、複数のスケジュール形式に対応しています。
{
  "jobs": [
    {
      "id": "daily-news-summary",
      "schedule": "0 8 * * *",
      "description": "每天早上 8 点抓取 AI 行业新闻并生成摘要",
      "skill": "ai-news-summarizer",
      "deliver_to": {
        "platform": "telegram",
        "chat_id": "-1001234567890"
      }
    },
    {
      "id": "weekly-code-review",
      "schedule": "0 10 * * 1",
      "description": "每周一早上 10 点审查项目代码变更",
      "skill": "code-review-assistant",
      "deliver_to": {
        "platform": "discord",
        "chat_id": "123456789"
      }
    },
    {
      "id": "health-check",
      "schedule": "*/30 * * * *",
      "description": "每 30 分钟检查服务器健康状态",
      "skill": "server-health-checker",
      "deliver_to": {
        "platform": "telegram",
        "chat_id": "123456789"
      }
    }
  ]
}
対応しているスケジュール形式
| 形式 | 例 | 説明 |
|---|---|---|
| Cron 式 | 0 8 * * * | 標準の5フィールド cron 式 |
| 間隔 | 30m | 30分ごと |
| 相対時間 | +90s | 90秒後に1回実行 |
| 繰り返し回数 | repeat.times: 5 | 5回実行後に自動停止 |
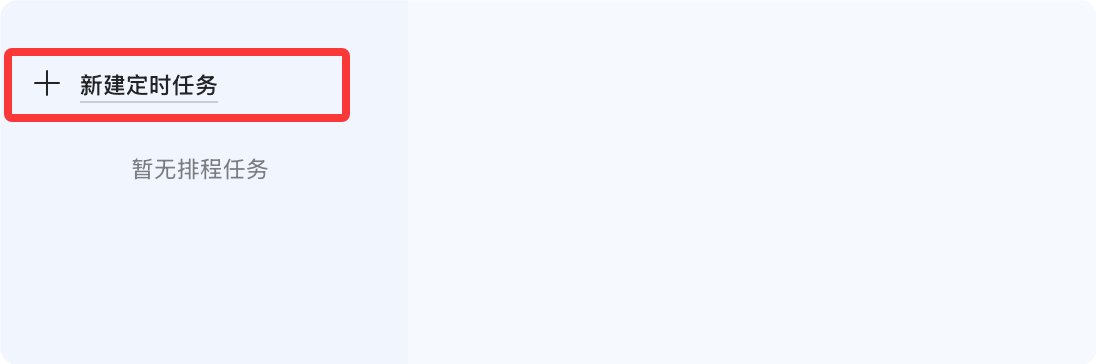
デスクトップ版で設定できます。左下隅の「スケジュール」をクリックします:
「新しいスケジュールタスク」をクリックします:
タスクを作成:
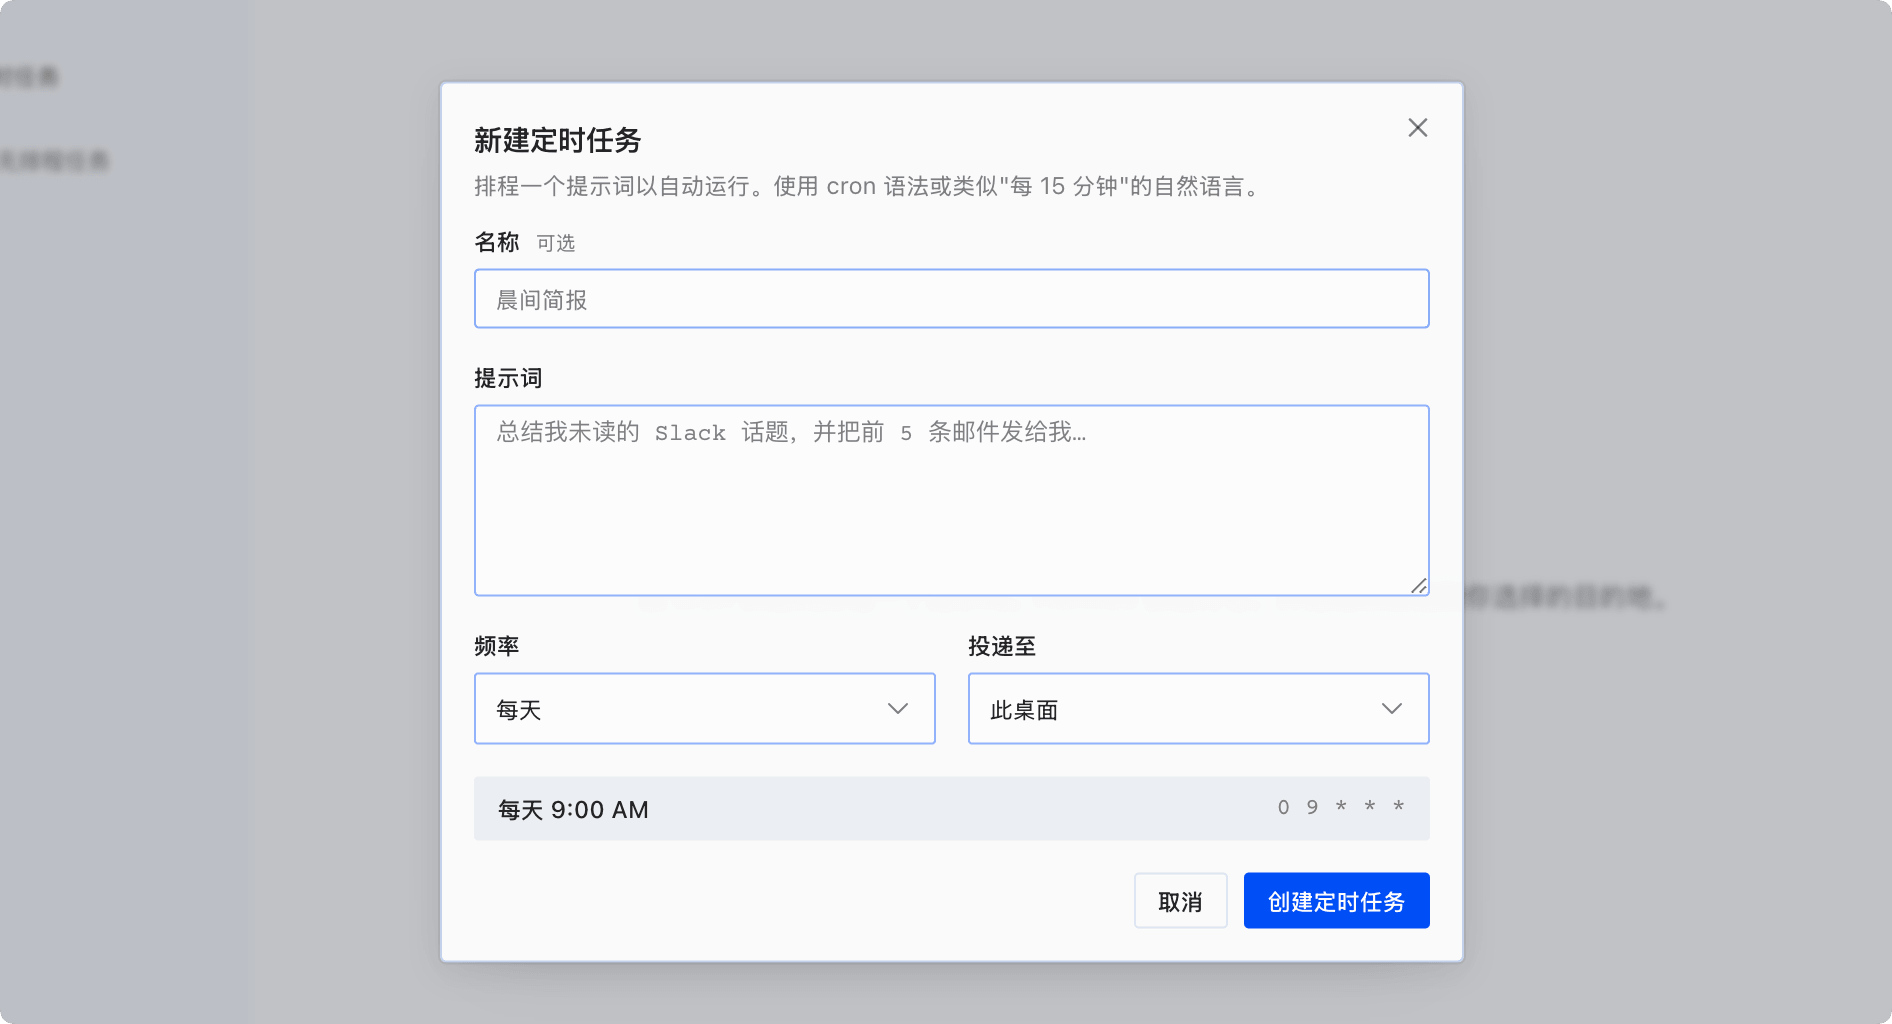
スケジュールタスクが Skill にバインドされると、実行出力は Skill が定義する出力形式に自動的にフォーマットされます。これにより、スケジュールタスクの結果がメッセージプラットフォームに配信される際、一貫性があり読みやすい表示になります。
Chronos マネージド Cron(上級編)
Chronos は Hermes のマネージド型スケジュールタスクソリューションであり、scale-to-zero デプロイモード専用に設計されています。
Gateway がアイドル時に完全に停止しても、Chronos はスケジュールタスクを時間通りに確実にトリガーできます。
なぜ Chronos が必要か?
組み込みの cron ticker は Gateway プロセスが常時稼働している必要があります。Gateway がゼロにスケールダウンすると、スケジュールタスクはトリガーされません。
Chronos はスケジュールタスクの管理を NAS(Nous Account Service)に委任し、外部スケジューラを介してタスクのトリガー時に Gateway を起動します。
Chronos のワークフロー
Chronos のワークフローは4つのステップに分かれています:
ステップ1:Agent が次回のトリガー時間を計算し、NAS に one-shot タイマーを登録します。
ステップ2:NAS は外部スケジューラ(例:Fly Machines のスケジュールトリガー)を使用して、指定時間にコールバックをトリガーします。
ステップ3:外部スケジューラが NAS をコールバックすると、NAS は短時間有効な JWT トークンを生成します。
ステップ4:NAS は JWT トークンを使用して Agent の /api/cron/fire エンドポイントを呼び出し、Agent は検証後にタスクを実行し、次の one-shot を再登録します。
At-most-once 保証
Chronos はストアレベルの CAS(Compare-And-Set)操作により、各スケジュールタスクが一度だけ実行されることを保証します。
スケジューラがネットワーク再試行により重複したトリガーリクエストを送信しても、Agent は CAS で重複排除できるため、タスクが重複実行されることはありません。
Chronos の設定
例
cron:
provider: "chronos" # 組み込み ticker の代わりに Chronos を使用
chronos:
portal_url: "https://portal.nousresearch.com"
callback_url: "https://my-agent.fly.dev" # Agent のパブリックアクセス可能な URL
expected_audience: "agent:inst_abc123" # JWT 検証の audience
nas_jwks_url: "https://portal.nousresearch.com/.well-known/jwks.json"
その他の拡張Chronos はマネージド Hermes デプロイメントに推奨されるスケジュールタスクソリューションです。セルフホストデプロイメントを使用していて Gateway がゼロにスケールダウンしない場合は、組み込みの cron ticker で十分です。callback_url が空の場合、または Agent が Nous にログインしていない場合、システムは自動的に組み込みの ticker にフォールバックします。