Хеш-таблица
Хеш-таблица, также называемая хеш-картой, — это чрезвычайно эффективная структура данных.
Хеш-таблицы могут, в среднем случае, с близкой кO(1)Временная сложность вставки, удаления и поиска данных намного лучше, чем обход массива (O(n)) и поиск в двоичном дереве поиска (O(log n)) намного быстрее.
| Действие | Массив/связный список | Хеш-таблица |
|---|---|---|
| Поиск | O(n) | O(1) |
| Вставка | O(n) | O(1) |
| Delete | O(n) | O(1) |
| Эффективность использования памяти | Высокая | Средняя |
Хеш-таблицаПрямо как умная система шкафчиков:
- Традиционный шкафчик: Нужно помнить, в каком шкафчике находится каждый предмет (линейный поиск)
- Умный шкафчик: вы сообщаете администратору название предмета, и он сразу говорит вам номер шкафчика (поиск по хешу)
Основная идея:
С помощьюхеш-функцииключпреобразуется виндексмассива, обеспечивая быстрый доступ.
Пример из реальной жизни:
- Поиск по словарю: быстро находите страницу по первой букве слова
- Телефонная книга: сортировка по пиньиню фамилии для быстрого поиска контактов
- Библиотечный шифр: сразу находите место на полке по классификационному номеру
Представьте, что у вас огромная библиотека с тысячами книг.
Если вы хотите найти конкретную книгу, например «Гарри Поттера», что бы вы сделали? Самый глупый способ — начать с первой книги на первой полке и просматривать одну за другой, пока не найдёте её, — это может занять часы или даже дни!
Что бы сделал умный библиотекарь? Он использовал бысистему индексации: основываясь на некотором правиле названия книги или имени автора (например, первой букве), быстро определить примерную область, где находится книга, и затем искать только в этой небольшой области. Идея этой системы индексации —Хеш-таблица— ядро этого.
Основные концепции
Что такое хеш-таблица?
Хеш-таблица — это структура данных, которая напрямую обращается к значениям по ключам., в ней используется нечто под названиемхеш-функция— волшебная формула, преобразующая ключ произвольного размера (например, строку, число или объект) в число фиксированного размера, называемое хеш-значением.Значение хешаилиХеш-кодЗатем используйте это значение хеша какИндексиндекс массива, и сохраните значение в позиции массива, соответствующей этому индексу.
Этот процесс похож на то, как если бы каждому ключу присвоили уникальный номер места (значение хеша), а затем сказали ему: ваши данные находятся в месте с этим номером. Когда вы захотите найти эти данные, вы просто пересчитываете номер места по тому же правилу и идёте прямо к нему — не нужно проверять место за местом.
Основные компоненты
Хеш-таблица в основном состоит из следующих трёх ключевых частей:
- Ключ: идентификатор, который вы используете при сохранении и поиске данных. Например, в телефонной книге имя человека — это ключ.
- Значение: фактические данные, связанные с ключом. В телефонной книге номер телефона — это значение.
- Хеш-функция (Hash Function): математическая функция, которая сопоставляет ключи с индексами массива. Это сердце хеш-таблицы.
Схема работы
Давайте рассмотрим простой пример. Предположим, мы хотим создать телефонную книгу, которая сопоставляет имена с номерами телефонов.
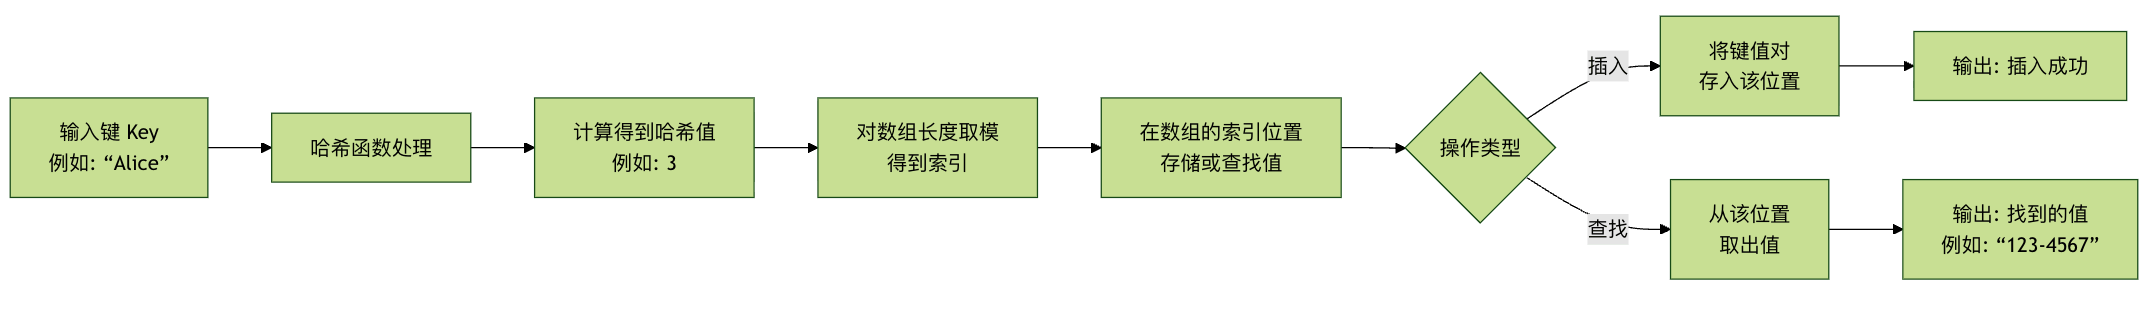
На рисунке выше наглядно показан рабочий процесс хеш-таблицы: независимо от того, выполняется вставка или поиск, процесс всегда начинается с ключа, вычисляет индекс с помощью хеш-функции, а затем напрямую работает с этой позицией в массиве, обеспечивая высокоскоростной доступ.
Проектирование хеш-функции
Характеристики хорошей хеш-функции
| Особенности | Описание | Важность |
|---|---|---|
| Детерминированность | Одинаковый вход всегда даёт одинаковый выход | ⭐⭐⭐⭐⭐ |
| Равномерное распределение | Выход равномерно распределён в пределах диапазона хеш-таблицы | ⭐⭐⭐⭐⭐ |
| Эффективные вычисления | Процесс вычисления прост и быстр | ⭐⭐⭐⭐ |
| Лавинный эффект | Крошечное изменение входных данных вызывает огромное изменение выходных данных | ⭐⭐⭐ |
Распространённые хеш-функции
| Type | Пример | Применимые сценарии |
|---|---|---|
| Метод деления с остатком | hash = key % table_size |
Целочисленный ключ |
| Метод умножения | hash = floor(key * A % 1 * table_size) |
Ключ с плавающей запятой |
| Метод анализа цифр | Анализ закономерностей распределения чисел | Данные с определёнными закономерностями |
| Метод середины квадрата | hash = (key * key) // 10^(n/2) % table_size |
Числовой ключ |
| Хеширование строк | Посимвольная обработка | Строковый ключ |
Методы разрешения коллизий
Метод цепочек
| Особенности | Описание | Временная сложность |
|---|---|---|
| Принцип | Каждая корзина хеш-таблицы хранит связный список | |
| Вставка | Добавить в начало соответствующего связанного списка | O(1) |
| Поиск | Поиск в соответствующем связанном списке | O(k), где k — длина связанного списка |
| Delete | Удалить из соответствующего связанного списка | O(k) |
| Накладные расходы памяти | Требует дополнительной памяти для указателей | Относительно большие |
Метод открытой адресации (Open Addressing)
| Type | Последовательность проб | Преимущества | Недостатки |
|---|---|---|---|
| Линейное пробирование | h, h+1, h+2, ... |
Простой и лёгкий в реализации | Склонность к кластеризации |
| Квадратичное пробирование | h, h+1², h+2², ... |
Снижает кластеризацию | Возможно, не удастся проверить все позиции |
| Двойное хеширование | h, h+hash2(key), h+2*hash2(key), ... |
Равномерное распределение | Вычислительно сложный |
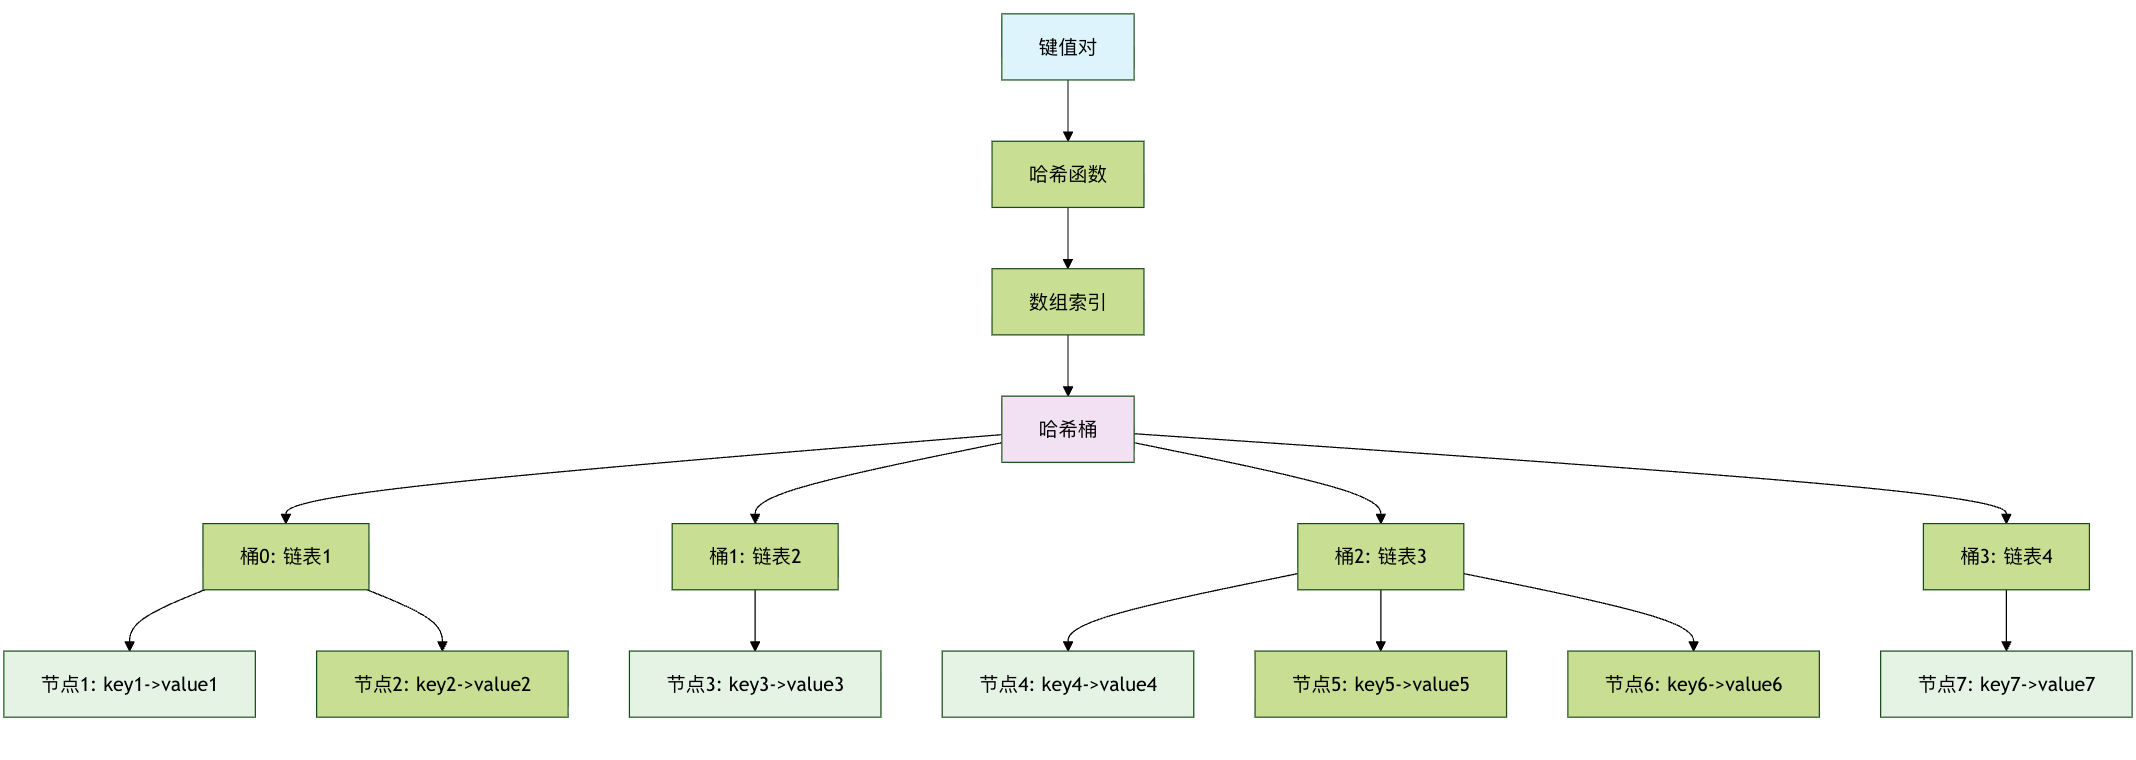
Схема структуры хеш-таблицы
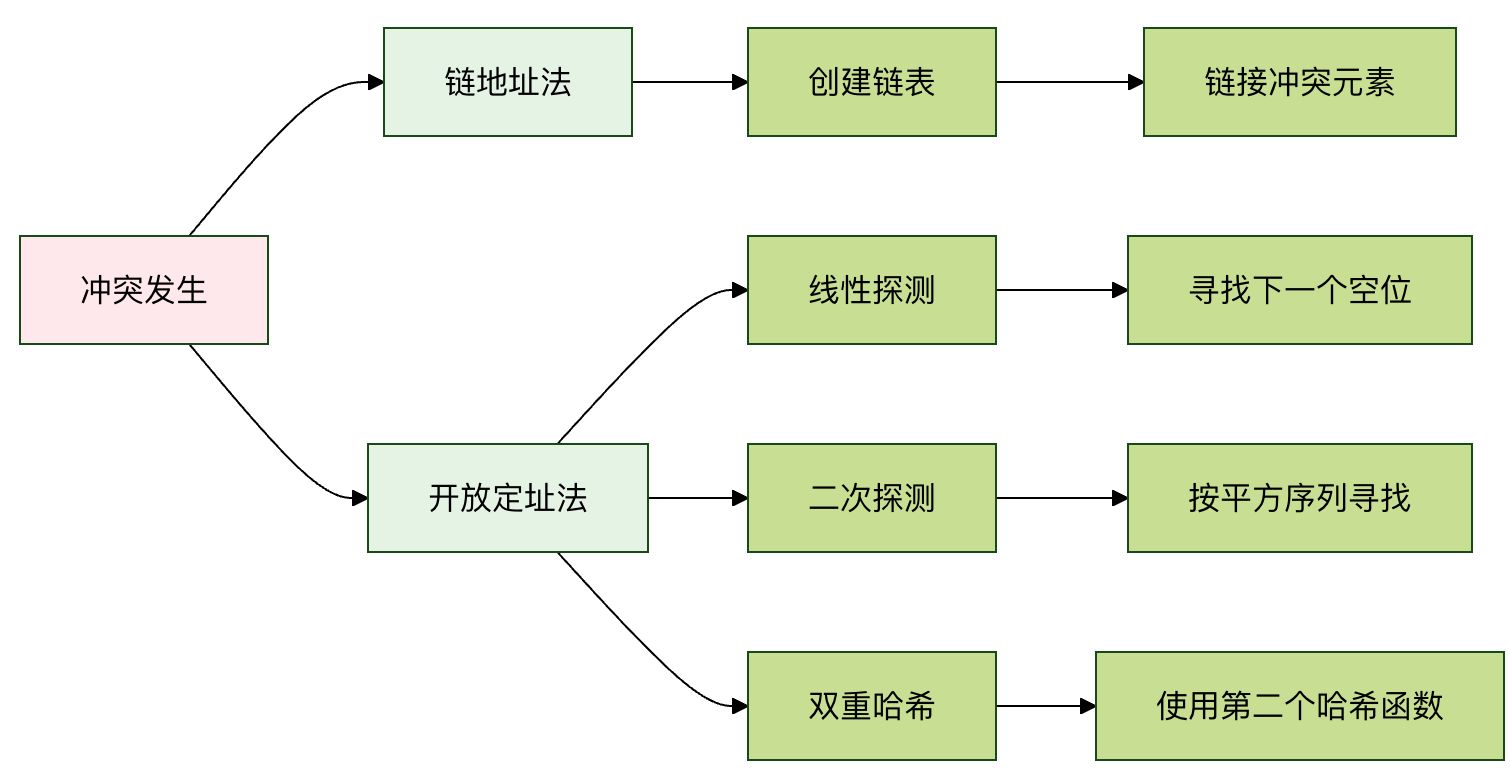
Сравнение методов разрешения конфликтов
Углублённое понимание хеш-функций
Хеш-функция — ключ к эффективности хеш-таблицы. Хорошая хеш-функция должна обладать следующими характеристиками:
- Детерминированность: Один и тот же ключ всегда должен давать одно и то же хеш-значение.
- Эффективность: Скорость вычислений должна быть высокой.
- Равномерное распределение: Позволяет отображать разные ключи как можно более равномерно по всему пространству массива, уменьшая количество коллизий.
Пример простой хеш-функции
Предположим, наши ключи — строки, а длина массива равна 10. Простой хеш-функцией могла бы быть сумма ASCII-кодов каждого символа строки, затем взятие остатка по модулю длины массива.
Пример
"""
Простая хеш-функция для строк.
:param key: Входной ключ (строка)
:param array_size: Размер массива хеш-таблицы
:return: Вычисленный индекс массива
"""
total = 0
for char in key:
# Преобразовать символ в его ASCII-код и накопить значение
total += ord(char)
# Взять остаток от деления на размер массива, чтобы индекс не выходил за пределы массива
return total % array_size
# Протестировать нашу хеш-функцию
keys_to_test = ["Alice", "Bob", "Charlie", "David"]
array_size = 10
print("Результаты теста простой хеш-функции:")
for key in keys_to_test:
hash_index = simple_hash(key, array_size)
print(fКлюч '{key}' -> индекс хеша: {hash_index})
Результат вывода:
简单哈希函数测试结果:
  键 'Alice' -> 哈希索引: 0
  键 'Bob' -> 哈希索引: 8
  键 'Charlie' -> 哈希索引: 5
  键 'David' -> 哈希索引: 3
Эта функция проста, но может быть не лучшей, потому что разные строки могут давать одинаковую сумму (например, ab и ba), что приводит кхеш-коллизии。
Хеш-конфликты и методы их разрешения
Хеш-коллизияколлизии. Коллизия — это когда два или более разных ключа после обработки хеш-функцией дают один и тот же индекс массива. Это как двум зрителям кинотеатра назначают одно и то же место, что явно проблема. Коллизии неизбежны, потому что диапазон хеш-значений (размер массива) обычно конечен, а возможные ключи бесконечны.
Существует два основных классических метода разрешения конфликтов:
Метод 1: метод цепочек
Это самый распространённый метод. Он не размещает данные непосредственно в каждой позиции массива; вместо этого он хранит вСвязный списоксвязный список (или другую структуру данных, например красно-чёрное дерево) в каждой позиции массива. Когда возникает коллизия, новая пара ключ-значение добавляется в связный список в этой позиции.
Описание процесса:
Вычислите хеш-значение ключа и найдите индекс массива.
Если связанный список не пуст (произошла коллизия), пройдите по связанному списку.
- Если найден тот же ключ, обновите его значение (или обработайте его по мере необходимости).
- Если тот же ключ не найден, добавьте новую пару ключ-значение в конец связанного списка.
Пример
"""Реализация хеш-таблицы с использованием цепочек для разрешения коллизий."""
def __init__(self, size=10):
"""Инициализирует хеш-таблицу.
:param size: начальный размер базового массива
"""
self.size = size
# Создать список размера `size`, в котором каждый элемент инициализирован пустым списком (представляющим связанный список)
self.table = [[] for _ in range(size)]
def _hash(self, key):
"""Внутренняя хеш-функция. Здесь мы используем встроенную функцию hash в Python и берём остаток по модулю."""
return hash(key) % self.size
def insert(self, key, value):
"""Вставить пару ключ-значение в хеш-таблицу."""
index = self._hash(key)
bucket = self.table[index] # Получить 'bucket' (связный список), соответствующий этому индексу
# Пройти по корзине и проверить, существует ли уже ключ
for i, (k, v) in enumerate(bucket):
if k == key:
# Ключ уже существует, обновить значение
bucket[i] = (key, value)
return
# Ключ отсутствует, добавить его в конец связного списка
bucket.append((key, value))
def get(self, key):
"""Получить значение по ключу. Если ключ отсутствует, вернуть None."""
index = self._hash(key)
bucket = self.table[index]
for k, v in bucket:
if k == key:
return v
return None # Ключ отсутствует
def delete(self, key):
"""Удалить пару ключ-значение по ключу."""
index = self._hash(key)
bucket = self.table[index]
for i, (k, v) in enumerate(bucket):
if k == key:
del bucket[i] # Удалить этот узел из связного списка
return True # Удаление выполнено успешно
return False # Ключ отсутствует, удаление не удалось
def display(self):
"""Вывести всё содержимое хеш-таблицы."""
for i, bucket in enumerate(self.table):
print(fИндекс {i}: {bucket})
# Пример использования
print("\n--- Пример хеш-таблицы с цепочками ---)
phone_book = HashTableChaining(5)
phone_book.insert("Alice", "123-4567")
phone_book.insert("Bob", "987-6543")
phone_book.insert("Charlie", "555-1234")
# Предположим, что хеш-значение "David" вызывает коллизию с "Alice" (для демонстрации)
phone_book.insert("David", "111-2222")
print("Хеш-таблица после вставки данных:")
phone_book.display()
print(f"\nНайти телефон 'Bob': {phone_book.get('Bob')}")
print(f"Поиск несуществующего 'Eve': {phone_book.get('Eve')}")
phone_book.delete("Charlie")
print("\nХеш-таблица после удаления 'Charlie':")
phone_book.display()
Результат вывода:
--- 链地址法哈希表示例 ---
插入数据后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: [('Charlie', '555-1234')]
索引 4: [('Bob', '987-6543')]

查找 'Bob' 的电话: 987-6543
查找不存在的 'Eve': None

删除 'Charlie' 后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: []
索引 4: [('Bob', '987-6543')]
Примечание: Чтобы наглядно продемонстрировать коллизии, в примере размер массива установлен равным 5, и мы используем
hash(key), фактические конфликты могут быть неочевидны. Вsimple_hashПод функцией,"Alice"и"David"ключи, которые могут давать один и тот же индекс, тем самым показывая, как метод цепочек хранит несколько записей под одним индексом.
Метод 2: метод открытой адресации
Этот метод сохраняет все элементы непосредственно в самом массиве. При возникновении коллизии он ищет следующую свободную позицию в массиве в соответствии с последовательностью проб.
Распространённые методы проб:
- Линейное пробирование: Если позиция
iзанята, то попробуйтеi+1,i+2,i+3... пока не будет найдена пустая ячейка. - Квадратичное пробирование: Если позиция
iзанята, то попробуйтеi+1^2,i+2^2,i+3^2...。 - Двойное хеширование: Используйте вторую хеш-функцию для вычисления размера шага пробирования.
Здесь мы реализуем простое линейное пробирование:
Пример
"""Реализация хеш-таблицы с использованием линейного пробирования (открытая адресация) для разрешения коллизий."""
def __init__(self, size=10):
self.size = size
# Используйте специальный маркер `None` для обозначения пустых ячеек и маркер (например, `'DELETED'`) для обозначения удалённых позиций.
# Для простоты для пустых ячеек используется только `None`; поиск останавливается, когда встречает `None`.
self.keys = [None] * size
self.values = [None] * size
def _hash(self, key):
return hash(key) % self.size
def insert(self, key, value):
index = self._hash(key)
original_index = index
# Использовать линейное пробирование для поиска пустого слота или того же ключа
while self.keys[index] is not Отсутствует:
if self.keys[index] == key:
# Ключ уже существует, обновить значение
self.values[index] = value
return
index = (index + 1) % self.size # Перейти к следующей позиции (циклический массив)
if index == original_index:
# Прошли полный круг; таблица заполнена (на практике следует изменить размер)
raise Exception("Хеш-таблица заполнена")
# Найден пустой слот, вставляем
self.keys[index] = key
self.values[index] = value
def get(self, key):
index = self._hash(key)
original_index = index
while self.keys[index] is not Отсутствует:
if self.keys[index] == key:
return self.values[index]
index = (index + 1) % self.size
if index == original_index:
break # Прошли полный круг, так и не найдя его
return None
def display(self):
for i in range(self.size):
if self.keys[i] is not Отсутствует:
print(f"Индекс {i}: ключ={self.keys[i]}, значение={self.values[i]}")
else:
print(fИндекс {i}: пусто)
# Пример использования
print("\n--- Пример хеш-таблицы с линейным пробированием ---)
ht_linear = HashTableLinearProbing(7) # Маленький размер делает пробирование наглядным
ht_linear.insert("Яблоко", 10)
ht_linear.insert("Банан", 20)
ht_linear.insert("Вишня", 30)
# Предположим, 'Финик' и 'Яблоко' вызывают коллизию
ht_linear.insert("Date", 40)
print("Хеш-таблица после вставки данных:")
ht_linear.display()
print(f"\nПоиск 'Banana': {ht_linear.get('Banana')})
print(fПоиск 'Date' (вставлено после коллизии): {ht_linear.get('Date')})
Результат вывода:
--- 线性探测哈希表示例 ---
插入数据后的哈希表:
索引 0: 键=Apple, 值=10
索引 1: 键=Date, 值=40
索引 2: 键=Banana, 值=20
索引 3: 键=Cherry, 值=30
索引 4: 空
索引 5: 空
索引 6: 空

查找 'Banana': 20
查找 'Date' (冲突后插入的): 40
Примечание: При открытой адресации удаление сложно: нельзя просто установить позицию в
Noneпустое значение (null); иначе это нарушит последовательность зондирования. Обычно используется специальный маркер "deleted". Для простоты в этом примере удаление не реализовано.
Сравнение двух методов
| Особенности | Метод цепочек | Открытая адресация |
|---|---|---|
| Сложность реализации | Относительно просто | Относительно сложно, особенно операции удаления |
| Накладные расходы памяти | Требуется дополнительное пространство для хранения указателей (связный список) | Все данные находятся в массиве, поэтому использование пространства может быть выше |
| Влияние коллизий | Коллизии влияют только на производительность одной и той же корзины (связного списка) | Коллизии влияют на позиции последующих вставок и могут приводить к "кластеризации" |
| Момент изменения размера | Расширять, когда средняя длина связного списка превышает порог | Расширять, когда коэффициент загрузки (число элементов / размер массива) превышает порог |
| Применимые сценарии | Общий, более распространённый | Дружественный к кэшу, подходит для сценариев с известным максимальным объёмом данных или ограниченной памятью |
Производительность хеш-таблиц и коэффициент загрузки
Эффективность хеш-таблицы во многом зависит от ключевой метрики:Коэффициент загрузки。
Коэффициент загрузки = количество элементов, хранящихся в хеш-таблице / общий размер массива хеш-таблицы
- Низкий коэффициент загрузки(например, 0.5): означает, что в массиве ещё много пустых слотов, вероятность коллизий низкая, а операции выполняются быстро.
- Высокий коэффициент загрузки(например, 0.9): означает, что массив почти заполнен, вероятность коллизий резко возрастает, связанные списки становятся длиннее или расстояния при пробировании увеличиваются, а производительность снижается.
Чтобы поддерживать высокую производительность, когда коэффициент загрузки превышает определённый порог (например, 0.75), хеш-таблица расширяется:ResizeОперации:
- Создайте новый, более крупный массив (обычно вдвое больше исходного размера).
- Пройдите по всем парам ключ-значение в старой хеш-таблице.
- На основе нового размера массива используйте хеш-функцию, чтобы пересчитать индекс для каждого ключа, и вставьте его в новый массив.
Этот процесс называетсяRehashingХотя это требует времени, он может значительно снизить коэффициент загрузки и вернуть хеш-таблицу к высокой эффективности.
Практическое упражнение: создайте счётчик слов
Давайте используем самостоятельно реализованную хеш-таблицу с цепочками, чтобы решить практическую задачу: подсчёт количества вхождений каждого слова в тексте.
Мы будем использовать следующий текст в качестве тестовых данных (вы можете скопировать его в свой код):
the quick brown fox jumps over the lazy dog the dog is not lazy at all
Пример
print("\n=== Практическое упражнение: Счётчик слов ===)
# 1. Создайте экземпляр хеш-таблицы
word_counter = HashTableChaining(size=10)
# 2. Предоставленный тестовый текст
text = "быстрая коричневая лиса прыгает через ленивую собаку собака не ленивая вообще"
words = text.split() # Разделить текст на список слов
print(Обработанный список слов:, words)
# 3. Перебрать слова и вставить в хеш-таблицу
for word in words:
current_count = word_counter.get(word)
if current_count is None:
# Первое вхождение слова, количество равно 1
word_counter.insert(word, 1)
else:
# Слово уже существует, увеличить количество на 1
word_counter.insert(word, current_count + 1)
# 4. Вывод статистических результатов
print("\nСтатистика вхождений слов:)
# Примечание: наш метод отображения выводит по индексу; здесь мы пишем более удобный для пользователя вывод
all_entries = []
for bucket in word_counter.table:
all_entries.extend(bucket) # Объединить записи во всех корзинах
for word, count in all_entries:
print(f'{word}': {count} раз)
# 5. Проверка конкретного слова
test_word = "the"
print(f"\nПроверка: слово '{test_word}' встречалось {word_counter.get(test_word)} раз.)
test_word = "lazy"
print(fПроверка: слово '{test_word}' встречалось {word_counter.get(test_word)} раз.)
Результат вывода:
=== 实践练习:单词计数器 ===
处理的单词列表: ['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog', 'the', 'dog', 'is', 'not', 'lazy', 'at', 'all']

单词出现次数统计:
  'the': 3 次
  'quick': 1 次
  'brown': 1 次
  'fox': 1 次
  'jumps': 1 次
  'over': 1 次
  'lazy': 2 次
  'dog': 2 次
  'is': 1 次
  'not': 1 次
  'at': 1 次
  'all': 1 次

验证:单词 'the' 出现了 3 次。
验证:单词 'lazy' 出现了 2 次。
Поздравляем! Вы успешно использовали свою собственную реализацию хеш-таблицы, чтобы выполнить практическую задачу. В реальном программировании вам редко приходится реализовывать хеш-таблицу самостоятельно, потому что современные языки программирования (такие как в PythondictJavaHashMapC++'sunordered_map) все предоставляют высокооптимизированные, мощные встроенные реализации хеш-таблиц. Понимание их принципов поможет вам использовать их более разумно и эффективно.
Резюме и обзор ключевых моментов
Что такое хеш-таблица: эффективная структура данных, которая напрямую обращается к значениям по ключам, со средней временной сложностьюO(1)。
Основной механизм: Хеш-функцияПреобразует ключ в индекс массива.
Ключевые проблемы: Хеш-коллизия— разные ключи отображаются на один и тот же индекс.
Решение:
- Метод цепочек: каждая позиция индекса хранит связанный список для хранения конфликтующих пар ключ-значение.
- Открытая адресация: поиск следующей пустой ячейки в массиве в соответствии с последовательностью проб.
Критично для производительности: Коэффициент заполнения. Когда коэффициент заполнения слишком высок, необходимоизменить размери выполнитьперехешированиечтобы восстановить производительность.
Практические применения: хеш-таблицы — краеугольный камень программирования, широко используемый в бесчисленных сценариях, таких как индексирование баз данных, системы кэширования, проверка принадлежности к множеству, хранение свойств объектов и многие другие.
Другие расширения