Алгоритмы сортировки
Алгоритм сортировки — это алгоритм, который упорядочивает последовательность данных согласно определённому методу сортировки; отсортированные данные затем можно поместить в упорядоченный массив.
СортировкаЭто процесс переупорядочивания набора данных (например, массива или списка) в определённом порядке (по возрастанию или убыванию).
Основой сортировки обычно является некоторое свойство элементов данныхКлючнапример, величина чисел, лексикографический порядок строк и т. д.
Сортировка — одна из самых фундаментальных и ключевых алгоритмических задач в информатике. Будь то организация контактов, анализ результатов экзаменов или оптимизация запросов к базе данных — алгоритмы сортировки повсюду.
Понимание различных алгоритмов сортировки не только помогает нам решать практические задачи, но и является отличным способом глубоко понять идеи проектирования и анализа алгоритмов.
Классификация алгоритмов сортировки
Алгоритмы сортировки можно классифицировать по нескольким измерениям, и наиболее распространённая классификация основана на ихвременной сложностиипространственной сложности。
| Измерение классификации | Категория | Описание | Типичные алгоритмы |
|---|---|---|---|
| Временная сложность | Уровень O(n²) | простые и интуитивно понятные, но малоэффективные, подходят для небольших объёмов данных. | Пузырьковая сортировка, сортировка выбором, сортировка вставками |
| Уровень O(n log n) | сравнительно высокая эффективность, и это первый выбор при обработке больших объёмов данных. | Быстрая сортировка, сортировка слиянием, пирамидальная сортировка | |
| Пространственная сложность | Сортировка на месте | Использует только константный объём дополнительной памяти в процессе сортировки. | Пузырьковая сортировка, сортировка выбором, сортировка вставками, сортировка Шелла, пирамидальная сортировка, быстрая сортировка. |
| Сортировка с использованием дополнительной памяти | Во время сортировки требуется дополнительная память, пропорциональная размеру данных. | Сортировка слиянием, сортировка подсчётом, блочная сортировка, поразрядная сортировка. | |
| Стабильность | Устойчивая сортировка | Относительный порядок равных элементов после сортировки не изменяется. | Пузырьковая сортировка, сортировка вставками, сортировка слиянием, сортировка подсчётом, блочная сортировка, поразрядная сортировка. |
| Неустойчивая сортировка | Относительный порядок равных элементов после сортировки может измениться. | Сортировка выбором, сортировка Шелла, пирамидальная сортировка, быстрая сортировка |
Объяснение ключевых понятий:
- Временная сложностьИзмеряет тенденцию изменения времени выполнения алгоритма при увеличении размера данных.
- Пространственная сложностьИзмеряет объём дополнительной памяти, необходимой во время выполнения алгоритма.
- УстойчивостьДля элементов с равными значениями — сохраняется ли их относительный порядок после сортировки. Это очень важно при сортировке по нескольким ключам.
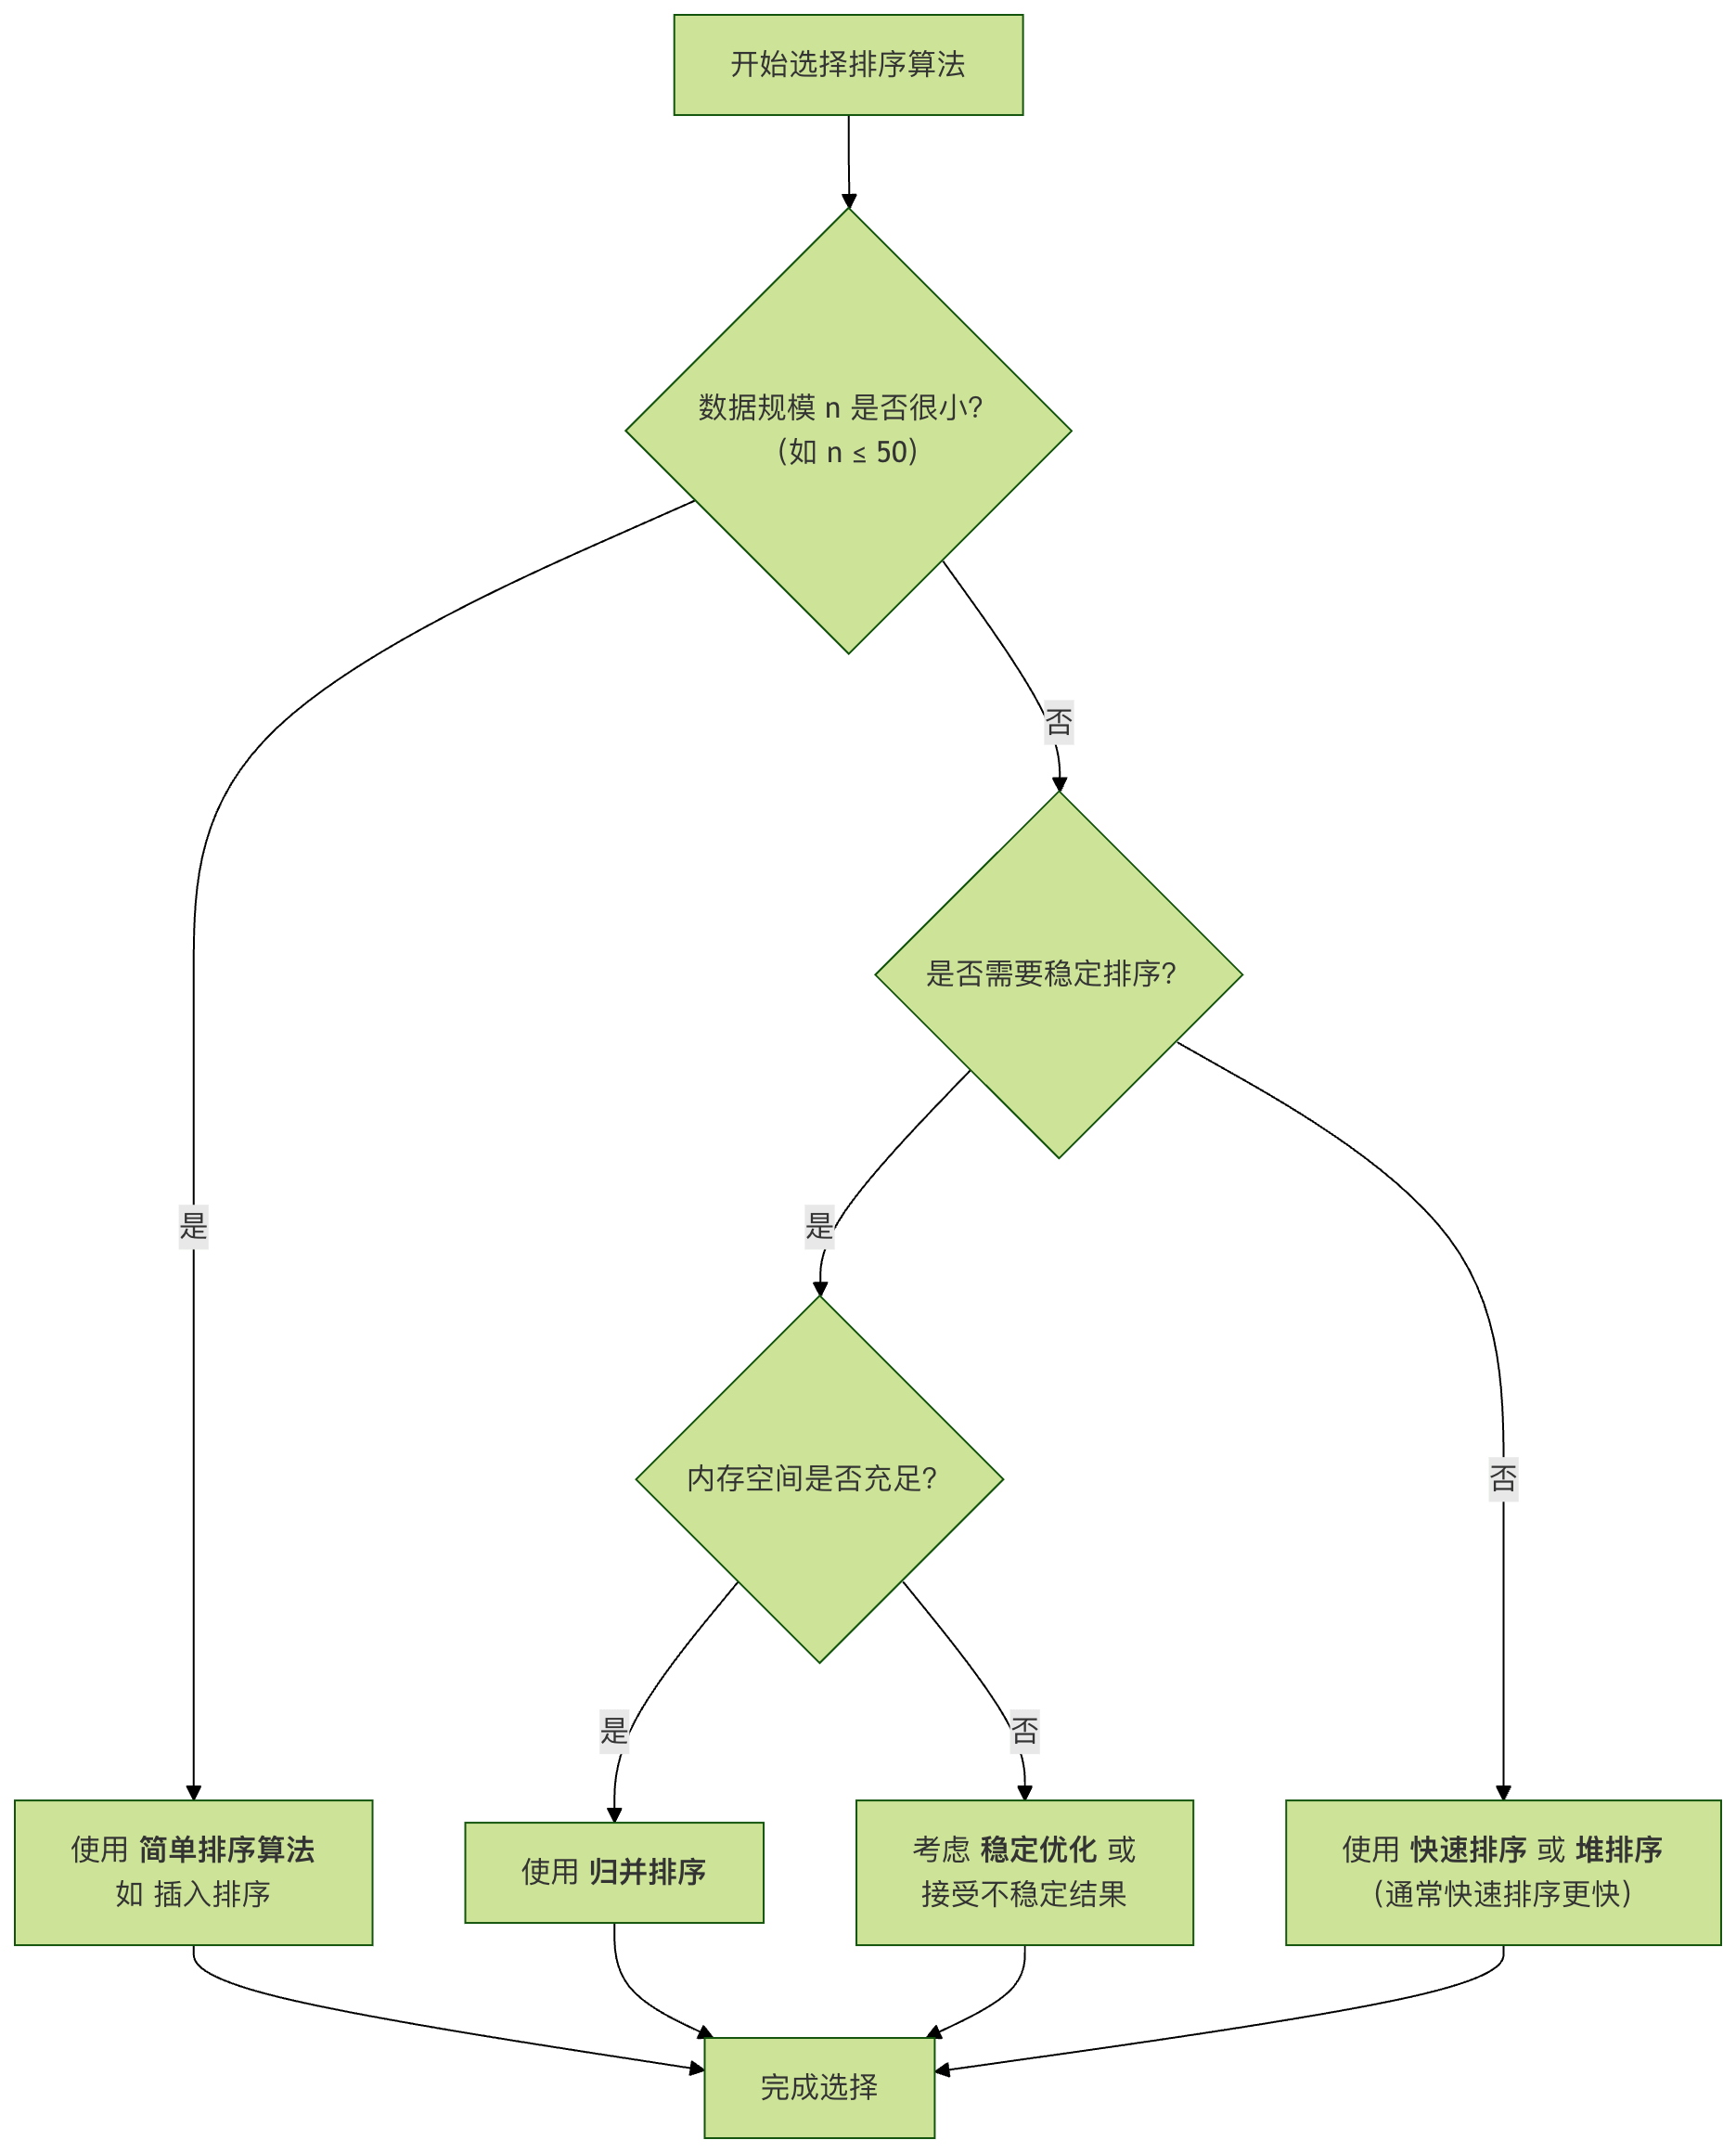
Следующая блок-схема показывает, как сделать предварительный выбор среди нескольких классических алгоритмов в зависимости от различных сценариев требований:
Базовые алгоритмы сортировки уровня O(n²)
Эти алгоритмы просты по своей идее и являются отправной точкой для понимания логики сортировки.
Пузырьковая сортировка
Основная идеяМногократно «проходить» по сортируемой последовательности, сравнивая каждый раз два соседних элемента и меняя их местами, если они стоят в неправильном порядке. При каждом проходе наибольший (или наименьший) элемент в текущей неотсортированной части всплывает на своё правильное место.
Шаги алгоритма:
- Сравните соседние элементы. Если первый больше второго (для сортировки по возрастанию), поменяйте их местами.
- Проделайте то же самое для каждой пары соседних элементов — от первой пары в начале до последней пары в конце. После этого шага последний элемент будет наибольшим числом.
- Повторите вышеописанные шаги для всех элементов, кроме последнего (потому что каждый раунд определяет окончательное положение одного элемента).
- Продолжайте повторять вышеописанные шаги для всё меньшего и меньшего числа элементов, пока не останется ни одной пары чисел для сравнения.
Реализация кода:
Пример
"""
Сортировка пузырьком (по возрастанию)
:param arr: список для сортировки
"""
n = len(arr)
# Внешний цикл управляет количеством необходимых проходов (n-1 проходов)
for i in range(n - 1):
# Внутренний цикл выполняет сравнение и обмен соседних элементов
# После каждого прохода последние i+1 элементов уже отсортированы, поэтому диапазон сравнения — от 0 до n-1-i
for j in range(0, n - 1 - i):
if arr[j] > arr[j + 1]: # Если предыдущий элемент больше следующего элемента
# Поменять местами два элемента
arr[j], arr[j + 1] = arr[j + 1], arr[j]
return arr
# Тестовые данные
test_data = [64, 34, 25, 12, 22, 11, 90]
print("Исходный массив:", test_data)
sorted_data = bubble_sort(test_data.copy()) # Использовать копию, чтобы не изменять исходные данные
print("После пузырьковой сортировки:", sorted_data)
Вывод:
原始数组: [64, 34, 25, 12, 22, 11, 90]
冒泡排序后: [11, 12, 22, 25, 34, 64, 90]
Анализ производительности:
- Временная сложностьЛучший случай O(n) (достигается с оптимизацией, когда данные уже отсортированы), худший и средний случаи O(n²).
- Пространственная сложность: O(1), это сортировка на месте.
- Устойчивость: устойчивая.
Сортировка выбором
Основная идеяНайти наименьший (или наибольший) элемент в неотсортированной последовательности, поместить его в начало отсортированной последовательности, затем продолжать находить наименьший (наибольший) элемент среди оставшихся неотсортированных элементов и помещать его в конец отсортированной последовательности. Продолжать так, пока все элементы не будут отсортированы.
Шаги алгоритма:
- Начальное состояние: вся последовательность является неотсортированной областью.
- В i-м раунде сортировки (i начинается с 0) текущая неотсортированная область — это
arr[i...n-1]Из этой области выберите запись с наименьшим ключомarr[min_index]。 - будет
arr[min_index]С первой записью неотсортированной областиarr[i]Поменяйте местами. Таким образом,arr[0...i]Затем формируется отсортированная область. - После n-1 раундов массив отсортирован.
Реализация кода:
Пример
"""
Сортировка выбором (по возрастанию)
:param arr: список для сортировки
"""
n = len(arr)
for i in range(n):
# Предположим, что элемент с текущим индексом i является наименьшим
min_index = i
# Найдите меньший элемент в диапазоне от i+1 до n-1
for j in range(i + 1, n):
if arr[j] < arr[min_index]:
min_index = j # Обновить индекс наименьшего элемента
# Поменять найденный наименьший элемент с элементом на позиции i
arr[i], arr[min_index] = arr[min_index], arr[i]
return arr
#
test_data = [64, 25, 12, 22, 11]
print("Исходный массив:", test_data)
print("После сортировки выбором:", selection_sort(test_data.copy()))
Вывод:
原始数组: [64, 25, 12, 22, 11]
选择排序后: [11, 12, 22, 25, 64]
Анализ производительности:
- Временная сложностьВсегда O(n²), потому что требуются все сравнения независимо от того, отсортированы ли данные.
- Пространственная сложность: O(1), сортировка на месте.
- Устойчивость:неустойчива. Например, последовательность
[5, 8, 5, 2, 9], в первом проходе первый [элемент] будет5и2обменян местами, нарушая порядок двух5Исходный порядок.
Сортировка вставками
Основная идеяПутём построения упорядоченной последовательности для неотсортированных данных просматриваем отсортированную последовательность в обратном направлении, находим подходящую позицию и вставляем. Это похоже на раскладывание игральных карт.
Шаги алгоритма:
- Считать первый элемент отсортированной последовательностью.
- Возьмите следующий элемент и просмотрите отсортированную последовательность элементов в обратном порядке.
- Если отсортированный элемент больше нового элемента, переместите отсортированный элемент на следующую позицию.
- Повторяйте шаг 3, пока не найдёте позицию, где отсортированный элемент меньше или равен новому элементу.
- После вставки нового элемента в эту позицию.
- Повторяйте шаги 2-5, пока не будут обработаны все элементы.
Реализация кода:
Пример
"""
Сортировка вставками (по возрастанию)
:param arr: список для сортировки
"""
n = len(arr)
# Начните со второго элемента (индекс 1), потому что первый элемент уже отсортирован по умолчанию
for i in range(1, n):
key = arr[i] # Текущий элемент для вставки
j = i - 1 # Индекс последнего элемента в отсортированной последовательности
# Просмотрите отсортированную последовательность с конца к началу, чтобы найти позицию вставки key
# Одновременно сдвиньте элементы, большие key, на одну позицию назад
while j >= 0 and key < arr[j]:
arr[j + 1] = arr[j]
j -= 1
# Вставить key в найденную правильную позицию
arr[j + 1] = key
return arr
#
test_data = [12, 11, 13, 5, 6]
print("Исходный массив:", test_data)
print("После сортировки вставками:", insertion_sort(test_data.copy()))
Вывод:
原始数组: [12, 11, 13, 5, 6]
插入排序后: [5, 6, 11, 12, 13]
Анализ производительности:
- Временная сложностьЛучший случай O(n) (уже отсортирован), худший и средний случаи O(n²).
- Пространственная сложность: O(1), сортировка на месте.
- Устойчивость: устойчивая.
- Особенности: Для небольших объёмов данных или почти отсортированных данных сортировка вставками очень эффективна. Это алгоритм, на который переключаются продвинутые алгоритмы сортировки (такие как Timsort) для небольших объёмов данных.
Эффективные алгоритмы сортировки уровня O(n log n)
Когда размер данных растёт, алгоритмы O(n²) становятся очень медленными. Следующие более эффективные алгоритмы являются основой инженерной практики.
Быстрая сортировка
Основная идея:Разделяй и властвуйВыбрать опорный элемент. За один проход сортировки разделить записи, подлежащие сортировке, на две независимые части, где все ключи одной части меньше ключей другой части; затем отсортировать эти две части отдельно, чтобы вся последовательность стала упорядоченной.
Шаги алгоритма:
- Выбор опорного элементаВыберите элемент из последовательности и назовите его "опорным".
- Операция разбиенияПереставьте последовательность так, чтобы все элементы меньше опорного были размещены перед ним, а все элементы больше опорного — после него (равные числа могут находиться с любой стороны). После завершения этого разбиения опорный элемент находится в своей окончательной позиции в середине последовательности. Это называется операцией разбиения.
- рекурсивная сортировкаРекурсивно отсортировать подпоследовательность с элементами меньше опорного и подпоследовательность с элементами больше опорного.
Реализация кода:
Пример
"""
Быстрая сортировка (по возрастанию) - Основная функция
"""
def _quick_sort(arr, low, high):
if low < high:
# pi — индекс разбиения, arr[pi] теперь в правильной позиции
pi = partition(arr, low, high)
# Рекурсивно сортируем подмассивы до и после разбиения
_quick_sort(arr, low, pi - 1)
_quick_sort(arr, pi + 1, high)
def partition(arr, low, high):
"""
Функция разбиения, выбирает последний элемент в качестве опорного
:return: итоговый индекс правильной позиции опорного элемента
"""
pivot = arr[high] # Выбираем опорный элемент
i = low - 1 # Указывает на конец подмассива элементов, меньших опорного элемента
for j in range(low, high):
# Если текущий элемент меньше или равен опорному элементу
if arr[j] <= pivot:
i += 1
arr[i], arr[j] = arr[j], arr[i] # Поменять местами
# Поместить опорный элемент в правильную позицию (i+1)
arr[i + 1], arr[high] = arr[high], arr[i + 1]
return i + 1
_quick_sort(arr, 0, len(arr) - 1)
return arr
#
test_data = [10, 80, 30, 90, 40, 50, 70]
print("Исходный массив:", test_data)
print("После быстрой сортировки:", quick_sort(test_data.copy()))
Вывод:
原始数组: [10, 80, 30, 90, 40, 50, 70]
快速排序后: [10, 30, 40, 50, 70, 80, 90]
Анализ производительности:
- Временная сложностьСредний случай O(n log n), худший случай O(n²) (когда массив уже отсортирован или отсортирован в обратном порядке, а опорный элемент выбран неудачно). Худшего случая можно в значительной степени избежать, выбирая опорный элемент случайно или используя метод "медианы трёх".
- Пространственная сложность: в среднем O(log n) (стек рекурсивных вызовов), в худшем случае O(n).
- Устойчивость:неустойчивая。
Сортировка слиянием
Основная идея:Разделяй и властвуйТипичное применение. Слияние уже упорядоченных подпоследовательностей для получения полностью упорядоченной последовательности. То есть сначала сделать каждую подпоследовательность упорядоченной, а затем сделать сегменты подпоследовательности упорядоченными друг относительно друга.
Шаги алгоритма:
- РазделениеРазделить текущий интервал на две части, т.е. найти точку разделения
mid = (low + high)/2。 - ПокорениеРекурсивно [отсортировать] два подынтервала
arr[low...mid]иarr[mid+1...high]Выполнить сортировку слиянием. Условие завершения рекурсии — длина подынтервала равна 1 (один элемент считается естественно упорядоченным). - СлияниеОбъединить два отсортированных подынтервала в один упорядоченный интервал.
Реализация кода:
Пример
"""
Сортировка слиянием (по возрастанию) — основная функция
"""
if len(arr) > 1:
mid = len(arr) // 2 # Найти середину и разделить массив
left_half = arr[:mid]
right_half = arr[mid:]
# Рекурсивно отсортировать левую и правую половины
merge_sort(left_half)
merge_sort(right_half)
# Слить два отсортированных подмассива
i = j = k = 0
# Сравнить элементы левого и правого подмассивов, поместить меньший в исходный массив
while i < len(left_half) and j < len(right_half):
if left_half[i] < right_half[j]:
arr[k] = left_half[i]
i += 1
else:
arr[k] = right_half[j]
j += 1
k += 1
# Проверить, остались ли элементы (левая или правая половина)
while i < len(left_half):
arr[k] = left_half[i]
i += 1
k += 1
while j < len(right_half):
arr[k] = right_half[j]
j += 1
k += 1
return arr
#
test_data = [38, 27, 43, 3, 9, 82, 10]
print("Исходный массив:", test_data)
print("После сортировки слиянием:", merge_sort(test_data.copy()))
Вывод:
原始数组: [38, 27, 43, 3, 9, 82, 10]
归并排序后: [3, 9, 10, 27, 38, 43, 82]
Анализ производительности:
- Временная сложностьЛучший, худший и средний случаи — все O(n log n). Производительность очень стабильна.
- Пространственная сложностьO(n), требует дополнительной памяти, равной исходному массиву, для слияния.
- Устойчивость: устойчивая.
Пирамидальная сортировка
Основная идея: использованиекучи. Алгоритм сортировки, разработанный для этой структуры данных. Куча — это почти полное бинарное дерево, которое также удовлетворяет свойству кучи: значение родительского узла всегда больше или равно (max-heap) или меньше или равно (min-heap) значению любого дочернего узла.
Шаги алгоритма:
- Построение max-кучиПостройте из сортируемой последовательности max-кучу. В этот момент максимальное значение всей последовательности — это корневой узел на вершине кучи.
- Обменяйте вершину кучи с последним элементомОбменяйте верхний элемент (максимум) с последним элементом; теперь последний элемент — максимум.
- Отрегулируйте структуру кучи: для оставшихся
n-1Перестройте оставшиеся элементы в max-кучу, что даёт следующее по величине значение. Поменяйте его с новым последним элементом (позиция n-1). - Повторение выполненияПовторяйте шаги 2 и 3, пока размер кучи не станет равным 1; сортировка завершена.
Реализация кода:
Пример
"""
Сортировка кучей (по возрастанию) — с использованием max-кучи
"""
n = len(arr)
# Шаг 1: Постройте max-кучу. Начните корректировку вверх от последнего нелистового узла
# Индекс последнего нелистового узла = n//2 - 1
for i in range(n // 2 - 1, -1, -1):
heapify(arr, n, i)
# Шаги 2 и 3: извлекаем верхний элемент (максимум) по одному и корректируем кучу
for i in range(n - 1, 0, -1):
# Меняем местами текущий верхний элемент (максимум) с последним элементом
arr[i], arr[0] = arr[0], arr[i]
# Корректируем оставшиеся элементы, чтобы снова сделать её максимальной кучей, с размером кучи, установленным в i
heapify(arr, i, 0)
return arr
def heapify(arr, n, i):
"""
Корректируем поддерево с корнем в i, чтобы сделать его максимальной кучей
:param arr: массив кучи
:param n: текущий размер кучи
:param i: индекс текущего корня
"""
largest = i # Инициализируем максимальное значение как корень
left = 2 * i + 1 # Индекс левого потомка
right = 2 * i + 2 # Индекс правого потомка
# Если левый дочерний узел существует и больше корня
if left < n and arr[left] > arr[largest]:
largest = left
# Если правый дочерний узел существует и больше текущего максимума
if right < n and arr[right] > arr[largest]:
largest = right
# Если максимум не является корнем, поменять местами и рекурсивно скорректировать нарушенную подкучу
if largest != i:
arr[i], arr[largest] = arr[largest], arr[i]
heapify(arr, n, largest)
#
test_data = [4, 10, 3, 5, 1]
print("Исходный массив:", test_data)
print("После пирамидальной сортировки:", heap_sort(test_data.copy()))
Вывод:
原始数组: [4, 10, 3, 5, 1]
堆排序后: [1, 3, 4, 5, 10]
Анализ производительности:
- Временная сложностьЛучший, худший и средний случаи — все O(n log n).
- Пространственная сложность: O(1), сортировка на месте.
- Устойчивость:неустойчивая。
Сводка сравнения производительности алгоритмов
Чтобы более наглядно сравнить характеристики вышеуказанных алгоритмов, мы обобщаем их в следующей таблице:
| Алгоритмы | Средняя временная сложность | Временная сложность в худшем случае | Пространственная сложность | Стабильность | Основные возможности |
|---|---|---|---|---|---|
| Пузырьковая сортировка | O(n²) | O(n²) | O(1) | Устойчивая | Простой, низкая эффективность, подходит для обучения. |
| Сортировка выбором | O(n²) | O(n²) | O(1) | неустойчивая | Меньше обменов, но фиксированное большое число сравнений. |
| Сортировка вставками | O(n²) | O(n²) | O(1) | Устойчивая | Эффективен для небольших объёмов данных или почти отсортированных данных. |
| Быстрая сортировка | O(n log n) | O(n²) | O(log n) | неустойчивая | Наилучшая средняя производительность, это самый широко используемый алгоритм сортировки. |
| Сортировка слиянием | O(n log n) | O(n log n) | O(n) | Устойчивая | Стабильная производительность, но требует дополнительной памяти. Часто используется для внешней сортировки. |
| Пирамидальная сортировка | O(n log n) | O(n log n) | O(1) | неустойчивая | Сортировка на месте и O(n log n) даже в худшем случае. |
Практические упражнения
После теоретического обучения лучший способ закрепить знания — практика.
Упражнение 1: Выбор алгоритма и реализация
Для следующих сценариев какой алгоритм сортировки вы выберете? Кратко объясните свой выбор.
- Отсортируйте массив, содержащий 10 чисел.
- Отсортируйте связный список из 1 миллиона объектов студентов по идентификатору студента, требуется устойчивость.
- Отсортируйте большой массив во встраиваемой системе с ограниченной памятью.
- Нужно получать K наибольших элементов из потока данных в реальном времени.
Эталонный подход к ответу:
- Сортировка вставкамиМалый объём данных; сортировка вставками проста, хорошо подходит для почти отсортированных данных и имеет небольшой постоянный коэффициент.
- Сортировка слияниемБольшой объём данных, требуется устойчивая сортировка, а структура связного списка позволяет выполнить операцию слияния сортировки слиянием за O(1) памяти (просто изменяя указатели).
- Пирамидальная сортировкаОграниченная память, требуется сортировка на месте, и пирамидальная сортировка гарантирует производительность O(n log n) даже в худшем случае.
- Поддерживайте минимальную кучу размера KОбходите поток данных и используйте кучу для поддержания текущих K наибольших элементов. Это не полная сортировка, но она использует свойства кучи.
Упражнение 2: отладка и оптимизация кода
В приведённой ниже пузырьковой сортировке есть небольшая ошибка и одно место, которое можно оптимизировать; пожалуйста, найдите и исправьте их.
Пример
n = len(arr)
for i in range(n):
for j in range(n - 1):
if arr[j] > arr[j]:
arr[j], arr[j+1] = arr[j+1], arr[j]
return arr
Подсказка:
- Условие сравнения
arr[j] > arr[j]Всегда ложно. - Границу внутреннего цикла можно оптимизировать, потому что после каждого раунда конечные элементы уже отсортированы.
Упражнение 3: Практическая реализация
Попробуйте реализовать его самостоятельно с нуляQuicksort, и подумайте:
- Если бенчмарк
pivotЧто произойдёт, если первый элемент всегда выбирается в качестве опорного при сортировке уже отсортированного массива? - Как изменить
partitionИзмените функцию partition так, чтобы она стала «трёхпутевой быстрой сортировкой», которая может более эффективно обрабатывать массивы с большим количеством повторяющихся элементов.