Алгоритм трехсторонней сортировки
Алгоритм трехсторонней сортировки(Three-Way Partitioning) — это особая разновидность быстрой сортировки, оптимизированная специально для массивов, содержащих много дублирующихся элементов. Его основная идея — разделить массив на три части за один проход разбиения, а не на традиционные две части.
Трехсторонняя быстрая сортировка — это дальнейшее улучшение двухсторонней быстрой сортировки. Алгоритм трехсторонней сортировки делит сортируемые данные на три части: меньшие v, равные v и большие v, где v — опорный элемент. Таким образом, среди трех частей данные, равные v, больше не нуждаются в сортировке при следующей рекурсии, а данные меньше v или больше v не окажутся в ситуации, когда одна сторона особенно велика. Благодаря этому подходу алгоритм трехсторонней быстрой сортировки показывает лучшую производительность.
Представьте, что у вас есть большое ведро смешанных цветных шариков трех цветов: красного, белого и синего. Ваша задача — быстро разделить их так, чтобы все красные шарики были слева, белые — посередине, а синие — справа. Алгоритм трехстороннего разбиения — это мастер сортировки для решения таких задач.
Традиционная быстрая сортировка против трехсторонней быстрой сортировки
Давайте используем простую таблицу, чтобы сравнить различия между ними:
| Особенности | Традиционная быстрая сортировка | Быстрая сортировка с трёхсторонним разбиением |
|---|---|---|
| Количество разбиений | 2 (меньше опорного элемента, больше опорного элемента) | 3 (меньше опорного элемента, равно опорному элементу, больше опорного элемента) |
| Обработка повторяющихся элементов | Менее эффективна; дублирующиеся элементы могут многократно сравниваться и обмениваться местами | Чрезвычайно эффективна, дублирующиеся элементы обрабатываются вместе |
| Временная сложность | В среднем O(n log n), в худшем случае O(n²) | В среднем O(n log n), в худшем случае O(n²) |
| Пространственная сложность | O(log n) (стек рекурсии) | O(log n) (стек рекурсии) |
| Применимые сценарии | Универсальная сортировка, низкая доля дублирующихся элементов | Высокая доля дублирующихся элементов, например сортировка цветов и сегментация оценок |
Применимость
Временная и пространственная сложность такие же, как у рандомизированной быстрой сортировки.
Алгоритм трёхпутевой быстрой сортировки разделяет массив с использованием стратегии трёхпутевого разбиения, что очень эффективно для массивов с множеством дублирующихся элементов и улучшает процесс быстрой сортировки. Он добавляет логику обработки элементов, равных опорному значению, группируя все значения, равные опорному элементу, вместе.
Схема процесса
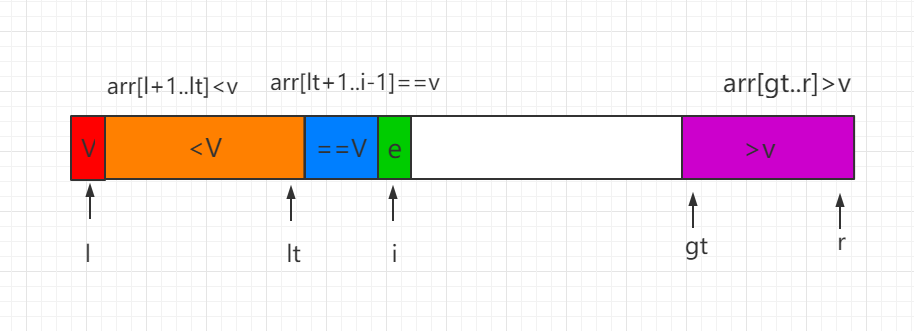
Рассмотрим процесс разбиения в трёх случаях, где i обозначает текущую позицию индекса обхода:
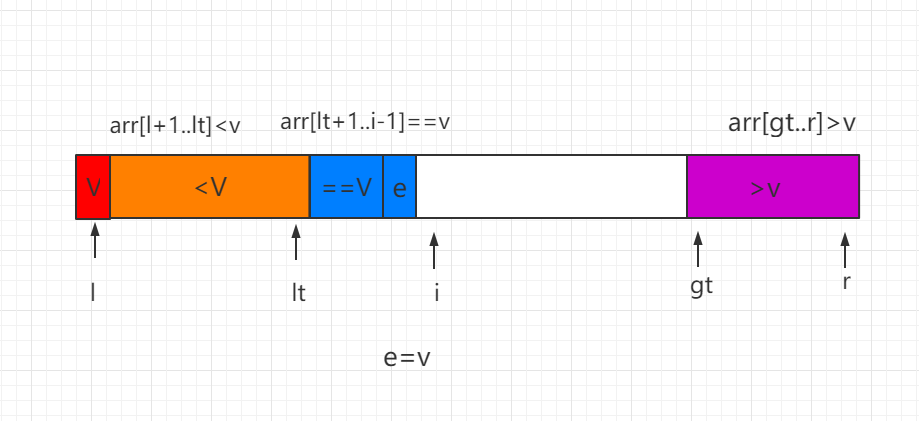
(1) Текущий элемент e = V напрямую помещается в синий интервал, и i сдвигается на одну позицию вправо.
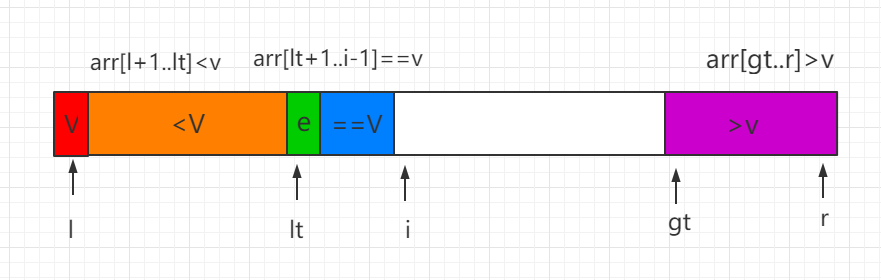
(2) Текущий элемент e < v: поменять местами e со значением в первой позиции интервала, равного V, и сдвинуть как lt, так и i на одну позицию вправо.
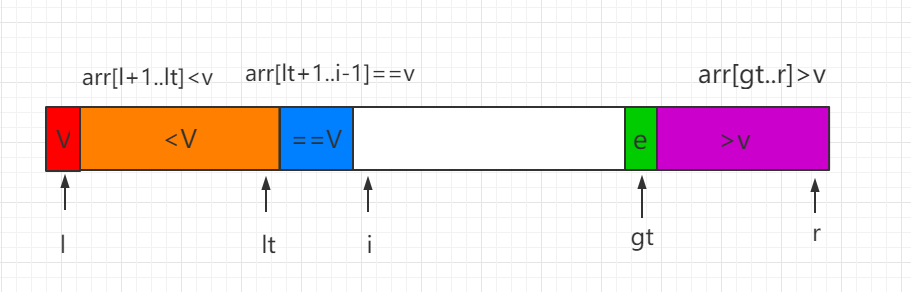
(3) Текущий элемент e > v: поменять местами e со значением по индексу gt-1 и сдвинуть индекс gt на одну позицию влево.
Наконец, когдаi=gtобход завершается, поменяйте местами v со значением, на которое указывает индекс lt, и на этом процесс разбиения завершается. Затем тем же методом рекурсивно отсортируйте части <V и >V.
Пример кода на Java
Загрузка пакета исходного кода:Скачать
Код файла QuickSort3Ways.java:
/**
* Трёхпутевая быстрая сортировка
*/
public class QuickSort3Ways {
// Основной код --- начало
// Рекурсивно применяйте быструю сортировку для сортировки диапазона arr[l...r]
private static void sort(Comparable[] arr, int l, int r){
if (l >= r) {
return;
}
// Случайным образом выбрать значение в качестве опорного элемента в диапазоне arr[l...r]
swap( arr, l, (int)(Math.random()*(r-l+1)) + l );
Comparable v = arr[l];
int lt = l; // arr[l+1...lt] < v
int gt = r + 1; // arr[gt...r] > v
int i = l+1; // arr[lt+1...i) == v
while( i < gt ){
if( arr[i].compareTo(v) < 0 ){
swap( arr, i, lt+1);
i ++;
lt ++;
}
else if( arr[i].compareTo(v) > 0 ){
swap( arr, i, gt-1);
gt --;
}
else{ // arr[i] == v
i ++;
}
}
swap( arr, l, lt );
sort(arr, l, lt-1);
sort(arr, gt, r);
}
// Основной код --- конец
public static void sort(Comparable[] arr){
int n = arr.length;
sort(arr, 0, n-1);
}
private static void swap(Object[] arr, int i, int j) {
Object t = arr[i];
arr[i] = arr[j];
arr[j] = t;
}
// Тест QuickSort3Ways
public static void main(String[] args) {
// Алгоритм трёхпутевой быстрой сортировки также является алгоритмом сложности O(nlogn)
// Может легко обрабатывать данные порядка 1 миллиона за 1 секунду
int N = 1000000;
Integer[] arr = SortTestHelper.generateRandomArray(N, 0, 100000);
sort(arr);
SortTestHelper.printArray(arr);
}
}
Основная идея и принцип работы алгоритма
Тонкость алгоритма трёхпутевого разбиения заключается в том, что он использует три указателя для отслеживания различных областей массива, выполняя трёхпутевую классификацию за один проход.
Состояние разбиения алгоритма
Давайте разберём процесс разбиения алгоритма с помощью диаграммы состояний:
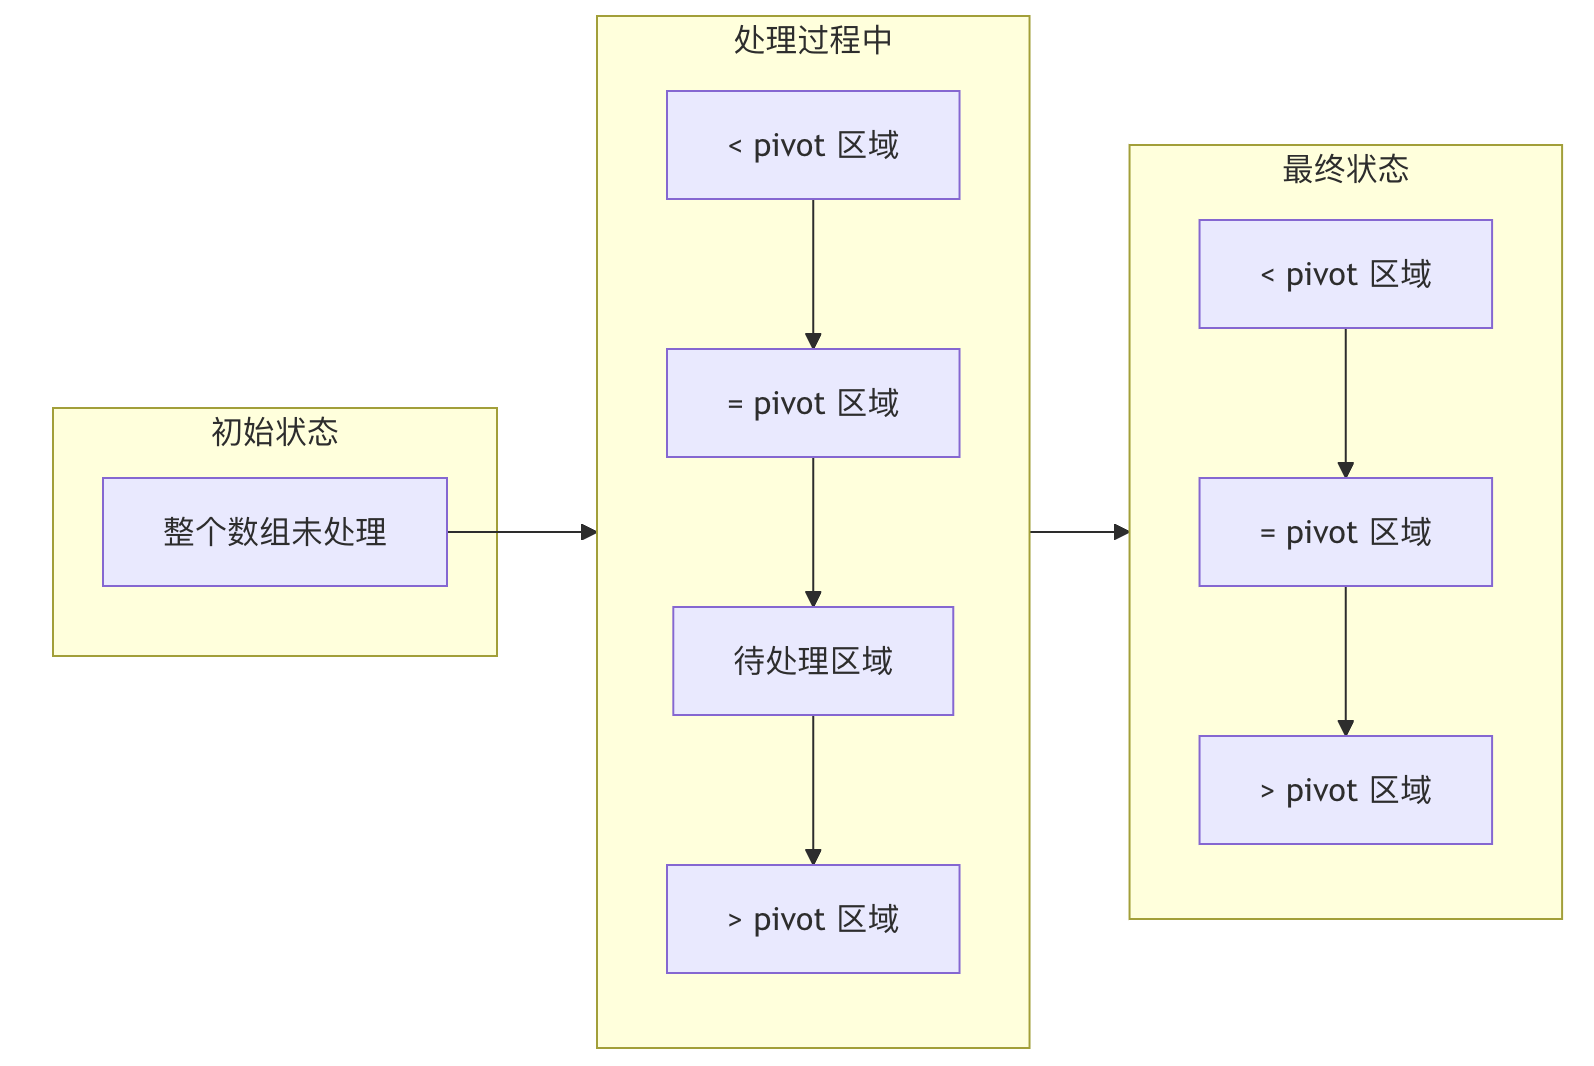
Описание рисункаАлгоритм поддерживает три указателя (lt, i, gtОн делит массив на четыре области; по мере обработки необработанная область постепенно уменьшается, в итоге образуя три чётких раздела.
Роли трёх ключевых указателей
lt(меньше) указательУказывает на конец области, элементы которой меньше опорного элементаi(текущий) указательПозиция элемента, который сейчас проверяетсяgt(больше) указательУказывает на начало области, элементы которой больше опорного элемента
Реализация на Python
Базовая функция трехстороннего разбиения
Ниже представлена стандартная реализация функции трехстороннего разбиения; мы разберем ее строка за строкой:
Пример
"""
Выполнить трехстороннее разбиение массива arr в диапазоне от low до high
Параметры:
arr: массив, который нужно разбить
low: начальный индекс разбиения
high: конечный индекс разбиения
Возвращает:
(lt, gt): левая и правая границы области, равной значению опорного элемента
"""
# Выбрать опорный элемент (здесь выбирается первый элемент)
pivot = arr[low]
# Инициализировать три указателя
lt = low # Правая граница области, значения которой меньше опорного элемента (инициализируется значением low)
i = low + 1 # Позиция текущего проверяемого элемента
gt = high # Левая граница области, элементы которой больше опорного элемента (инициализируется значением high)
# Основной цикл: продолжаем, пока остаются необработанные элементы
while i <= gt:
if arr[i] < pivot:
# Случай 1: текущий элемент меньше опорного
# Поменять его местами со следующим элементом указателя lt, чтобы расширить область элементов меньше опорного
arr[lt], arr[i] = arr[i], arr[lt]
lt += 1
i += 1
elif arr[i] > pivot:
# Случай 2: текущий элемент больше опорного
# Поменять его местами с элементом, на который указывает gt, чтобы расширить область элементов больше опорного
arr[i], arr[gt] = arr[gt], arr[i]
gt -= 1
# Примечание: i здесь не увеличивается, потому что элемент, помещённый сюда обменом, ещё не был проверен
else:
# Случай 3: текущий элемент равен опорному элементу
# Пропустить сразу, расширяя область элементов, равных опорному
i += 1
# Вернуть границы области элементов, равных опорному элементу
return lt, gt
Полная реализация трёхпутевой быстрой сортировки
Основываясь на приведённой выше функции разбиения, можно реализовать полную трёхпутевую быструю сортировку:
Пример
"""
Основная функция трёхпутевой быстрой сортировки
Параметры:
arr: массив, который нужно отсортировать
low: начальный индекс для сортировки (по умолчанию 0)
high: конечный индекс для сортировки (по умолчанию конец массива)
"""
if high is None:
high = len(arr) - 1
# Условие завершения рекурсии: длина подмассива меньше или равна 1
if low >= high:
return
# Выполнить трехстороннее разбиение
lt, gt = three_way_partition(arr, low, high)
# Рекурсивно отсортировать часть, меньшую опорного элемента
three_way_quicksort(arr, low, lt - 1)
# Рекурсивно отсортировать часть, большую опорного элемента
three_way_quicksort(arr, gt + 1, high)
# Примечание: часть, равная опорному элементу, уже находится на своём правильном месте, дальнейшая сортировка не требуется
Практические примеры применения
Пример 1: Задача сортировки цветов
Это классический сценарий применения алгоритма трёхстороннего разбиения, также известного как «задача о голландском национальном флаге».
Пример
"""
Сортировка цветов: упорядочить массив, содержащий только 0 (красный), 1 (белый), 2 (синий), по порядку
Параметры:
colors: массив цветов, элементы — 0, 1, 2
Возвращает:
Отсортированный массив цветов
"""
# Инициализировать три указателя
red_ptr = 0 # Конец красной области
white_ptr = 0 # Текущая проверяемая позиция (также конец белой области)
blue_ptr = len(colors) - 1 # Начало синей области
while white_ptr <= blue_ptr:
if colors[white_ptr] == 0:
# Красный: переставить в красную область
colors[red_ptr], colors[white_ptr] = colors[white_ptr], colors[red_ptr]
red_ptr += 1
white_ptr += 1
elif colors[white_ptr] == 1:
# Белый: остаётся в средней области
white_ptr += 1
else:
# Синий: переставить в синюю область
colors[white_ptr], colors[blue_ptr] = colors[blue_ptr], colors[white_ptr]
blue_ptr -= 1
# Примечание: white_ptr здесь не увеличивается, потому что переставленный сюда элемент ещё не проверен
return colors
# Тестовые данные
test_colors = [2, 0, 2, 1, 1, 0, 1, 2, 0, 1, 0, 2]
print("Исходный массив цветов:", test_colors)
print("Отсортированный массив цветов:", sort_colors(test_colors.copy()))
Описание тестовых данныхМассив выше представляет цветовые коды (0=красный, 1=белый, 2=синий). После сортировки все нули должны быть впереди, единицы в середине, а двойки в конце.
Пример 2: Группировка студентов по баллам
Предположим, нам нужно разделить студентов по баллам: ниже 60 — неудовлетворительно, 60-80 — хорошо, а выше 80 — отлично.
Пример
"""
Классифицировать баллы на три уровня: Неудовлетворительно (<60), Хорошо (60-80), Отлично (>80)
Параметры:
scores: массив баллов
Возвращает:
Сегментированный массив баллов
"""
if not scores:
return scores
# Используйте идею трёхстороннего разбиения, где 60 и 80 — границы
# Сначала разделите по 60: не сдавшие против сдавших или выше
low = 0
mid = 0
high = len(scores) - 1
# Первый раунд: отделяем неудовлетворительные баллы (<60)
while mid <= high:
if scores[mid] < 60:
scores[low], scores[mid] = scores[mid], scores[low]
low += 1
mid += 1
elif scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
# Второй раунд: отделить хорошие и отличные оценки от части сдавших и выше
# На этом этапе low указывает на позицию первой хорошей оценки
mid = low
high = len(scores) - 1
while mid <= high:
if scores[mid] <= 80:
mid += 1
else:
scores[mid], scores[high] = scores[high], scores[mid]
high -= 1
return scores
# Тестовые данные
test_scores = [45, 78, 92, 56, 85, 67, 72, 88, 59, 95, 61, 73]
print("Исходные оценки:", test_scores)
print("Оценки по категориям:", categorize_grades(test_scorescopy()))
print(Примечание: первая часть <60, средняя часть 60-80, последняя часть >80)
Анализ алгоритма
Временная сложность
Анализ временной сложности алгоритма можно выразить следующей формулой:
$$ T(n) = O(n) + T(k) + T(n - k - m) $$
Где:
- $n$ — длина массива
- $k$ — количество элементов, меньших значения опорного элемента
- $m$ — количество элементов, равных значению опорного элемента
- $n - k - m$ — количество элементов, больших значения опорного элемента
Лучший случайЛучший случай: каждое разбиение может поровну разделить массив на три части, с временной сложностью $O(n \log_3 n)$, что фактически всё ещё $O(n \log n)$.
Худший случайХудший случай: каждое разбиение крайне несбалансировано, с временной сложностью $O(n^2)$.
Средний случайСредний случай: для случайных данных средняя временная сложность составляет $O(n \log n)$.
Пространственная сложность
Алгоритм реализован рекурсивно, и глубина рекурсии зависит от характера разбиения:
- Лучший случай:$O(\log n)$
- Худший случай:$O(n)$
Использование памяти можно сократить за счёт оптимизации хвостовой рекурсии или использования итеративного подхода.