Tabla hash
Una tabla hash (Hash Table), también llamada tabla de dispersión, es una estructura de datos extremadamente eficiente.
Una tabla hash puede, en promedio, con una complejidad temporal cercana aO(1)realizar la inserción, eliminación y búsqueda de datos, lo que es mucho más rápido que el recorrido de un array (O(n)) y la búsqueda en un árbol binario de búsqueda (O(log n)) es mucho más rápido.
| Operación | Array/Lista enlazada | Tabla hash |
|---|---|---|
| Búsqueda | O(n) | O(1) |
| Inserción | O(n) | O(1) |
| Eliminación | O(n) | O(1) |
| Eficiencia espacial | Alto | Media |
Tabla hashEs como un sistema de casilleros inteligentes:
- Casilleros tradicionales: debes recordar en qué casillero pusiste cada objeto (búsqueda lineal)
- Casilleros inteligentes: le dices al administrador el nombre del objeto y él te dice directamente el número del casillero (búsqueda hash)
Idea central:
Mediantela función hashva ala clave (Key)se convierte enun índice de array, logrando un acceso rápido.
Casos cotidianos:
- Buscar en el diccionario: localizar rápidamente la página según la letra inicial de la palabra
- Guía telefónica: ordenar por la pronunciación del apellido para encontrar rápidamente el contacto
- Signatura bibliotecaria: según el número de clasificación, encontrar directamente el estante donde está el libro
Imagina que tienes una biblioteca enorme con miles de libros.
Si quieres encontrar un libro concreto, como *Harry Potter*, ¿qué harías? El método más torpe sería empezar por el primer libro del primer estante e ir buscando uno a uno hasta encontrarlo; ¡esto podría llevar horas e incluso días!
¿Qué haría un bibliotecario inteligente? Usaría unsistema de indexación: de acuerdo con alguna regla del título o del autor (por ejemplo, la letra inicial), localizar rápidamente la zona aproximada donde está el libro y luego solo hay que buscar en esa pequeña zona. La idea de este sistema de indexación es elnúcleo de la tabla hash.
Conceptos básicos
¿Qué es una tabla hash?
Una tabla hash es una estructura de datos que accede directamente al valor (Value) a través de una clave (Key), utilizando unafunción hash, una fórmula mágica que convierte claves de cualquier tamaño (por ejemplo, una cadena, un número o un objeto) en un número de tamaño fijo; este número se llamavalor hashoo código hash. Luego, se usa este valor hash comoíndice del array, y el valor se almacena en la posición correspondiente del array.
Este proceso es como asignar a cada clave un número de asiento único (valor hash) y decirle: tus datos están en este asiento. Cuando quieras encontrar los datos, solo tienes que volver a calcular el número de asiento con la misma regla y podrás ir directamente a recogerlos, sin tener que preguntar asiento por asiento.
Componentes principales
Una tabla hash se compone principalmente de las siguientes tres partes fundamentales:
- Clave (Key): el identificador que utilizas al almacenar y buscar datos. Por ejemplo, en una guía telefónica, el nombre de la persona es la clave.
- Valor (Value): los datos reales asociados a la clave. En una guía telefónica, el número de teléfono es el valor.
- Función hash (Hash Function): la función matemática que asigna la clave a un índice del array. Es el corazón de la tabla hash.
Ilustración del principio de funcionamiento
Expliquémoslo con un ejemplo sencillo. Supongamos que queremos crear una guía telefónica que asigne nombres de personas a números de teléfono.
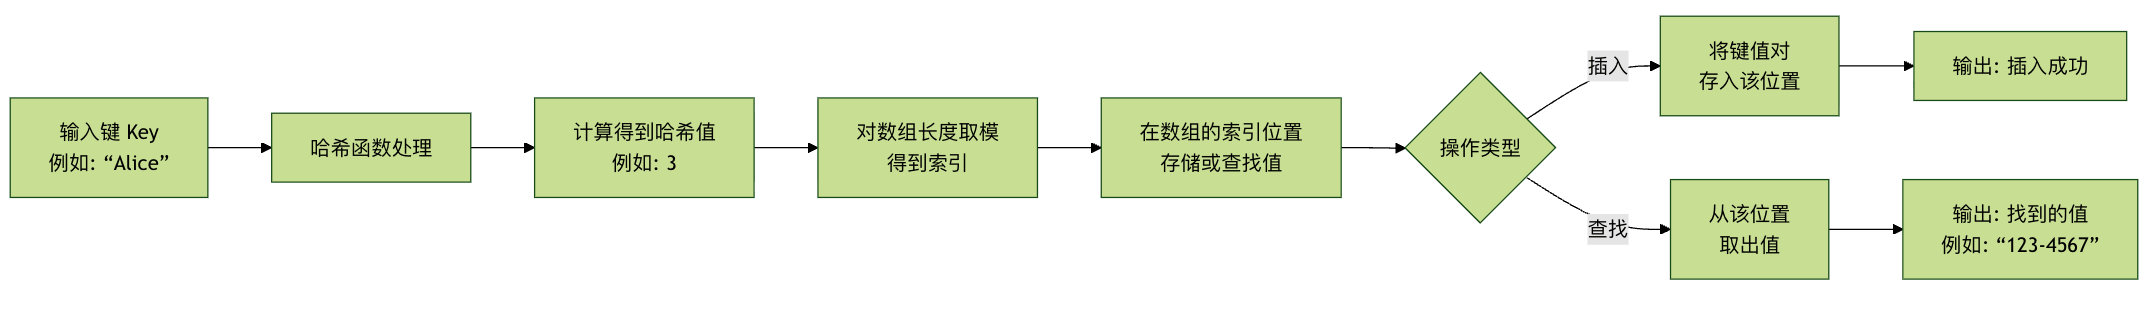
La figura anterior muestra claramente el flujo de trabajo de una tabla hash: tanto la inserción como la búsqueda comienzan con una clave; se calcula el índice mediante la función hash y luego se opera directamente sobre esa posición del array, logrando así un acceso de alta velocidad.
Diseño de la función hash
Características de una buena función hash
| Característica | Descripción | Importancia |
|---|---|---|
| Determinismo | La misma entrada siempre produce la misma salida | ⭐⭐⭐⭐⭐ |
| Distribución uniforme | La salida se distribuye uniformemente por todo el rango de la tabla hash | ⭐⭐⭐⭐⭐ |
| Cálculo eficiente | El proceso de cálculo es simple y rápido | ⭐⭐⭐⭐ |
| Efecto avalancha | Un pequeño cambio en la entrada provoca un gran cambio en la salida | ⭐⭐⭐ |
Funciones hash comunes
| Tipo | Ejemplo | Escenario de aplicación |
|---|---|---|
| Método de división y resto | hash = key % table_size |
Claves enteras |
| Método de multiplicación y truncamiento | hash = floor(key * A % 1 * table_size) |
Claves de punto flotante |
| Análisis de dígitos | Analizar la ley de distribución de los dígitos | Datos con patrones específicos |
| Método del cuadrado medio | hash = (key * key) // 10^(n/2) % table_size |
Claves numéricas |
| Hash de cadenas | Procesar carácter por carácter | Claves de cadena |
Métodos de resolución de colisiones
Encadenamiento separado (Separate Chaining)
| Característica | Descripción | Complejidad temporal |
|---|---|---|
| Principio | Cada cubeta hash mantiene una lista enlazada | |
| Inserción | Agregar al inicio de la lista enlazada correspondiente | O(1) |
| Búsqueda | Buscar en la lista enlazada correspondiente | O(k), donde k es la longitud de la lista enlazada |
| Eliminación | Eliminar de la lista enlazada correspondiente | O(k) |
| Costo de espacio | Requiere almacenamiento adicional de punteros | Grande |
Direccionamiento abierto (Open Addressing)
| Tipo | Secuencia de sondeo | Ventaja | Desventaja |
|---|---|---|---|
| Sondeo lineal | h, h+1, h+2, ... |
Simple y fácil de implementar | Propenso a la aglomeración |
| Sondeo cuadrático | h, h+1², h+2², ... |
Reduce la aglomeración | Puede no sondear todas las posiciones |
| Doble hash | h, h+hash2(key), h+2*hash2(key), ... |
Distribución uniforme | Cálculo complejo |
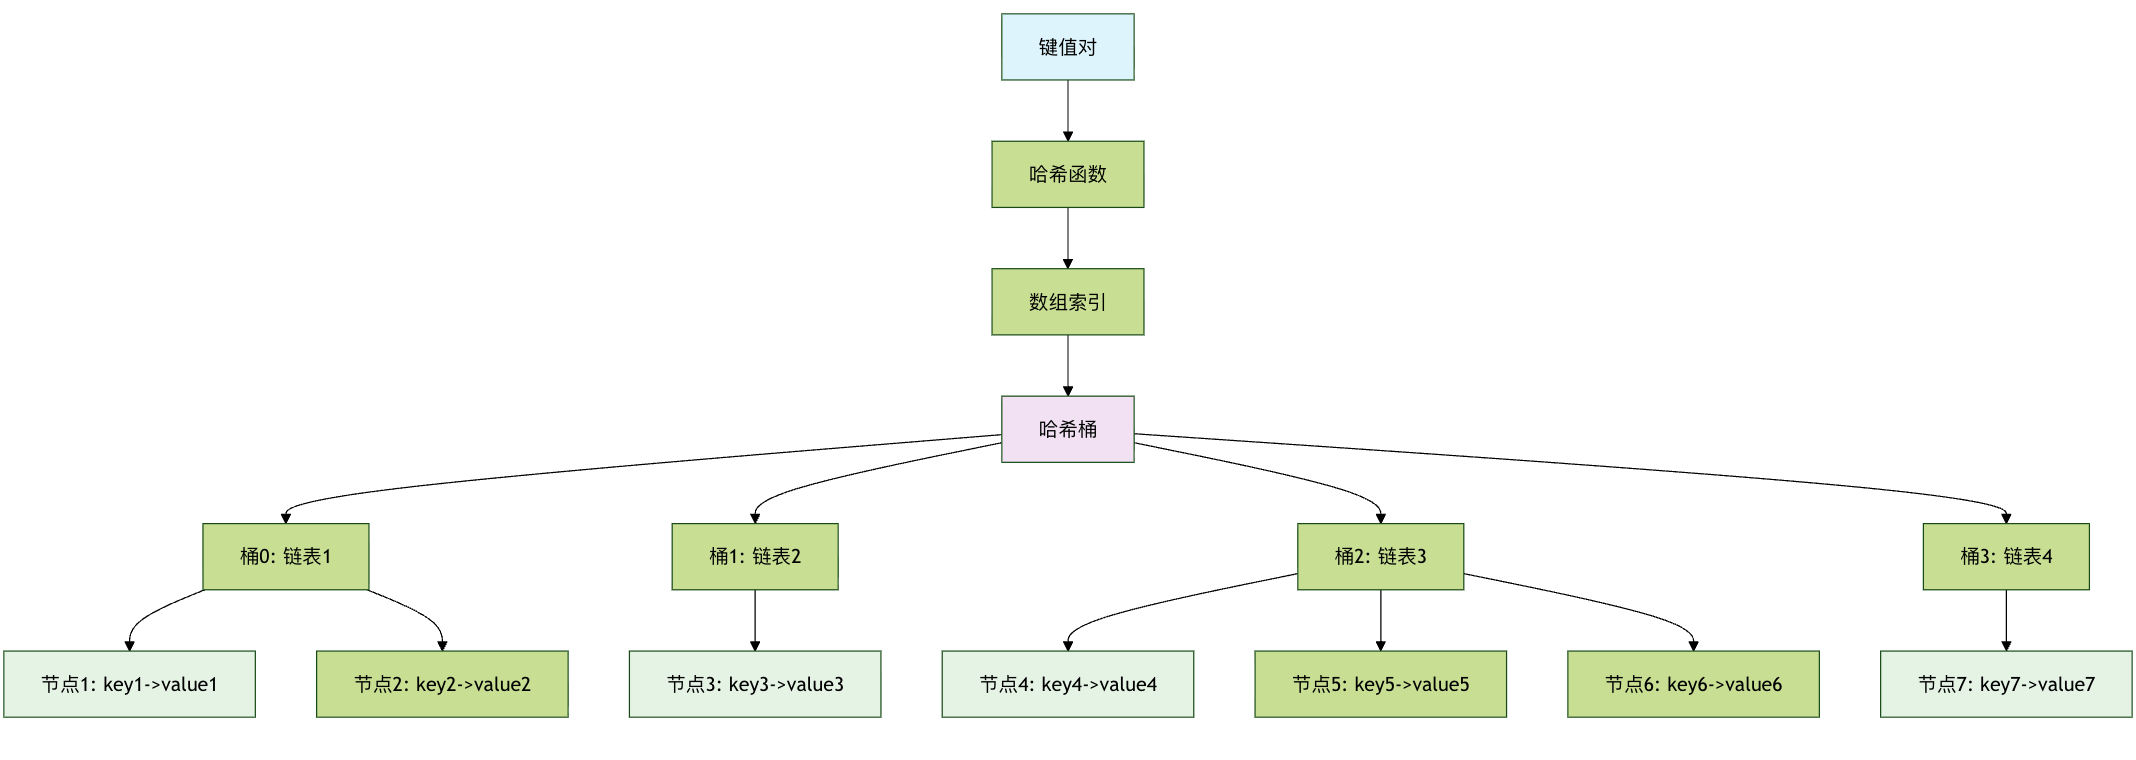
Diagrama de estructura de la tabla hash
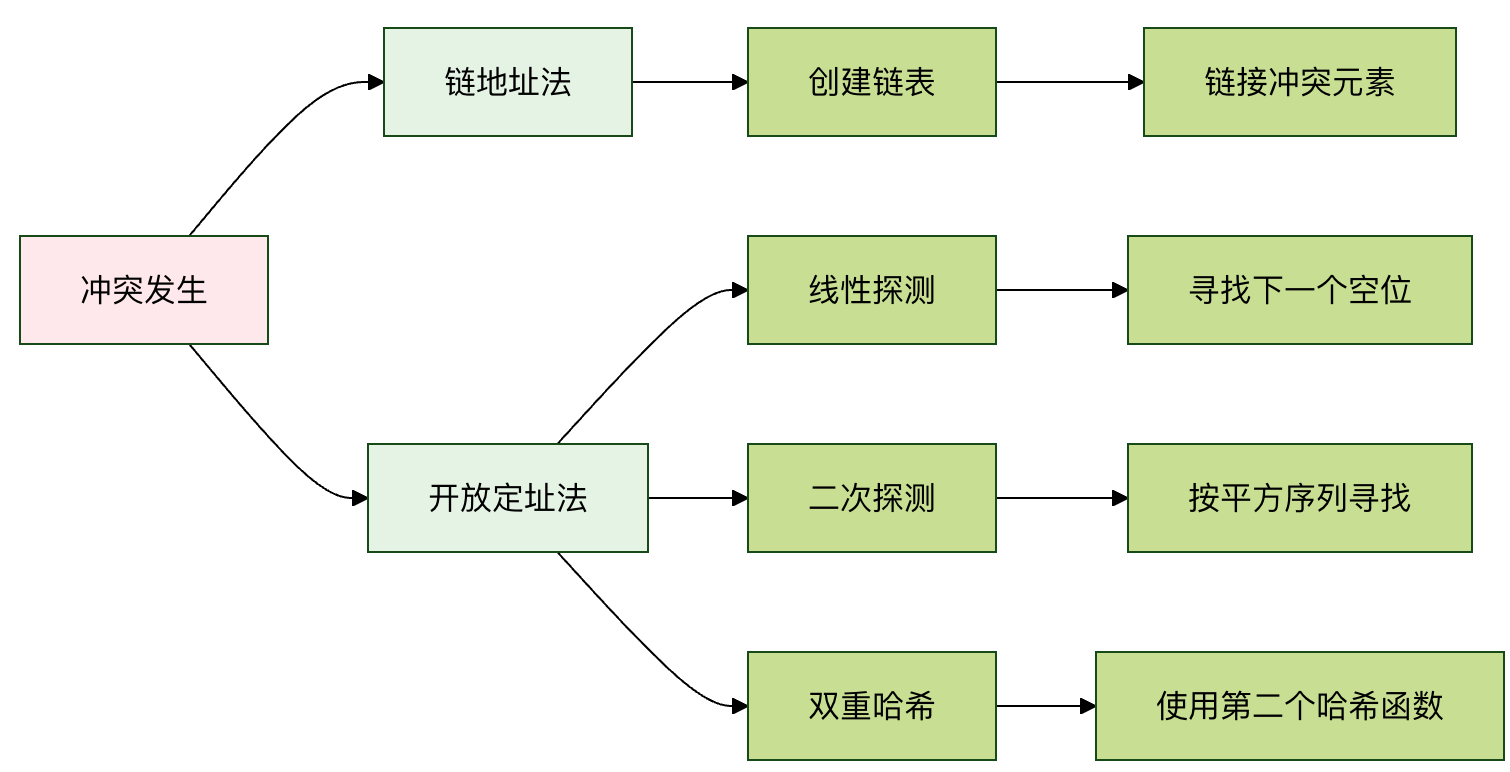
Comparación de métodos de resolución de colisiones
Comprensión profunda de la función hash
La función hash es la clave de la eficiencia de una tabla hash. Una buena función hash debe tener las siguientes características:
- Determinismo: la misma clave debe producir siempre el mismo valor hash.
- Eficiencia: la velocidad de cálculo debe ser rápida.
- Distribución uniforme: debe asignar las distintas claves de la manera más uniforme posible a todo el espacio del array, reduciendo las colisiones.
Un ejemplo sencillo de función hash
Supongamos que nuestras claves son cadenas y que la longitud del array es 10. Una función hash sencilla podría ser sumar los códigos ASCII de cada carácter de la cadena y luego tomar el residuo con respecto a la longitud del array.
Ejemplo
"""
Una función hash de cadenas simple.
:param key: La clave de entrada (cadena)
:param array_size: El tamaño del array de la tabla hash
:return: El índice de array calculado
"""
total = 0
for char in key:
# Convertir el carácter a su valor ASCII y acumular
total += ord(char)
# Aplicar módulo con el tamaño del array para asegurar que el índice esté en el rango
return total % array_size
# Probar nuestra función hash
keys_to_test = ["Alice", "Bob", "Charlie", "David"]
array_size = 10
print(Resultado de la prueba de la función hash simple:)
for key in keys_to_test:
hash_index = simple_hash(key, array_size)
print(fClave '{key}' -> Índice hash: {hash_index})
Salida:
简单哈希函数测试结果:
  键 'Alice' -> 哈希索引: 0
  键 'Bob' -> 哈希索引: 8
  键 'Charlie' -> 哈希索引: 5
  键 'David' -> 哈希索引: 3
Esta función es muy simple, pero quizás no sea la mejor, porque cadenas distintas pueden producir la misma suma (por ejemplo, 'ab' y 'ba'), lo que puede provocarcolisiones hash。
Colisiones hash y métodos de resolución
Colisión hashSe refiere a que dos o más claves diferentes, después de ser procesadas por la función hash, obtienen el mismo índice del array. Es como si a dos espectadores de un cine se les asignara el mismo número de asiento; claramente es un problema. Las colisiones son inevitables porque el rango de valores hash (el tamaño del array) suele ser finito, mientras que las claves posibles son infinitas.
Existen principalmente dos métodos clásicos para resolver colisiones:
Método 1: Encadenamiento separado (Separate Chaining)
Es el método más utilizado. No coloca los datos directamente en cada posición del array, sino que en cada posición almacena unalista enlazada(u otra estructura de datos, como un árbol rojo-negro). Cuando se produce una colisión, el nuevo par clave-valor se agrega a la lista enlazada de esa posición.
Descripción del proceso:
Calcula el valor hash de la clave y encuentra el índice del array.
Si la lista enlazada no está vacía (se produce una colisión), recorre esta lista.
- Si se encuentra la misma clave, actualiza su valor (o trátalo según sea necesario).
- Si no se encuentra la misma clave, agrega el nuevo par clave-valor al final de la lista enlazada.
Ejemplo
"""Implementación de una tabla hash que resuelve colisiones mediante el método de encadenamiento."""
def __init__(self, size=10):
"""Inicializa la tabla hash.
:param size: Tamaño inicial del array subyacente.
"""
self.size = size
# Crea una lista de tamaño `size`, donde cada elemento se inicializa como una lista vacía (que representa la lista enlazada).
self.table = [[] for _ in range(size)]
def _hash(self, key):
"""Función hash interna. Aquí se utiliza la función hash incorporada de Python y se aplica el módulo."""
return hash(key) % self.size
def insert(self, key, value):
"""Inserta un par clave-valor en la tabla hash."""
index = self._hash(key)
bucket = self.table[index] # Obtiene el "cubo" (lista enlazada) correspondiente a ese índice.
# Recorre el cubo para comprobar si la clave ya existe.
for i, (k, v) in enumerate(bucket):
if k == key:
# La clave ya existe, actualiza el valor.
bucket[i] = (key, value)
return
# La clave no existe, se agrega al final de la lista enlazada.
bucket.append((key, value))
def get(self, key):
"""Obtiene el valor según la clave. Si la clave no existe, devuelve None."""
index = self._hash(key)
bucket = self.table[index]
for k, v in bucket:
if k == key:
return v
return None # La clave no existe.
def delete(self, key):
"""Elimina el par clave-valor según la clave."""
index = self._hash(key)
bucket = self.table[index]
for i, (k, v) in enumerate(bucket):
if k == key:
del bucket[i] # Elimina ese nodo de la lista enlazada.
return True # Eliminación exitosa.
return False # La clave no existe, eliminación fallida.
def display(self):
"""Imprime todo el contenido de la tabla hash."""
for i, bucket in enumerate(self.table):
print(f"Índice {i}: {bucket}")
# Ejemplo de uso.
print("\n--- Ejemplo de tabla hash con encadenamiento ---")
phone_book = HashTableChaining(5)
phone_book.insert("Alice", "123-4567")
phone_book.insert("Bob", "987-6543")
phone_book.insert("Charlie", "555-1234")
# Supongamos que el valor hash de "David" entra en conflicto con el de "Alice" (para la demostración).
phone_book.insert("David", "111-2222")
print("Tabla hash después de insertar los datos:")
phone_book.display()
print(f"\nTeléfono de 'Bob': {phone_book.get('Bob')}")
print(f"Búsqueda de 'Eve' inexistente: {phone_book.get('Eve')}")
phone_book.delete("Charlie")
print("\nTabla hash después de eliminar a 'Charlie':")
phone_book.display()
Salida:
--- 链地址法哈希表示例 ---
插入数据后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: [('Charlie', '555-1234')]
索引 4: [('Bob', '987-6543')]

查找 'Bob' 的电话: 987-6543
查找不存在的 'Eve': None

删除 'Charlie' 后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: []
索引 4: [('Bob', '987-6543')]
Nota: Para demostrar claramente las colisiones, en el ejemplo se establece el tamaño del array en 5, y se utiliza
hash(key), las colisiones reales pueden no ser evidentes. Ensimple_hashbajo la función,"Alice"y"David"pueden producir el mismo índice, mostrando así cómo el método de encadenamiento almacena múltiples entradas en un mismo índice.
Método 2: Direccionamiento abierto (Open Addressing)
Este método almacena todos los elementos en el propio array. Cuando se produce una colisión, busca la siguiente posición libre en el array siguiendo una secuencia de sondeo (Probing Sequence).
Métodos de sondeo comunes:
- Sondeo lineal: Si la posición
iestá ocupada, pruebai+1,i+2,i+3... hasta encontrar un espacio libre. - Sondeo cuadrático: Si la posición
iestá ocupada, pruebai+1^2,i+2^2,i+3^2...。 - Doble hash: Utiliza una segunda función hash para calcular el tamaño del paso de sondeo.
Aquí implementamos un sondeo lineal simple:
Ejemplo
"""Implementación de una tabla hash que resuelve colisiones mediante direccionamiento abierto con sondeo lineal."""
def __init__(self, size=10):
self.size = size
# Usa un marcador especial `None` para indicar una posición vacía, y una marca (como `'DELETED'`) para indicar una posición eliminada.
# Para simplificar, aquí solo se usa `None` para las posiciones vacías; al buscar, se detiene al encontrar `None`.
self.keys = [None] * size
self.values = [None] * size
def _hash(self, key):
return hash(key) % self.size
def insert(self, key, value):
index = self._hash(key)
original_index = index
# Sondeo lineal para encontrar una posición vacía o la misma clave.
while self.keys[index] is not None:
if self.keys[index] == key:
# La clave ya existe, actualiza el valor.
self.values[index] = value
return
index = (index + 1) % self.size # Se mueve a la siguiente posición (array circular).
if index == original_index:
# Ya se ha recorrido todo el array, la tabla está llena (en una aplicación real se debería expandir).
raise Exception("Tabla hash llena")
# Se encontró una posición vacía, inserta.
self.keys[index] = key
self.values[index] = value
def get(self, key):
index = self._hash(key)
original_index = index
while self.keys[index] is not None:
if self.keys[index] == key:
return self.values[index]
index = (index + 1) % self.size
if index == original_index:
break # Se recorrió todo el array sin encontrarla.
return None
def display(self):
for i in range(self.size):
if self.keys[i] is not None:
print(f"Índice {i}: clave={self.keys[i]}, valor={self.values[i]}")
else:
print(f"Índice {i}: vacío")
# Ejemplo de uso.
print("\n--- Ejemplo de tabla hash con sondeo lineal ---")
ht_linear = HashTableLinearProbing(7) # Usa un tamaño pequeño para que el sondeo sea fácil de ver.
ht_linear.insert("Apple", 10)
ht_linear.insert("Banana", 20)
ht_linear.insert("Cherry", 30)
# Supongamos que "Date" y "Apple" tienen una colisión de hash.
ht_linear.insert("Date", 40)
print("Tabla hash después de insertar los datos:")
ht_linear.display()
print(f"\nBuscar 'Banana': {ht_linear.get('Banana')}")
print(f"Buscar 'Date' (insertado después de una colisión): {ht_linear.get('Date')}")
Salida:
--- 线性探测哈希表示例 ---
插入数据后的哈希表:
索引 0: 键=Apple, 值=10
索引 1: 键=Date, 值=40
索引 2: 键=Banana, 值=20
索引 3: 键=Cherry, 值=30
索引 4: 空
索引 5: 空
索引 6: 空

查找 'Banana': 20
查找 'Date' (冲突后插入的): 40
Nota: En el direccionamiento abierto, la eliminación es problemática; no se puede simplemente establecer la posición como
None, de lo contrario se rompería la secuencia de sondeo. Normalmente se utiliza un marcador especial de "eliminado". En este ejemplo, por simplicidad, no se implementa la eliminación.
Comparación de los dos métodos
| Característica | Encadenamiento | Direccionamiento abierto |
|---|---|---|
| Dificultad de implementación | Relativamente simple | Relativamente complejo, especialmente la eliminación |
| Coste de espacio | Requiere espacio adicional para almacenar punteros (lista enlazada) | Todos los datos están en el array, la utilización del espacio puede ser mayor |
| Impacto de las colisiones | Las colisiones solo afectan al rendimiento del mismo cubo (lista enlazada) | Las colisiones afectan a la posición de inserciones posteriores, lo que puede provocar el fenómeno de "agrupamiento". |
| Momento de expansión | Se expande cuando la longitud media de las listas enlazadas supera un umbral | Se expande cuando el factor de carga (número de elementos / tamaño del array) supera un umbral |
| Escenarios de aplicación | General, más común | Amigable con la caché, adecuado para escenarios con un volumen máximo de datos conocido o con memoria limitada |
Rendimiento de la tabla hash y factor de carga
La eficiencia de la tabla hash depende en gran medida de un indicador clave:factor de carga。
factor de carga = número de elementos almacenados en la tabla hash / tamaño total del array de la tabla hash
- Factor de carga bajo(por ejemplo, 0.5): significa que el array aún tiene muchos espacios vacíos, la probabilidad de colisión es baja y las operaciones son rápidas.
- Factor de carga alto(por ejemplo, 0.9): significa que el array está casi lleno, la probabilidad de colisión aumenta drásticamente, las listas enlazadas se alargan o la distancia de sondeo aumenta, y el rendimiento disminuye.
Para mantener un alto rendimiento, cuando el factor de carga supera un cierto umbral (por ejemplo, 0.75), la tabla hash realiza unaexpansiónoperación:
- Crear un array nuevo y más grande (generalmente el doble del tamaño original).
- Recorrer todos los pares clave-valor de la tabla hash anterior.
- Según el nuevo tamaño del array, recalcular el índice de cada clave con la función hash e insertarlo en el nuevo array.
Este proceso se denominaRehashing, aunque consume tiempo, puede reducir significativamente el factor de carga y hacer que la tabla hash recupere su eficiencia.
Ejercicio práctico: construir un contador de palabras
Usemos nuestra propia tabla hash con encadenamiento para resolver un problema real: contar cuántas veces aparece cada palabra en un texto.
Usaremos el siguiente texto como datos de prueba (puedes copiarlo en tu código):
the quick brown fox jumps over the lazy dog the dog is not lazy at all
Ejemplo
print("\n=== Ejercicio práctico: contador de palabras ===")
# 1. Crear una instancia de la tabla hash.
word_counter = HashTableChaining(size=10)
# 2. El texto de prueba proporcionado.
text = "the quick brown fox jumps over the lazy dog the dog is not lazy at all"
words = text.split() # Divide el texto en una lista de palabras.
print("Lista de palabras procesadas:", words)
# 3. Recorre las palabras e insértalas en la tabla hash.
for word in words:
current_count = word_counter.get(word)
if current_count is None:
# Si la palabra aparece por primera vez, el contador se establece en 1.
word_counter.insert(word, 1)
else:
# Si la palabra ya existe, se incrementa el contador en 1.
word_counter.insert(word, current_count + 1)
# 4. Muestra los resultados estadísticos.
print("\nEstadísticas de aparición de palabras:")
# Nota: nuestro método display imprime por índice; aquí escribimos una salida más amigable.
all_entries = []
for bucket in word_counter.table:
all_entries.extend(bucket) # Combina las entradas de todos los cubos.
for word, count in all_entries:
print(f" '{word}': {count} veces")
# 5. Verificar una palabra específica.
test_word = "the"
print(f"\nVerificación: la palabra '{test_word}' aparece {word_counter.get(test_word)} veces.")
test_word = "lazy"
print(f"Verificación: la palabra '{test_word}' aparece {word_counter.get(test_word)} veces.")
Resultado de salida:
=== 实践练习:单词计数器 ===
处理的单词列表: ['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog', 'the', 'dog', 'is', 'not', 'lazy', 'at', 'all']

单词出现次数统计:
  'the': 3 次
  'quick': 1 次
  'brown': 1 次
  'fox': 1 次
  'jumps': 1 次
  'over': 1 次
  'lazy': 2 次
  'dog': 2 次
  'is': 1 次
  'not': 1 次
  'at': 1 次
  'all': 1 次

验证:单词 'the' 出现了 3 次。
验证:单词 'lazy' 出现了 2 次。
¡Felicidades! Has completado con éxito una tarea práctica usando tu propia implementación de tabla hash. En la programación del mundo real, casi nunca necesitas implementar tu propia tabla hash, porque los lenguajes de programación modernos (como el de Pythondict, el de JavaHashMap, el de C++unordered_map) ofrecen implementaciones de tablas hash integradas altamente optimizadas y potentes.
Resumen y repaso de puntos clave
¿Qué es una tabla hash?: una estructura de datos eficiente que accede directamente a los valores mediante claves, con una complejidad temporal promedio deO(1)。
Mecanismo central: Función hashConvierte las claves en índices de array.
Desafío clave: Colisión hash— Diferentes claves se asignan al mismo índice.
Soluciones:
- Encadenamiento separado: Cada posición de índice almacena una lista enlazada para almacenar los pares clave-valor que colisionan.
- Direccionamiento abierto: Dentro del array, se busca la siguiente posición vacía siguiendo una secuencia de sondeo.
Clave para el rendimiento: Factor de carga. Cuando el factor de carga es demasiado alto, es necesarioampliar la capacidadyy rehashearpara restaurar el rendimiento.
Aplicaciones prácticas: Las tablas hash son la piedra angular de la programación y se utilizan ampliamente en innumerables escenarios, como índices de bases de datos, sistemas de caché, comprobación de pertenencia a conjuntos, almacenamiento de atributos de objetos, etc.
Otras extensiones