Table de hachage
Une table de hachage, aussi appelée carte de hachage, est une structure de données extrêmement efficace.
Les tables de hachage peuvent, dans le cas moyen, avec une complexité proche deO(1)La complexité temporelle pour l'insertion, la suppression et la recherche de données est bien meilleure que le parcours de tableau (O(n)) et la recherche dans un arbre binaire de recherche (O(log n)) est bien plus rapide.
| Opération | Tableau/Liste chaînée | Table de hachage |
|---|---|---|
| Rechercher | O(n) | O(1) |
| Insérer | O(n) | O(1) |
| Delete | O(n) | O(1) |
| Efficacité spatiale | Élevée | Moyenne |
Table de hachageTout comme un système de casiers intelligent :
- Casier traditionnel: Vous devez vous rappeler dans quel casier se trouve chaque objet (recherche linéaire)
- Casier intelligent: Vous indiquez le nom de l'objet à l'administrateur, et il vous donne directement le numéro du casier (recherche par hachage)
Idée principale :
Grâce à laFonction de hachage, laClésera convertie enIndice de tableau, permettant un accès rapide.
Cas concret :
- Recherche dans le dictionnaire: Localiser rapidement la page en fonction de la première lettre du mot
- Annuaire téléphonique: Trier par pinyin du nom de famille pour trouver rapidement des contacts
- Cote de bibliothèque: trouver directement l'emplacement de l'étagère en fonction du numéro de classification
Imaginez que vous avez une immense bibliothèque avec des milliers de livres.
Si vous voulez trouver un livre précis, comme Harry Potter, que feriez-vous ? La méthode la plus stupide consiste à commencer par le premier livre de la première étagère et à chercher un par un jusqu'à ce que vous le trouviez—cela pourrait prendre des heures, voire des jours !
Que ferait un bibliothécaire intelligent ? Il utiliserait unSystème d'indexation: En se basant sur une règle du titre du livre ou du nom de l'auteur (comme la première lettre), localiser rapidement la zone approximative où se trouve le livre, puis chercher uniquement dans cette petite zone. L'idée de ce système d'indexation estTable de hachagele cœur de.
Concepts de base
Qu'est-ce qu'une table de hachage ?
Une table de hachage est une structure de données qui accède directement aux valeurs par le biais de clés., elle utilise ce qu'on appelle uneFonction de hachagela formule magique qui convertit une clé de taille arbitraire (comme une chaîne, un nombre ou un objet) en un nombre de taille fixe, appelé valeur de hachage.Valeur de hachageouCode de hachageEnsuite, utilisez cette valeur de hachage comme l'Indicedu tableau, et stockez la valeur dans la position du tableau correspondant à cet indice.
Ce processus s'apparente à attribuer à chaque clé un numéro de siège unique (valeur de hachage), puis à lui dire : vos données sont placées dans le siège portant ce numéro. Lorsque vous voulez retrouver ces données, vous recalculez simplement le numéro de siège en utilisant la même règle, puis vous vous y rendez directement—pas besoin de vérifier siège par siège.
Composants principaux
Une table de hachage se compose principalement des trois parties essentielles suivantes :
- Clé: l'identifiant que vous utilisez pour stocker et rechercher des données. Par exemple, dans un annuaire téléphonique, le nom de la personne est la clé.
- Valeur: les données réelles associées à la clé. Dans un annuaire téléphonique, le numéro de téléphone est la valeur.
- Fonction de hachage (Hash Function): la fonction mathématique qui associe les clés aux indices d'un tableau. C'est le cœur de la table de hachage.
Schéma de fonctionnement
Prenons un exemple simple. Supposons que nous voulions créer un annuaire téléphonique qui associe des noms à des numéros de téléphone.
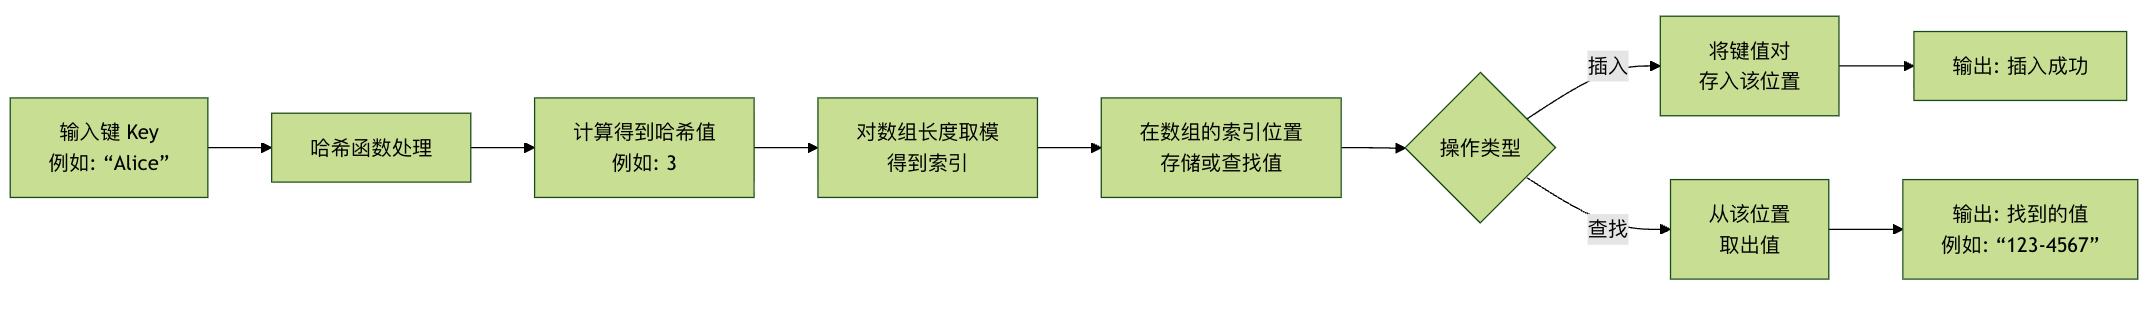
La figure ci-dessus montre clairement le fonctionnement d'une table de hachage : qu'il s'agisse d'insertion ou de recherche, on commence toujours par une clé, on calcule l'indice via la fonction de hachage, puis on opère directement sur cette position dans le tableau, ce qui permet un accès à grande vitesse.
Conception de la fonction de hachage
Caractéristiques d'une bonne fonction de hachage
| Fonctionnalités | Description | Importance |
|---|---|---|
| Déterminisme | La même entrée produit toujours la même sortie | ⭐⭐⭐⭐⭐ |
| Distribution uniforme | La sortie est uniformément répartie dans l'intervalle de la table de hachage | ⭐⭐⭐⭐⭐ |
| Calcul efficace | Le processus de calcul est simple et rapide | ⭐⭐⭐⭐ |
| Effet avalanche | Un infime changement dans l'entrée provoque un énorme changement dans la sortie | ⭐⭐⭐ |
Fonctions de hachage courantes
| Type | Exemple | Scénarios applicables |
|---|---|---|
| Méthode de division-reste | hash = key % table_size |
Clé entière |
| Méthode de multiplication | hash = floor(key * A % 1 * table_size) |
Clé à virgule flottante |
| Méthode d'analyse des chiffres | Analyser les motifs de distribution des nombres | Données avec des motifs spécifiques |
| Méthode du carré moyen | hash = (key * key) // 10^(n/2) % table_size |
Clé numérique |
| Hachage de chaînes de caractères | Traitement caractère par caractère | Clé de chaîne de caractères |
Méthodes de résolution des collisions
Chaînage séparé
| Fonctionnalités | Description | Complexité temporelle |
|---|---|---|
| Principe | Chaque compartiment de hachage maintient une liste chaînée | |
| Insérer | Ajouter en tête de la liste chaînée correspondante | O(1) |
| Rechercher | Rechercher dans la liste chaînée correspondante | O(k), où k est la longueur de la liste chaînée |
| Delete | Supprimer de la liste chaînée correspondante | O(k) |
| Surcoût d'espace | Nécessite un stockage supplémentaire pour les pointeurs | Relativement important |
Méthode d’adressage ouvert (Open Addressing)
| Type | Séquence de sondage | Avantages | Inconvénients |
|---|---|---|---|
| Sondage linéaire | h, h+1, h+2, ... |
Simple et facile à mettre en œuvre | Propice au regroupement |
| Sondage quadratique | h, h+1², h+2², ... |
Réduire le regroupement | Peut ne pas pouvoir sonder toutes les positions |
| Double hachage | h, h+hash2(key), h+2*hash2(key), ... |
Distribution uniforme | Complexe sur le plan calculatoire |
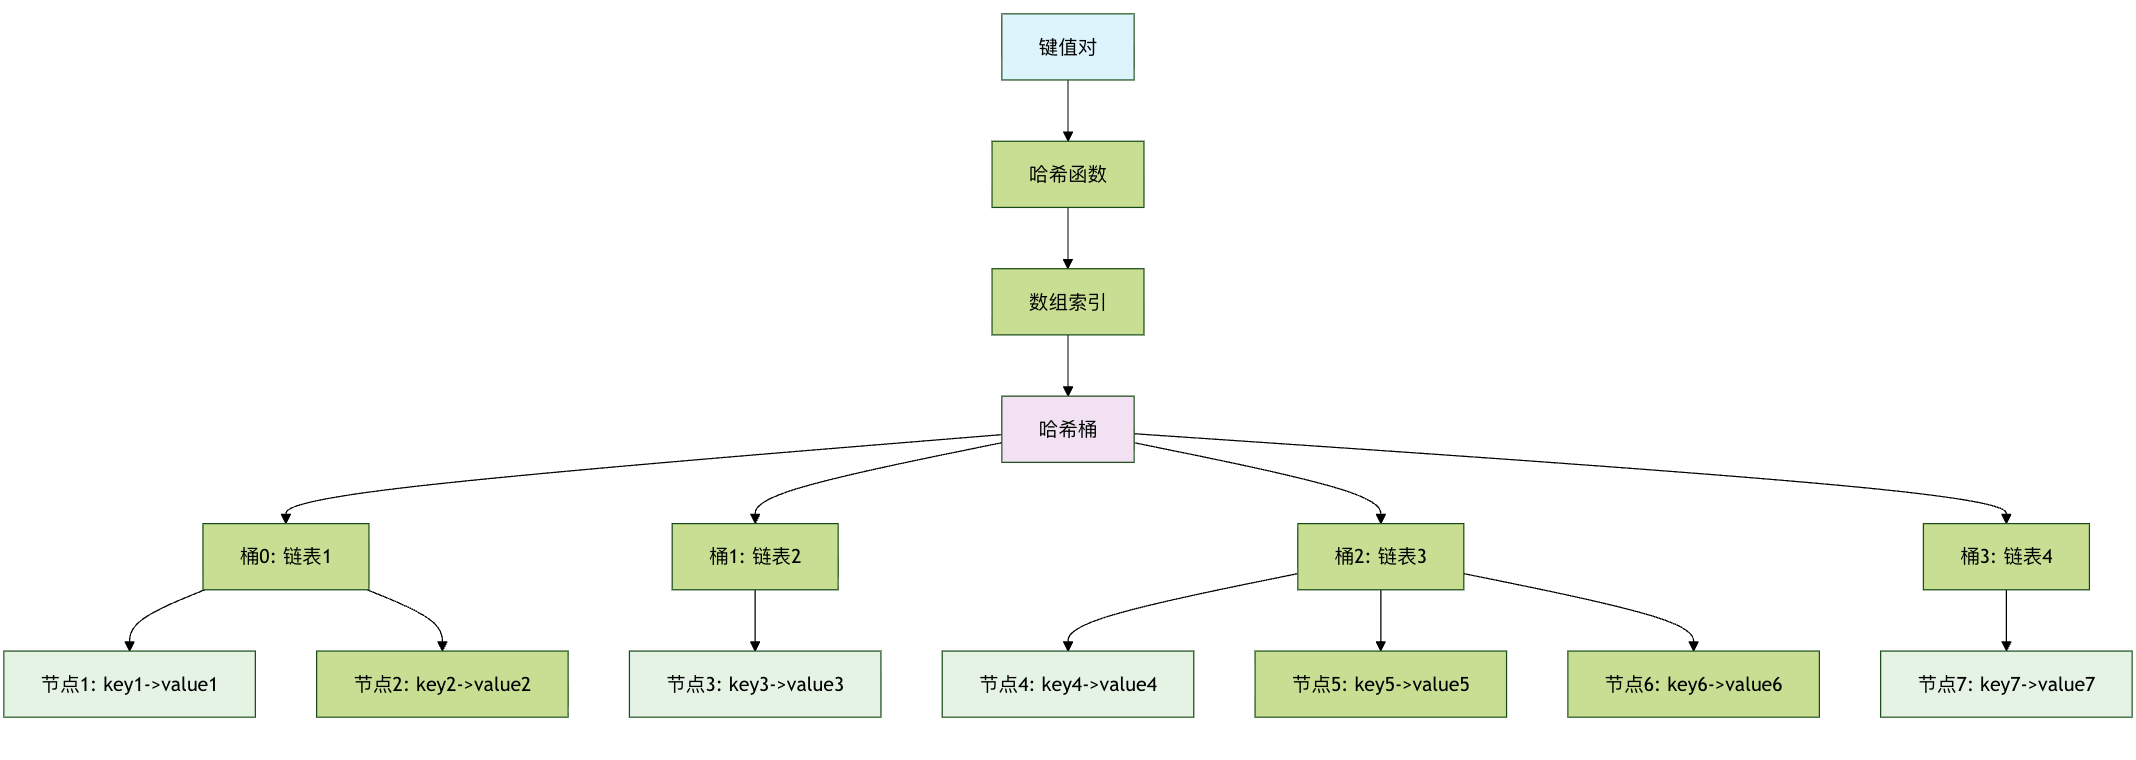
Schéma de structure de table de hachage
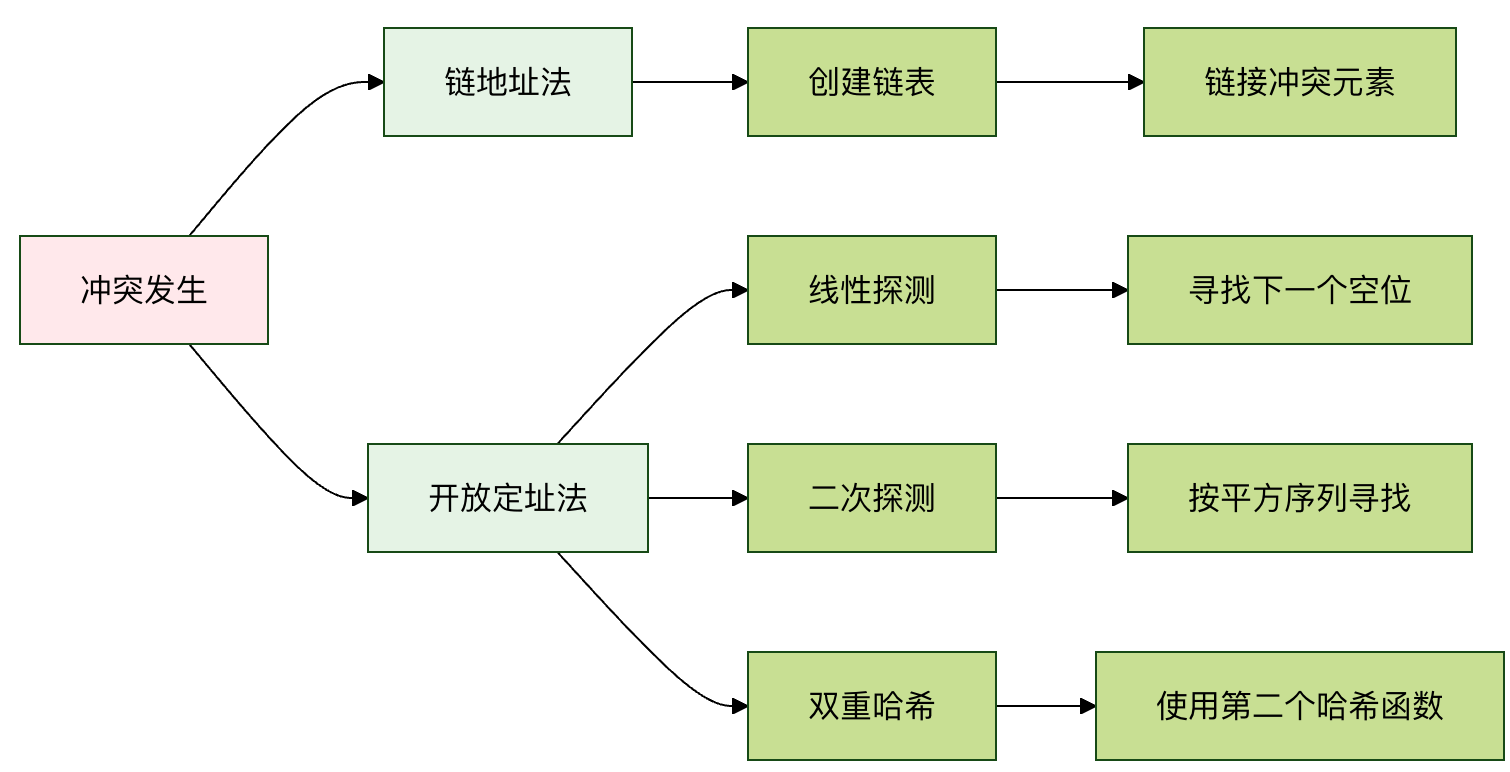
Comparaison des méthodes de résolution des collisions
Compréhension approfondie des fonctions de hachage
La fonction de hachage est la clé de l'efficacité d'une table de hachage. Une bonne fonction de hachage doit avoir les caractéristiques suivantes :
- Déterminisme: La même clé doit toujours produire la même valeur de hachage.
- Efficacité: La vitesse de calcul doit être rapide.
- Distribution uniforme: Elle peut répartir différentes clés aussi uniformément que possible sur tout l'espace du tableau, ce qui réduit les collisions.
Un exemple de fonction de hachage simple
Supposons que nos clés soient des chaînes de caractères et que la longueur du tableau soit 10. Une fonction de hachage simple pourrait consister à additionner les codes ASCII de chaque caractère de la chaîne, puis à prendre le reste modulo la longueur du tableau.
Exemple
"""
Une fonction de hachage simple pour chaîne de caractères.
:param key: La clé d'entrée (chaîne)
:param array_size: La taille du tableau de la table de hachage
:return: L'indice de tableau calculé
"""
total = 0
for char in key:
# Convertir le caractère en sa valeur de code ASCII et accumuler
total += ord(char)
# Prendre le modulo de la taille du tableau pour garantir que l'indice est dans les limites du tableau
return total % array_size
# Tester notre fonction de hachage
keys_to_test = ["Alice", "Bob", "Charlie", "David"]
array_size = 10
print("Résultats du test de la fonction de hachage simple :")
for key in keys_to_test:
hash_index = simple_hash(key, array_size)
print(fClé '{key}' -> indice de hachage : {hash_index})
Résultat de sortie :
简单哈希函数测试结果:
  键 'Alice' -> 哈希索引: 0
  键 'Bob' -> 哈希索引: 8
  键 'Charlie' -> 哈希索引: 5
  键 'David' -> 哈希索引: 3
Cette fonction est simple, mais elle peut ne pas être la meilleure, car différentes chaînes peuvent produire la même somme (par ex., ab et ba), ce qui conduit àCollision de hachage。
Conflits de hachage et méthodes de résolution
Collision de hachagecollisions. Une collision désigne deux clés différentes ou plus produisant le même indice de tableau après avoir été traitées par la fonction de hachage. C'est comme deux spectateurs à qui on attribue le même numéro de siège, ce qui est clairement un problème. Les collisions sont inévitables car la plage des valeurs de hachage (taille du tableau) est généralement finie, tandis que les clés possibles sont infinies.
Il existe deux méthodes classiques principales pour résoudre les conflits :
Méthode 1 : méthode de chaînage
C'est la méthode la plus courante. Elle ne place pas les données directement à chaque position du tableau ; à la place, elle stocke uneListe chaînéeliste chaînée (ou une autre structure de données, comme un arbre rouge-noir) à chaque position du tableau. Lorsqu'une collision se produit, la nouvelle paire clé-valeur est ajoutée à la liste chaînée à cette position.
Description du processus :
Calculer la valeur de hachage de la clé et trouver l'indice du tableau.
Si la liste chaînée n'est pas vide (une collision se produit), parcourir la liste chaînée.
- Si la même clé est trouvée, mettre à jour sa valeur (ou la traiter comme nécessaire).
- Si la même clé n'est pas trouvée, ajouter la nouvelle paire clé-valeur à la fin de la liste chaînée.
Exemple
"""Une implémentation de table de hachage utilisant le chaînage pour résoudre les collisions."""
def __init__(self, size=10):
"""Initialiser la table de hachage.
:param size: taille initiale du tableau sous-jacent
"""
self.size = size
# Créer une liste de taille `size`, avec chaque élément initialisé à une liste vide (représentant une liste chaînée)
self.table = [[] for _ in range(size)]
def _hash(self, key):
"""Fonction de hachage interne. Ici, nous utilisons la fonction de hachage intégrée de Python et appliquons le modulo."""
return hash(key) % self.size
def insert(self, key, value):
"""Insérer une paire clé-valeur dans la table de hachage."""
index = self._hash(key)
bucket = self.table[index] # Récupérer le 'bucket' (liste chaînée) correspondant à cet index
# Parcourir le bucket et vérifier si la clé existe déjà
for i, (k, v) in enumerate(bucket):
if k == key:
# La clé existe déjà, mettre à jour la valeur
bucket[i] = (key, value)
return
# La clé n'existe pas, l'ajouter à la fin de la liste chaînée
bucket.append((key, value))
def get(self, key):
"""Obtenir la valeur par clé. Si la clé n'existe pas, renvoyer None."""
index = self._hash(key)
bucket = self.table[index]
for k, v in bucket:
if k == key:
return v
return None # La clé n'existe pas
def delete(self, key):
"""Supprimer la paire clé-valeur par clé."""
index = self._hash(key)
bucket = self.table[index]
for i, (k, v) in enumerate(bucket):
if k == key:
del bucket[i] # Supprimer ce nœud de la liste chaînée
return True # Suppression réussie
return False # La clé n'existe pas, échec de la suppression
def display(self):
"""Affiche tout le contenu de la table de hachage."""
for i, bucket in enumerate(self.table):
print(fIndice {i}: {bucket})
# Exemple d'utilisation
print("\n--- Exemple de table de hachage avec chaînage ---)
phone_book = HashTableChaining(5)
phone_book.insert("Alice", "123-4567")
phone_book.insert("Bob", "987-6543")
phone_book.insert("Charlie", "555-1234")
# Supposons que la valeur de hachage de "David" entre en collision avec "Alice" (pour la démonstration)
phone_book.insert("David", "111-2222")
print("Table de hachage après insertion des données :")
phone_book.display()
print(f"\nRechercher le téléphone de 'Bob' : {phone_book.get('Bob')}")
print(f"Rechercher 'Eve' inexistante : {phone_book.get('Eve')}")
phone_book.delete("Charlie")
print("\nTable de hachage après suppression de 'Charlie' :")
phone_book.display()
Résultat de sortie :
--- 链地址法哈希表示例 ---
插入数据后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: [('Charlie', '555-1234')]
索引 4: [('Bob', '987-6543')]

查找 'Bob' 的电话: 987-6543
查找不存在的 'Eve': None

删除 'Charlie' 后的哈希表:
索引 0: [('David', '111-2222')]
索引 1: []
索引 2: [('Alice', '123-4567')]
索引 3: []
索引 4: [('Bob', '987-6543')]
Remarque: Pour démontrer clairement les collisions, la taille du tableau est fixée à 5 dans l'exemple, et nous utilisons
hash(key), les conflits réels peuvent ne pas être évidents. Danssimple_hashSous la fonction,"Alice"et"David"des clés qui peuvent produire le même indice, montrant ainsi comment la méthode de chaînage stocke plusieurs entrées sous un même indice.
Méthode 2 : méthode d'adressage ouvert
Cette méthode stocke tous les éléments directement dans le tableau lui-même. Lorsqu'une collision se produit, elle recherche la prochaine position libre dans le tableau selon une séquence de sondage.
Méthodes de sondage courantes :
- Sondage linéaire: Si la position
iest occupée, alors essayezi+1,i+2,i+3... jusqu'à ce qu'un emplacement vide soit trouvé. - Sondage quadratique: Si la position
iest occupée, alors essayezi+1^2,i+2^2,i+3^2...。 - Double hachage: Utilisez une seconde fonction de hachage pour calculer la taille du pas de sondage.
Nous implémentons ici un sondage linéaire simple :
Exemple
"""Implémentation de table de hachage utilisant le sondage linéaire (adressage ouvert) pour résoudre les collisions."""
def __init__(self, size=10):
self.size = size
# Utilisez un marqueur spécial `None` pour représenter les emplacements vides, et un marqueur (comme `'DELETED'`) pour représenter les positions supprimées.
# Par souci de simplicité, seul `None` est utilisé pour les emplacements vides ; la recherche s'arrête lorsqu'elle rencontre `None`.
self.keys = [None] * size
self.values = [None] * size
def _hash(self, key):
return hash(key) % self.size
def insert(self, key, value):
index = self._hash(key)
original_index = index
# Utiliser le sondage linéaire pour trouver un emplacement vide ou la même clé
while self.keys[index] is not Aucune:
if self.keys[index] == key:
# La clé existe déjà, mettre à jour la valeur
self.values[index] = value
return
index = (index + 1) % self.size # Passer à la position suivante (tableau circulaire)
if index == original_index:
# A fait un tour complet ; la table est pleine (en pratique, il faudrait redimensionner)
raise Exception("La table de hachage est pleine")
# Emplacement vide trouvé, insérer
self.keys[index] = key
self.values[index] = value
def get(self, key):
index = self._hash(key)
original_index = index
while self.keys[index] is not Aucune:
if self.keys[index] == key:
return self.values[index]
index = (index + 1) % self.size
if index == original_index:
break # A fait un tour complet sans le trouver
return None
def display(self):
for i in range(self.size):
if self.keys[i] is not Aucune:
print(f"Indice {i}: clé={self.keys[i]}, valeur={self.values[i]}")
else:
print(fIndice {i}: vide)
# Exemple d'utilisation
print("\n--- Exemple de table de hachage à sondage linéaire ---)
ht_linear = HashTableLinearProbing(7) # Une petite taille rend le sondage facile à voir
ht_linear.insert("Apple", 10)
ht_linear.insert("Banana", 20)
ht_linear.insert("Cherry", 30)
# Supposons que 'Date' et 'Apple' entrent en collision
ht_linear.insert("Date", 40)
print("Table de hachage après insertion des données :")
ht_linear.display()
print(f"\nRecherche 'Banana' : {ht_linear.get('Banana')})
print(fRecherche 'Date' (inséré après collision) : {ht_linear.get('Date')})
Résultat de sortie :
--- 线性探测哈希表示例 ---
插入数据后的哈希表:
索引 0: 键=Apple, 值=10
索引 1: 键=Date, 值=40
索引 2: 键=Banana, 值=20
索引 3: 键=Cherry, 值=30
索引 4: 空
索引 5: 空
索引 6: 空

查找 'Banana': 20
查找 'Date' (冲突后插入的): 40
Remarque: Dans l'adressage ouvert, la suppression est délicate : vous ne pouvez pas simplement définir la position à
Nonevide (null) ; sinon, cela romprait la séquence de sondage. Habituellement, un marqueur spécial "supprimé" est utilisé. Par souci de simplicité, cet exemple n'implémente pas la suppression.
Comparaison des deux méthodes
| Fonctionnalités | Chaînage séparé | Adressage ouvert |
|---|---|---|
| Difficulté d'implémentation | Relativement simple | Relativement complexe, en particulier les opérations de suppression |
| Surcoût d'espace | Nécessite de l'espace supplémentaire pour stocker les pointeurs (liste chaînée) | Toutes les données sont dans le tableau, donc l'utilisation de l'espace peut être plus élevée |
| Impact des collisions | Les collisions n'affectent que les performances du même compartiment (liste chaînée) | Les collisions affectent les positions des insertions suivantes et peuvent conduire à un « clustering » |
| Moment du redimensionnement | Agrandir lorsque la longueur moyenne des listes chaînées dépasse le seuil | Agrandir lorsque le facteur de charge (nombre d'éléments / taille du tableau) dépasse un seuil |
| Scénarios applicables | Général, plus courant | Adapté au cache, convenant aux scénarios avec une taille maximale de données connue ou une mémoire restreinte |
Performance des tables de hachage et facteur de charge
L'efficacité d'une table de hachage dépend fortement d'une métrique clé :Facteur de charge。
Facteur de charge = nombre d'éléments stockés dans la table de hachage / taille totale du tableau de la table de hachage
- Faible facteur de charge(par ex., 0.5) : Cela signifie que le tableau a encore de nombreux emplacements vides, la probabilité de collision est faible et les opérations sont rapides.
- Facteur de charge élevé(par ex., 0.9) : cela signifie que le tableau est presque plein, la probabilité de collision augmente fortement, les listes chaînées s'allongent ou les distances de sondage augmentent, et les performances se dégradent.
Pour maintenir des performances élevées, lorsque le facteur de charge dépasse un certain seuil (par ex., 0.75), la table de hachage s'agrandit :RedimensionnementOpérations :
- Créer un nouveau tableau plus grand (généralement deux fois la taille d'origine).
- Parcourir toutes les paires clé-valeur dans l'ancienne table de hachage.
- En fonction de la taille du nouveau tableau, utiliser la fonction de hachage pour recalculer l'index de chaque clé, puis l'insérer dans le nouveau tableau.
Ce processus est appeléRehachageBien que cela prenne du temps, cela peut réduire considérablement le facteur de charge et rétablir la table de hachage à une haute efficacité.
Exercice pratique : construire un compteur de mots
Utilisons une table de hachage à chaînage que nous avons construite nous-mêmes pour résoudre un problème pratique : compter le nombre d'occurrences de chaque mot dans un texte.
Nous utiliserons le texte suivant comme données de test (vous pouvez le copier dans votre code) :
the quick brown fox jumps over the lazy dog the dog is not lazy at all
Exemple
print("\n=== Exercice pratique : Compteur de mots ===)
# 1. Créer une instance de table de hachage
word_counter = HashTableChaining(size=10)
# 2. Texte de test fourni
text = "le vif renard brun saute par-dessus le chien paresseux le chien n'est pas paresseux du tout"
words = text.split() # Découper le texte en une liste de mots
print(Liste des mots traités :, words)
# 3. Parcourir les mots, insérer dans la table de hachage
for word in words:
current_count = word_counter.get(word)
if current_count is None:
# Première occurrence d'un mot, le compteur vaut 1
word_counter.insert(word, 1)
else:
# Le mot existe déjà, incrémenter le compteur de 1
word_counter.insert(word, current_count + 1)
# 4. Afficher les résultats statistiques
print("\nStatistiques d'occurrence des mots :)
# Remarque : notre méthode d'affichage imprime par index ; ici, nous écrivons une sortie plus conviviale
all_entries = []
for bucket in word_counter.table:
all_entries.extend(bucket) # Fusionner les entrées dans tous les compartiments
for word, count in all_entries:
print(f'{word}': {count} fois)
# 5. Vérifier un mot spécifique
test_word = "the"
print(f"\nVérifier : Le mot '{test_word}' est apparu {word_counter.get(test_word)} fois.)
test_word = "lazy"
print(fVérifier : Le mot '{test_word}' est apparu {word_counter.get(test_word)} fois.)
Résultat de sortie :
=== 实践练习:单词计数器 ===
处理的单词列表: ['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog', 'the', 'dog', 'is', 'not', 'lazy', 'at', 'all']

单词出现次数统计:
  'the': 3 次
  'quick': 1 次
  'brown': 1 次
  'fox': 1 次
  'jumps': 1 次
  'over': 1 次
  'lazy': 2 次
  'dog': 2 次
  'is': 1 次
  'not': 1 次
  'at': 1 次
  'all': 1 次

验证:单词 'the' 出现了 3 次。
验证:单词 'lazy' 出现了 2 次。
Félicitations ! Vous avez utilisé avec succès votre propre implémentation de table de hachage pour accomplir une tâche pratique. Dans la programmation réelle, vous avez rarement besoin d'implémenter vous-même une table de hachage, car les langages de programmation modernes (comme celui de PythondictCelui de JavaHashMapC++'sunordered_map) offrent tous des implémentations de tables de hachage intégrées hautement optimisées et puissantes. Comprendre leurs principes peut vous aider à les utiliser plus judicieusement et efficacement.
Résumé et révision des points clés
Qu'est-ce qu'une table de hachage: une structure de données efficace qui accède directement aux valeurs via des clés, avec une complexité temporelle moyenne deO(1)。
Mécanisme central: Fonction de hachageConvertit la clé en un index de tableau.
Défis principaux: Collision de hachage—des clés différentes correspondent au même index.
Solution:
- Chaînage séparé: chaque position d'index stocke une liste chaînée pour contenir les paires clé-valeur en collision.
- Adressage ouvert: trouver le prochain emplacement vide dans le tableau selon la séquence de sondage.
Critique pour les performances: Facteur de charge. Lorsque le facteur de charge est trop élevé, il fautRedimensionneretRehacherpour restaurer les performances.
Applications pratiques: les tables de hachage sont une pierre angulaire de la programmation, largement utilisées dans d'innombrables scénarios tels que l'indexation de bases de données, les systèmes de cache, les vérifications d'appartenance à un ensemble, le stockage de propriétés d'objets, et bien d'autres.
autres extensions