Оптимизация размера Union-Find
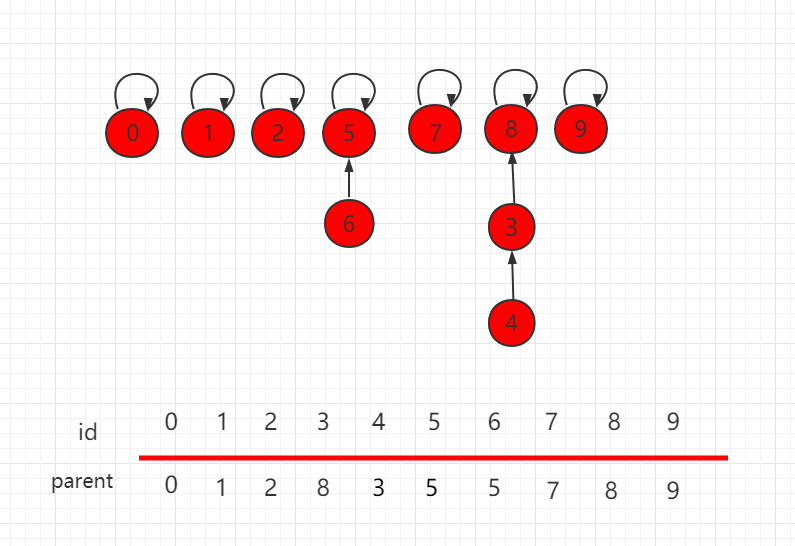
Следуя подходу из предыдущего подраздела, возьмём систему непересекающихся множеств, показанную на рисунке ниже, и выполнимunion(4,9)операцию.
Структура после операции объединения:
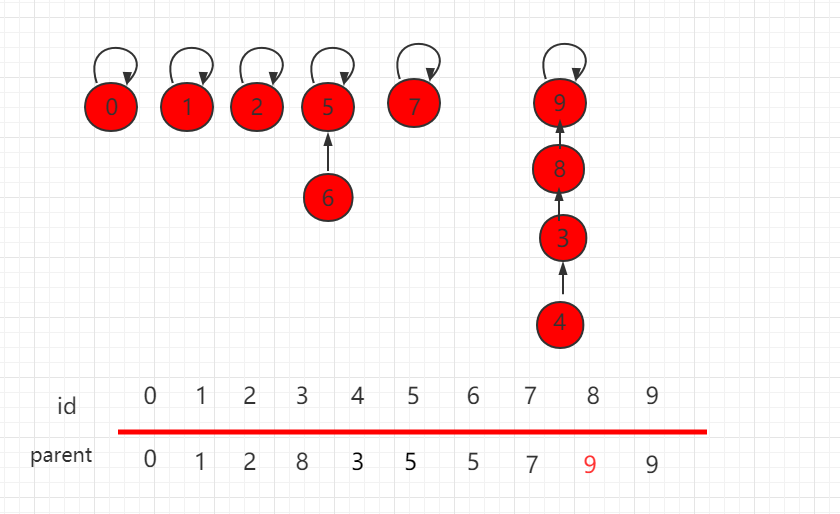
Видно, что высота дерева этой структуры довольно велика. Если в этот момент количество элементов увеличится, возникающие затраты будут довольно большими. Решить эту проблему на самом деле очень просто: перед выполнением конкретной операции указания сначала оцените и направьте корень множества с меньшим числом элементов на корень множества с большим числом элементов — это с большей вероятностью позволит построить дерево меньшей высоты.
При построении системы непересекающихся множеств нужен ещё один параметр,szмассив,sz[i]указывает, чтоiколичество элементов во множестве с корнем в...
public UnionFind3(int count){
parent = new int[count];
sz = new int[count];
this.count = count;
// инициализация: каждый parent[i] указывает на самого себя, что означает, что каждый элемент образует отдельное множество
for( int i = 0 ; i < count ; i ++ ){
parent[i] = i;
sz[i] = 1;
}
}
Во время операции объединения направление объединения определяется на основе количества элементов в деревьях, в которых находятся эти два элемента.
int pRoot = find(p);
int qRoot = find(q);
if( pRoot == qRoot )
return;
if( sz[pRoot] < sz[qRoot] ){
parent[pRoot] = qRoot;
sz[qRoot] += sz[pRoot];
}
else{
parent[qRoot] = pRoot;
sz[pRoot] += sz[qRoot];
}
}
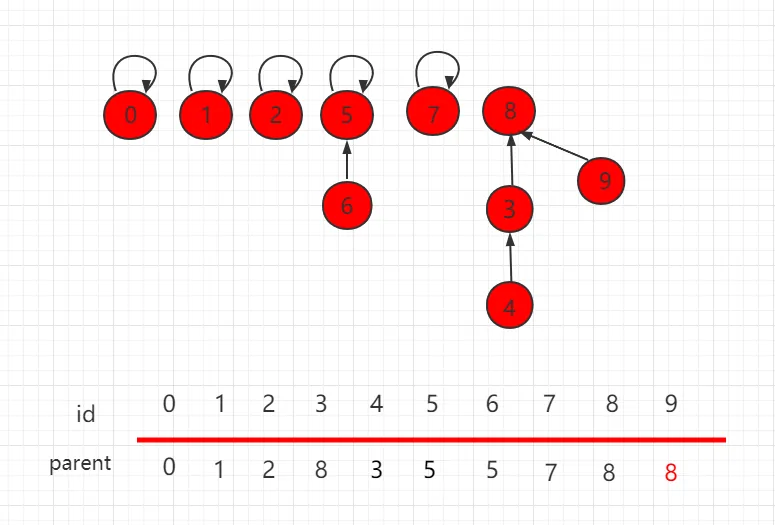
После оптимизации результат объединения следующий: 9 указывает на родительский узел 8.
Пример кода на Java
Загрузка пакета исходного кода:Скачать
Код файла UnionFind3.java:
/**
* Оптимизация размера системы непересекающихся множеств
*/
public class UnionFind3 {
// parent[i] представляет родительский узел i-го элемента
private int[] parent;
// sz[i] представляет количество элементов в множестве с корнем в i
private int[] sz;
// количество элементов данных
private int count;
// конструктор
public UnionFind3(int count){
parent = new int[count];
sz = new int[count];
this.count = count;
// инициализация: каждый parent[i] указывает на самого себя, что означает, что каждый элемент образует отдельное множество
for( int i = 0 ; i < count ; i ++ ){
parent[i] = i;
sz[i] = 1;
}
}
// процесс find, найти номер множества, соответствующего элементу p
// сложность O(h), h — высота дерева
private int find(int p){
assert( p >= 0 && p < count );
// продолжаем обращаться к родительскому узлу, пока не достигнем корневого узла
// признак корневого узла: parent[p] == p
while( p != parent[p] )
p = parent[p];
return p;
}
// проверить, принадлежат ли элемент p и элемент q одному и тому же множеству
// сложность O(h), h — высота дерева
public boolean isConnected( int p , int q ){
return find(p) == find(q);
}
// объединить множества, содержащие элемент p и элемент q
// сложность O(h), h — высота дерева
public void unionElements(int p, int q){
int pRoot = find(p);
int qRoot = find(q);
if( pRoot == qRoot )
return;
// Определить направление объединения на основе количества элементов в деревьях, в которых находятся два элемента
// Объединять множество с меньшим числом элементов во множество с большим числом элементов
if( sz[pRoot] < sz[qRoot] ){
parent[pRoot] = qRoot;
sz[qRoot] += sz[pRoot];
}
else{
parent[qRoot] = pRoot;
sz[pRoot] += sz[qRoot];
}
}
}