Введение в структуры данных и алгоритмы
В информатике структуры данных и алгоритмы — это основополагающая база для создания эффективного и надёжного программного обеспечения. Они представляют собой инструментарий программиста для решения сложных задач, определяющий скорость работы программы и потребление ресурсов.
Представьте, что вы приводите в порядок захламлённый книжный шкаф. Если просто случайно сложить книги, найти нужную книгу будет очень трудно. Но если отсортировать их по первой букве названия или распределить по категориям (например, художественная литература, история, наука), эффективность поиска значительно повысится.Структуры данныхПодобно методу организации книжного шкафа, они определяют, как данные должны быть организованы и храниться. ААлгоритмы— это конкретные шаги для поиска, вставки или удаления книги.
Структуры данных и алгоритмы — это основополагающие компетенции информатики, применяемые для решения двух вещей: как следует организовывать данные и как эффективно решать задачи.
Структуры данных
Изучение того, как данные организованы в памяти или хранилище, и как эффективно получать к ним доступ и изменять их. Основная цель — сократить затраты времени и пространства.
Распространённые типы:
- Линейные структуры: массивы, связанные списки, стеки, очереди
- Нелинейные структуры: деревья, графы, кучи, хеш-таблицы
Алгоритмы
Изучение шагов и стратегий решения задач; суть — абстракция вычислительного процесса. Есть только два критерия оценки: временная сложность и пространственная сложность.
Распространённые классификации:
- Базовые алгоритмы: обход, рекурсия, разделяй и властвуй
- Сортировка и поиск: быстрая сортировка, сортировка слиянием, бинарный поиск
- Продвинутые стратегии: жадные алгоритмы, динамическое программирование, перебор с возвратом
Связь
Структуры данных определяют, как хранятся данные, а алгоритмы определяют, как они вычисляются. Для одной и той же задачи различные структуры могут сделать сложность алгоритма кардинально разной.
Структуры данных
Структура данных — это способ хранения и организации данных компьютером.
Структура данных предназначена для реализации совокупности элементов данных с одной или несколькими определёнными связями, а также для определения набора операций над этими данными.
Основные концепции
- Данные: совокупность символов, которые компьютер может распознавать, хранить и обрабатывать, например числа, символы и т. д.
- Элемент данных: базовая единица данных, обычно рассматриваемая и обрабатываемая в программе как единое целое.
- Единица данных: наименьшая неделимая единица, составляющая элемент данных и имеющая самостоятельное значение.
- Структуры данных: совокупность элементов данных, которые имеют одну или несколько определённых связей друг с другом.
Классификация структур данных
Структуры данных в основном делятся на две большие категории:логическая структураифизическая структура。
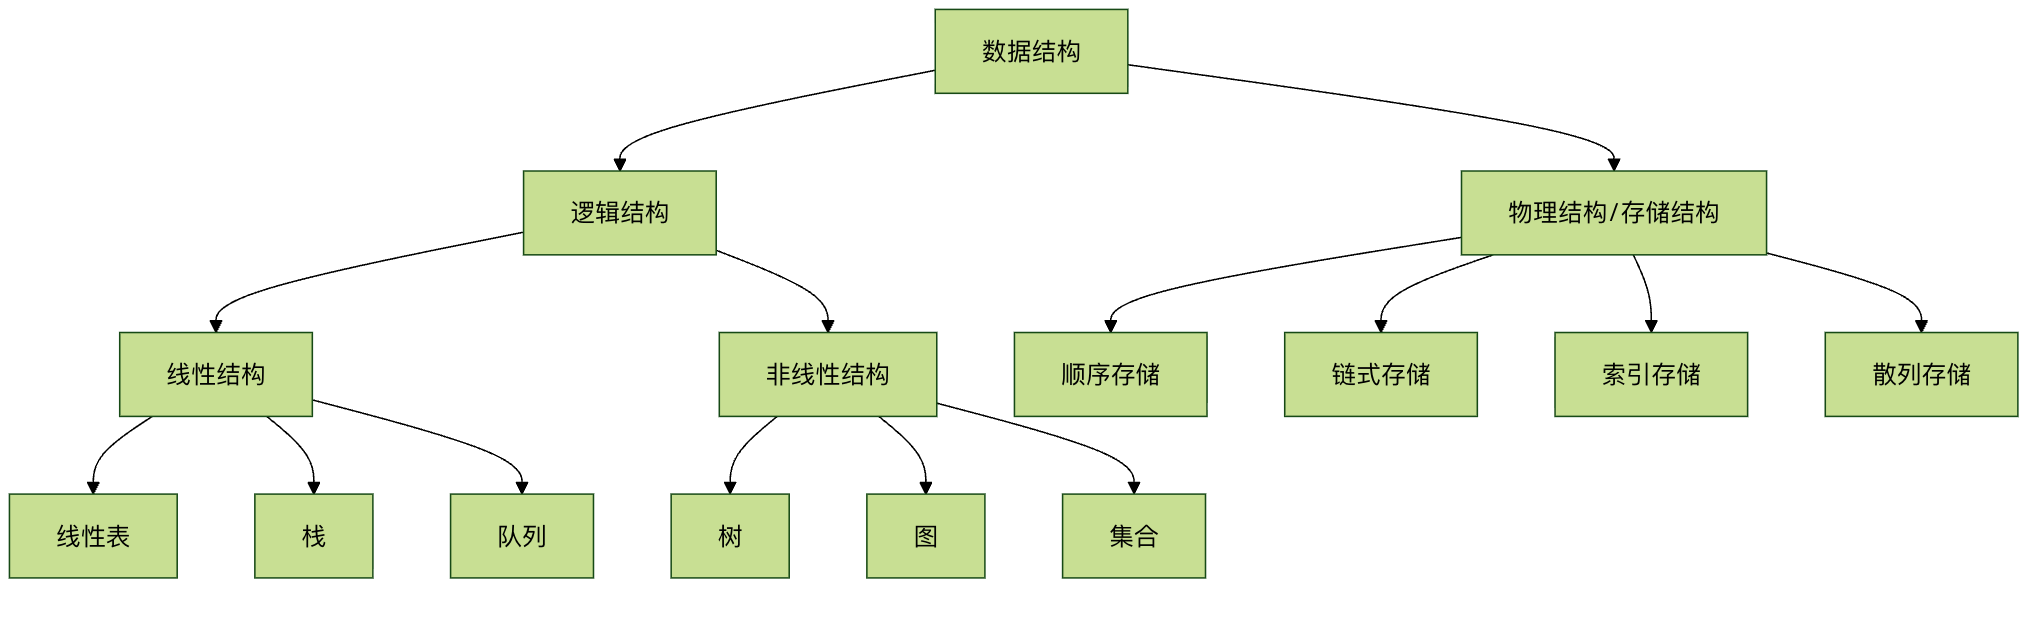
Логическая структураОписывает абстрактные взаимосвязи между элементами данных, независимо от того, как компьютер их реализует. Она в основном делится на:
- Линейная структура: между элементами данных существует линейная связь «один к одному». Например, массивы, связные списки, стеки и очереди.
- Нелинейная структура: между элементами данных существуют сложные связи «один ко многим» или «многие ко многим». Например, деревья, графы и множества.
Физическая структура(также называемая структурой хранения) описывает фактический способ хранения данных в памяти компьютера. Она в основном делится на:
- Последовательное хранение: логически смежные элементы хранятся в единицах хранения, которые также физически смежны. Например, массивы.
- Связное хранение: не требует, чтобы логически смежные элементы были физически смежными; логические взаимосвязи между элементами представляются с помощью дополнительных указателей. Например, связные списки.
Алгоритмы
Алгоритм — это последовательность четких, конечных шагов-инструкций для решения конкретной задачи.
Эффективный алгоритм должен обладать следующими пятью свойствами:
- Конечность: алгоритм должен завершиться после выполнения конечного числа шагов.
- Детерминированность: каждый шаг алгоритма должен иметь однозначное определение, без неоднозначности.
- Выполнимость: каждый шаг алгоритма может быть выполнен конечное число раз с помощью уже реализованных базовых операций.
- Вход: алгоритм имеет ноль или более входных данных.
- Выходные данные: У алгоритма есть один или несколько выходов, которые представляют собой величины, определённым образом связанные с входными данными.
Критерии оценки алгоритмов: временная сложность и пространственная сложность
Как мы судим, хорош алгоритм или плох? Обычно оценивают по двум измерениям:времениипространства.
- Временная сложность: Качественно описывает время выполнения алгоритма. Она представляет тенденцию роста времени выполнения алгоритма при увеличении размера задачи n. Обычно выражается с помощью нотации Big O.
- Пространственная сложность: Качественно описывает объём временно занимаемой памяти, используемой алгоритмом во время выполнения. Также выражается с помощью нотации Big O.
Сравнение распространённых временных сложностей
В таблице ниже показаны тенденции изменения различных временных сложностей при росте объёма данных:
| Представление сложности | Name | Пример (n=10 против n=1000) | Описание |
|---|---|---|---|
| O(1) | Константный порядок | 1 шаг против 1 шага | Наибольшая эффективность, не зависящая от размера задачи |
| O(log n) | Логарифмический порядок | ~3 шага против ~10 шагов | Очень высокая эффективность, например бинарный поиск |
| O(n) | Линейный порядок | 10 шагов против 1000 шагов | Хорошая эффективность, например обход массива |
| O(n log n) | Линейно-логарифмический порядок | ~30 шагов против ~10000 шагов | Довольно хорошая эффективность, например быстрая сортировка |
| O(n²) | Квадратичный порядок | 100 шагов против 1,000,000 шагов | Более низкая эффективность, например простая сортировка выбором |
| O(2ⁿ) | Экспоненциальный порядок | 1024 шага против астрономических чисел | Крайне низкая эффективность, по возможности следует избегать |
Простое понимание: Мы стремимся к алгоритмам, время выполнения которых растет медленнее по мере увеличения размера данных n. O(1) и O(log n) — отличные, O(n) — приемлемая, а O(n²) и выше требуют оптимизации при работе с большими объемами данных.
Классические примеры структур данных и алгоритмов
Давайте на конкретной задаче познакомимся с применением структур данных и алгоритмов.
Задача: В неупорядоченном списке чисел быстро определить, существует ли целевое число.
Решение 1: Линейный поиск (с использованием массивов)
Это интуитивно понятный, но неэффективный метод.
- Структуры данных: Массив (линейный список с последовательным хранением).
- Алгоритмы: Начиная с первого элемента, сравнивать его с целевым значением один за другим, пока он не будет найден или пока не будут пройдены все элементы.
- Временная сложность: O(n). В худшем случае нужно проверить все n элементов.
Пример
def linear_search(arr, target):
"""
Выполнить линейный поиск целевого значения target в массиве arr.
Параметры:
arr: список для поиска
target: целевое значение для поиска
Возвращает:
Если найдено, вернуть его индекс; иначе вернуть -1.
"""
for i in range(len(arr)): # Перебрать каждый элемент массива
if arr[i] == target: # Если текущий элемент равен целевому значению
return i # Вернуть текущий индекс
return -1 # После обхода, если не найдено, вернуть -1
# Тестовые данные
test_data = [12, 45, 67, 89, 34, 23, 90, 11]
target_number = 34
# Выполнить поиск
result = linear_search(test_data, target_number)
# Вывести результат
if result != -1:
print(f"Индекс целевого числа {target_number} в массиве: {result}")
else:
print(f"Целевое число {target_number} не найдено в массиве.")
Результат вывода:
目标数字 34 在数组中的索引是:4
Решение 2: Двоичный поиск (с использованием отсортированного массива)
Это эффективный метод, но обязательное условие — данные должны быть отсортированы.
- Структуры данных: Упорядоченный массив.
- Алгоритмы:
- Сравните искомое значение со средним элементом массива.
- Если они равны, значение найдено.
- Если искомое значение меньше, повторите шаг 1 в левой половине массива.
- Если искомое значение больше, повторите шаг 1 в правой половине массива.
- Если интервал поиска пуст, значение не найдено.
- Временная сложность: O(log n). Каждое сравнение сокращает диапазон поиска вдвое.
Пример
def binary_search(sorted_arr, target):
"""
Бинарный поиск значения target в отсортированном массиве sorted_arr.
Параметры:
sorted_arr: отсортированный список (по возрастанию)
target: целевое значение для поиска
Возвращает:
Если найдено, вернуть его индекс; иначе вернуть -1.
"""
left, right = 0, len(sorted_arr) - 1 # Инициализировать диапазон поиска как весь массив
while left <= right: # Продолжать поиск, пока диапазон допустим
mid = (left + right) // 2 # Вычислить средний индекс
if sorted_arr[mid] == target: # Целевое значение найдено
return mid
elif sorted_arr[mid] < target: # Целевое значение находится в правой половине
left = mid + 1
else: # Целевое значение находится в левой половине
right = mid - 1
return -1 # Недопустимый диапазон, не найдено
# Тестовые данные (должны быть отсортированы)
test_data = [12, 45, 67, 89, 34, 23, 90, 11]
sorted_test_data = sorted(test_data) # Отсортировать тестовые данные
print(fОтсортированный массив: {sorted_test_data})
target_number = 34
# Выполнить поиск
result = binary_search(sorted_test_data, target_number)
# Вывести результат
if result != -1:
print(fИндекс целевого числа {target_number} в отсортированном массиве: {result})
else:
print(fИскомое число {target_number} не найдено в отсортированном массиве)
Результат вывода:
有序数组:[11, 12, 23, 34, 45, 67, 89, 90]
目标数字 34 在有序数组中的索引是:3
Сравнение и размышление:
- Когда
n=1000, линейный поиск требует не более 1000 сравнений, тогда как бинарный поиск требует не более примерно 10 сравнений (потому что 2^10 ≈ 1024). - Бинарный поиск гораздо эффективнее линейного, но он требует предварительной сортировки данных. Сама сортировка связана с затратами, поэтому выбор алгоритма зависит от конкретного сценария (например, статичны ли данные с частым поиском или динамичны с частыми вставками).
С чего начать обучение?
Изучение структур данных и алгоритмов — это постепенный процесс. Рекомендуется следовать этому пути:
- Освойте язык программирования: Сначала вам нужен инструмент для реализации своих идей. Python, Java или C++ — все хорошие варианты. Python имеет лаконичный синтаксис и лучше подходит для начинающих, чтобы сосредоточиться на самой логике алгоритма.
- Начните с базовых структур данных:
- Массив / Список: Самая базовая и часто используемая структура последовательного хранения.
- Связный список: Ключ к пониманию указателей/ссылок и динамического выделения памяти.
- Стек и очередь: Поймите линейные списки с ограниченным набором операций: «последним пришёл — первым вышел» и «первым пришёл — первым вышел».
- Изучите базовые концепции алгоритмов:
- Алгоритмы сортировки: Пузырьковая сортировка, сортировка выбором, сортировка вставками (поймите O(n²)), затем изучите сортировку слиянием и быструю сортировку (поймите O(n log n) и идею «разделяй и властвуй»).
- Алгоритмы поиска: Последовательный поиск, бинарный поиск.
- Изучите нелинейные структуры:
- Дерево: Сосредоточьтесь на бинарных деревьях, особенно на бинарных деревьях поиска. Разберитесь в обходе дерева (прямой, симметричный, обратный).
- Граф: Разберитесь в способах представления графов (матрица смежности, список смежности) и базовых алгоритмах обхода (поиск в глубину DFS, поиск в ширину BFS).
- Практика и решение задач: Начните практиковаться с простых задач на таких платформах, как LeetCode и Niuke.com, чтобы применять теорию на практике. Это лучший способ закрепить знания и потренировать мышление.