Линейная структура данных
В этой главе мы представим один из самых базовых и часто используемых типов структур данных —линейную структуру данных。
Линейная структура данныхТочно так же, как ряд людей, выстроившихся в линию:
- У каждого человека (элемента) есть четкое отношение «до и после»
- За исключением первого и последнего, у каждого человека есть один предшественник и один последователь
- Элементы данных имеют линейное отношение «один к одному»
Представьте, что вы стоите в очереди за кофе или расставляете книги на полке.
В этих сценариях есть общая черта: элементы расположены один за другим, образуя линию.
В информатике такая упорядоченная коллекция данных называется линейной структурой данных.
Характерная особенность линейной структуры данных: за исключением первого и последнего элементов, каждый элемент имеет ровно одногопредшественникаи одногопоследователя。
Распространённые линейные структуры данных:
- массив: как ряд пронумерованных шкафчиков, каждый шкафчик имеет фиксированное положение
- Связный список: как цепочка людей, держащихся за руки, каждый человек помнит только людей впереди и позади
- Стек:Как стопка тарелок, предметы можно брать и класть только сверху
- ОчередьКак очередь за билетами, кто первым пришёл, того первым обслуживают
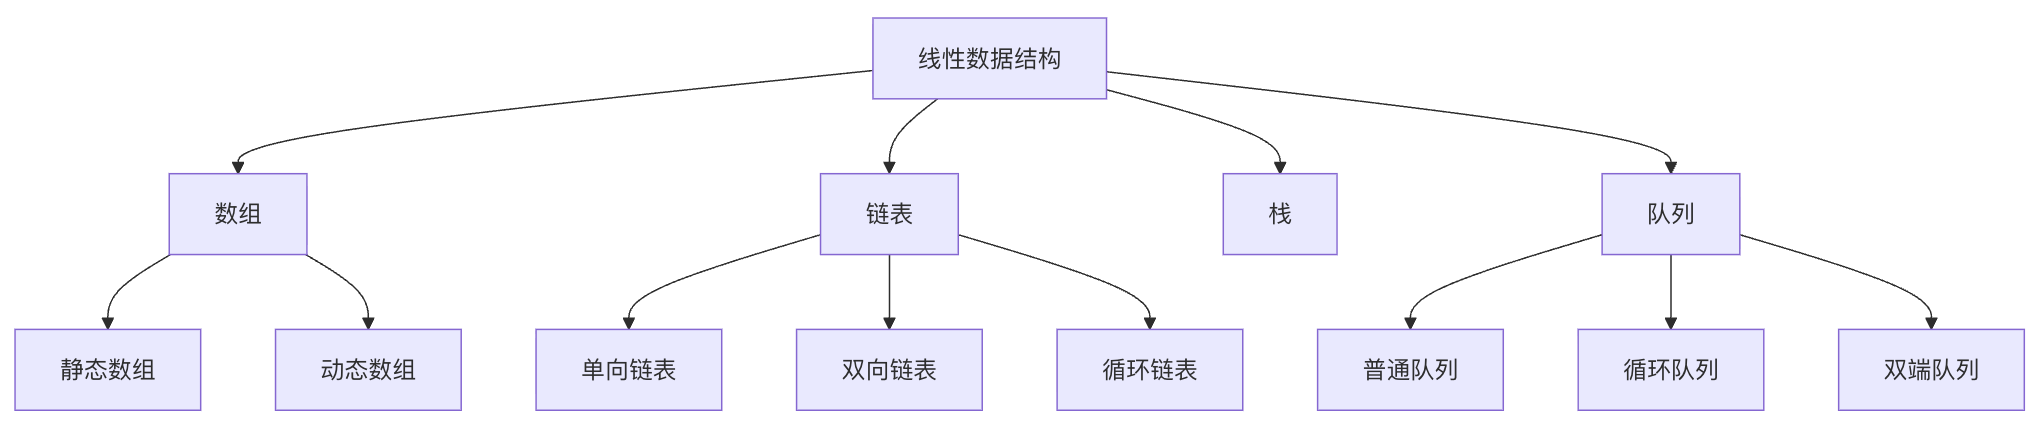
На рисунке ниже показана классификация линейных структур данных. Каждая структура имеет свои конкретные сценарии применения и характеристики производительности:
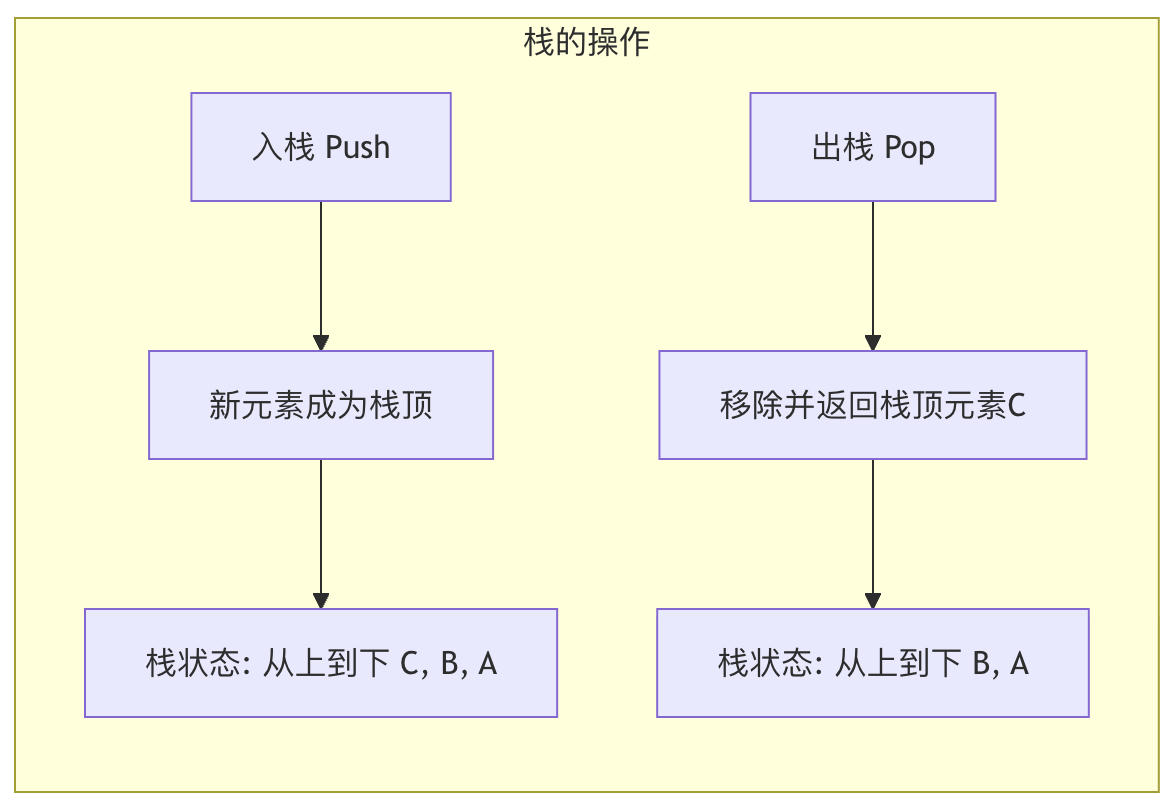
На рисунке ниже показан базовый процесс работы стека, который следует принципу LIFO (последним пришёл — первым вышел):

Массив
Статический массив
| Особенности | Описание | Временная сложность |
|---|---|---|
| Доступ к элементам | Прямой доступ по индексу | O(1) |
| Вставка элемента | Нужно сдвинуть последующие элементы | O(n) |
| Удаление элемента | Нужно сдвинуть последующие элементы | O(n) |
| Выделение памяти | Фиксированный размер, память выделена заранее | O(1) |
Динамический массив
| Особенности | Описание | Временная сложность |
|---|---|---|
| Доступ к элементам | Прямой доступ по индексу | O(1) |
| Вставка элемента | Может потребоваться изменение размера и копирование | В среднем O(1), в худшем случае O(n) |
| Удаление элемента | Нужно сдвинуть последующие элементы | O(n) |
| Выделение памяти | Автоматическое изменение размера | O(n) (при изменении размера) |
Связный список
Односвязный список
| Действие | Описание | Временная сложность |
|---|---|---|
| Доступ к элементам | Нужно пройти от начала | O(n) |
| Вставка в начало | Прямая вставка | O(1) |
| Вставка в хвост | Нужно пройти до хвоста | O(n) |
| Вставка в середину | Сначала нужно найти позицию | O(n) |
| Удаление элемента | Сначала нужно найти позицию | O(n) |
Двусвязный список
| Действие | Описание | Временная сложность |
|---|---|---|
| Доступ к элементам | Нужно пройти от головы или хвоста | O(n) |
| Вставка в начало | Прямая вставка | O(1) |
| Вставка в хвост | Прямая вставка (если есть указатель на хвост) | O(1) |
| Вставка в середину | Сначала нужно найти позицию | O(n) |
| Удаление элемента | Сначала нужно найти позицию | O(n) |
Стек
| Действие | Описание | Временная сложность |
|---|---|---|
| push | Добавить элемент на вершину стека | O(1) |
| pop | Удалить верхний элемент стека | O(1) |
| peek(просмотр) | Просмотреть верхний элемент стека | O(1) |
| isEmpty(проверка на пустоту) | Проверить, пуст ли стек | O(1) |
Очередь
| Действие | Описание | Временная сложность |
|---|---|---|
| enqueue | Добавить элемент в хвост очереди | O(1) |
| dequeue | Удалить головной элемент очереди | O(1) |
| front (просмотр начала очереди) | Просмотреть головной элемент очереди | O(1) |
| isEmpty(проверка на пустоту) | Проверить, пуста ли очередь | O(1) |
Диаграмма сравнения линейных структур данных
Массив: фиксированный многоквартирный дом для данных
Массивы — это простейшая и наиболее понятная линейная структура данных.
Мы можем представить его как зданиеМногоквартирный дом с фиксированным числом этажей。
Основные понятия и характеристики
- Непрерывное хранениеМассив занимает непрерывный блок в памятиНепрерывныйПространство похоже на комнаты в многоквартирном доме, расположенные вплотную друг к другу.
- Фиксированный размер: Вместимость (длина) массива должна быть определена при создании и обычно не может быть изменена после этого, так же как число комнат в многоквартирном доме фиксировано после его постройки.
- Доступ по индексу: Каждый элемент (комната) имеет уникальный номер, называемыйиндексомВ большинстве языков программирования индексация начинается с
0Начиная с. Вы можете напрямую и быстро обращаться к любому элементу по его индексу, с временной сложностьюO(1)。
Основные операции и примеры кода
Давайте продемонстрируем массивы на Python (в Python мы обычно используемlistдля имитации, но учтите, что в Pythonlistкоторый является динамическим) основные операции.
Пример
apartment_building = ['Комната 101 - Чжан Сань', 'Комната 102 - Ли Сы', 'Комната 103 - Ван У', 'Комната 104 - свободна', 'Комната 105 - свободна']
print("Жильцы многоквартирного дома:", apartment_building)
# 2. Доступ к элементам (по индексу)
# Доступ к комнате 102
tenant = apartment_building[1] # Индекс начинается с 0, поэтому 1 соответствует второму элементу
print(f"Жилец комнаты 102: {tenant}")
# 3. Обновление элементов
# Новый жилец Чжао Лю заселился в комнату 104
apartment_building[3] = 'Комната 104 - Чжао Лю'
print("После заселения Чжао Лю:", apartment_building)
# 4. Вставка элементов (добавление в конец относительно эффективно, имитируя "расширение")
# Предположим, что нам разрешено добавить комнату 106 в конец
apartment_building.append('Комната 106 - Сунь Ци')
print("После добавления комнаты 106:", apartment_building)
# 5. Удаление элементов
# Ван У съехал из комнаты 103
# Способ 1: пометить как свободную (логическое удаление)
# apartment_building[2] = 'Комната 103 - свободна'
# Способ 2: удалить элемент; последующие элементы нужно сдвинуть вперёд (физическое удаление, относительно неэффективно)
removed_tenant = apartment_building.pop(2) # Удалить элемент с индексом 2
print(f"{removed_tenant} съехал.")
print("После того как Ван У съехал:", apartment_building)
Вывод:
寓楼住户情况: ['101室-张三', '102室-李四', '103室-王五', '104室-空置', '105室-空置']
102室的住户是:102室-李四
赵六入住后: ['101室-张三', '102室-李四', '103室-王五', '104室-赵六', '105室-空置']
加盖106室后: ['101室-张三', '102室-李四', '103室-王五', '104室-赵六', '105室-空置', '106室-孙七']
103室-王五 已搬走。
王五搬走后: ['101室-张三', '102室-李四', '104室-赵六', '105室-空置', '106室-孙七']
Преимущества и недостатки
| Преимущества | Недостатки |
|---|---|
| Быстрый произвольный доступ: Любой элемент можно получить за постоянное время по его индексу. | Фиксированный размер: После создания статического массива его вместимость трудно изменить. |
| Высокая эффективность использования памяти: Непрерывное хранение, не требуется дополнительное пространство для хранения связей между элементами. | Высокая стоимость вставки/удаления: Вставка или удаление элементов в середине требует сдвига многих последующих элементов для сохранения непрерывности. |
Связный список: поезд-кладоискатель для данных
Когда фиксированный размер массивов и неэффективность вставки/удаления становятся проблемой, на сцену выходят связные списки. Связный список похож на поездПоезд, каждый вагон (узел) перевозит груз (данные) и соединён со следующим вагоном через сцепку (указатель).
Основные понятия и типы
Каждый узел связного спискаузелСодержит как минимум две части:
- Поле данныхХранит фактическое значение данных.
- Поле указателя: хранит адрес следующего узла в памяти.
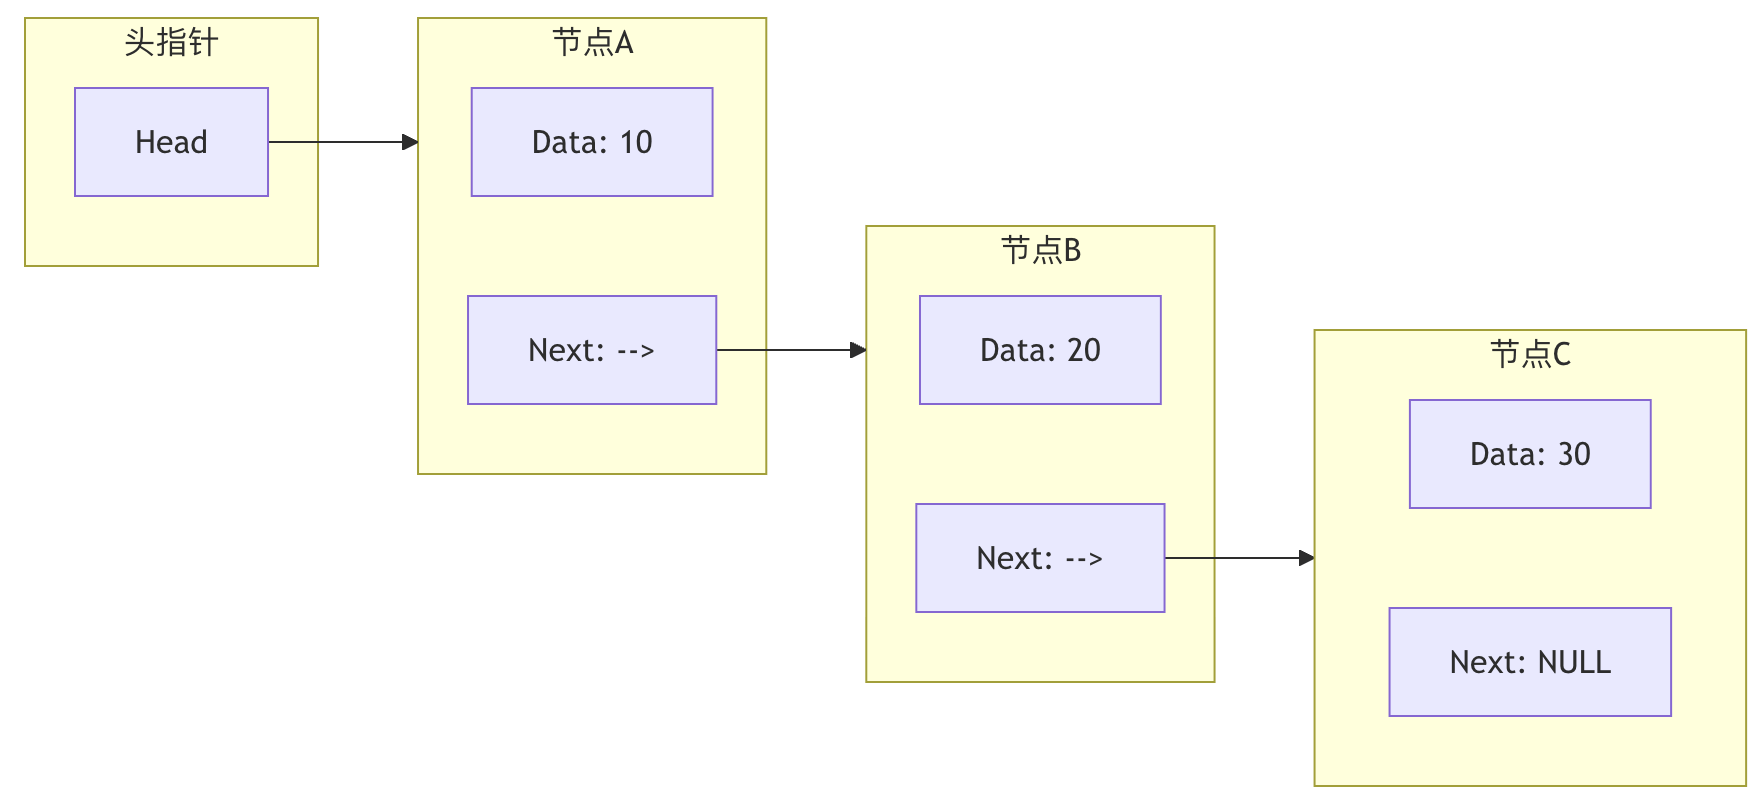
На рисунке выше показана структураодносвязного списка. Указатель head указывает на первый узел, и у каждого узлаNextуказатель указывает на следующий узел, а у последнего узлаNextУказывает наNULLОбозначает конец связного списка.
Основные типы связных списков:
- Односвязный списокУзел указывает только на следующий узел.
- Двусвязный список: Узлы указывают как на предыдущий, так и на следующий узел, что позволяет выполнять двунаправленный обход.
- Циклический связный список: Хвостовой узел указывает на головной узел, образуя кольцо.
Основные операции и примеры кода
Давайте реализуем простой односвязный список.
Пример
"""Определяет класс узла связного списка"""
def __init__(self, data):
self.data = data # Поле данных
self.next = None # Поле указателя, изначально указывает на null
class LinkedList:
"""Определяет класс односвязного списка"""
def __init__(self):
self.head = None # Указатель на голову связного списка
def append(self, data):
"""Добавляет узел в конец связного списка"""
new_node = ListNode(data)
if not self.head: # Если связный список пуст, новый узел становится головным узлом
self.head = new_node
return
last_node = self.head
while last_node.next: # Пройти до последнего узла
last_node = last_node.next
last_node.next = new_node # Присоединить новый узел в конец
def prepend(self, data):
"""Добавить узел в начало связного списка"""
new_node = ListNode(data)
new_node.next = self.head
self.head = new_node
def delete(self, key):
"""Удалить первый узел со значением key"""
current_node = self.head
# Если удаляемый узел является головным
if current_node and current_node.data == key:
self.head = current_node.next
current_node = None
return
prev_node = None
# Обход для поиска удаляемого узла
while current_node and current_node.data != key:
prev_node = current_node
current_node = current_node.next
if current_node is None: # Не найдено
return
# После обнаружения обходим узел, чтобы соединить
prev_node.next = current_node.next
current_node = None
def print_list(self):
"""Вывести все элементы связного списка"""
current_node = self.head
while current_node:
print(current_node.data, end=" -> ")
current_node = current_node.next
print("NULL")
# Проверка связного списка
print("=== Демонстрация операций односвязного списка ===")
train = LinkedList()
train.append("Вагон 1 - Уголь")
train.append("Вагон 2 - Древесина")
train.prepend("Локомотив") # Добавить в начало
train.append("Вагон 3 - Сталь")
print("Начальный поезд:")
train.print_list() # Вывод: Локомотив -> Вагон 1 - Уголь -> Вагон 2 - Древесина -> Вагон 3 - Сталь -> NULL
train.delete("Вагон 2 - Древесина")
print("После разгрузки древесины:")
train.print_list() # Вывод: locomotive -> carriage1-coal -> carriage3-steel -> NULL
Вывод:
=== 单向链表操作演示 ===
初始列车:
车头 -> 车厢1-煤炭 -> 车厢2-木材 -> 车厢3-钢材 -> NULL
卸下木材后:
车头 -> 车厢1-煤炭 -> 车厢3-钢材 -> NULL
Преимущества и недостатки
| Преимущества | Недостатки |
|---|---|
| Динамический размер: Не нужно заранее выделять фиксированное пространство; он может гибко увеличиваться и уменьшаться. | Накладные расходы памяти: Каждый узел требует дополнительного места для хранения указателя. |
| Эффективная вставка/удаление: Когда позиция узла известна, нужно только изменить указатели, не перемещая множество элементов. | Последовательный доступ: В отличие от массивов, элементы нельзя получить напрямую по индексу; нужно проходить от головы. |
| Неудобный для кэша: Узлы разбросаны в памяти, что не способствует предварительной выборке в кэш CPU. |
Стек: стопка тарелок для данных
Стек — этоLIFO (последним пришёл — первым вышел)структура данных, как стопка тарелок в ресторане: вы всегда берёте верхнюю (последнюю положенную).
Основные понятия и операции
Стек допускает операции только на одном конце (называемомвершиной стека) для вставки (Push) и удаления (Pop) операции. Другой конец называетсядном стека。
Основные операции:
- push(data)Поместить данные на вершину стека.
- pop()Извлечь и вернуть верхний элемент стека.
- peek() / top()Просмотреть верхний элемент стека, не извлекая его.
- is_empty()Проверить, пуст ли стек.
Сценарии применения и примеры кода
Стеки чрезвычайно широко используются в информатике, например, стек вызовов функций, навигация вперёд/назад в браузере, вычисление выражений, проверка соответствия скобок и т. д.
Пример
"""Использовать список для реализации стека"""
def __init__(self):
self.items = []
def push(self, item):
"""Поместить"""
self.items.append(item) # Использовать конец списка как вершину стека
def pop(self):
"""Извлечь; вернуть None, если стек пуст"""
if not self.is_empty():
return self.items.pop()
return None
def peek(self):
"""Посмотреть верхний элемент"""
if not self.is_empty():
return self.items[-1]
return None
def is_empty(self):
"""Проверить, пуст ли стек"""
return len(self.items) == 0
def size(self):
"""Вернуть размер стека"""
return len(self.items)
# Пример применения: проверка соответствия скобок
def is_balanced_parentheses(expression):
"""
Проверить, совпадают ли скобки в выражении
Например: (()) сбалансировано, (() несбалансировано
"""
stack = Stack()
# Сопоставление пар скобок
matching_bracket = {')': '(', ']': '[', '}': '{'}
for char in expression:
if char in '([{': # Если это левая скобка, поместить в стек
stack.push(char)
elif char in ')]}': # Если это правая скобка
if stack.is_empty():
return False # Стек пуст, поэтому слишком много закрывающих скобок
top_char = stack.pop()
if matching_bracket[char] != top_char: # Проверить, совпадают ли они
return False
# После цикла стек должен быть пустым
return stack.is_empty()
# Тест стека и сопоставления скобок
print("\n=== Демонстрация стека и сопоставления скобок ===")
plate_stack = Stack()
plate_stack.push("Тарелка 1")
plate_stack.push("Тарелка 2")
plate_stack.push("Тарелка 3")
print(f"Достаньте верхнюю тарелку: {plate_stack.pop()}") # Вывод: Тарелка 3
print(f"Теперь верхняя тарелка: {plate_stack.peek()}") # Вывод: Тарелка 2
# Проверка соответствия скобок
test_cases = ["((1+2)*3)", "({[ ]})", "((())", ")( )"]
for test in test_cases:
result = сбалансированы if is_balanced_parentheses(test) else не сбалансированы
print(fСкобки в выражении '{test}' {result}.)
Вывод:
=== 栈与括号匹配演示 ===
取出最上面的盘子: 盘子3
现在最上面的盘子是: 盘子2
表达式 '((1+2)*3)' 的括号是 平衡 的。
表达式 '({[ ]})' 的括号是 平衡 的。
表达式 '((())' 的括号是 不平衡 的。
表达式 ')( )' 的括号是 不平衡 的。
Очередь: канал для данных, работающий по принципу очереди
Очередь — этопервым пришёл — первым вышелструктура данных; как и в любом месте в жизни, где нужно стоять в очереди (например, на кассе в супермаркете), первыми обслуживают тех, кто пришёл первым.
Основные понятия и операции
Очередь позволяет выполнять операции на одном конце (называемомхвост) для вставки (Enqueue) операций, а на другом конце (называемомголова) для операции удаления (Dequeue).
Основные операции:
- enqueue(data)Добавляет данные в хвост очереди.
- dequeue()Удаляет и возвращает данные из головы очереди.
- front() / peek()Просмотреть головной элемент очереди, не удаляя его.
- is_empty()Проверить, пуста ли очередь.
Сценарии применения и примеры кода
Очереди часто используются в сценариях, где задачи должны обрабатываться по порядку, например: очереди заданий на печать, очереди сообщений, поиск в ширину и т. д.
Пример
class Queue:
"""Реализовать очередь с использованием collections.deque"""
def __init__(self):
self.items = deque()
def enqueue(self, item):
"""Поставить в очередь"""
self.items.append(item) # Добавить справа (в хвост)
def dequeue(self):
"""Извлечь из очереди, вернуть None, если очередь пуста"""
if not self.is_empty():
return self.items.popleft() # Удалить слева (из головы)
return None
def front(self):
"""Посмотреть на головной элемент"""
if not self.is_empty():
return self.items[0]
return None
def is_empty(self):
"""Проверить, пуста ли очередь"""
return len(self.items) == 0
def size(self):
"""Вернуть размер очереди"""
return len(self.items)
# Пример применения: имитация задач печати
print("\n=== Очередь и имитация задач печати ===)
printer_queue = Queue()
# Смоделировать поступление трёх задач печати
tasks = ["Резюме Алисы.pdf", "Отчёт Боба.doc", "Диаграмма Чарли.png"]
for task in tasks:
printer_queue.enqueue(task)
print(f"Задача '{task}' добавлена в очередь печати.")
# Обработка задач печати
print("\nНачало печати...)
while not printer_queue.is_empty():
current_task = printer_queue.dequeue()
print(f"Печать: {current_task}")
# Имитация времени печати
print("Все задачи печати выполнены.")
Вывод:
=== 队列与打印任务模拟 ===
任务 'Alice的简历.pdf' 已加入打印队列。
任务 'Bob的报告.doc' 已加入打印队列。
任务 'Charlie的图表.png' 已加入打印队列。

开始打印...
正在打印: Alice的简历.pdf
正在打印: Bob的报告.doc
正在打印: Charlie的图表.png
所有打印任务已完成。
Итоги и сравнение
Мы изучили четыре основные линейные структуры данных. Таблица ниже поможет вам быстро просмотреть и сравнить их ключевые характеристики:
| Особенности | array | Связный список | Стек | Очередь |
|---|---|---|---|---|
| Способ хранения | Непрерывная память | Разрозненная память, связанная через указатели | Реализовано на основе массивов или связанных списков | Реализовано на основе массивов или связанных списков |
| Способ доступа | Произвольный доступ (по индексу) | Последовательный доступ (необходимо пройти по элементам) | Ограничен вершиной стека (LIFO) | Ограничен головой очереди (FIFO) |
| Эффективность вставки/удаления | Быстро в конце, медленно в середине/в начале (требуется сдвиг элементов) | Быстро, когда позиция известна (нужно только изменить указатели) | Операции на вершине стека, O(1) | Постановка в очередь в хвост, извлечение из очереди из головы, O(1) |
| Size | Фиксированный (статический массив) | Динамический | Динамический | Динамический |
| Основные применения | Быстрый поиск, фиксированная коллекция | Частая вставка/удаление, неопределённый размер | Вызовы функций, перебор с возвратом, сопоставление скобок | Планирование задач, буферизация, BFS |
Как выбрать?
- требуетсяБыстрый произвольный доступи, когда объём данных известен, выбирайтемассив。
- требуетсяЧасто вставлять или удалять в произвольных позицияхэлементы, и когда объём данных сильно меняется, выбирайтесвязный список。
- Нужно реализовать"Отмена"функцию илиобратную обработкупри работе с последовательностью, рассмотритестек。
- Нужно соблюдать"Первым пришёл — первым обслужен"при обработке задач по порядку, используйтеочередь。