Algorithmes de tri
Un algorithme de tri est un algorithme qui organise une séquence de données selon une méthode de tri spécifique ; les données triées peuvent ensuite être placées dans un tableau ordonné.
TriIl désigne le processus de réorganisation d'un ensemble de données (comme un tableau ou une liste) dans un ordre spécifique (croissant ou décroissant).
La base du tri est généralement une certaine propriété des éléments de donnéesClécomme la grandeur des nombres, l'ordre lexicographique des chaînes, etc.
Le tri est l'un des problèmes algorithmiques les plus fondamentaux et centraux en informatique. Qu'il s'agisse d'organiser des contacts, d'analyser des notes d'examen ou d'optimiser des requêtes de base de données, les algorithmes de tri sont partout.
Comprendre différents algorithmes de tri nous aide non seulement à résoudre des problèmes pratiques, mais c'est aussi un excellent moyen de comprendre en profondeur les idées de conception et d'analyse d'algorithmes.
Classification des algorithmes de tri
Les algorithmes de tri peuvent être classés selon plusieurs dimensions, et la classification la plus courante repose sur leurcomplexité temporelleet leurcomplexité spatiale。
| Dimension de classification | Catégorie | Description | Algorithmes typiques |
|---|---|---|---|
| Complexité temporelle | Niveau O(n²) | simple et intuitif, mais peu efficace, adapté aux données de petite taille. | Tri à bulles, tri par sélection, tri par insertion |
| Niveau O(n log n) | efficacité relativement élevée, et constitue le premier choix pour le traitement de données à grande échelle. | Tri rapide, tri fusion, tri par tas | |
| Complexité spatiale | Tri en place | N'utilise qu'une quantité constante d'espace supplémentaire pendant le processus de tri. | Tri à bulles, tri par sélection, tri par insertion, tri de Shell, tri par tas, tri rapide. |
| Tri non en place | Un espace supplémentaire proportionnel à la taille des données est nécessaire pendant le processus de tri. | Tri fusion, tri comptage, tri par compartiments, tri par base. | |
| Stabilité | Tri stable | L'ordre relatif des éléments égaux reste inchangé après le tri. | Tri à bulles, tri par insertion, tri fusion, tri comptage, tri par compartiments, tri par base. |
| Tri instable | L'ordre relatif des éléments égaux peut changer après le tri. | Tri par sélection, tri de Shell, tri par tas, tri rapide |
Explication des concepts clés :
- Complexité temporelleMesure l'évolution du temps d'exécution d'un algorithme à mesure que la taille des données augmente.
- Complexité spatialeMesure la quantité d'espace de stockage supplémentaire nécessaire pendant l'exécution d'un algorithme.
- StabilitéPour les éléments de valeurs égales, si leur ordre relatif reste inchangé après le tri. C'est très important dans le tri multi-clés.
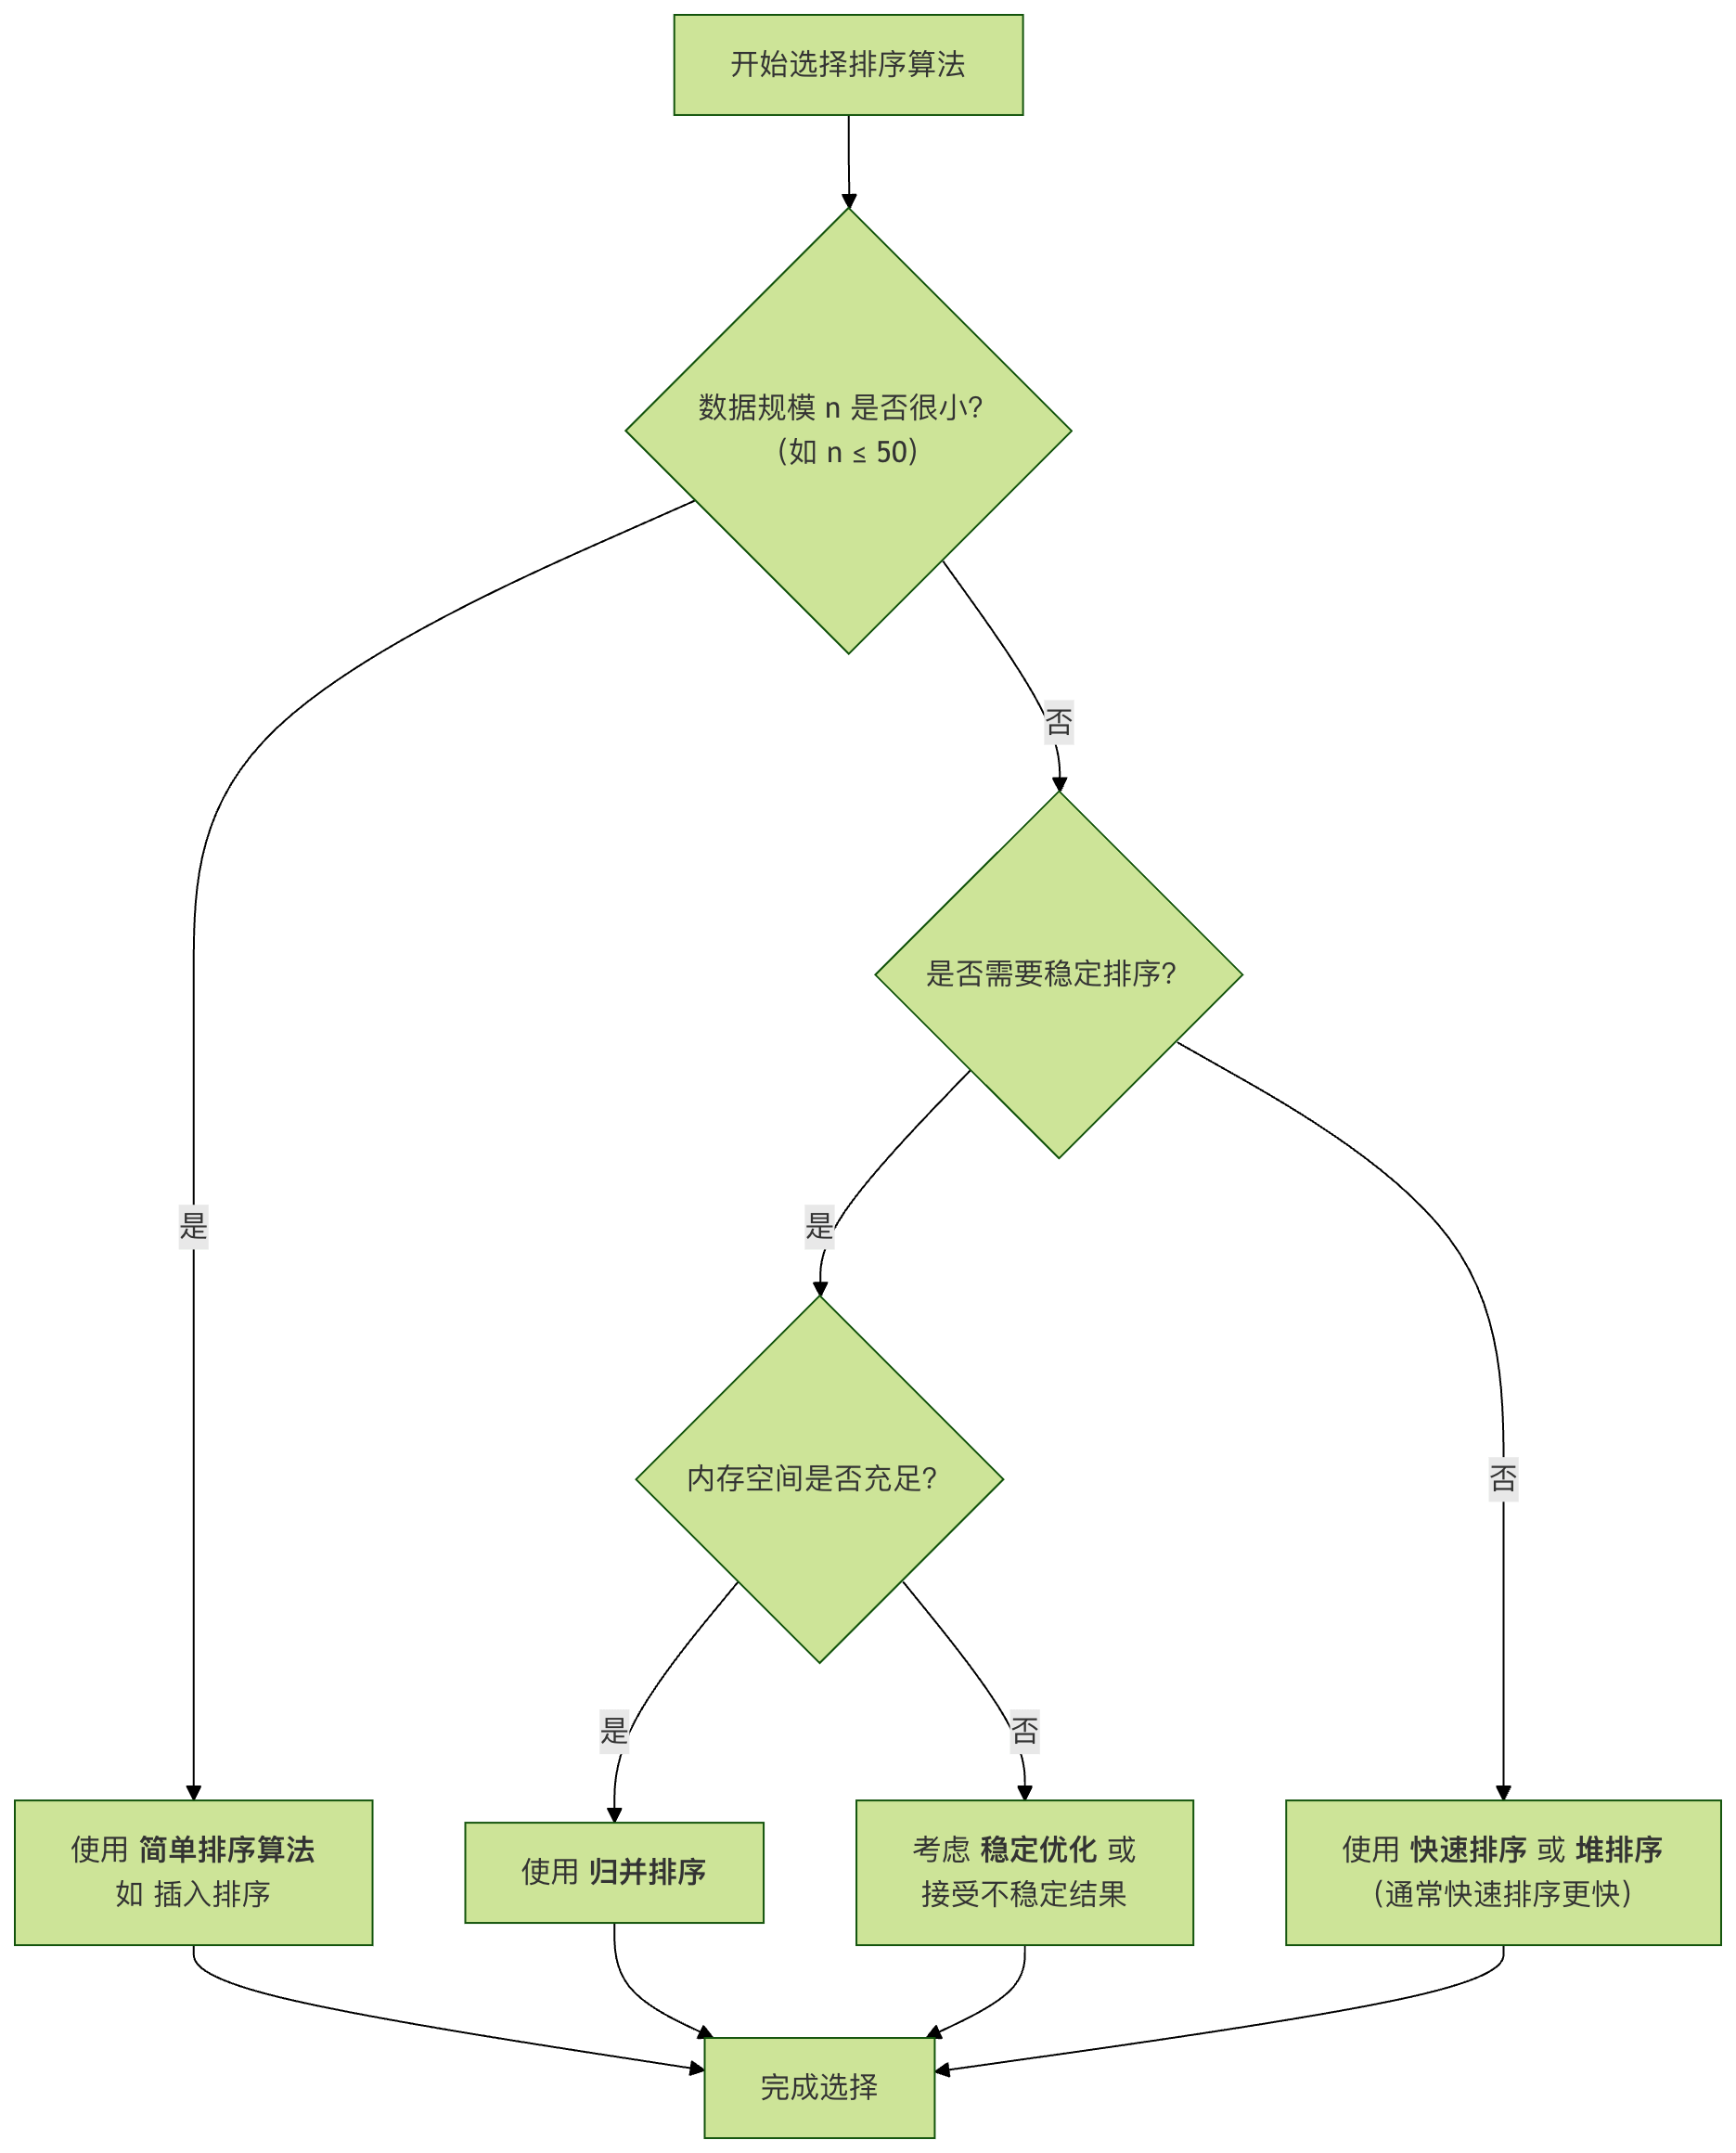
L'organigramme suivant montre comment faire un choix préliminaire parmi plusieurs algorithmes classiques selon différents scénarios de besoins :
Algorithmes de tri de base de niveau O(n²)
Ces algorithmes sont simples dans leur concept et constituent le point de départ pour comprendre la logique de tri.
Tri à bulles
Idée principaleParcourir de façon répétée la séquence à trier, en comparant deux éléments adjacents à la fois, et en les échangeant s'ils sont dans le mauvais ordre. Chaque parcours fait remonter le plus grand (ou le plus petit) élément de la partie non triée actuelle à sa position correcte.
Étapes de l'algorithme:
- Comparer les éléments adjacents. Si le premier est supérieur au second (pour un ordre croissant), les échanger.
- Faire de même pour chaque paire d'éléments adjacents, de la première paire au début à la dernière paire à la fin. Après cette étape, le dernier élément sera le plus grand nombre.
- Répéter les étapes ci-dessus pour tous les éléments sauf le dernier (car chaque tour détermine un élément final).
- Continuer à répéter les étapes ci-dessus pour de moins en moins d'éléments à chaque fois, jusqu'à ce qu'il n'y ait plus de paire de nombres à comparer.
Implémentation du code:
Exemple
"""
Tri à bulles (ordre croissant)
:param arr: La liste à trier
"""
n = len(arr)
# La boucle externe contrôle le nombre de passes nécessaires (n-1 passes)
for i in range(n - 1):
# La boucle interne effectue la comparaison et l'échange des éléments adjacents
# Après chaque passe, les derniers i+1 éléments sont déjà triés, donc la plage de comparaison va de 0 à n-1-i
for j in range(0, n - 1 - i):
if arr[j] > arr[j + 1]: # Si l'élément précédent est plus grand que l'élément suivant
# Échanger les positions des deux éléments
arr[j], arr[j + 1] = arr[j + 1], arr[j]
return arr
# Données de test
test_data = [64, 34, 25, 12, 22, 11, 90]
print("Tableau d'origine :", test_data)
sorted_data = bubble_sort(test_data.copy()) # Utiliser une copie pour éviter de modifier les données d'origine
print("Après le tri à bulles :", sorted_data)
Sortie :
原始数组: [64, 34, 25, 12, 22, 11, 90]
冒泡排序后: [11, 12, 22, 25, 34, 64, 90]
Analyse des performances:
- Complexité temporelleMeilleur cas O(n) (réalisable avec optimisation lorsque déjà trié), pire cas et cas moyen O(n²).
- Complexité spatiale: O(1), c'est un tri en place.
- Stabilité: stable.
Tri par sélection
Idée principaleTrouver le plus petit (ou le plus grand) élément dans la séquence non triée, le placer au début de la séquence triée, puis continuer à trouver le plus petit (le plus grand) élément parmi les éléments non triés restants et le placer à la fin de la séquence triée. Continuer ainsi jusqu'à ce que tous les éléments soient triés.
Étapes de l'algorithme:
- État initial : la séquence entière est la région non triée.
- Lors de la i-ème passe (i commençant à 0) du tri, la région non triée actuelle est
arr[i...n-1]Dans cette région, sélectionnez l'enregistrement ayant la plus petite cléarr[min_index]。 - va
arr[min_index]Avec le premier enregistrement de la région non triéearr[i]Échangez. De cette façon,arr[0...i]Ensuite, la région triée est formée. - Après n-1 passes, le tableau est trié.
Implémentation du code:
Exemple
"""
Tri par sélection (croissant)
:param arr: La liste à trier
"""
n = len(arr)
for i in range(n):
# Supposons que l'élément à l'indice actuel i soit le plus petit
min_index = i
# Trouver un élément plus petit dans l'intervalle de i+1 à n-1
for j in range(i + 1, n):
if arr[j] < arr[min_index]:
min_index = j # Mettre à jour l'indice du plus petit élément
# Échanger le plus petit élément trouvé avec l'élément à la position i
arr[i], arr[min_index] = arr[min_index], arr[i]
return arr
# Test
test_data = [64, 25, 12, 22, 11]
print("Tableau d'origine :", test_data)
print("Après le tri par sélection :", selection_sort(test_data.copy()))
Sortie :
原始数组: [64, 25, 12, 22, 11]
选择排序后: [11, 12, 22, 25, 64]
Analyse des performances:
- Complexité temporelleToujours O(n²), car des comparaisons complètes sont nécessaires, que les données soient triées ou non.
- Complexité spatiale: O(1), tri en place.
- Stabilité:instable. Par exemple, la séquence
[5, 8, 5, 2, 9], au premier tour, le premier [élément] sera5et2échangé, ce qui brise les deux5L'ordre d'origine.
Tri par insertion
Idée cléEn construisant une séquence ordonnée, pour les données non triées, parcourir la séquence triée en sens inverse, trouver la position appropriée et l'insérer. C'est comme ranger des cartes à jouer.
Étapes de l'algorithme:
- Considérer le premier élément comme la séquence triée.
- Prenez l'élément suivant et parcourez à rebours la séquence d'éléments triés.
- Si l'élément trié est supérieur au nouvel élément, déplacez l'élément trié à la position suivante.
- Répétez l'étape 3 jusqu'à ce que vous trouviez une position où l'élément trié est inférieur ou égal au nouvel élément.
- Après avoir inséré le nouvel élément à cette position.
- Répétez les étapes 2-5 jusqu'à ce que tous les éléments soient traités.
Implémentation du code:
Exemple
"""
Tri par insertion (ordre croissant)
:param arr: La liste à trier
"""
n = len(arr)
# Commencez à partir du deuxième élément (index 1) car le premier élément est déjà trié par défaut
for i in range(1, n):
key = arr[i] # L'élément actuel à insérer
j = i - 1 # Indice du dernier élément de la séquence triée
# Parcourez la séquence triée de la fin vers le début pour trouver la position d'insertion de key
# En même temps, déplacez d'une position vers l'arrière les éléments supérieurs à key
while j >= 0 and key < arr[j]:
arr[j + 1] = arr[j]
j -= 1
# Insérer key à la position correcte trouvée
arr[j + 1] = key
return arr
# Test
test_data = [12, 11, 13, 5, 6]
print("Tableau d'origine :", test_data)
print("Après le tri par insertion :", insertion_sort(test_data.copy()))
Sortie :
原始数组: [12, 11, 13, 5, 6]
插入排序后: [5, 6, 11, 12, 13]
Analyse des performances:
- Complexité temporelleMeilleur cas O(n) (déjà trié), cas défavorable et moyen O(n²).
- Complexité spatiale: O(1), tri en place.
- Stabilité: stable.
- Caractéristiques: Pour des données de petite échelle ou presque triées, le tri par insertion est très efficace. C'est l'algorithme vers lequel les algorithmes de tri avancés (comme Timsort) basculent pour les données de petite échelle.
Algorithmes de tri efficaces de niveau O(n log n)
Lorsque la taille des données augmente, les algorithmes en O(n²) deviennent très lents. Les algorithmes plus efficaces suivants sont les piliers de la pratique de l'ingénierie.
Tri rapide
Idée principale:Diviser pour régnerSélectionner un élément pivot. En une passe de tri, partitionner les enregistrements à trier en deux parties indépendantes, où les clés d'une partie sont toutes inférieures aux clés de l'autre partie ; puis trier ces deux parties séparément pour rendre toute la séquence ordonnée.
Étapes de l'algorithme:
- Sélectionner le pivotChoisir un élément de la séquence et l'appeler le "pivot".
- Opération de partitionnementRéorganiser la séquence de sorte que tous les éléments plus petits que le pivot soient placés avant lui et que tous les éléments plus grands que le pivot soient placés après lui (les nombres égaux peuvent aller d'un côté ou de l'autre). Une fois cette partition terminée, le pivot est dans sa position finale au milieu de la séquence. C'est ce qu'on appelle l'opération de partitionnement.
- trier récursivementTrier récursivement la sous-séquence contenant les éléments plus petits que le pivot et la sous-séquence contenant les éléments plus grands que le pivot.
Implémentation du code:
Exemple
"""
Tri rapide (croissant) - Fonction principale
"""
def _quick_sort(arr, low, high):
if low < high:
# pi est l'indice de partition, arr[pi] est maintenant à la bonne position
pi = partition(arr, low, high)
# Trier récursivement les sous-tableaux avant et après la partition
_quick_sort(arr, low, pi - 1)
_quick_sort(arr, pi + 1, high)
def partition(arr, low, high):
"""
Fonction de partition, sélectionner le dernier élément comme pivot
:return: l'indice de la position finale correcte de l'élément pivot
"""
pivot = arr[high] # Choisir un pivot
i = low - 1 # Pointe vers la fin du sous-tableau des éléments inférieurs au pivot
for j in range(low, high):
# Si l'élément actuel est inférieur ou égal au pivot
if arr[j] <= pivot:
i += 1
arr[i], arr[j] = arr[j], arr[i] # Échanger
# Placer l'élément pivot à la position correcte (i+1)
arr[i + 1], arr[high] = arr[high], arr[i + 1]
return i + 1
_quick_sort(arr, 0, len(arr) - 1)
return arr
# Test
test_data = [10, 80, 30, 90, 40, 50, 70]
print("Tableau d'origine :", test_data)
print("Après le tri rapide :", quick_sort(test_data.copy()))
Sortie :
原始数组: [10, 80, 30, 90, 40, 50, 70]
快速排序后: [10, 30, 40, 50, 70, 80, 90]
Analyse des performances:
- Complexité temporelleCas moyen O(n log n), pire cas O(n²) (lorsque le tableau est déjà trié ou trié dans l'ordre inverse et que le pivot est mal choisi). Le pire cas peut être largement évité en sélectionnant aléatoirement le pivot ou en utilisant la méthode « médiane de trois ».
- Complexité spatiale: En moyenne O(log n) (pile d'appels récursifs), dans le pire des cas O(n).
- Stabilité:instable。
Tri par fusion
Idée principale:Diviser pour régnerUne application typique. Fusionner des sous-séquences déjà triées pour obtenir une séquence complètement triée. C'est-à-dire, d'abord trier chaque sous-séquence, puis ordonner les segments de sous-séquences les uns par rapport aux autres.
Étapes de l'algorithme:
- DiviserDiviser l'intervalle actuel en deux parties, c'est-à-dire trouver le point de séparation
mid = (low + high)/2。 - RégnerTrier récursivement les deux sous-intervalles
arr[low...mid]etarr[mid+1...high]Effectuer le tri fusion. La condition d'arrêt de la récursion est que la longueur du sous-intervalle soit 1 (un élément est considéré comme naturellement ordonné). - FusionnerFusionner deux sous-intervalles triés en un intervalle trié.
Implémentation du code:
Exemple
"""
Tri fusion (croissant) - Fonction principale
"""
if len(arr) > 1:
mid = len(arr) // 2 # Trouver le point milieu et diviser le tableau
left_half = arr[:mid]
right_half = arr[mid:]
# Trier récursivement les moitiés gauche et droite
merge_sort(left_half)
merge_sort(right_half)
# Fusionner les deux sous-tableaux triés
i = j = k = 0
# Comparer les éléments des sous-tableaux gauche et droit, placer le plus petit dans le tableau d'origine
while i < len(left_half) and j < len(right_half):
if left_half[i] < right_half[j]:
arr[k] = left_half[i]
i += 1
else:
arr[k] = right_half[j]
j += 1
k += 1
# Vérifier s'il reste des éléments (moitié gauche ou moitié droite)
while i < len(left_half):
arr[k] = left_half[i]
i += 1
k += 1
while j < len(right_half):
arr[k] = right_half[j]
j += 1
k += 1
return arr
# Test
test_data = [38, 27, 43, 3, 9, 82, 10]
print("Tableau d'origine :", test_data)
print("Après le tri fusion :", merge_sort(test_data.copy()))
Sortie :
原始数组: [38, 27, 43, 3, 9, 82, 10]
归并排序后: [3, 9, 10, 27, 38, 43, 82]
Analyse des performances:
- Complexité temporelleLes cas meilleur, pire et moyen sont tous O(n log n). Les performances sont très stables.
- Complexité spatialeO(n), nécessitant un espace supplémentaire égal au tableau d'origine pour la fusion.
- Stabilité: stable.
Tri par tas
Idée principale: utiliserTasUn algorithme de tri conçu pour cette structure de données. Un tas est une structure d'arbre binaire presque complète qui satisfait également la propriété du tas : la valeur d'un nœud parent est toujours supérieure ou égale (tas max) ou inférieure ou égale (tas min) à la valeur de n'importe quel nœud enfant.
Étapes de l'algorithme:
- Construire un tas maxConstruire la séquence à trier en un tas max. À ce stade, la valeur maximale de toute la séquence est le nœud racine au sommet du tas.
- Échanger le sommet du tas avec le dernier élémentÉchangez l'élément au sommet (le maximum) avec le dernier élément ; le dernier élément est maintenant le maximum.
- Ajuster la structure du tas: pour les éléments restants
n-1Reconstruire les éléments restants en un tas max, ce qui donne la valeur la plus grande suivante. Échangez-la avec le nouveau dernier élément (position n-1). - Répéter l'exécutionRépétez les étapes 2 et 3 jusqu'à ce que la taille du tas soit 1 ; le tri est terminé.
Implémentation du code:
Exemple
"""
Tri par tas (croissant) - Utilisation d'un tas max
"""
n = len(arr)
# Étape 1 : construire le tas max. Commencez l'ajustement vers le haut à partir du dernier nœud non-feuille
# Indice du dernier nœud non-feuille = n//2 - 1
for i in range(n // 2 - 1, -1, -1):
heapify(arr, n, i)
# Étapes 2 & 3 : Extraire l'élément supérieur (maximum) un par un et ajuster le tas
for i in range(n - 1, 0, -1):
# Échanger l'élément supérieur actuel (maximum) avec le dernier élément
arr[i], arr[0] = arr[0], arr[i]
# Ajuster les éléments restants pour en faire à nouveau un tas max, avec la taille du tas définie à i
heapify(arr, i, 0)
return arr
def heapify(arr, n, i):
"""
Ajuster le sous-arbre enraciné en i pour en faire un tas max
:param arr: tableau du tas
:param n: taille actuelle du tas
:param i: indice de la racine actuelle
"""
largest = i # Initialiser la valeur maximale comme racine
left = 2 * i + 1 # Indice de l'enfant gauche
right = 2 * i + 2 # Indice de l'enfant droit
# Si l'enfant gauche existe et est supérieur à la racine
if left < n and arr[left] > arr[largest]:
largest = left
# Si l'enfant droit existe et est supérieur au maximum actuel
if right < n and arr[right] > arr[largest]:
largest = right
# Si le maximum n'est pas la racine, échangez et ajustez récursivement le sous-tas brisé
if largest != i:
arr[i], arr[largest] = arr[largest], arr[i]
heapify(arr, n, largest)
# Test
test_data = [4, 10, 3, 5, 1]
print("Tableau d'origine :", test_data)
print("Après le tri par tas :", heap_sort(test_data.copy()))
Sortie :
原始数组: [4, 10, 3, 5, 1]
堆排序后: [1, 3, 4, 5, 10]
Analyse des performances:
- Complexité temporelleLes cas meilleur, pire et moyen sont tous O(n log n).
- Complexité spatiale: O(1), tri en place.
- Stabilité:instable。
Résumé de la comparaison des performances des algorithmes
Pour comparer plus intuitivement les caractéristiques des algorithmes ci-dessus, nous les résumons dans le tableau suivant :
| 算法 | Complexité temporelle moyenne | Complexité temporelle dans le pire des cas | Complexité spatiale | Stabilité | Fonctionnalités principales |
|---|---|---|---|---|---|
| Tri à bulles | O(n²) | O(n²) | O(1) | Stable | Simple, faible efficacité, adapté à l'enseignement. |
| Tri par sélection | O(n²) | O(n²) | O(1) | instable | Moins d'échanges, mais un nombre fixe et élevé de comparaisons. |
| Tri par insertion | O(n²) | O(n²) | O(1) | Stable | Efficace pour des données à petite échelle ou presque triées. |
| Tri rapide | O(n log n) | O(n²) | O(log n) | instable | Meilleure performance moyenne, est l'algorithme de tri le plus largement utilisé. |
| Tri par fusion | O(n log n) | O(n log n) | O(n) | Stable | Performances stables, mais nécessite de l'espace supplémentaire. Souvent utilisé pour le tri externe. |
| Tri par tas | O(n log n) | O(n log n) | O(1) | instable | Tri en place et O(n log n) même dans le pire des cas. |
Exercices pratiques
Après l'apprentissage théorique, la pratique concrète est le meilleur moyen de consolider les connaissances.
Exercice 1 : Choix et implémentation d'algorithmes
Étant donné les scénarios suivants, quel algorithme de tri choisiriez-vous ? Expliquez brièvement vos raisons.
- Trier un tableau contenant 10 nombres.
- Trier une liste chaînée de 1 million d'objets étudiants par identifiant étudiant, en exigeant la stabilité.
- Trier un grand tableau dans un système embarqué à mémoire limitée.
- Besoin d'obtenir les K plus grands éléments d'un flux de données en temps réel.
Approche de la réponse de référence:
- Tri par insertionPetite taille de données ; le tri par insertion est simple, adapté aux données presque triées, et a un faible facteur constant.
- Tri fusionGrande taille de données, un tri stable est requis, et la structure de liste chaînée permet de réaliser l'opération de fusion du tri fusion en espace O(1) (simplement en modifiant les pointeurs).
- Tri par tasMémoire limitée, un tri en place est nécessaire, et le tri par tas garantit une performance O(n log n) même dans le pire cas.
- Maintenir un tas min de taille KParcourez le flux de données et utilisez un tas pour maintenir les K plus grands éléments actuels. Ce n'est pas un tri complet, mais cela exploite les propriétés d'un tas.
Exercice 2 : Débogage et optimisation du code
Le tri à bulles ci-dessous a un petit bug et un endroit qui peut être optimisé ; veuillez les trouver et les corriger.
Exemple
n = len(arr)
for i in range(n):
for j in range(n - 1):
if arr[j] > arr[j]:
arr[j], arr[j+1] = arr[j+1], arr[j]
return arr
Indice:
- Condition de comparaison
arr[j] > arr[j]Toujours faux. - La borne de la boucle interne peut être optimisée, car après chaque tour, les éléments de fin sont déjà triés.
Exercice 3 : implémentation pratique
Essayez de l'implémenter vous-même à partir de zéroQuicksort, et réfléchissez :
- Si le benchmark
pivotQue se passe-t-il si le premier élément est toujours choisi comme pivot, lors du tri d'un tableau déjà trié ? - Comment modifier
partitionModifiez la fonction de partition pour qu'elle devienne un « tri rapide à trois voies », qui peut gérer plus efficacement les tableaux comportant de nombreux éléments dupliqués.