Lineare Datenstruktur
In diesem Kapitel stellen wir eine der grundlegendsten und am häufigsten verwendeten Arten von Datenstrukturen vor—lineare Datenstruktur。
Lineare DatenstrukturGenau wie eine Reihe von Menschen, die in einer Schlange stehen:
- Jede Person (Element) hat eine klare Vorher-Nachher-Beziehung
- Außer der ersten und der letzten hat jede Person einen Vorgänger und einen Nachfolger
- Die Datenelemente haben eine lineare Eins-zu-eins-Beziehung
Stell dir vor, du stehst in der Schlange, um Kaffee zu kaufen, oder ordnest Bücher in einem Regal.
Diese Szenarien haben eine Gemeinsamkeit: Elemente sind hintereinander angeordnet und bilden eine Linie.
In der Informatik ist eine solche geordnete Sammlung von Daten eine lineare Datenstruktur.
Die Eigenschaft einer linearen Datenstruktur ist: Außer dem ersten und letzten Element hat jedes Element genau einenVorgängerund einenNachfolger。
Häufige lineare Datenstrukturen:
- Array: wie eine Reihe nummerierter Schließfächer, jedes Schließfach hat eine feste Position
- Verkettete Liste: wie eine Kette von Menschen, die sich an den Händen halten, jede Person erinnert sich nur an die Personen vor und hinter sich
- Stack: Wie ein Stapel Teller, Elemente können nur oben entnommen und abgelegt werden
- Queue: Wie beim Anstehen zum Ticketkauf, wer zuerst kommt, wird zuerst bedient
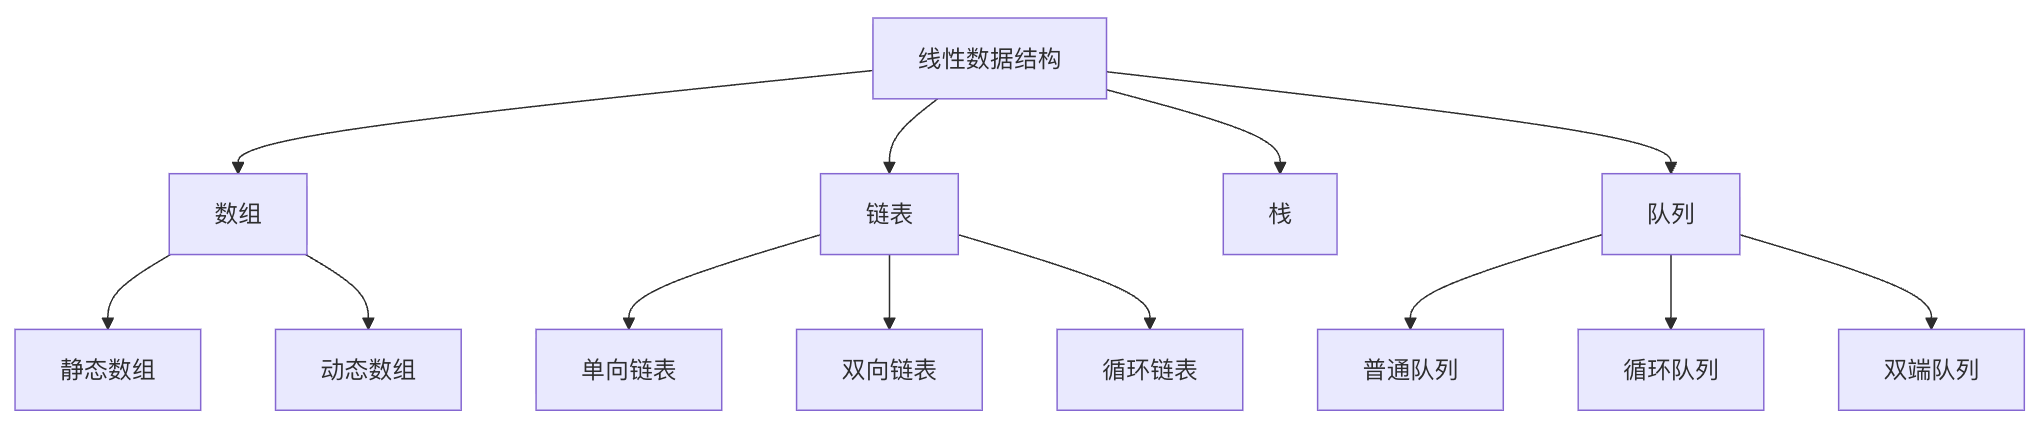
Die folgende Abbildung zeigt die Taxonomie linearer Datenstrukturen. Jede Struktur hat ihre spezifischen Anwendungsszenarien und Leistungsmerkmale:
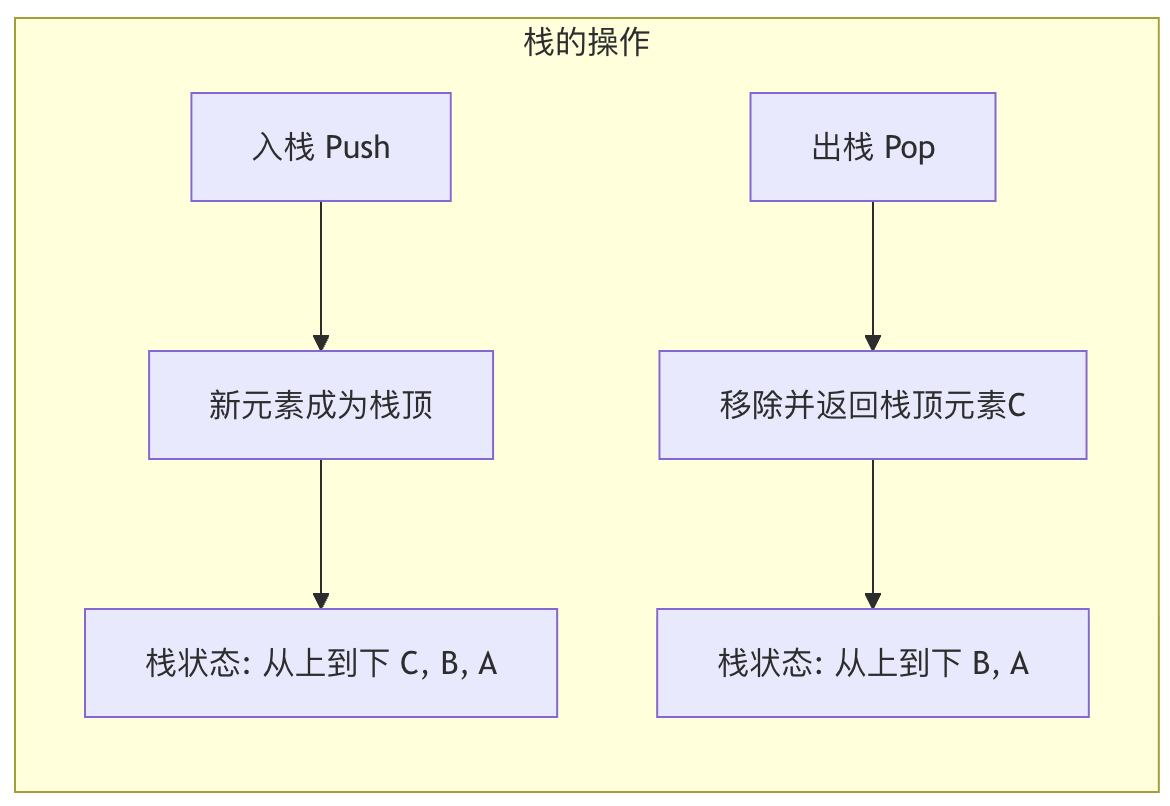
Die folgende Abbildung zeigt den grundlegenden Operationsablauf eines Stacks, der dem LIFO-Prinzip (Last In, First Out) folgt:

Array
Statisches Array
| Funktionen | Beschreibung | Zeitkomplexität |
|---|---|---|
| Zugriff auf Elemente | Direkter Zugriff über den Index | O(1) |
| Element einfügen | Nachfolgende Elemente müssen verschoben werden | O(n) |
| Element löschen | Nachfolgende Elemente müssen verschoben werden | O(n) |
| Speicherzuweisung | Feste Größe, vorab zugewiesen | O(1) |
Dynamisches Array
| Funktionen | Beschreibung | Zeitkomplexität |
|---|---|---|
| Zugriff auf Elemente | Direkter Zugriff über den Index | O(1) |
| Element einfügen | Kann Größenänderung und Kopieren erfordern | Durchschnittlich O(1), im schlimmsten Fall O(n) |
| Element löschen | Nachfolgende Elemente müssen verschoben werden | O(n) |
| Speicherzuweisung | Automatische Größenänderung | O(n) (bei Größenänderung) |
Verkettete Liste
Einfach verkettete Liste
| Aktion | Beschreibung | Zeitkomplexität |
|---|---|---|
| Zugriff auf Elemente | Muss vom Anfang aus durchlaufen werden | O(n) |
| Einfügen am Anfang | Direkte Einfügung | O(1) |
| Einfügen am Ende | Muss bis zum Ende durchlaufen werden | O(n) |
| Einfügung in der Mitte | Position muss zuerst gefunden werden | O(n) |
| Element löschen | Position muss zuerst gefunden werden | O(n) |
Doppelt verkettete Liste
| Aktion | Beschreibung | Zeitkomplexität |
|---|---|---|
| Zugriff auf Elemente | Muss vom Kopf oder Ende aus durchlaufen werden | O(n) |
| Einfügen am Anfang | Direkte Einfügung | O(1) |
| Einfügen am Ende | Direktes Einfügen (falls ein Endzeiger vorhanden ist) | O(1) |
| Einfügung in der Mitte | Position muss zuerst gefunden werden | O(n) |
| Element löschen | Position muss zuerst gefunden werden | O(n) |
Stapel
| Aktion | Beschreibung | Zeitkomplexität |
|---|---|---|
| push | Ein Element oben auf dem Stack hinzufügen | O(1) |
| pop | Das oberste Element des Stacks entfernen | O(1) |
| peek(Ansicht) | Das oberste Element des Stacks anzeigen | O(1) |
| isEmpty(Leerheitsprüfung) | Prüfen, ob der Stack leer ist | O(1) |
Warteschlange
| Aktion | Beschreibung | Zeitkomplexität |
|---|---|---|
| enqueue | Ein Element am Ende der Warteschlange hinzufügen | O(1) |
| dequeue | Das Kopfelement der Warteschlange entfernen | O(1) |
| front (vorderes Ende der Warteschlange anzeigen) | Das Kopfelement der Warteschlange anzeigen | O(1) |
| isEmpty(Leerheitsprüfung) | Prüfen, ob die Warteschlange leer ist | O(1) |
Vergleichsdiagramm linearer Datenstrukturen
Array: ein festes Wohnhaus für Daten
Arrays sind die einfachste und geradlinigste lineare Datenstruktur.
Wir können es uns als ein Gebäude vorstellenEin Wohnhaus mit einer festen Anzahl von Stockwerken。
Grundlegende Konzepte und Eigenschaften
- Zusammenhängende SpeicherungEin Array belegt einen zusammenhängenden Block im SpeicherZusammenhängendDer Speicherplatz ist wie Zimmer in einem Wohnhaus, die direkt nebeneinander liegen.
- Feste Größe: Die Kapazität (Länge) eines Arrays muss bei der Erstellung festgelegt werden und kann danach normalerweise nicht geändert werden, so wie die Anzahl der Zimmer in einem Wohnhaus feststeht, sobald es gebaut ist.
- Indexzugriff: Jedes Element (Zimmer) hat eine eindeutige Nummer, die manIndexnennt. In den meisten Programmiersprachen beginnt die Indizierung bei
0Beginnend bei. Sie können direkt und schnell über seinen Index auf jedes Element zugreifen, mit einer Zeitkomplexität vonO(1)。
Kernoperationen und Codebeispiele
Lassen Sie uns Arrays mit Python demonstrieren (in Python verwenden wir normalerweiselistum zu simulieren, aber beachten Sie, dass Pythonslistdie dynamisch ist) Kernoperationen.
Beispiel
apartment_building = ['Zimmer 101 - Zhang San', 'Zimmer 102 - Li Si', 'Zimmer 103 - Wang Wu', 'Zimmer 104 - unbesetzt', 'Zimmer 105 - unbesetzt']
print("Bewohner des Apartmenthauses:", apartment_building)
# 2. Auf Elemente zugreifen (über Index)
# Auf Zimmer 102 zugreifen
tenant = apartment_building[1] # Index beginnt bei 0, daher entspricht 1 dem zweiten Element
print(f"Der Bewohner von Zimmer 102 ist: {tenant}")
# 3. Elemente aktualisieren
# Ein neuer Bewohner Zhao Liu ist in Zimmer 104 eingezogen
apartment_building[3] = 'Zimmer 104 - Zhao Liu'
print("Nachdem Zhao Liu eingezogen ist:", apartment_building)
# 4. Elemente einfügen (das Hinzufügen am Ende ist relativ effizient, simuliert "Erweiterung")
# Angenommen, wir dürfen am Ende ein Zimmer 106 hinzufügen
apartment_building.append('Zimmer 106 - Sun Qi')
print("Nach dem Hinzufügen von Zimmer 106:", apartment_building)
# 5. Elemente löschen
# Wang Wu ist aus Zimmer 103 ausgezogen
# Methode 1: Als frei markieren (logisches Löschen)
# apartment_building[2] = 'Zimmer 103 - frei'
# Methode 2: Das Element entfernen; nachfolgende Elemente müssen nach vorne verschoben werden (physisches Löschen, relativ ineffizient)
removed_tenant = apartment_building.pop(2) # Entferne das Element an Index 2
print(f"{removed_tenant} ist ausgezogen.")
print("Nachdem Wang Wu ausgezogen ist:", apartment_building)
Ausgabe:
寓楼住户情况: ['101室-张三', '102室-李四', '103室-王五', '104室-空置', '105室-空置']
102室的住户是:102室-李四
赵六入住后: ['101室-张三', '102室-李四', '103室-王五', '104室-赵六', '105室-空置']
加盖106室后: ['101室-张三', '102室-李四', '103室-王五', '104室-赵六', '105室-空置', '106室-孙七']
103室-王五 已搬走。
王五搬走后: ['101室-张三', '102室-李四', '104室-赵六', '105室-空置', '106室-孙七']
Vorteile und Nachteile
| Vorteile | Nachteile |
|---|---|
| Schneller wahlfreier Zugriff: Jedes Element kann in konstanter Zeit über seinen Index erreicht werden. | Feste Größe: Sobald ein statisches Array erstellt wurde, ist seine Kapazität schwer zu ändern. |
| Hohe Speichereffizienz: Zusammenhängende Speicherung, kein zusätzlicher Speicherplatz zum Speichern von Beziehungen zwischen Elementen erforderlich. | Hohe Einfüge-/Löschkosten: Das Einfügen oder Löschen von Elementen in der Mitte erfordert das Verschieben vieler nachfolgender Elemente, um die Zusammenhängigkeit zu erhalten. |
Verkettete Liste: ein Schatzsuche-Zug für Daten
Wenn die feste Größe von Arrays und die Ineffizienz beim Einfügen/Löschen zum Problem werden, kommen verkettete Listen ins Spiel. Eine verkettete Liste ist wie ein ZugTrain, jeder Waggon (Knoten) trägt Fracht (Daten) und ist über eine Kupplung (Zeiger) mit dem nächsten Waggon verbunden.
Grundlegende Konzepte und Typen
Jeder Knoten der verketteten ListeKnotenenthält mindestens zwei Teile:
- DatenfeldSpeichert den tatsächlichen Datenwert.
- Zeigerfeld: Speichert die Adresse des nächsten Knotens im Speicher.
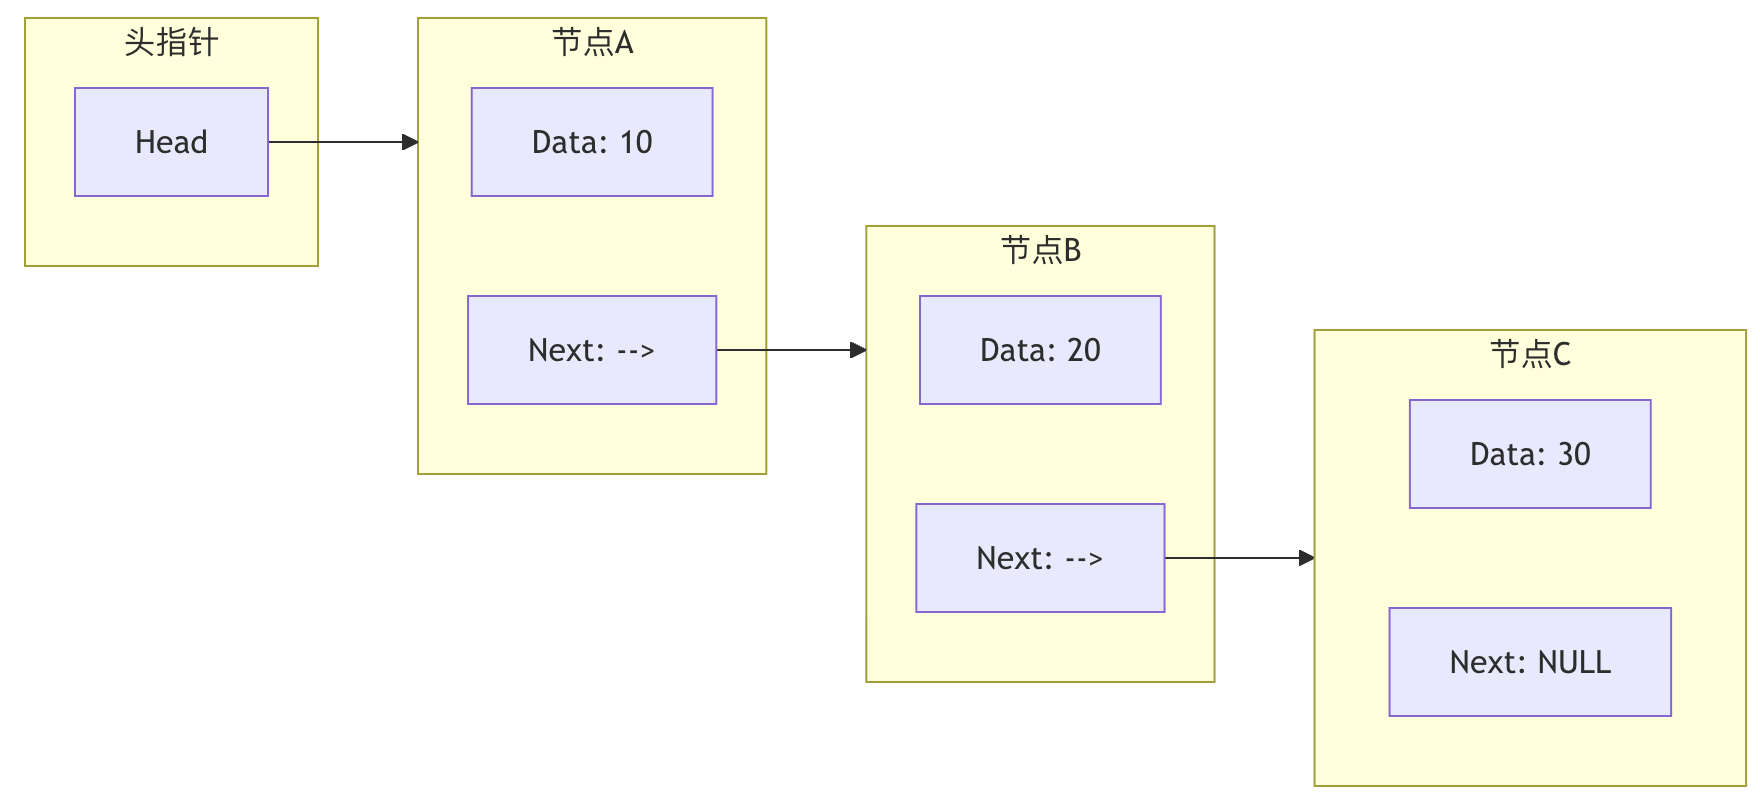
Die obige Abbildung zeigt eineeinfach verkettete ListeStruktur. Der Kopfzeiger zeigt auf den ersten Knoten, und jedes KnotensNextZeiger zeigt auf den nächsten Knoten, und der Zeiger des letzten KnotensNextZeigt aufNULLMarkiert das Ende der verketteten Liste.
Haupttypen von verketteten Listen:
- Einfach verkettete ListeDer Knoten zeigt nur auf den nächsten Knoten.
- Doppelt verkettete Liste: Knoten zeigen sowohl auf den vorherigen als auch auf den nächsten Knoten, was eine bidirektionale Traversierung ermöglicht.
- Zirkuläre verkettete Liste: Der Endknoten zeigt auf den Kopfknoten und bildet einen Ring.
Kernoperationen und Codebeispiele
Lass uns eine einfache, einfach verkettete Liste implementieren.
Beispiel
"""Definiere die Knotenklasse der verketteten Liste"""
def __init__(self, data):
self.data = data # Datenfeld
self.next = None # Zeigerfeld, zeigt anfangs auf null
class LinkedList:
"""Definiere eine Klasse für eine einfach verkettete Liste"""
def __init__(self):
self.head = None # Kopfzeiger der verketteten Liste
def append(self, data):
"""Füge einen Knoten am Ende der verketteten Liste hinzu"""
new_node = ListNode(data)
if not self.head: # Wenn die verkettete Liste leer ist, wird der neue Knoten zum Kopfknoten
self.head = new_node
return
last_node = self.head
while last_node.next: # Bis zum letzten Knoten durchlaufen
last_node = last_node.next
last_node.next = new_node # Den neuen Knoten am Ende anhängen
def prepend(self, data):
"""Fügt einen Knoten am Kopf der verketteten Liste hinzu"""
new_node = ListNode(data)
new_node.next = self.head
self.head = new_node
def delete(self, key):
"""Löscht den ersten Knoten mit dem Wert key"""
current_node = self.head
# Falls der zu löschende Knoten der Kopfknoten ist
if current_node and current_node.data == key:
self.head = current_node.next
current_node = None
return
prev_node = None
# Durchlaufen, um den zu löschenden Knoten zu finden
while current_node and current_node.data != key:
prev_node = current_node
current_node = current_node.next
if current_node is None: # Nicht gefunden
return
# Sobald gefunden, den Knoten überspringen, um die Verbindung herzustellen
prev_node.next = current_node.next
current_node = None
def print_list(self):
"""Alle Elemente der verketteten Liste ausgeben"""
current_node = self.head
while current_node:
print(current_node.data, end=" -> ")
current_node = current_node.next
print("NULL")
# Teste die verkettete Liste
print("=== Demo für Operationen mit einfach verketteter Liste ===")
train = LinkedList()
train.append("Wagen 1 - Kohle")
train.append("Wagen 2 - Holz")
train.prepend("Lokomotive") # Am Kopf einfügen
train.append("Wagen 3 - Stahl")
print("Anfänglicher Zug:")
train.print_list() # Ausgabe: Lokomotive -> Wagen 1 - Kohle -> Wagen 2 - Holz -> Wagen 3 - Stahl -> NULL
train.delete("Wagen 2 - Holz")
print("Nach dem Entladen des Holzes:")
train.print_list() # Ausgabe: locomotive -> carriage1-coal -> carriage3-steel -> NULL
Ausgabe:
=== 单向链表操作演示 ===
初始列车:
车头 -> 车厢1-煤炭 -> 车厢2-木材 -> 车厢3-钢材 -> NULL
卸下木材后:
车头 -> 车厢1-煤炭 -> 车厢3-钢材 -> NULL
Vorteile und Nachteile
| Vorteile | Nachteile |
|---|---|
| Dynamische Größe: Kein Bedarf, festen Speicherplatz vorab zuzuweisen; sie kann flexibel wachsen und schrumpfen. | Speicheraufwand: Jeder Knoten benötigt zusätzlichen Speicherplatz, um einen Zeiger zu speichern. |
| Effizientes Einfügen/Löschen: Wenn die Position eines Knotens bekannt ist, muss man nur Zeiger ändern, ohne viele Elemente zu verschieben. | Sequenzieller Zugriff: Anders als bei Arrays kann nicht direkt über den Index auf Elemente zugegriffen werden; man muss vom Kopf aus durchlaufen. |
| Cache-unfreundlich: Knoten sind im Speicher verstreut, was dem CPU-Cache-Prefetching nicht förderlich ist. |
Stack: Tellerstapel für Daten
Ein Stack ist eineLast-in, first-outDatenstruktur, wie gestapelte Teller in einem Restaurant, man nimmt immer den obersten (den zuletzt aufgelegten).
Grundlegende Konzepte und Operationen
Der Stack erlaubt Operationen nur an einem Ende (genanntStack-Spitze), um einzufügen (Push) und zu löschen (Pop) Operationen. Das andere Ende heißtStack-Boden。
Kernoperationen:
- push(data)Daten oben auf den Stapel legen.
- pop()Das oberste Element des Stapels entnehmen und zurückgeben.
- peek() / top()Das oberste Element des Stapels anzeigen, ohne es zu entnehmen.
- is_empty()Prüfen, ob der Stapel leer ist.
Anwendungsszenarien und Codebeispiele
Stapel werden in der Informatik äußerst häufig verwendet, z. B. Funktionsaufruf-Stapel, Vorwärts-/Rückwärtsnavigation im Browser, Auswertung von Ausdrücken, Klammerabgleich usw.
Beispiel
"""Liste verwenden, um Stapel zu implementieren"""
def __init__(self):
self.items = []
def push(self, item):
"""Einfügen"""
self.items.append(item) # Das Ende der Liste als Stapeloberseite verwenden
def pop(self):
"""Pop, gebe None zurück, wenn der Stack leer ist"""
if not self.is_empty():
return self.items.pop()
return None
def peek(self):
"""Peek auf das oberste Element"""
if not self.is_empty():
return self.items[-1]
return None
def is_empty(self):
"""Prüfe, ob der Stack leer ist"""
return len(self.items) == 0
def size(self):
"""Gib die Größe des Stacks zurück"""
return len(self.items)
# Anwendungsbeispiel: Klammerpaarungsprüfung
def is_balanced_parentheses(expression):
"""
Prüfe, ob die Klammern im Ausdruck übereinstimmen
Zum Beispiel: (()) ist balanciert, (() ist unbalanciert
"""
stack = Stack()
# Zuordnung der Klammerpaare
matching_bracket = {')': '(', ']': '[', '}': '{'}
for char in expression:
if char in '([{': # Wenn es eine linke Klammer ist, auf den Stack legen
stack.push(char)
elif char in ')]}': # Wenn es eine rechte Klammer ist
if stack.is_empty():
return False # Stack ist leer, also gibt es zu viele schließende Klammern
top_char = stack.pop()
if matching_bracket[char] != top_char: # Prüfen, ob sie übereinstimmen
return False
# Nach der Schleife sollte der Stack leer sein
return stack.is_empty()
# Stack- und Klammerabgleich testen
print("\n=== Stack- und Klammerabgleich-Demo ===")
plate_stack = Stack()
plate_stack.push("Teller 1")
plate_stack.push("Teller 2")
plate_stack.push("Teller 3")
print(f"Nimm den obersten Teller heraus: {plate_stack.pop()}") # Ausgabe: Teller 3
print(f"Jetzt ist der oberste Teller: {plate_stack.peek()}") # Ausgabe: Teller 2
# Klammerabgleich testen
test_cases = ["((1+2)*3)", "({[ ]})", "((())", ")( )"]
for test in test_cases:
result = ausgeglichen if is_balanced_parentheses(test) else unausgeglichen
print(fDie Klammern im Ausdruck '{test}' sind {result}.)
Ausgabe:
=== 栈与括号匹配演示 ===
取出最上面的盘子: 盘子3
现在最上面的盘子是: 盘子2
表达式 '((1+2)*3)' 的括号是 平衡 的。
表达式 '({[ ]})' 的括号是 平衡 的。
表达式 '((())' 的括号是 不平衡 的。
表达式 ')( )' 的括号是 不平衡 的。
Warteschlange: ein Warteschlangenkanal für Daten
Eine Warteschlange ist eineFirst-In-First-OutDatenstruktur, wie an jedem Ort im Leben, an dem man anstehen muss (z. B. Supermarktkasse), werden die zuerst Ankommenden zuerst bedient.
Grundlegende Konzepte und Operationen
Die Warteschlange ermöglicht an einem Ende (genanntEnde) das Einfügen (Enqueue) von Operationen und am anderen Ende (genanntKopf) das Löschen (Dequeue) einer Operation.
Kernoperationen:
- enqueue(data)Fügt Daten am Ende der Warteschlange hinzu.
- dequeue()Entfernt Daten vom Kopf der Warteschlange und gibt sie zurück.
- front() / peek()Zeigt die Daten am Kopf der Warteschlange an, ohne sie zu entfernen.
- is_empty()Prüft, ob die Warteschlange leer ist.
Anwendungsszenarien und Codebeispiele
Warteschlangen werden häufig in Szenarien verwendet, in denen Aufgaben in der Reihenfolge verarbeitet werden müssen, z. B.: Warteschlangen für Druckaufträge, Nachrichtenwarteschlangen, Breitensuche usw.
Beispiel
class Queue:
"""Implementiere eine Warteschlange mit collections.deque"""
def __init__(self):
self.items = deque()
def enqueue(self, item):
"""Einreihen"""
self.items.append(item) # Von rechts hinzufügen (Ende)
def dequeue(self):
"""Ausreihen, gibt None zurück, wenn die Warteschlange leer ist"""
if not self.is_empty():
return self.items.popleft() # Von links entfernen (Kopf)
return None
def front(self):
"""Das vorderste Element ansehen"""
if not self.is_empty():
return self.items[0]
return None
def is_empty(self):
"""Prüfen, ob die Warteschlange leer ist"""
return len(self.items) == 0
def size(self):
"""Gibt die Größe der Warteschlange zurück"""
return len(self.items)
# Anwendungsbeispiel: Simulieren von Druckaufträgen
print("\n=== Warteschlangen- und Druckauftragssimulation ===)
printer_queue = Queue()
# Simuliere das Eintreffen von drei Druckaufträgen
tasks = ["Alices Lebenslauf.pdf", "Bobs Bericht.doc", "Charlies Diagramm.png"]
for task in tasks:
printer_queue.enqueue(task)
print(f"Auftrag '{task}' wurde zur Druckwarteschlange hinzugefügt.")
# Druckaufträge verarbeiten
print("\nDruckvorgang starten...)
while not printer_queue.is_empty():
current_task = printer_queue.dequeue()
print(f"Druckvorgang: {current_task}")
# Druckzeit simulieren
print("Alle Druckaufträge wurden abgeschlossen.")
Ausgabe:
=== 队列与打印任务模拟 ===
任务 'Alice的简历.pdf' 已加入打印队列。
任务 'Bob的报告.doc' 已加入打印队列。
任务 'Charlie的图表.png' 已加入打印队列。

开始打印...
正在打印: Alice的简历.pdf
正在打印: Bob的报告.doc
正在打印: Charlie的图表.png
所有打印任务已完成。
Zusammenfassung und Vergleich
Wir haben vier grundlegende lineare Datenstrukturen kennengelernt. Die folgende Tabelle hilft dir, ihre Kernmerkmale schnell zu überprüfen und zu vergleichen:
| Funktionen | array | Verkettete Liste | Stapel | Warteschlange |
|---|---|---|---|---|
| Speichermethode | Zusammenhängender Speicher | Verstreuter Speicher, über Zeiger verbunden | Implementiert auf Basis von Arrays oder verketteten Listen | Implementiert auf Basis von Arrays oder verketteten Listen |
| Zugriffsmethode | Wahlfreier Zugriff (über Index) | Sequenzieller Zugriff (muss durchlaufen werden) | Beschränkt auf die Spitze des Stapels (LIFO) | Beschränkt auf den Kopf der Warteschlange (FIFO) |
| Effizienz beim Einfügen/Löschen | Schnell am Ende, langsam in der Mitte/am Kopf (erfordert Verschieben von Elementen) | Schnell, wenn die Position bekannt ist (nur Zeiger müssen geändert werden) | Operationen an der Stapelspitze, O(1) | Anfügen am Ende, Entfernen am Kopf, O(1) |
| Size | Fest (statisches Array) | Dynamisch | Dynamisch | Dynamisch |
| Hauptanwendungen | Schnelles Nachschlagen, feste Sammlung | Häufiges Einfügen/Löschen, unbestimmte Größe | Funktionsaufrufe, Backtracking, Klammerabgleich | Aufgabenplanung, Pufferung, BFS |
Wie soll man wählen?
- erfordertschnellen wahlfreien Zugriffund wenn die Datenmenge bekannt ist, wähleArray。
- erforderthäufiges Einfügen oder Löschen an beliebigen Positionenvon Elementen, und wenn die Datenmenge stark variiert, wähleverkettete Liste。
- Müssen Sie"Undo"-Funktion implementieren oderRückwärtsverarbeitungWenn Sie in Reihenfolge vorgehen, ziehen SieStack in Betracht。
- Müssen Sie"First come, first served"bei der Verarbeitung von Aufgaben in Reihenfolge einhalten, verwenden SieQueue。