データ構造とアルゴリズム入門
コンピュータサイエンスにおいて、データ構造とアルゴリズムは効率的で信頼性の高いソフトウェアを構築するための中核となる基盤です。これらはプログラマーが複雑な問題を解決するためのツールボックスであり、プログラムの実行速度とリソース消費を決定します。
想像してみてください。あなたが乱雑な本棚を整理しているとします。ただ本を適当に積み上げただけでは、特定の本を見つけるのは非常に困難です。しかし、書名の頭文字で並べたり、カテゴリー(小説、歴史、科学など)で分類したりすれば、探す効率は大幅に向上します。データ構造本棚を整理する方法のようなもので、データをどのように組織化し保存すべきかを定義します。一方、アルゴリズムは、本を探す、挿入する、削除する具体的な手順です。
データ構造とアルゴリズムはコンピュータサイエンスの基盤となる能力であり、データをどのように組織化するか、問題をどのように効率的に解決するかという2つのことを解決するために使われます。
データ構造
メモリやストレージにおけるデータの組織化の方法と、効率的にアクセス・変更する方法を研究します。中核となる目標は、時間と空間のコストを削減することです。
一般的な種類:
- 線形構造:配列、連結リスト、スタック、キュー
- 非線形構造:木、グラフ、ヒープ、ハッシュテーブル
アルゴリズム
問題を解決するための手順と戦略を研究し、本質は計算プロセスの抽象化です。評価基準は2つだけです:時間計算量、空間計算量。
一般的な分類:
- 基礎アルゴリズム:走査、再帰、分割統治
- ソートと探索:クイックソート、マージソート、二分探索
- 高度な戦略:貪欲法、動的計画法、バックトラッキング
関係
データ構造はどう保存するかを決定し、アルゴリズムはどう計算するかを決定します。同じ問題でも、構造が異なれば、アルゴリズムの複雑さは大きく異なる可能性があります。
データ構造
データ構造は、コンピュータがデータを保存・組織化する方法です。
データ構造は、1つまたは複数の特定の関係を持つデータ要素の集合を実現し、さらにこれらのデータ上で定義される一連の操作を定義することを目的としています。
中核概念
- データ: コンピュータが認識、保存、処理できる記号の集合。例:数字、文字など。
- データ要素: データの基本単位であり、プログラム内では通常、一つのまとまりとして考えられ処理されます。
- データ項目: データ要素を構成する、独立した意味を持ち、分割できない最小単位。
- データ構造: 相互に1つまたは複数の特定の関係が存在するデータ要素の集合。
データ構造の分類
データ構造は主に2つの大きなカテゴリに分けられます:論理構造と物理構造。
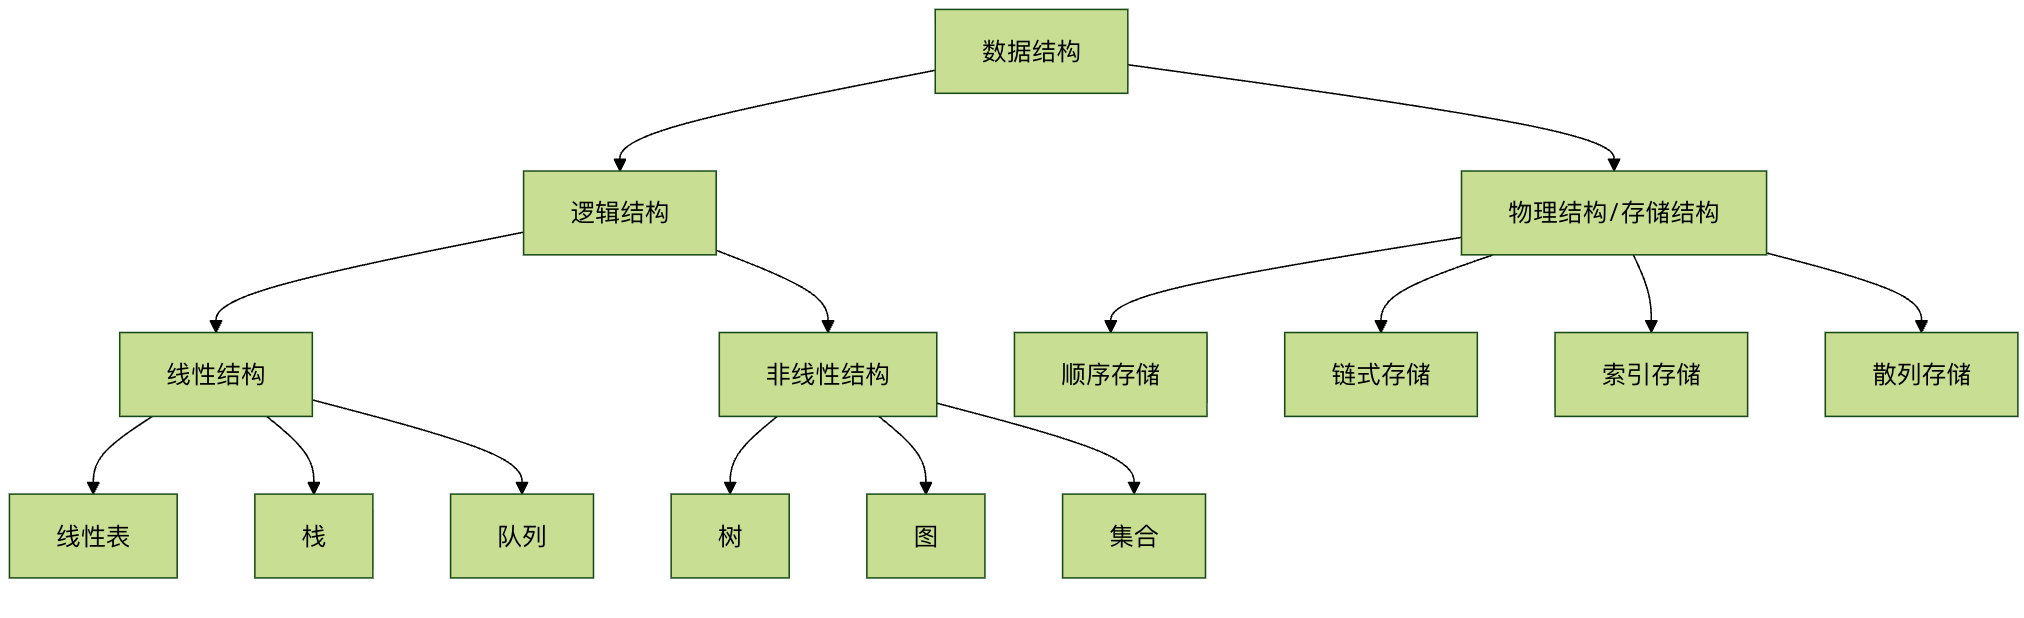
論理構造データ要素間の抽象的な関係を記述し、コンピュータでの実現方法には関係ありません。主に次のように分けられます:
- 線形構造: データ要素間に「1対1」の線形関係が存在します。例:配列、連結リスト、スタック、キュー。
- 非線形構造: データ要素間に「1対多」または「多対多」の複雑な関係が存在します。例:木、グラフ、集合。
物理構造(記憶構造とも呼ばれる)コンピュータのメモリ内でのデータの実際の保存方法を記述します。主に次のように分けられます:
- 順次記憶(連続記憶): 論理的に隣接する要素を、物理的位置も隣接する記憶領域に保存します。例:配列。
- チェーン記憶(連結記憶): 論理的に隣接する要素が物理的位置でも隣接している必要はなく、要素間の論理関係は付加的なポインタによって表現されます。例:連結リスト。
アルゴリズム
アルゴリズムは、特定の問題を解決するための、明確で有限な一連の命令手順です。
有効なアルゴリズムは、以下の5つの特性を備えている必要があります:
- 有限性: アルゴリズムは有限の手順を実行した後に終了しなければなりません。
- 決定性: アルゴリズムの各ステップは明確に定義されており、曖昧さが生じてはなりません。
- 実現可能性: アルゴリズムの各ステップは、すでに実装されている基本演算を有限回実行することで実現できます。
- 入力: アルゴリズムには、0個以上の入力があります。
- 出力: アルゴリズムには、1個以上の出力があります。出力は入力と特定の関係を持つ量です。
アルゴリズムの評価基準:時間計算量と空間計算量
アルゴリズムの良し悪しをどのように判断するのでしょうか?通常、時間と空間の2つの次元から測定します。
- 時間計算量: アルゴリズムの実行時間を定性的に記述します。問題の規模 n が大きくなるにつれて、アルゴリズムの実行時間の増加傾向を示します。一般的にオーダー記法(大O記法)で表されます。
- 空間計算量: アルゴリズムが実行中に一時的に占有する記憶領域の大きさを定性的に記述します。同様にオーダー記法(大O記法)で表されます。
一般的な時間計算量の比較
次の表は、データ規模の増加に伴うさまざまな時間計算量の傾向を示しています:
| 複雑さの表記 | 名称 | 例(n=10 vs n=1000) | 説明 |
|---|---|---|---|
| O(1) | 定数階 | 1ステップ vs 1ステップ | 効率が最も高く、問題の規模に関係ない |
| O(log n) | 対数階 | ~3ステップ vs ~10ステップ | 効率が非常に高い。例:二分探索 |
| O(n) | 線形階 | 10ステップ vs 1000ステップ | 効率は良好。例:配列の走査 |
| O(n log n) | 線形対数階 | ~30ステップ vs ~10000ステップ | 効率は比較的良い。例:クイックソート |
| O(n²) | 平方階 | 100ステップ vs 1,000,000ステップ | 効率は低め。例:単純選択ソート |
| O(2ⁿ) | 指数階 | 1024ステップ vs 天文学的な数字 | 効率が極めて低く、できるだけ避けるべき |
簡単に理解するには: 私たちが目指すのは、データ量 n が増えるにつれて、処理時間の増加が遅いアルゴリズムです。O(1) と O(log n) は優れており、O(n) は許容可能、O(n²) 以上はデータ量が多い場合に最適化が必要です。
代表的なデータ構造とアルゴリズムの例
具体的な問題を通して、データ構造とアルゴリズムの応用を実感してみましょう。
問題: 順序がバラバラな数値のリストの中に、特定の目標の数値が存在するかどうかを素早く見つける。
方法1:線形探索(配列を使用)
これは直感的ですが非効率な方法です。
- データ構造: 配列(順次記憶の線形リスト)。
- アルゴリズム: 最初の要素から順に目標値と比較し、見つかるか全要素を走査し終えるまで続けます。
- 時間計算量: O(n)。最悪の場合、すべての n 個の要素をチェックする必要があります。
例
def linear_search(arr, target):
"""
配列 arr 内で目標値 target を線形探索します。
引数:
arr: 探索対象のリスト
target: 探索する目標値
戻り値:
見つかった場合はそのインデックスを返し、見つからない場合は -1 を返します。
"""
for i in range(len(arr)): # 配列の各要素を走査する
if arr[i] == target: # 現在の要素が目標値と等しい場合
return i # 現在のインデックスを返す
return -1 # 走査が完了しても見つからない場合、-1 を返す
# テストデータ
test_data = [12, 45, 67, 89, 34, 23, 90, 11]
target_number = 34
# 探索を実行
result = linear_search(test_data, target_number)
# 結果を出力
if result != -1:
print(f"目標の数値 {target_number} の配列内のインデックスは:{result}")
else:
print(f"配列内に目標の数値 {target_number} が見つかりません")
出力結果:
目标数字 34 在数组中的索引是:4
方法2:二分探索(ソート済み配列を使用)
これは効率的な方法ですが、データがソートされていることが前提です。
- データ構造: ソート済み配列。
- アルゴリズム:
- 目標値と配列の中央の要素を比較します。
- 等しければ、見つかりました。
- 目標値がより小さければ、配列の左半分で手順1を繰り返します。
- 目標値がより大きければ、配列の右半分で手順1を繰り返します。
- 探索範囲が空なら、見つかりませんでした。
- 時間計算量: O(log n)。各比較で探索範囲が半分に縮小されます。
例
def binary_search(sorted_arr, target):
"""
ソート済みの配列 sorted_arr 内で目標値 target を二分探索します。
パラメータ:
sorted_arr: ソート済みリスト(昇順)
target: 検索する目標値
戻り値:
見つかった場合はそのインデックスを返し、見つからない場合は -1 を返します。
"""
left, right = 0, len(sorted_arr) - 1 # 探索範囲を配列全体に初期化
while left <= right: # 範囲が有効な間、探索を続ける
mid = (left + right) // 2 # 中央のインデックスを計算
if sorted_arr[mid] == target: # 目標値が見つかった
return mid
elif sorted_arr[mid] < target: # 目標値は右半分にある
left = mid + 1
else: # 目標値は左半分にある
right = mid - 1
return -1 # 範囲が無効、見つからなかった
# テストデータ(ソート済みである必要がある)
test_data = [12, 45, 67, 89, 34, 23, 90, 11]
sorted_test_data = sorted(test_data) # テストデータをソート
print(fソート済み配列:{sorted_test_data})
target_number = 34
# 検索を実行
result = binary_search(sorted_test_data, target_number)
# 結果を出力
if result != -1:
print(f目標数字 {target_number} のソート済み配列内のインデックスは:{result})
else:
print(fソート済み配列内に目標数字 {target_number} が見つかりませんでした)
出力結果:
有序数组:[11, 12, 23, 34, 45, 67, 89, 90]
目标数字 34 在有序数组中的索引是:3
比較と考察:
- 当
n=1000このとき、線形探索は最大で 1000 回の比較が必要ですが、二分探索は最大で約 10 回の比較で済みます(2^10 ≈ 1024 のため)。 - 二分探索は線形探索よりもはるかに効率的ですが、データが事前にソートされている必要があります。ソート自体にもコストがかかるため、どちらのアルゴリズムを選択するかは具体的なシナリオによります(例えば、データが静的で検索が頻繁なのか、動的で挿入が頻繁なのか)。
どのように学習を始めるか?
データ構造とアルゴリズムの学習は段階的に進めるプロセスです。以下の手順で進めることをお勧めします:
- プログラミング言語を1つ習得する: まず、アイデアを実現するためのツールが必要です。Python、Java、C++ が良い選択肢です。Python は構文が簡潔で、初学者がアルゴリズムのロジック自体に集中するのに適しています。
- 基礎的なデータ構造から始める:
- 配列 / リスト: 最も基礎的で一般的に使われる順次格納構造です。
- リンクリスト(連結リスト): ポインタ/参照と動的メモリ割り当てを理解するための鍵です。
- スタックとキュー: 「後入れ先出し(LIFO)」と「先入れ先出し(FIFO)」という操作が制限された線形リストを理解します。
- 基礎的なアルゴリズムの考え方を学ぶ:
- ソートアルゴリズム: バブルソート、選択ソート、挿入ソート(O(n²) を理解)、次にマージソート、クイックソートを学びます(O(n log n) と分割統治法を理解)。
- 探索アルゴリズム:線形探索(逐次探索)、二分探索。
- 非線形構造に挑戦する:
- 树: 二分木、特に二分探索木を重点的に学びます。木の走査(前順、中順、後順)を理解します。
- 图: グラフの表現方法(隣接行列、隣接リスト)と基本的な走査アルゴリズム(深さ優先探索 DFS、幅優先探索 BFS)を理解します。
- 実践と問題演習: LeetCode、牛客網(Nowcoder)などのプラットフォームで簡単な問題から練習し、理論を実践に応用します。これは知識を定着させ、思考力を鍛える最良の方法です。