Agent Context Engineering
Agent 上下文工程(Agent Context Engineering) — это техническая практика систематического проектирования и оптимизации контекстной информации, передаваемой AI-агентам. Её цель — позволить агентам получать наиболее эффективную информацию в рамках ограниченного контекстного окна, тем самым повышая точность, эффективность и надёжность выполнения задач.
В отличие от традиционных программ, у AI-агентов нет фиксированной логики выполнения; их поведение полностью определяется получаемым контекстом — включая системные промпты, описания инструментов, историю диалога и внешне извлечённую информацию.
Суть контекстной инженерии — ответить на вопрос:что агенту нужно знать больше всего в этом раунде вызова?
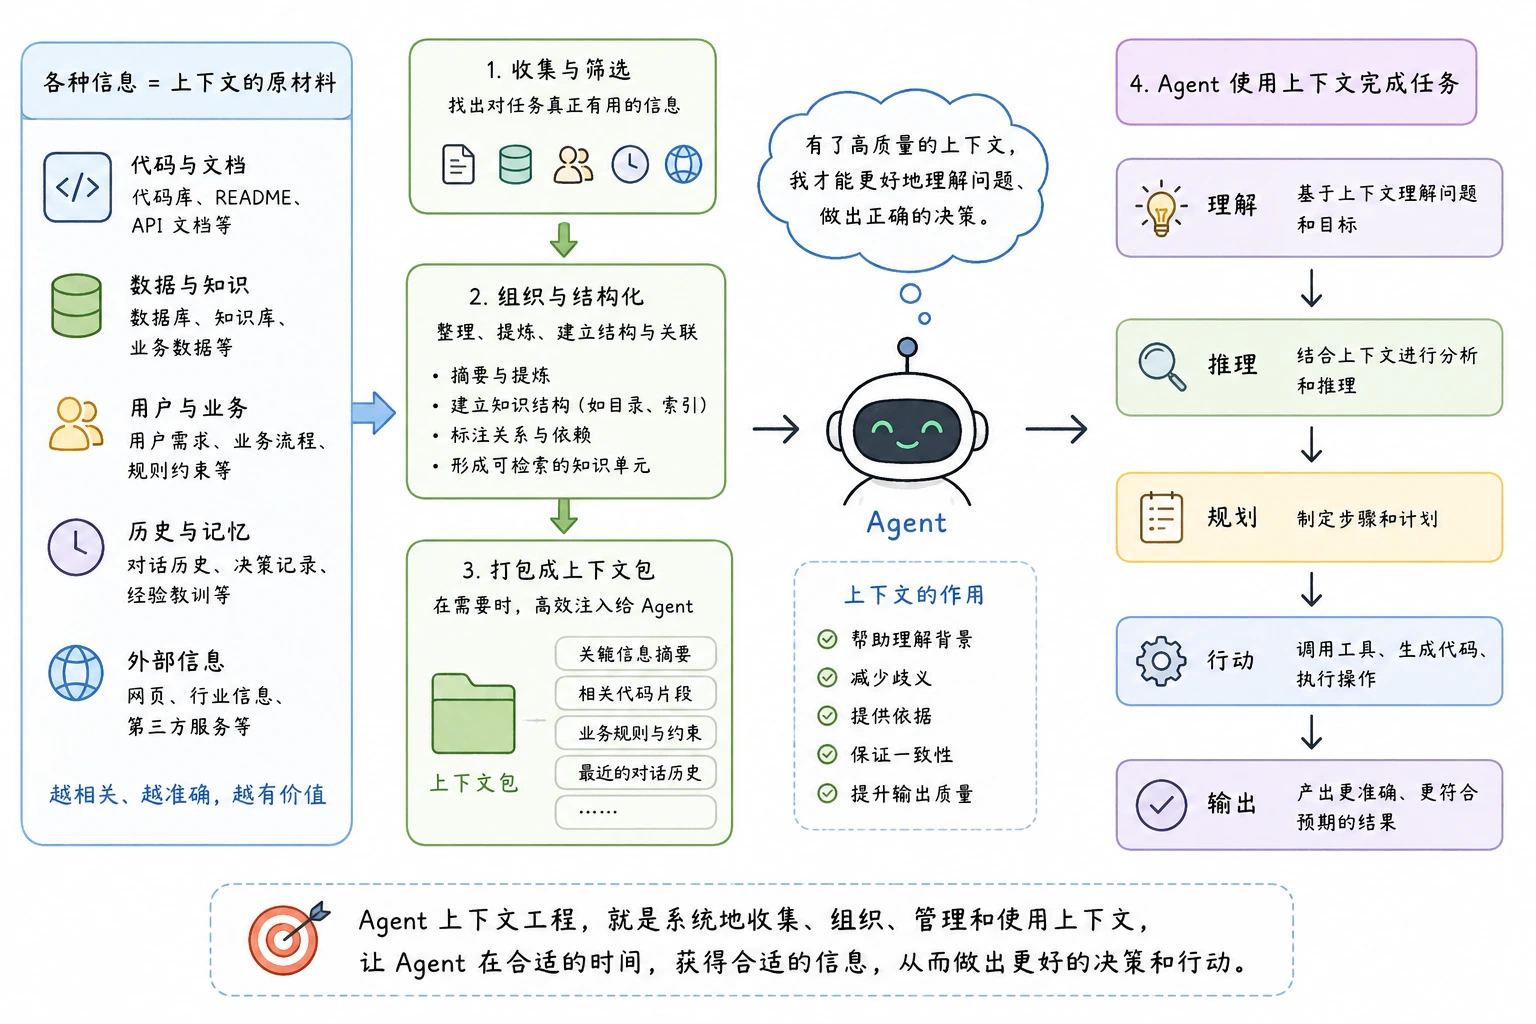
Контекстная инженерия — это не однократное написание промпта, а непрерывный процесс оптимизации, проходящий через весь жизненный цикл разработки, тестирования и эксплуатации агентной системы.
Ключевые элементы
Контекст агента состоит из следующих слоёв:
| Слой | Содержание | Характеристики |
|---|---|---|
| Системный промпт | Определение роли, правила поведения, требования к формату вывода | Передаётся при каждом вызове, относительно стабилен |
| Определения инструментов | Имена, параметры и описания функций доступных инструментов | Потребляет большое количество токенов, требует краткости |
| История | Записи разговора и вызовов инструментов текущей сессии | Непрерывно растёт, требуются стратегии усечения или суммирования |
| Извлечённый контекст | Содержимое, извлечённое из внешних баз знаний или репозиториев кода | Внедряется по требованию, требует ранжирования по релевантности |
| Пользовательский ввод | Текущая инструкция или вопрос пользователя | Неконтролируемо, но может быть оптимизировано через уточнение |
Ключевые практики
Управление бюджетом контекста
Рассматривайте контекстное окно как конечный "бюджет" и разумно распределяйте его между различными типами контекста.
Не вся информация заслуживает того, чтобы занимать место в контексте; каждый фрагмент контекста должен иметь чёткую ROI.
上下文预算分配建议(以 200K token 窗口为例):

系统提示  ██████████ 10% (20K token)
工具定义  ████████████████ 20% (40K token)
检索上下文 ████████████████████ 25% (50K token)
历史记录  ████████████████████████ 30% (60K token)
用户输入  ████████ 5%~10% (10-20K token)
预留缓冲  ████ 5% (10K token)
Фактическую пропорцию следует динамически корректировать в зависимости от конкретного типа задач агента.
Если Agent в основном занимается генерацией кода, можно увеличить долю извлечённого контекста.
Если Agent — многоходовой диалоговый ассистент, следует отдать приоритет бюджету исторических записей.
Инженерия системных промптов
Системный промпт — это краеугольный камень поведения Agent, и при его написании следует придерживаться структурированных принципов.
Принципы написания:
| Принцип | Описание | Пример |
|---|---|---|
| Иерархическая организация | Разделяйте инструкции на блоки по роли, правилам, процессу и формату | Отделяйте их заголовками Markdown |
| Позитивные формулировки | Говорите Agent, что делать, а не чего не делать | «Отвечай кратко» лучше, чем «не будь многословным» |
| Приводите примеры | Используйте few-shot примеры вместо длинных описаний | Примеры формата вывода эффективнее текстовых описаний |
| Чёткие приоритеты | Какому правилу должен следовать Agent при конфликте правил | «Правила безопасности имеют приоритет над требованиями эффективности» |
| Удаляйте избыточность | Удаляйте правила, которые никогда не срабатывают, и дублирующиеся инструкции | Регулярно пересматривайте и упрощайте системный промпт |
Ниже приведён пример скелета структурированного системного промпта:
## 角色
你是一名 Python 代码审查助手。

## 核心规则
- 每个问题附上修复建议
- 按严重程度排序输出
- 不确定时标注「待确认」

## 工作流程
1. 分析代码变更
2. 按严重程度分类问题
3. 逐一输出问题与建议

## 输出格式
**问题**:[问题描述]
**严重程度**:[高/中/低]
**建议**:[修复建议]
Оптимизация описаний инструментов
Описания инструментов часто занимают наибольшую долю контекста, но многие инструменты фактически никогда не вызываются.
Стратегии оптимизации включают:
| Стратегия | Метод | Эффект |
|---|---|---|
| Сокращение числа инструментов | Удалите определения инструментов, не относящихся к текущей задаче | Сократите контекст инструментов на 30%~50% |
| Краткие описания | Опишите назначение и параметры каждого инструмента одним предложением | Повысьте точность понимания инструментов моделью |
| Ограничения параметров | Уточните в описании сценарии использования и ограничения параметров | Сократите ошибки параметров при вызовах инструментов |
| Групповая регистрация | Динамически регистрируйте разные наборы инструментов по этапам задачи | Избегайте «сложности выбора», вызванной слишком большим числом инструментов |
Любое ненулевое определение инструмента — это нагрузка. Каждый сохранённый инструмент требует компромисса между качеством описания и стоимостью в токенах.
Стратегии сжатия истории
В многоходовых диалогах история быстро растёт и расходует контекст.
Необходимо выбрать подходящую стратегию сжатия, чтобы сбалансировать полноту контекста и ограничения окна.
常见历史压缩策略对比:

策略     方法            适用场景
─────────────────────────────────────────────────
滑动窗口   保留最近 N 轮完整记录    短对话、实时交互
阶梯摘要   每轮做一次增量摘要     长对话、客服场景
分层摘要   近期保留完整、远期做摘要  文档生成、复杂任务
关键轮标记  标记重要轮次,其余丢弃   调试、分步执行任务
Иерархическое суммирование — наиболее часто используемая стратегия: сохраняйте последние 3-5 ходов полностью, а более ранние диалоги заменяйте структурированными сводками.
Структурированная сводка должна содержать ключевую информацию исходного диалога: какова была цель пользователя, что сделал Agent, какой вывод он получил и с какими ошибками столкнулся.
Контроль качества извлечённого контекста
Когда Agent полагается на внешнюю базу знаний, качество извлечённого контекста напрямую определяет качество вывода.
Ключевые моменты для повышения качества извлечённого контекста:
| Этап | Типичные проблемы | Методы улучшения |
|---|---|---|
| Переформулирование запроса | Пользовательский ввод недостаточно точен | Пусть Agent переформулирует запрос перед извлечением |
| Фильтрация по релевантности | Результаты извлечения содержат нерелевантный контент | Задайте порог релевантности и проактивно предупреждайте, когда он не достигнут |
| Аннотирование источников | Agent не может оценить достоверность информации | Прикрепляйте путь к источнику и время обновления |
| Сокращение длины | Результаты извлечения занимают слишком много контекста | Обрезайте по абзацам, сохраняя наиболее релевантные фрагменты |
Типовые паттерны
Постепенное раскрытие
Вместо того чтобы сразу втискивать всю информацию в контекст, раскрывайте её постепенно в соответствии с этапом выполнения.
Начальный контекст содержит только системный промпт и инструменты, необходимые для текущего этапа. После того как Agent завершит текущий этап, внедряются инструменты и правила для следующего этапа.
Этот режим удерживает «плотность» контекста в разумных пределах, не позволяя Agent отвлекаться на нерелевантную информацию.
Цепочка сжатия контекста
Когда задача требует обработки больших объёмов данных, разбейте её на несколько шагов с помощью цепочки вызовов, сохраняя на каждом шаге только ключевые промежуточные результаты.
步骤1:读取全部日志文件 → 输出 { 错误数量,时间范围,错误类型列表 }

步骤2:基于步骤1的输出,分析 Top 3 错误 → 输出 { 根因分析,修复建议 }

步骤3:基于步骤2的输出,生成修复 PR → 输出 { PR 标题,描述,代码变更 }
Вход каждого звена — это уточнённая сводка предыдущего шага, а не необработанные данные, что позволяет постоянно удерживать контекст в контролируемом размере.
Водяные знаки в контексте
Размещайте маркеры-«водяные знаки» в ключевых позициях контекста, чтобы помочь отслеживать и диагностировать поведение Agent.
上下文水印示例:

<system-reminder>
当前使用的上下文策略版本:v2.3
检索到的文档来源:docs/api-reference/ 共 3 个文件
已消耗上下文:85,000 / 200,000 tokens
</system-reminder>
Эти водяные знаки не влияют напрямую на поведение Agent, но при отладке они позволяют быстро определить, была ли инъекция контекста выполнена должным образом.
Оценка и итерации
Эффективность инженерии контекста необходимо проверять с помощью оценки, её нельзя определять только интуицией.
Обычно используемые измерения оценки:
| Измерение | Метод оценки | Ключевые метрики |
|---|---|---|
| Доля выполнения задач | Запускать Agent на стандартном тестовом наборе | Доля успешных запусков, распределение причин неудач |
| Эффективность использования контекста | Подсчитывать использование контекста при каждом вызове | Среднее потребление токенов, коэффициент использования контекста |
| Качество вызовов инструментов | Анализировать точность вызовов инструментов и долю корректных параметров | Доля недопустимых вызовов, число повторных попыток |
| Согласованность ответов | Многократные тесты с одним и тем же входом | Стабильность вывода, коэффициент соблюдения формата |
Контекстная инженерия — это не одноразовая настройка; она требует создания итеративного цикла «тест → анализ → оптимизация → повторный тест».
Примечания
Большее контекстное окно не всегда лучше. Избыточный контекст может рассеивать внимание модели на ключевой информации и фактически снижать качество вывода.
Слепое добавление правил может сделать системные промпты раздутыми и самопротиворечивыми. Каждое новое правило необходимо проверять на конфликты с существующими правилами.
Изменения в определениях инструментов могут повлиять на поведение существующих агентов. После модификации следует провести регрессионное тестирование в типичных сценариях.
Стратегию сжатия истории нужно выбирать исходя из характеристик задач агента; ни одна стратегия не может быть оптимальной во всех сценариях.
Конфиденциальная информация в контексте (API-ключи, внутренние пути и т.д.) может распространяться через вызовы инструментов и логи, поэтому необходима надлежащая десенсибилизация.
Связанные концепции
| Концепция | Описание |
|---|---|
| Промпт-инжиниринг | Фокус на проектировании и оптимизации промпта для одного вызова |
| Контекстное окно | Максимальное количество токенов, которое модель может обработать за раз |
| Токен | Наименьшая семантическая единица текста, обрабатываемая моделью |
| RAG (генерация с дополненной выборкой) | Архитектурный шаблон, расширяющий контекст через внешний поиск |
| Few-shot промптинг | Предоставление примеров в контексте для управления выводом модели |
| Chain-of-Thought | Позволяет модели показать процесс рассуждения в контексте |