Архитектура агента
Агент (интеллектуальный агент) — это ИИ-система, которая может автономно воспринимать окружающую среду, рассуждать и предпринимать действия для достижения целей.
От простейшего цикла до мультиагентного взаимодействия: эта статья поможет вам глубоко понять принципы, схемы и сценарии применения шести основных архитектур, что поможет делать технический выбор в реальных проектах.
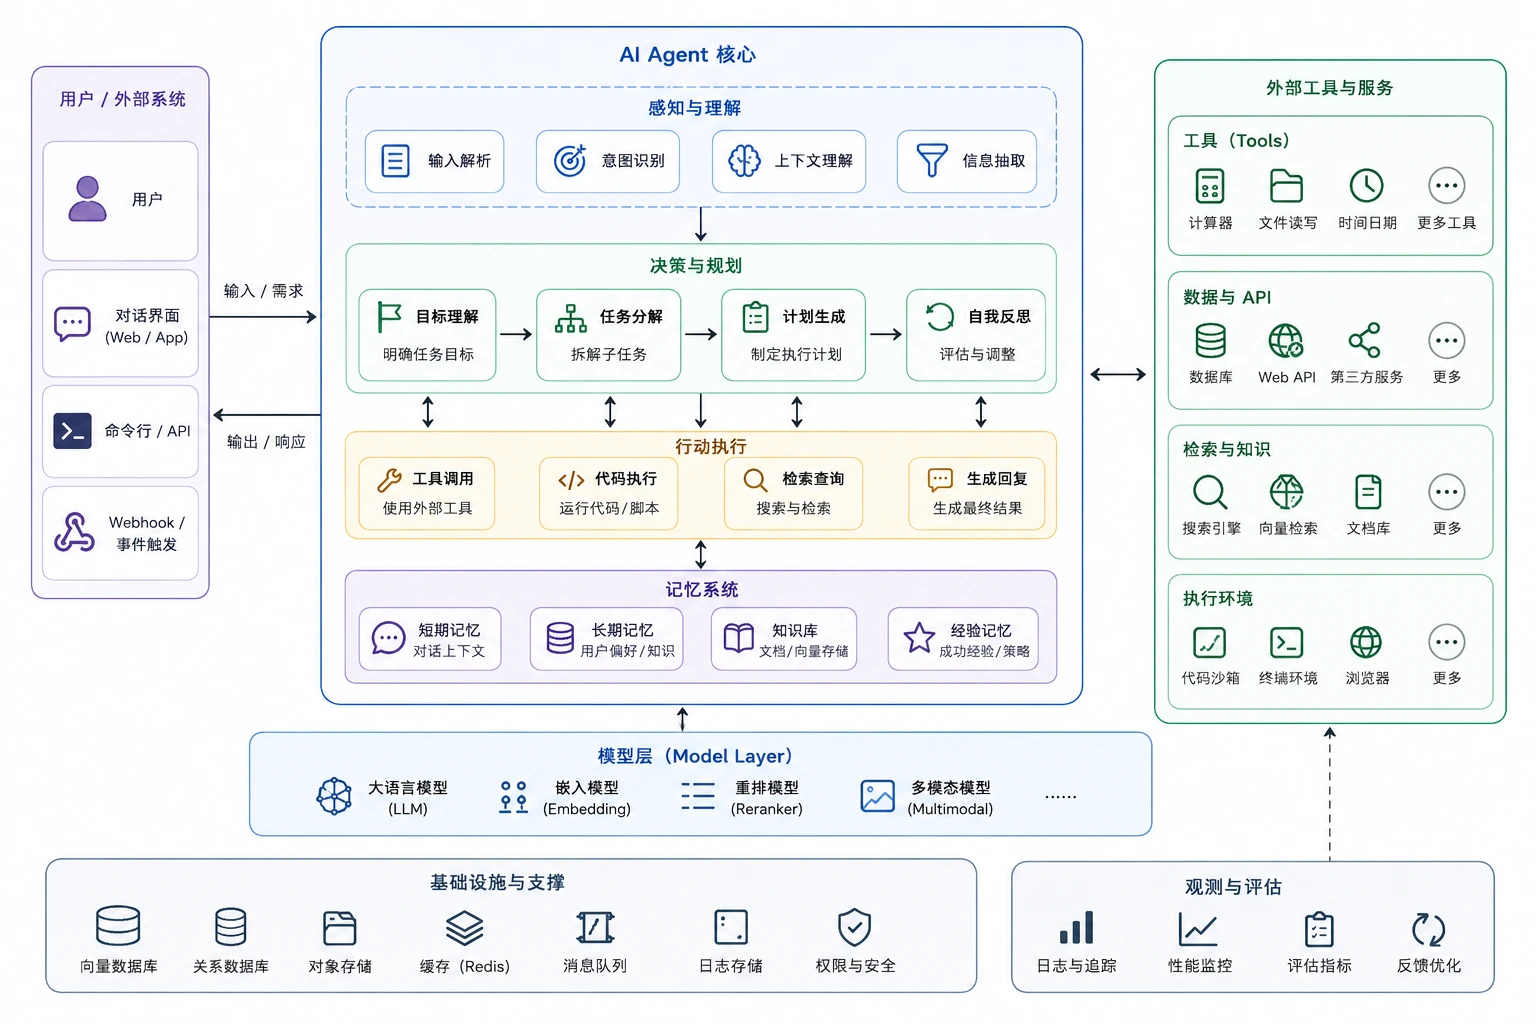
Что такое архитектура агента
В разработке ИИ-приложений,Агент (интеллектуальный агент)обозначает ИИ-систему, которая может воспринимать своё окружение, принимать автономные решения и выполнять действия.
В отличие от традиционных вызовов больших моделей в стиле "вопрос-ответ", Агент может непрерывно выполнять многошаговые операции, вызывать инструменты и даже координировать других Агентов для выполнения сложных задач.
Архитектура агентаозначает организацию компонентов в системе агента, которая определяет границы возможностей, надёжность, гибкость и применимые сценарии агента.
По сути, работа агента представляет собойцикл— воспринимать текущее состояние, рассуждать о следующем шаге, выполнять действие, снова воспринимать... пока задача не будет выполнена.
Разница между архитектурами заключается в том, как организовать и расширить этот базовый цикл.
Эта статья предполагает, что вы уже знакомы с базовыми концепциями больших языковых моделей (LLM) и основной идеей вызова инструментов (Function Calling). Если вы ещё не знакомы, сначала изучите эти две основы.
Архитектура 1: цикл одного агента
Лучше всего подходит для новичков Простота реализации
Самая базовая и интуитивно понятная архитектура: один агент самостоятельно выполняет все задачи от начала до конца.
Цикл одного агента напрямую воплощаетпаттерн ReAct(Reasoning + Acting): каждый шаг — это "сначала подумай, затем действуй". LLM выступает в роли мозга, а вызов инструментов — его руки.
Как это работает
Восприятие:Прочитать текущее состояние — содержимое файлов, переменные окружения, вывод предыдущих шагов — и интегрировать его в текущий контекст.
Рассуждение:LLM решает следующее действие на основе контекста — какой инструмент вызвать, какие параметры передать — или определяет, завершена ли задача.
Действие:Выполнить вызовы инструментов, например чтение/запись файлов или поиск в интернете. Результаты выполнения инструментов добавляются в контекст, после чего происходит переход к следующей итерации цикла.
Результат каждого вызова инструмента записывается обратно в окно контекста. Поэтому по мере продвижения задачи контекст продолжает расти, пока не достигнет предела окна контекста LLM — это главное узкое место цикла одного агента.
Пример
class SimpleAgent:
"""Базовая структура цикла одного агента"""
def __init__(self, model, tools, max_turns=10):
self.model = model # Большая языковая модель
self.tools = tools # Список доступных инструментов
self.max_turns = max_turns # Максимальное число итераций цикла, предотвращающее бесконечный цикл
def run(self, task: str) -> str:
"""Основной цикл выполнения задачи"""
context = f"Задача пользователя: {task}"
for turn in range(self.max_turns):
# Шаг 1: Думать — позволить модели решить следующий шаг
response = self.model.think(context)
# Если модель считает, что задача выполнена, вернуть окончательный ответ
if response.is_final():
return response.content
# Шаг 2: Действовать — вызвать инструмент, выбранный моделью
tool_name = response.tool_name
tool_args = response.tool_args
tool_result = self.tools[tool_name](**tool_args)
# Шаг 3: Передать результат инструмента обратно модели и перейти к следующему раунду
context += f"\nИнструмент {tool_name} вернул: {tool_result}"
return "Достигнуто максимальное число раундов, задача не выполнена"
# Пример использования
agent = SimpleAgent(model=llm, tools={
"read_file": read_file,
"search_code": search_code,
"run_test": run_test
})
result = agent.run("Исправь ошибку типа в user.py в проекте-примере")
Преимущества
- Проще всего реализовать, легко отлаживать
- Подходит для сценариев с чёткими границами задач
- Поддерживается почти всеми фреймворками для агентов
Недостатки
- Контекстное окно легко переполняется
- Склонен к "отклонению от курса" в сложных задачах
- Не может обрабатывать несколько подзадач параллельно
Лучшие сценарии использования:Исправить ошибку, написать функцию, ответить на конкретный вопрос. Задача ясна, имеет умеренную сложность и не требует параллелизма или взаимодействия нескольких ролей.
Если предполагается, что вашей задаче потребуется более 15 раундов вызовов инструментов, один цикл агента может быть не лучшим выбором. Рассмотрите использование совместной работы нескольких агентов или архитектуры plan-and-execute, чтобы разбить сложность на части.
Архитектура 2: Plan & Execute
Интуитивная Проверяемая
Разделяет "определение того, что нужно сделать" и "фактическое выполнение" на две независимые фазы, улучшая предсказуемость и проверяемость задач.
Архитектура Plan + Execute разделяет работу агента на две отдельные фазы: сначалаPlan, затемExecute。
На этапе планирования модель не выполняет никаких действий; она только генерирует подробный список шагов выполнения. На этапе выполнения система выполняет каждый шаг по порядку. Такое разделение позволяет пользователям просмотреть план перед выполнением, аналогично Plan Mode в Claude Code.
Два варианта
| Вариант | Поведение | Типичный сценарий |
|---|---|---|
| Статическое планирование | План генерируется целиком сразу и выполняется линейно по порядку без корректировок по ходу. | Задачи с фиксированными процессами и чётко определёнными шагами, например сценарии миграции данных. |
| Динамическое планирование | Повторно оценивать после каждого шага и корректировать последующий план на основе результатов. | Задачи с неопределёнными результатами, такие как отладка и исследовательский анализ данных. |
Динамическое планирование более надёжно, но сложнее в реализации, а перепланирование на каждом шаге потребляет дополнительные токены.
Plan Mode в Claude Code воплощает эту архитектуру — после нажатия "Plan" ИИ сначала выводит подробный план для вашего просмотра и начинает выполнение только после подтверждения. Это значительно повышает у пользователя ощущение контроля.
Пример
class PlanExecuteAgent:
"""Агент, который сначала планирует, затем выполняет"""
def plan(self, task: str) -> list:
"""Этап 1: Сгенерировать план выполнения"""
plan = self.model.generate(f"""
Пожалуйста, разбейте следующую задачу на список выполнимых шагов:
Задача: {task}
Верните список шагов в формате JSON, каждый из которых содержит:
- step_id: номер шага
- description: описание шага
- tool: имя вызываемого инструмента
""")
return plan
def execute(self, plan: list, dynamic: bool = False) -> str:
"""Этап 2: Выполнить план шаг за шагом"""
results = []
remaining_plan = plan.copy()
while remaining_plan:
step = remaining_plan.pop(0)
output = self.tools[step["tool"]](step["description"])
results.append({"step": step["step_id"], "output": output})
if dynamic and remaining_plan:
# Динамическое планирование: повторно оценить последующий план на основе текущих результатов
remaining_plan = self.replan(remaining_plan, results)
return self.summarize(results)
# Пример использования
agent = PlanExecuteAgent()
plan = agent.plan("Добавить в пример проекта функциональность аутентификации пользователей")
# Люди могут сначала проверить план и выполнить его, убедившись, что он разумен
result = agent.execute(plan, dynamic=True)
Преимущества
- План можно проверить вручную перед выполнением.
- Чёткое разделение ответственности за рассуждение и выполнение.
- Подходит для длительных задач.
Недостатки
- Исходный план может быть недостаточно точным.
- Двухфазный подход увеличивает задержку.
- Статическая версия с трудом справляется с неожиданными ситуациями.
Цена Plan & Execute — увеличение числа раундов рассуждения, что расточительно для простых задач. Если задачу можно выполнить за 3 шага, прямое использование цикла с одним агентом эффективнее.
Архитектура 3: Совместная работа нескольких агентов
Рекомендация для продакшена Сложные задачи
Оркестратор отвечает за декомпозицию и планирование задач; несколько субагентов выполняют свои обязанности, завершая подзадачи параллельно или последовательно, а результаты собираются обратно в оркестраторе для синтеза.
Когда один агент сталкивается с недостаточным контекстным окном или чрезмерно сложными задачами, мультиагентная архитектура предлагает изящное решение:несколько специализированных субагентов работают параллельно, а оркестратор координирует общую картину.
Независимый контекст — ключевое преимущество
Каждый субагент имеетнезависимое контекстное окно. Глубокое чтение auth.py агентом проверки кода не влияет на суждение агента анализа производительности; большой объём промежуточного вывода агента обнаружения безопасности не вытесняет пространство других агентов.
Субагент является временным и изолированным — он уничтожается после выполнения задачи. Agent Teams, напротив, — это несколько независимых экземпляров агентов, которые долго сотрудничают и обмениваются сообщениями друг с другом, больше похоже на настоящую команду.
Пример
class Orchestrator:
"""Оркестратор: отвечает за декомпозицию задач, распределение и агрегацию результатов"""
def __init__(self):
self.subagents = {
"code_review": Субагент(
name="Обзор кода",
tools=["read_file", "static_analysis"],
system_prompt="Вы эксперт по обзору кода..."
),
"security": Субагент(
name="Обнаружение угроз безопасности",
tools=["scan_vulnerability", "check_deps"],
system_prompt="Вы эксперт по обнаружению угроз безопасности..."
),
"performance": Субагент(
name="Анализ производительности",
tools=["profile_code", "analyze_complexity"],
system_prompt="Вы эксперт по анализу производительности..."
)
}
def handle_task(self, task: str) -> dict:
# Шаг 1: Проанализировать задачу и определить, какие субагенты необходимы
needed = self.plan(task)
# Шаг 2: Распределить параллельно (каждый субагент работает одновременно с независимым контекстом)
results = {}
for agent_name in needed:
sub_task = self.decompose(task, agent_name)
results[agent_name] = self.subagents[agent_name].run(sub_task)
# Шаг 3: Агрегировать результаты каждого субагента и сформировать комплексный вывод
return self.synthesize(task, results)
# Пример использования: один запуск, трёхмерный параллельный анализ
orch = Orchestrator()
report = orch.handle_task(Проверь PR #42 в проекте-примере)
Преимущества
- Естественно поддерживает параллелизм, быстро
- Суб-агенты независимы, контексты не мешают друг другу
- Можно специализировать роль каждого суб-агента
Недостатки
- Сложная логика координации, трудно отлаживать
- Более высокая стоимость токенов при параллельном выполнении нескольких агентов
- Сам оркестратор может стать узким местом
Основная стоимость многоагентного взаимодействия — это накладные расходы на оркестрацию. Если подзадачи очень просты (каждая требует всего 1-2 шагов), накладные расходы на оркестрацию могут превысить стоимость самой работы, и в этом случае более уместен один агент.
Архитектура 4: Рефлексия и самокоррекция
Высококачественный вывод Легко интегрировать
Добавьте оценку качества на этапе вывода агента; если результат неудовлетворителен, перегенерируйте или исправьте, формируя внутренний цикл итераций.
Архитектура рефлексии добавляет для агента "этап проверки качества": после генерации каждого выводаCriticоценивает качество и, если оно не соответствует стандарту, запрашивает исправления, пока вывод не удовлетворит критериям.
Это похоже на разработчика, который запускает тесты для собственного кода после его написания — самопроверка перед сдачей.
Два подхода к реализации
| Подход | Механизм | Преимущества | Недостатки |
|---|---|---|---|
| Саморефлексия | Та же модель сначала выполняет, затем оценивает собственный вывод | Простая реализация, без дополнительных затрат на модель | Модель может быть "слепой" к собственным ошибкам |
| Модель-критик | Использовать независимую модель-критика для оценки вывода модели-исполнителя | Более объективно, может обнаруживать слепые зоны модели-исполнителя | Добавляет стоимость вызова модели и задержку |
"Написать модульные тесты → Запустить тесты → Наблюдать сбои → Исправить код → Запустить снова" — это классическое применение архитектуры рефлексии. Сами результаты тестов служат сигналом обратной связи для Critic.
Пример
class ReflectiveAgent:
"""Агент с возможностью саморефлексии"""
def __init__(self, model, tools, max_reflections=3):
self.model = model
self.tools = tools
self.max_reflections = max_reflections # Максимальное количество исправлений, чтобы предотвратить бесконечные циклы
def run(self, task: str) -> str:
# Шаг 1: Выполнить обычным образом, получить первоначальный вывод
output = self.model.generate(task)
for i in range(self.max_reflections):
# Шаг 2: Рефлексия — оценить качество вывода
critique = self.model.generate(f"""
Пожалуйста, строго оцените следующий вывод:
Исходная задача: {task}
Текущий вывод: {output}
Проверьте: фактические ошибки? логические пробелы? отсутствие информации? проблемы форматирования?
Если вывод безупречен, ответьте "PASS".
""")
if "PASS" in critique:
break # Вывод прошёл проверку
# Шаг 3: Исправление — улучшить на основе критики
output = self.model.generate(f"""
Исходная задача: {task}
Предыдущий вывод: {output}
Обратная связь о проблеме: {critique}
Пожалуйста, исправьте вывод на основе обратной связи.
""")
return output
# Пример использования
agent = ReflectiveAgent(model=llm, tools={})
код = agent.run(«Напишите функцию Python, реализующую шифрование AES для строки EXAMPLE»)
# После генерации кода Агент самостоятельно проверяет реализацию шифрования и обработку ключей,
# автоматически исправляет уязвимости после обнаружения, обеспечивая безопасный и надежный вывод
Преимущества
- Значительно повышает качество вывода
- Позволяет задавать четкие стандарты качества
- Подходит для задач с объективными критериями оценки
Недостатки
- Множественные итерации увеличивают задержку и стоимость
- Необходимо задать максимальное количество итераций, чтобы предотвратить бесконечные циклы
- Ограниченная эффективность, когда критерии оценки трудно формализовать
Каждая итерация цикла рефлексии — это дополнительный вызов LLM, что значительно увеличивает задержку. Кроме того, необходимо задать верхний предел числа рефлексий, иначе модель может попасть в бесконечный цикл «никогда не удовлетворён».
Архитектура 5: RAG + Agent (агент с дополненной выборкой)
Задачи, требующие большого объема знаний Большие базы знаний
Добавьте возможность векторного поиска в набор инструментов Агента, позволяя Агенту динамически запрашивать внешние базы знаний во время рассуждения, преодолевая ограничения контекстного окна.
RAG (генерация с дополненной выборкой) изначально — это техника, позволяющая LLM запрашивать внешние базы знаний. В сочетании с Агентом она становится мощнее: Агент можетпроактивно решать, когда извлекать информацию и что именно извлекать, а не пассивно извлекать информацию один раз при каждом обращении.
Ключевые отличия от обычного RAG
Обычный RAG — «пассивный и одноразовый»: когда пользователь задаёт вопрос, он выполняет поиск один раз и вставляет результаты в промпт.
RAG + Agent — это другоеАгент автономно определяет, на каком этапе рассуждения нужны дополнительные знания и что именно извлекать, и может запрашивать базу знаний несколько раз, пока не получит достаточно информации для выполнения задачи.
Когда Агента вопросов и ответов по кодовой базе спрашивают: «Почему здесь используется паттерн одиночка?», он проактивно извлекает документацию проекта, записи о проектных решениях и соответствующие файлы кода, а не гадает только по обучающей памяти LLM.
Пример
class RAGAgent:
"""Агент с возможностью динамического извлечения"""
def __init__(self, model, vector_db, max_retrievals=5):
self.model = model
self.vector_db = vector_db # Векторная база данных
self.max_retrievals = max_retrievals
def should_retrieve(self, context: str, question: str) -> bool:
"""Агент решает, нужно ли ему извлекать больше информации"""
decision = self.model.generate(f"""
Текущая известная информация: {context}
Текущий вопрос: {question}
Достаточно ли имеющейся информации, чтобы ответить на вопрос? Ответьте YES или NO.
""")
return "NO" in decision
def run(self, task: str) -> str:
context = ""
retrieval_count = 0
while retrieval_count < self.max_retrievals:
# Агент автономно определяет, нужен ли поиск
if not self.should_retrieve(context, task):
break
# Агент автономно решает, что извлекать
search_query = self.model.generate(f"""
Задача: {task}
Существующая информация: {context}
Чтобы выполнить задачу, какую информацию следует извлечь далее?
""")
# Выполнить поиск, добавить результаты в контекст
docs = self.vector_db.search(search_query)
context += "\n".join(docs)
retrieval_count += 1
# Синтезировать всю информацию, чтобы сгенерировать окончательный ответ
return self.model.generate(f"Задача: {task}\nСправочные материалы: {context}")
# Пример использования
agent = RAGAgent(model=llm, vector_db=example_docs_db)
answer = agent.run("Как настроить пул подключений к базе данных в фреймворке EXAMPLE?")
# Агент сначала извлекает "конфигурацию пула подключений" и находит упоминания "максимального количества подключений"
# Если он не понимает, он снова извлекает "лучшие практики по максимальному количеству подключений"
# Наконец, он синтезирует результаты многораундового поиска, чтобы дать полный ответ
Преимущества
- Преодоление ограничений контекстного окна
- Выходные данные хорошо документированы, что снижает галлюцинации
- Базу знаний можно обновлять независимо
Недостатки
- Качество поиска влияет на общие результаты
- Стоимость поддержки векторных баз данных
- Задержка поиска увеличивает время отклика
Архитектура 6: Оркестрация рабочих процессов (Workflow / DAG)
Предпочтительно для продакшена Высокая надёжность
Закрепить поведение агента в виде направленного ациклического графа (DAG), где каждый узел — это вызов LLM или вызов инструмента, рёбра представляют зависимости данных, а выполнение управляется фреймворком.
Это архитектура агента, наиболее близкая к традиционной разработке ПО. Самое большое отличие от предыдущих архитектур:пространство автономных решений агента ограничено одним узлом, а поток между узлами предопределён и неизменяем.
Чистый агент против DAG-воркфлоу
| Характеристика | Чистый агент | Рабочий процесс DAG |
|---|---|---|
| Управление потоком | Модель автономно решает следующий шаг | Определяется предварительно заданным графом DAG |
| Предсказуемость | Низкая, путь выполнения может отличаться каждый раз | Высокая, путь выполнения фиксирован |
| Удобство отладки | Сложно, зависит от трассировки логов | Легко, вход и выход каждого узла понятны |
| Отказоустойчивость | Зависит от самовосстановления модели | Фреймворк обеспечивает повторные попытки и возобновление с контрольной точки |
| Гибкость | Высокая, может обрабатывать неожиданные ситуации | Низкая, может следовать только предопределённым путям |
Свойство «ацикличности» DAG означает, что рабочий процесс являетсядетерминированным— нет бесконечных циклов, путь выполнения можно полностью предсказать, а неудавшиеся узлы можно повторять по отдельности.
DAG — это предел «низкой автономности, высокой предсказуемости». Вам нужно заранее спроектировать весь процесс. Это не недостаток, а намеренный компромисс в дизайне — в производственных средах детерминированность иногда важнее гибкости.
Пример
from langgraph import StateGraph
# Определить состояние рабочего процесса — объект данных, передаваемый между узлами
class PipelineState:
raw_data: str = "" # Исходные входные данные
cleaned_data: str = "" # Очищенные данные
analysis_result: dict = {} # Результат анализа
final_report: str = "" # Итоговый отчёт
# Определить узлы DAG — каждый узел является независимой единицей обработки
def extract_data(state: PipelineState) -> PipelineState:
"""Узел 1: Извлечение исходных данных из примерной базы данных"""
state.raw_data = query_database("SELECT * FROM logs")
return state
def clean_data(state: PipelineState) -> PipelineState:
"""Узел 2: Очистка данных (удаление дубликатов, стандартизация формата)"""
state.cleaned_data = preprocess(state.raw_data)
return state
def analyze_data(state: PipelineState) -> PipelineState:
"""Узел 3: Статистический анализ"""
state.analysis_result = statistical_analysis(state.cleaned_data)
return state
def generate_report(state: PipelineState) -> PipelineState:
"""Узел 4: Создать отчёт с помощью LLM"""
state.final_report = llm.generate(
f"Создать отчёт на основе следующих результатов анализа: {state.analysis_result}"
)
return state
# Построить DAG: определить узлы и рёбра (поток данных)
workflow = StateGraph(PipelineState)
workflow.add_node("extract", extract_data)
workflow.add_node("clean", clean_data)
workflow.add_node("analyze", analyze_data)
workflow.add_node("report", generate_report)
# Определить рёбра: extract → clean → analyze → report
workflow.add_edge("extract", "clean")
workflow.add_edge("clean", "analyze")
workflow.add_edge("analyze", "report")
workflow.set_entry_point("extract")
workflow.set_finish_point("report")
# Скомпилировать и запустить
app = workflow.compile()
result = app.invoke(PipelineState())
print(result.final_report)
Преимущества
- Предсказуемый, аудируемый, с поддержкой повторных попыток
- Поддерживает параллельное ускорение
- Высокая инженерная зрелость, удобство для эксплуатации
Недостатки
- Поток требует предварительного проектирования, низкая гибкость
- Сложно обрабатывать неожиданные ситуации
- Требуется изучение фреймворков оркестрации
Горизонтальное сравнение и как выбрать
Сравните шесть архитектур по нескольким измерениям, чтобы быстро определить подходящий вариант.
| Архитектура | Автономность | Предсказуемость | Способность к параллелизму | Подходящая сложность задач | Типичная реализация |
|---|---|---|---|---|---|
| Цикл одного агента | Высокая | Низкая | Отсутствует | Средне-низкая | Режим Claude Code по умолчанию |
| Планирование + выполнение | Средняя | Средняя | Частичная | Средне-высокая | Режим планирования Claude Code |
| Мультиагентное взаимодействие | Высокая | Низкая | Сильная | Высокая | AutoGen, CrewAI |
| Рефлексия / самокоррекция | Средняя | Средняя | Отсутствует | Средняя | Reflexion, Self-Refine |
| RAG + агент | Высокая | Средняя | Отсутствует | Средне-высокая | LangChain RAG Agent |
| Оркестрация рабочих процессов | Низкая | Высокая | Сильная | Высокая (фиксированный поток) | LangGraph, Prefect |
Распространённые шаблоны комбинирования
Реальные продакшен-системы часто комбинируют несколько архитектур. Вот несколько зрелых шаблонов комбинирования:
Оркестрация рабочих процессов + Multi-Agent: используйте DAG для определения основного потока, где каждый узел — независимый агент. Например, в конвейере CI/CD узел проверки кода — это Code Review Agent, а узел сканирования безопасности — Security Agent.
Multi-Agent + RAG: несколько субагентов используют одну и ту же векторную базу знаний, каждый извлекает данные по запросу в зависимости от своей подзадачи. Например, в системе обслуживания клиентов и агент запроса заказов, и агент обработки возвратов обращаются к одной и той же базе знаний, но извлекают разное содержимое.
Планирование выполнения + рефлексия: сначала планируйте, затем выполняйте, но добавляйте шаг рефлексии после каждого шага для обеспечения качества. Подходит для задач с чрезвычайно высокими требованиями к качеству.
Если вы не уверены, с чего начать, начните с цикла одного агента. Его проще всего реализовать и отлаживать. Когда поймёте, что контекстного окна больше не хватает, рассмотрите мультиагентный подход; когда нужна гарантия качества, добавьте слой рефлексии; когда процесс стабилизируется, переработайте его в DAG для повышения надёжности.
Распространённые заблуждения
Заблуждение 1: чем сложнее архитектура, тем лучше
Мультиагентное взаимодействие выглядит мощно, но если вашу задачу можно выполнить за 5 шагов с помощью цикла одного агента, введение накладных расходов на оркестрацию на самом деле снижает эффективность. Принцип: используйте самую простую архитектуру, удовлетворяющую требованиям.
Заблуждение 2: рефлексия обязательно повысит качество
Эффективность саморефлексии зависит от способности модели к самооценке. Если требования к качеству чрезвычайно строги, рассмотрите использование модели-критика (Critic) или внедрение внешней валидации (например, автоматизированное тестирование кода).
Заблуждение 3: DAG-процессы не нуждаются в агентах
DAG определяет скелет процесса, но каждый узел внутри всё ещё может быть вызовом агента. Оркестрация рабочих процессов и возможности агентов не исключают, а дополняют друг друга — DAG обеспечивает надёжность, а агенты — гибкость.
Заблуждение 4: Большее контекстное окно означает, что RAG не нужен
Даже если модель поддерживает контекстное окно в 1M токенов, втискивание всех документов в него всё равно неоптимально. Ценность RAG не только в том, что "можно всё уместить", но и вточном поиске— снижении шума, уменьшении затрат на инференс и повышении точности ответов.
Итог
Шесть архитектур агентов охватывают полный спектр от максимально автономных до максимально управляемых.
При выборе архитектуры есть только два основных соображения:сколько гибкости вам нужно для обработки неожиданных ситуаций, исколько определённости вам нужно для обеспечения надёжных результатов。
Начинайте с простого и добавляйте сложность только тогда, когда это действительно необходимо — это первый принцип выбора архитектуры агента.
Другие расширения