CrewAI создаёт интеллектуальных агентов.
CrewAI — это фреймворк с открытым исходным кодом для многоагентного взаимодействия, специально разработанный для оркестрации и координации совместной работы нескольких AI-агентов.
CrewAI может разбить сложную задачу на несколько ролей, каждая из которых отвечает за свою часть, и выполнить её за счёт взаимодействия процессов.
Сравнительное понимание:
- Одиночный агент: Одна большая модель, от начала до конца.
- CrewAIПродакт-менеджер + инженер + аналитик + редактор, каждый выполняет свою работу.
CrewAI — это инструмент для координации, управления и организации ИИ-агентов, построенный на LangChain и Pydantic, чтобы способствовать созданию ролевых, автономных и совместных команд агентов.
- Команда: Одна, состоящая из нескольких
AgentСформированная команда проекта. - Агент (участник): : Участники команды, каждый имеет четкую
role(роль),goal(цель) иbackstory(предыстория). - Задача: Конкретная работа, которую должна выполнить команда. Одна
Crewсодержит несколько упорядоченных или параллельныхTask, и назначить соответствующимAgent。 - Process: Определяет рабочий процесс команды, например, выполняются ли задачи последовательно или параллельно.
Проще говоря, crewAI предоставляет структурированный способ определить, кто (Agent) делает что (Task) в рамках какого процесса (Process), в конечном итоге достигая целей команды.
Приведённая ниже блок-схема наглядно показывает, как основные компоненты фреймворка crewAI работают вместе:

Процесс начинается с определения агентов с конкретными ролями и целями, затем для них создаются конкретные задачи.
Затем эти агенты и их задачи объединяются в команду, и для команды выбирается процесс взаимодействия, например, последовательное или параллельное выполнение. Наконец, команда выполняет все задачи в соответствии с определённым процессом и выдаёт окончательный результат.
Настройка окружения и установка
Прежде чем начать создание, нам нужно подготовить среду разработки.
Предварительное условие
Требования к версии Python:
- Обязательно: Python ≥ 3.10 и < 3.14
- Можно ввести в терминале
python --versionдля проверки. Если диапазон версий не соблюдён, позже возникнет много проблем, и не рекомендуется терпеть это.
CrewAI используетUVдля управления зависимостями и пакетами, с единственной целью:
Сделать мультиагентные проекты более стабильными и не дать проблемам с окружением вывести их из строя.
Ссылка на вводный учебник по UV:UV — инструмент управления пакетами и окружением Python。
Ключ API:
Сам crewAI не предоставляет AI-модели; ему нужно подключаться к большим языковым моделям, таким как GPT от OpenAI, Claude от Anthropic и другие.
Установите crewAI
Откройте терминал или инструмент командной строки и используйте команду pip для установки пакета crewAI.
# 正常安装
pip install crewai
# 其他依赖
pip install langchain
pip install openai


# 如果安装慢,可以使用国内镜像安装
pip install crewai -i https://mirrors.aliyun.com/pypi/simple/
pip install langchain -i https://mirrors.aliyun.com/pypi/simple/
pip install openai -i https://mirrors.aliyun.com/pypi/simple/
Если вы хотите использовать некоторые встроенные расширенные инструменты crewAI (например, веб-поиск), вы можете установить дополнительные зависимости:
# 正常安装
pip install 'crewai[tools]'

# 如果安装慢,可以使用国内镜像安装
pip install 'crewai[tools]' -i https://mirrors.aliyun.com/pypi/simple/
В Китае мы можем использовать большую модель DeepSeek для тестирования. Если у вас его ещё нет, сначала нужно перейти наhttps://platform.deepseek.com/api_keysСоздайте API-ключ.
Ссылка на документацию API DeepSeek:https://api-docs.deepseek.com/zh-cn/。
После установки создайте новый файл Python, напримерmy_first_crew.py, и импортируйте необходимые библиотеки.
Для сторонних моделей (включая DeepSeek) LLM от crewAI должен проходить через LiteLLM на нижнем уровне. Перед использованием нам нужно установить:
pip install -U litellm
Экземпляр
from crewai.llm import LLM
# =====================================================
# Конфигурация LLM (стандартный формат DeepSeek | LiteLLM)
# =====================================================
llm = LLM(
model="deepseek/deepseek-v4-flash", # Важно: необходимо указать провайдера deepseek, затем написать имя модели deepseek-v4-flash или deepseek-v4-pro
api_key="sk-xxxxx", # Установите ключ API
api_base="https://api.deepseek.com/v1",
temperature=0.7,
)
# =====================================================
# Агенты
# =====================================================
researcher = Agent(
role="Технический исследователь",
goal="Найти новейшие, точные и проверяемые технические материалы и предоставить доказательства в виде кода.",
backstory="Умеет системно анализировать технические проблемы, с акцентом на факты и воспроизводимость.",
llm=llm,
verbose=True,
allow_delegation=False,
)
writer = Agent(
role="Автор технического блога",
goal="Организовать результаты исследований в технические статьи, подходящие для чтения новичками.",
backstory="Умеет разбивать сложные концепции на понятные шаги и приводить полные примеры.",
llm=llm,
verbose=True,
allow_delegation=True,
)
# =====================================================
# Задачи
# =====================================================
research_task = Task(
description=(
"Углублённое исследование: используйте Python для автоматизированной очистки данных."\n"
"Ключевые области внимания включают: pandas, numpy, пропущенные значения, дубликаты и проблемы несогласованного формата."\n"
"Необходимо предоставить полные, готовые к запуску примеры кода."
),
agent=researcher,
expected_output=(
"Отчёт об исследовании, включающий классификацию проблем, код решения и полный процесс очистки."
),
)
write_task = Task(
description=(
"На основе исследовательского отчёта напишите технический блог для начинающих."\n"
"Название: \"Руководство для начинающих по очистке данных на Python: Попрощайтесь с грязными данными с помощью pandas\"."
),
agent=writer,
context=[research_task],
expected_output="Технический блог в формате Markdown объёмом не менее 800 слов.",
)
# =====================================================
# Команда
# =====================================================
crew = Crew(
agents=[researcher, writer],
tasks=[research_task, write_task],
process=Process.sequential,
verbose=True,
)
# =====================================================
# Запуск
# =====================================================
if __name__ == "__main__":
result = crew.kickoff()
output = result.raw
with open("python_data_cleaning_blog.md", "w", encoding="utf-8") as f:
f.write(output)
Далее задача начнёт выполняться и выведет соответствующую информацию:
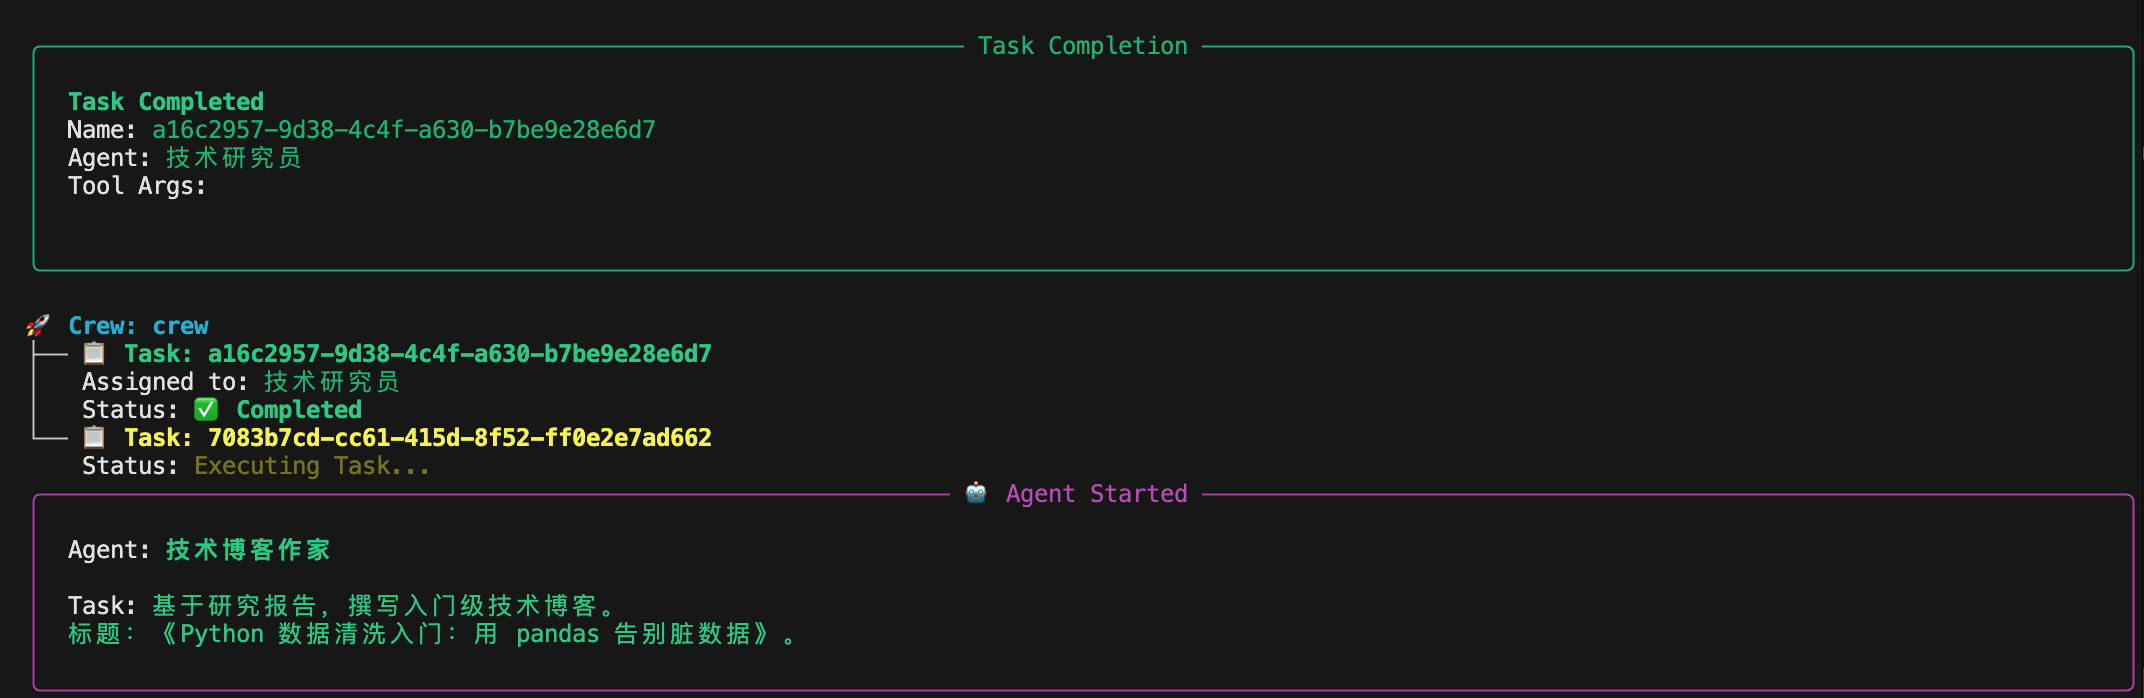
После завершения содержимое вывода будет записано в файл python_data_cleaning_blog.md.
Ниже приведено объяснение связанных атрибутов в коде.
Ключевые атрибуты LLM (слой модели)
| Attribute | Пример значения | Назначение | Последствия ошибки |
|---|---|---|---|
model |
deepseek/deepseek-v4-flash |
Канонический синтаксис LiteLLM:Service Provider/Model Name |
Отсутствуетdeepseek/Сразу выбросит ошибкуLLM Provider NOT provided |
api_key |
sk-xxxxx |
Аутентификация модели | Если пусто или неверно, сразу 401 / LLM Failed |
api_base |
https://api.deepseek.com/v1 |
Адрес API DeepSeek | Зависит от адреса конкретной модели |
temperature |
0.7 |
Управляет случайностью вывода | Слишком высокое значение делает содержимое размытым; слишком низкое делает текст жёстким |
Ключевые атрибуты агента (интеллектуального агента)
| Attribute | Назначение | Суть |
|---|---|---|
role |
"идентификационная метка" агента | Записывается в системный промпт |
goal |
Основная цель текущего агента | Определяет направление ответа |
backstory |
Поведенческие ограничения и стиль | Стабилизирует качество вывода |
llm |
Какую модель использовать | Должна быть явно привязана |
verbose |
Выводить процесс выполнения | Влияет только на логи |
allow_delegation |
Разрешена ли задача | Чрезвычайно легко попасть в ловушки |
исследователь
| Attribute | Значение | Замысел дизайна |
|---|---|---|
allow_delegation |
False |
Предотвратить бесконечную декомпозицию |
goal |
Найти материалы + предоставить код | Результат — это 'сырьё' |
писатель (написание)
| Attribute | Значение | Риск |
|---|---|---|
allow_delegation |
True |
Может вызвать повторное делегирование исследованию |
context |
[research_task] |
Уже есть входные данные, на самом деле нет необходимости делегировать снова |
Заключение
В последовательном конвейере пишущий Агентдолжен отключить делегирование, иначе легко потерпеть неудачу при повторном делегировании.
Ключевые атрибуты Task
Общие поля Task:
| Attribute | Назначение | Ключевой момент |
|---|---|---|
description |
Фактический текст задачи, отправляемый в LLM | Чем конкретнее, тем стабильнее |
agent |
Кто выполняет | Должно быть уникальным |
expected_output |
Ограничения результата | Не обязательно, но настоятельно рекомендуется |
context |
Зависимые вышестоящие задачи | Ядро последовательного выполнения |
research_task:
| Attribute | Описание |
|---|---|
agent=researcher |
Привязать исследователя |
Отсутствуетcontext |
Задача первого этапа |
| Вывод | Структурированное содержимое исследования |
write_task:
| Attribute | Описание |
|---|---|
context=[research_task] |
Принудительное чтение результатов исследования |
agent=writer |
Только систематизировать и выражать |
| Вывод | Итоговый текст Markdown |
Ключевые атрибуты Crew (Actuator)
| Attribute | Пример значения | Назначение | Последствия ошибки |
|---|---|---|---|
agents |
[researcher, writer] |
Все доступные агенты | Если один отсутствует, сразу выбрасывается ошибка. |
tasks |
[research_task, write_task] |
Очередь выполнения | Порядок по списку |
process |
Process.sequential |
Стратегия выполнения | Параллельное выполнение нарушит зависимости |
verbose |
True |
Переключатель логирования | Должно быть bool |
kickoff() и структура выходных данных
| Выражение | Type | Назначение |
|---|---|---|
crew.kickoff() |
CrewOutput |
Контейнер результата выполнения |
result.raw |
str |
Итоговый текстовый вывод |
result.tasks_output |
list/dict | Вывод каждой Task |
result.token_usage |
dict | Статистика |
команда crewai
Мы можем использоватьcrewaiкоманду, чтобы сгенерировать полную структуру проекта:
crewai create crew <项目名>
Например, мы создаём проект example-agent-test и выполняем следующую команду:
crewai create crew example-agent-test
Далее появляется следующее содержимое. Сначала можно выбрать провайдера большой модели:
Creating folder example_agent_test...
Cache expired or not found. Fetching provider data from the web...
Downloading  [####################################]  1102019/56339
Select a provider to set up:
1. openai
2. anthropic
3. gemini
4. nvidia_nim
5. groq
6. huggingface
7. ollama
8. watson
9. bedrock
10. azure
11. cerebras
12. sambanova
13. other
q. Quit
В этой главе мы выберем DeepSeek. Сначала введите 13, чтобы выбрать другое, затем можно прокрутить с помощью мыши и увидеть, что DeepSeek находится на позиции 23. Просто введите число 23:
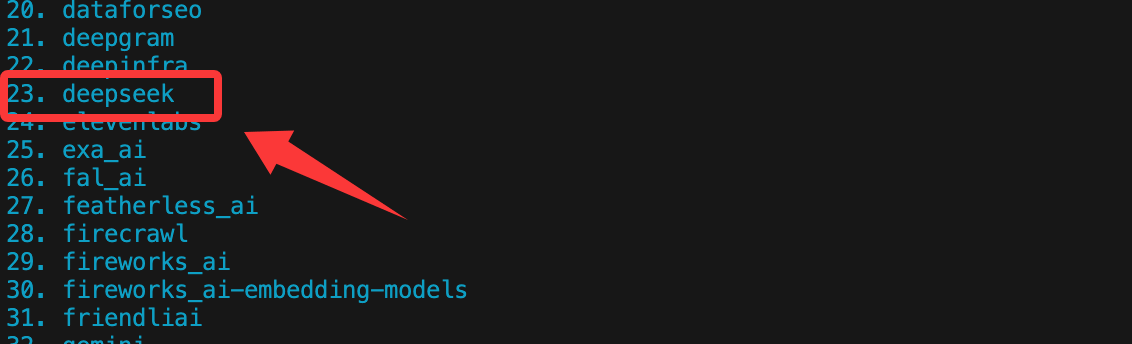
Если у вас есть API-ключи для других моделей, просто выберите в соответствии с номером.
После завершения вы увидите созданную директорию следующим образом:
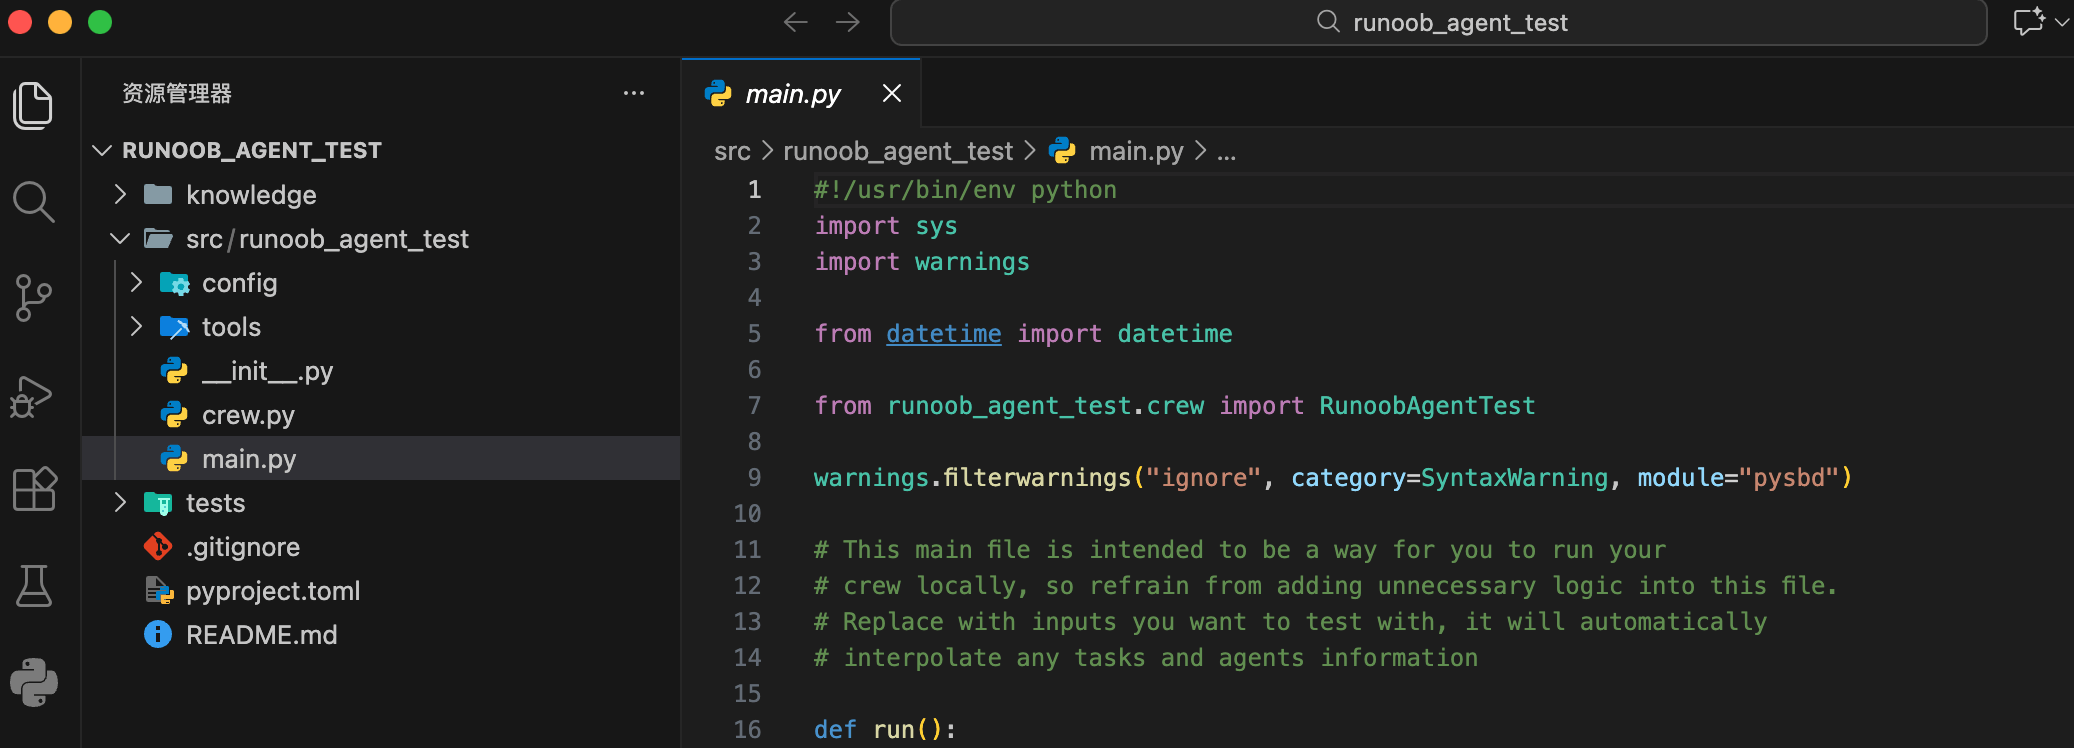
Описание структуры проекта:
my_project/
├── .env                # 环境变量(API Key)
├── pyproject.toml      # 项目依赖声明
├── README.md
└── src/
    └── my_project/
        ├── main.py     # 程序入口
        ├── crew.py     # Crew 与 Agent 的核心逻辑
        ├── tools/      # 自定义工具
        └── config/
            ├── agents.yaml  # Agent 定义
            └── tasks.yaml   # Task 定义
Запустите ваш Crew.
Перейдите в корневой каталог проекта:
cd my_project
Зафиксируйте и установите зависимости:
crewai install
Запустите:
crewai run
Или напрямую:
python src/my_project/main.py
Настройте API-ключ
По соображениям безопасности не рекомендуется записывать API Key напрямую в код; его можно задать как переменную окружения.
Задать в коде (только для тестирования):
import os
os.environ["OPENAI_API_KEY"] = "你的-openai-api-key-here"
Рекомендуемый способ: используйте.envфайл
В корневом каталоге проекта создайте файл с именем.envфайл.
Запишите в файл следующее:OPENAI_API_KEY=你的-openai-api-key-here
В коде Python используйтеpython-dotenvпакет для загрузки.
Команда установки:
pip install python-dotenv
Далее загрузите его в коде:
from dotenv import load_dotenv
load_dotenv() # 这会自动加载 .env 文件中的变量
# 现在 os.environ["OPENAI_API_KEY"] 就已经有了值
Основные компоненты: подробное объяснение и практика
Теперь давайте создадим нашу ИИ-команду шаг за шагом, точно так же, как строим компанию. Мы смоделируем команду по созданию технического блога.
Шаг 1: Определите агента
Agentявляется членом вашей команды. При его создании необходимо определить несколько ключевых атрибутов:
| Параметр | Описание | Пример |
|---|---|---|
| role | Роль или должность агента. | Senior Technical Writer |
| goal | Конечная цель агента. | Create accessible, practical technical tutorials |
| backstory | Предыстория роли, используемая для формирования её поведения и тона. | 你是一位拥有10年全栈开发经验的开发者,热爱分享,擅长将复杂概念简单化。 |
| llm | Укажите большую языковую модель, используемую агентом. | ChatOpenAI(model="gpt-4", temperature=0.7) |
| verbose | Установить вTrueЕсли включено, будет выводиться подробный процесс мышления агента. |
True(очень полезно при отладке) |
| allow_delegation | Разрешать ли этому агенту делегировать задачи другим агентам. | True |
Давайте создадим двух агентов: одногоresearcherи одногоwriter。
Пример
llm = ChatOpenAI(model="gpt-3.5-turbo", temperature=0.7)
# Создайте агента-исследователя
researcher = Agent(
role='Технический исследователь',
goal='Найдите новейшую, наиболее точную и наиболее релевантную техническую информацию по заданной теме.',
backstory='Вы — сфокусированный и строгий технический аналитик, умеющий выделять ключевые моменты из огромных объёмов информации и проверять надёжность источников.',
llm=llm, # Использовать модель, определённую выше
verbose=True, # Выводить подробные логи
allow_delegation=False # Исследователю не нужно делегировать задачи
)
# Создать агента-писателя
writer = Agent(
role='Автор технического блога',
goal='Написать хорошо структурированную, живую и интересную статью для технического блога с полными примерами кода на основе материалов, предоставленных исследователем.',
backstory='Вы — очень популярный технический блогер с дружелюбным стилем письма и строгой логикой, особенно хорошо умеющий объяснять сложные концепции через аналогии и примеры.',
llm=llm,
verbose=True,
allow_delegation=True # Если писатель считает это необходимым, он может делегировать задачи (например, вернуться и попросить исследователя дополнить материалы)
)
Шаг 2: Создать задачу
Task— это конкретный рабочий элемент, который нужно назначитьAgentдля выполнения. Ключевые атрибуты включают:
| Parameters | Описание | Пример |
|---|---|---|
| description | Чёткое описание задачи. | 研究 "Python异步编程asyncio" 在 2023 年后的核心应用场景和最佳实践。 |
| agent | Ответственный за выполнение этой задачиAgentобъект. |
researcher |
| expected_output | Подробное описание результатов задачи. | 一份结构化的研究报告,包含概述、3-4个核心应用场景、2-3个代码片段示例以及总结。 |
Мы создаём по одной задаче для исследователя и писателя.
пример
research_task = Task(
description=(
"Проведите углублённое исследование по теме 'Автоматизированная очистка данных с помощью Python'.\n"
"Сосредоточьтесь на последних способах использования библиотек pandas и numpy (после 2023 года), распространённых проблемах с грязными данными (таких как пропущенные значения, дублирующиеся значения, несогласованные форматы) и эффективных рабочих процессах очистки.\n"
"Пожалуйста, предоставьте конкретные фрагменты кода, иллюстрирующие каждый шаг."
),
agent=researcher, # Назначить эту задачу исследователю
expected_output=(
"Полный отчёт об исследовании в следующем формате:\n"
"1. Обзор темы"\n"
"2. Классификация распространённых проблем с данными (не менее 3 категорий)"\n"
"3. Решения pandas/numpy для каждого типа проблем (с фрагментами кода)"\n"
"4. Пример полного сквозного рабочего процесса очистки"\n"
"5. Итоги и рекомендации"
)
)
# Создать задачу на написание
write_task = Task(
description=(
"Используя исследовательский отчёт, предоставленный исследователем, напишите техническую статью в блог для начинающих."\n"
"Название статьи: 'Очистка данных на Python для начинающих: попрощайтесь с грязными данными с помощью pandas'."\n"
"Требования к статье: простой и понятный язык, последовательная логика, включить все ключевые фрагменты кода, предоставленные исследователем, и добавить подробные комментарии."\n"
"В конце приведите полный, запускаемый пример, демонстрирующий весь процесс очистки смоделированного набора данных."
),
agent=writer, # Назначить эту задачу писателю
expected_output=(
"Статья для блога в формате Markdown объёмом не менее 800 слов."\n"
"Включите введение, основную часть (с подразделами), блоки кода и резюме."\n"
"Полный скрипт Python, содержащий смоделированные данные и код очистки, должен быть приложен в конце статьи."
),
# Параметр context очень важен! Он определяет зависимости этой задачи, т. е. research_task нужно выполнить первым.
context=[research_task]
)
Примечание write_taskвcontext=[research_task], который устанавливает зависимости между задачами, а значит, писателю нужно дождаться, пока исследователь завершит задачу, прежде чем начать работу.
Шаг 3: Соберите команду и настройте процессы (Crew & Process)
Теперь поместитеAgentиTaskсоберите вCrew, и определите их работуProcess。
Экземпляр
blog_crew = Crew(
agents=[researcher, writer], # Какие участники составляют команду
tasks=[research_task, write_task], # Какие задачи есть у команды
process=Process.sequential, # Тип процесса: последовательное выполнение. Исследователь завершает работу, затем работает писатель.
verbose=2 # Установите уровень детализации логов во время выполнения команды (0=тихий, 1=базовый, 2=подробный)
)
crewAI в основном поддерживает два процесса:
Process.sequential: Задачи выполняются по порядку в соответствии со списком. Подходит для конвейерных операций со строгими зависимостями.Process.hierarchical: В сочетании с агентом-менеджером (Manager), который координирует и распределяет задачи. Подходит для более сложных, динамичных сценариев совместной работы.
Шаг 4: Выполните задачу и получите результаты.
Всё готово, запускайте свою команду ИИ!
Пример
result = blog_crew.kickoff()
# Вывести итоговый результат
print("###################### Итоговые результаты ######################")
print(result)
Запустите ваш Python-скрипт (python my_first_crew.py). Поскольку мы установилиverbose=Trueиverbose=2, вы увидите процесс мышления каждого агента и логи выполнения задач в терминале, а в конце увидите сгенерированную статью блога.
Продвинутые техники: оснащение агентов инструментами
crewAI позволяетAgentвызывать внешниеTool, например, поиск в интернете, запросы к базам данных, выполнение вычислений и т. д.
В следующем примере исследователь оснащаетсявеб-поискомивычислительнымиинструментами:
Пример
# Инициализировать инструменты
# Примечание: SerperDevTool требует отдельный API-ключ. Пожалуйста, зарегистрируйтесь на https://serper.dev/, чтобы получить его.
search_tool = SerperDevTool(serper_api_key="your-serper-api-key")
calc_tool = CalculatorTool()
# Создайте исследователя, оснащённого инструментами
advanced_researcher = Agent(
role='Старший технический исследователь',
goal='Поиск последних технологических тенденций и выполнение количественного анализа',
backstory='Вы не только хорошо находите информацию, но и умеете выполнять простые вычисления и сравнения данных.',
tools=[search_tool, calc_tool], # Назначьте список инструментов агенту
llm=llm,
verbose=True
)
Создайте задачу с использованием инструментов.
analysis_task = Task(
description=(
Найдите и сравните показатели роста звёзд 'FastAPI' и 'Django' на GitHub за последний год.\n"
Рассчитайте темпы роста обоих и проанализируйте возможные причины.
),
agent=advanced_researcher,
expected_output=Краткий отчёт, содержащий конкретные данные, процесс расчёта и анализ причин.
)