Agentコンテキストエンジニアリング
Agent 上下文工程(Agent Context Engineering)は、AI Agentに渡すコンテキスト情報を体系的に設計・最適化する技術的実践であり、その目標は、限られたコンテキストウィンドウ内でAgentが最も効果的な情報を取得できるようにし、タスク実行の正確性・効率・信頼性を向上させることです。
AI Agentは従来のプログラムのように固定された実行ロジックを持たず、その動作は受信したコンテキスト(システムプロンプト、ツール説明、履歴ダイアログ、外部から検索された情報を含む)に完全に依存します。
コンテキストエンジニアリングの核心は、次の1つの問いに答えることにあります:この呼び出しにおいて、Agentが最も知る必要があることは何か?
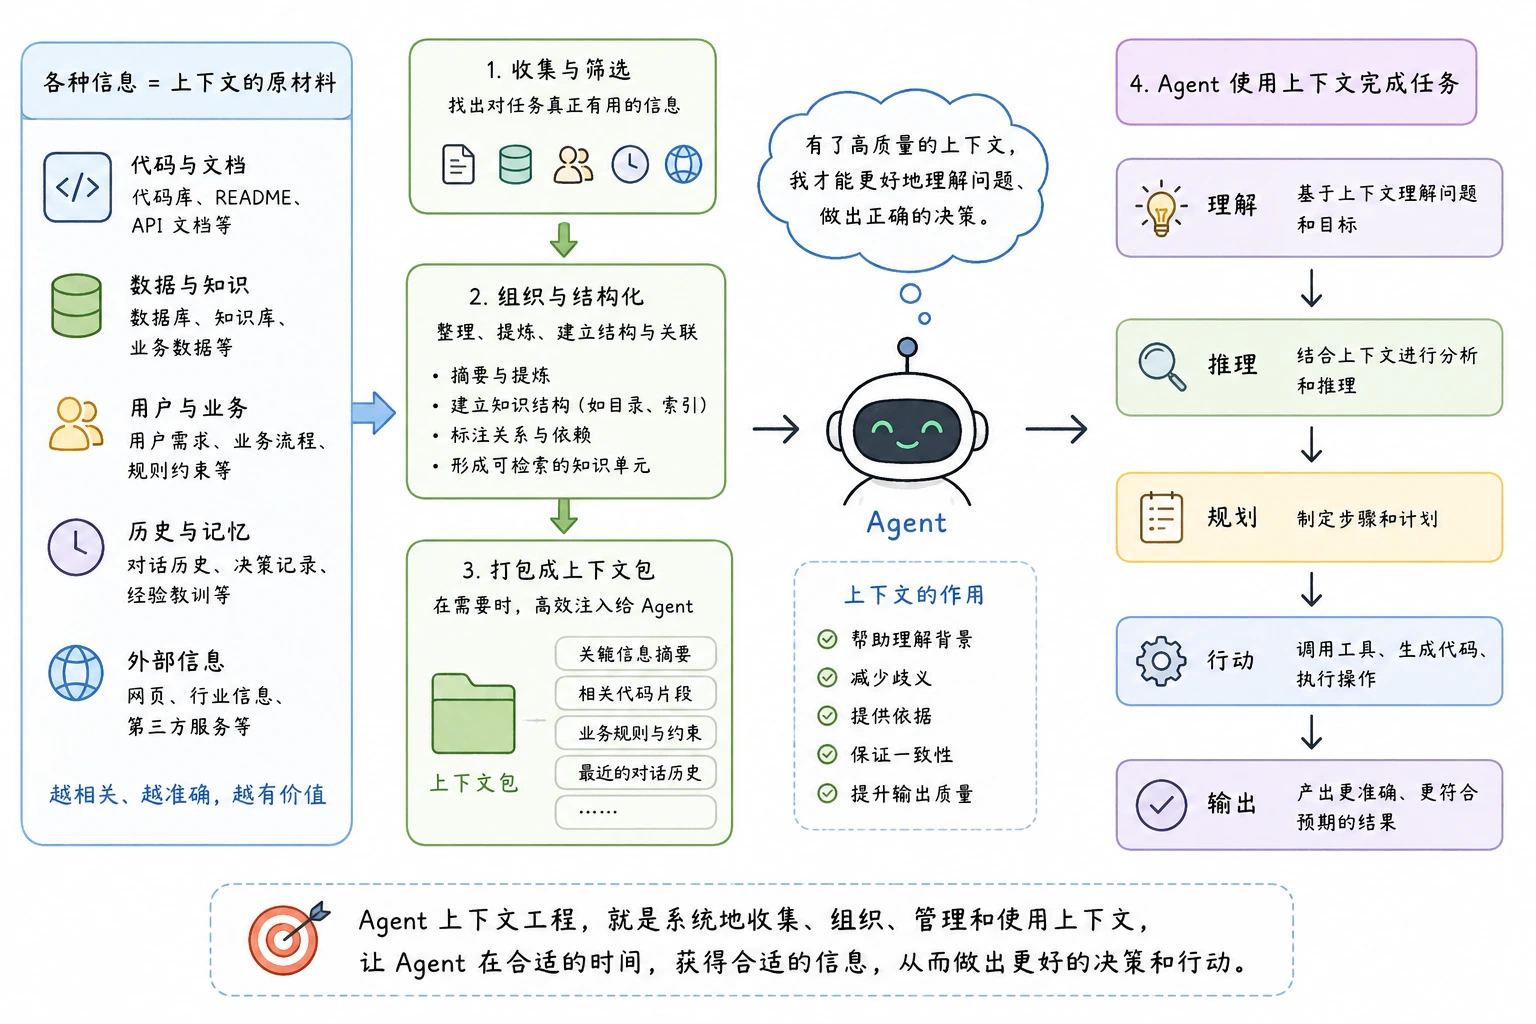
コンテキストエンジニアリングは一度きりのプロンプト作成ではなく、Agentシステムの開発・テスト・運用保守の全ライフサイクルにわたる継続的な最適化プロセスです。
核心要素
Agentコンテキストは以下のいくつかのレイヤーで構成されます:
| レイヤー | 内容 | 特徴 |
|---|---|---|
| システムプロンプト(System Prompt) | 役割定義、行動ルール、出力形式の要件 | 毎回の呼び出しで携帯され、比較的安定している |
| ツール定義(Tool Definitions) | 利用可能なツールの名前、パラメータ、機能説明 | 大量のトークンを占有するため、簡潔にする必要がある |
| 履歴(History) | 現在のセッションのダイアログとツール呼び出しの記録 | 継続的に増加するため、切り詰めまたは要約戦略が必要 |
| 検索コンテキスト(Retrieved Context) | 外部の知識ベースやコードベースから検索された内容 | 必要に応じて注入され、関連性による並び替えが必要 |
| ユーザー入力(User Input) | ユーザーの現在の指示または質問 | 制御不可能だが、明確化によって最適化できる |
核心プラクティス
コンテキスト予算管理
コンテキストウィンドウを有限の「予算」と見なし、異なるタイプのコンテキストに合理的に割り当てます。
すべての情報がコンテキストスペースを占有する価値があるわけではなく、各コンテキストには明確なROIが必要です。
上下文预算分配建议(以 200K token 窗口为例):

系统提示  ██████████ 10% (20K token)
工具定义  ████████████████ 20% (40K token)
检索上下文 ████████████████████ 25% (50K token)
历史记录  ████████████████████████ 30% (60K token)
用户输入  ████████ 5%~10% (10-20K token)
预留缓冲  ████ 5% (10K token)
実際の割合は、Agentの具体的なタスクタイプに応じて動的に調整する必要があります。
Agentが主にコード生成を行う場合、検索コンテキストの割合を高く調整できます。
Agentがマルチターンダイアログアシスタントの場合、履歴の予算を優先的に確保すべきです。
システムプロンプトのエンジニアリング
システムプロンプトはAgentの動作の基盤であり、構造化された作成原則に従う必要があります。
作成原則:
| 原則 | 説明 | 例 |
|---|---|---|
| 階層的な整理 | 命令を役割、ルール、フロー、形式ごとにブロックに分割する | Markdown見出しで区切る |
| 肯定的な表現 | Agentに「どうすべきか」を伝え、「どうすべきでないか」ではない | 「回答は簡潔に保つ」は「くどくど話すな」よりも優れている |
| 例を提供する | 長文の説明の代わりにfew-shotの例を使用する | 出力形式の例はテキストによる説明よりも効率的である |
| 優先順位を明確にする | ルールが衝突した場合、Agentはどちらに従うべきか | 「安全ルールは効率要件よりも優先される」 |
| 冗長性の除去 | 一度もトリガーされたことのないルールや重複する説明を削除する | 定期的にシステムプロンプトをレビューし、簡素化する |
以下は、構造化されたシステムプロンプトのサンプルスケルトンです:
## 角色
你是一名 Python 代码审查助手。

## 核心规则
- 每个问题附上修复建议
- 按严重程度排序输出
- 不确定时标注「待确认」

## 工作流程
1. 分析代码变更
2. 按严重程度分类问题
3. 逐一输出问题与建议

## 输出格式
**问题**:[问题描述]
**严重程度**:[高/中/低]
**建议**:[修复建议]
ツール説明の最適化
ツール説明はコンテキストの最大の割合を占めることが多いですが、多くのツールは実際には一度も呼び出されません。
最適化戦略には以下が含まれます:
| 戦略 | 方法 | 効果 |
|---|---|---|
| ツールの削減 | 現在のタスクに関係のないツール定義を削除する | ツールコンテキストを30%〜50%削減する |
| 説明の洗練 | 各ツールについて、用途とパラメータを一文だけで説明する | モデルのツールに対する理解の正確さを向上させる |
| パラメータの制約 | 説明の中でパラメータの使用シーンと制限を明確にする | ツール呼び出しにおけるパラメータエラーを減らす |
| グループ別登録 | タスクの段階に応じて異なるツールセットを動的に登録する | ツールが多すぎることに起因する「選択困難」を回避する |
ツール定義はゼロでない限り負担となります。保持する各ツールは、説明の品質とトークンコストの間でトレードオフを行う必要があります。
履歴の圧縮戦略
マルチターンダイアログでは、履歴が急速に増加し、コンテキストを占有します。
コンテキストの完全性とウィンドウ制限のバランスを取るために、適切な圧縮戦略を選択する必要があります。
常见历史压缩策略对比:

策略     方法            适用场景
─────────────────────────────────────────────────
滑动窗口   保留最近 N 轮完整记录    短对话、实时交互
阶梯摘要   每轮做一次增量摘要     长对话、客服场景
分层摘要   近期保留完整、远期做摘要  文档生成、复杂任务
关键轮标记  标记重要轮次,其余丢弃   调试、分步执行任务
階層的要約が最も一般的な戦略です:直近の3〜5ターンは完全に保持し、それより前のダイアログは構造化された要約で置き換えます。
構造化された要約には、元のダイアログの重要な情報を含める必要があります:ユーザーの目標は何か、Agentが何をしたか、どのような出力が生成されたか、どのようなエラーが発生したか。
検索コンテキストの品質管理
Agentが外部の知識ベースに依存する場合、検索されたコンテキストの品質が出力品質を直接決定します。
検索コンテキストの品質を向上させるための重要なポイント:
| プロセス | よくある問題 | 改善方法 |
|---|---|---|
| クエリの書き換え | ユーザー入力が十分に正確でない | Agentにクエリを書き換えさせてから検索させる |
| 関連性フィルタリング | 検索結果に関連のない内容が含まれている | 関連性の閾値を設定し、不足している場合は積極的に通知する |
| 出典の明記 | Agentが情報の信頼性を判断できない | 出典パスと更新日時を添付する |
| 長さの切り詰め | 検索結果がコンテキストを過剰に占有する | 段落ごとに切り取り、最も関連性の高い断片を保持する |
一般的なパターン
段階的開示
すべての情報を一度にコンテキストに詰め込むのではなく、実行段階に応じて段階的に開示します。
初期コンテキストには、システムプロンプトと現在の段階に必要なツールのみを含め、Agentが現在の段階を完了した後、次の段階のツールとルールを注入します。
このパターンはコンテキストの「密度」を合理的な範囲に抑え、Agentが無関係な情報に干渉されるのを防ぎます。
コンテキスト圧縮チェーン
タスクが大量のデータを処理する必要がある場合、チェーン呼び出しで複数のステップに分割し、各ステップで重要な中間結果のみを保持します。
步骤1:读取全部日志文件 → 输出 { 错误数量,时间范围,错误类型列表 }

步骤2:基于步骤1的输出,分析 Top 3 错误 → 输出 { 根因分析,修复建议 }

步骤3:基于步骤2的输出,生成修复 PR → 输出 { PR 标题,描述,代码变更 }
各チェーンの入力は、元のデータではなく前のステップで精錬された要約であり、コンテキストを常に管理可能なサイズに保ちます。
コンテキストウォーターマーク
コンテキストの重要な位置に「ウォーターマーク」を配置し、Agentの動作の監視と診断に役立てます。
上下文水印示例:

<system-reminder>
当前使用的上下文策略版本:v2.3
检索到的文档来源:docs/api-reference/ 共 3 个文件
已消耗上下文:85,000 / 200,000 tokens
</system-reminder>
これらのウォーターマークはAgentの動作に直接影響しませんが、デバッグ時にコンテキスト注入が期待どおりに実行されたかを迅速に特定できます。
評価と反復
コンテキストエンジニアリングの効果は評価によって検証する必要があり、感覚だけで判断することはできません。
一般的に使用される評価の側面:
| 側面 | 評価方法 | 主要指標 |
|---|---|---|
| タスク完了率 | 標準テストセットでAgentを実行する | 成功率、失敗原因の分布 |
| コンテキスト効率 | 毎回の呼び出しのコンテキスト使用量を統計する | 平均トークン消費量、コンテキスト利用率 |
| ツール呼び出しの品質 | ツール呼び出しの正確率とパラメータの正解率を分析する | 無効な呼び出しの割合、再試行回数 |
| 応答の一貫性 | 同じ入力を複数回テストする | 出力の安定性、形式の準拠率 |
コンテキストエンジニアリングは一度きりの設定ではなく、「テスト → 分析 → 最適化 → 再テスト」という反復サイクルを確立する必要があります。
注意事項
コンテキストウィンドウは大きければ大きいほど良いわけではありません。過剰なコンテキストは、モデルの重要な情報への注意力を希薄化し、かえって出力品質を低下させます。
盲目的にルールを増やすと、システムプロンプトが肥大化し、自己矛盾する可能性があります。ルールを1つ追加するたびに、既存のルールと矛盾しないかをレビューする必要があります。
ツール定義の変更は既存のAgentの動作に影響を与える可能性があるため、変更後は典型的なシナリオでリグレッションテストを行う必要があります。
履歴圧縮ポリシーはAgentのタスク特性に基づいて選択する必要があり、1つのポリシーがすべてのシナリオで最適なパフォーマンスを発揮することは不可能です。
コンテキスト内の機密情報(APIキー、内部パスなど)はツール呼び出しやログで伝播するため、マスキング処理を適切に行う必要があります。
関連概念
| 概念 | 説明 |
|---|---|
| Prompt Engineering | 単一呼び出しに特化したプロンプトの設計と最適化 |
| Context Window | モデルが一度に処理できるトークン数の上限 |
| Token | モデルがテキストを処理する際の最小の意味単位 |
| RAG(検索拡張生成) | 外部検索によってコンテキストを拡張するアーキテクチャパターン |
| Few-shot Prompting | コンテキストに例を示してモデルの出力を導くこと |
| Chain-of-Thought | モデルにコンテキスト内で推論過程を示させること |