Ingeniería de contexto de Agent
Agent 上下文工程(Agent Context Engineering) es una práctica técnica para diseñar y optimizar sistemáticamente la información de contexto que se transmite a un Agent de IA. Su objetivo es que el Agent obtenga la información más eficaz dentro de la ventana de contexto limitada, mejorando así la precisión, la eficiencia y la fiabilidad de la ejecución de tareas.
Un Agent de IA no tiene una lógica de ejecución fija como los programas tradicionales; su comportamiento depende completamente del contexto que recibe, incluyendo las instrucciones del sistema, las descripciones de las herramientas, el historial de conversaciones y la información recuperada externamente.
El núcleo de la ingeniería de contexto consiste en responder a una pregunta:¿Qué es lo que más necesita saber el Agent en esta ronda de llamadas?
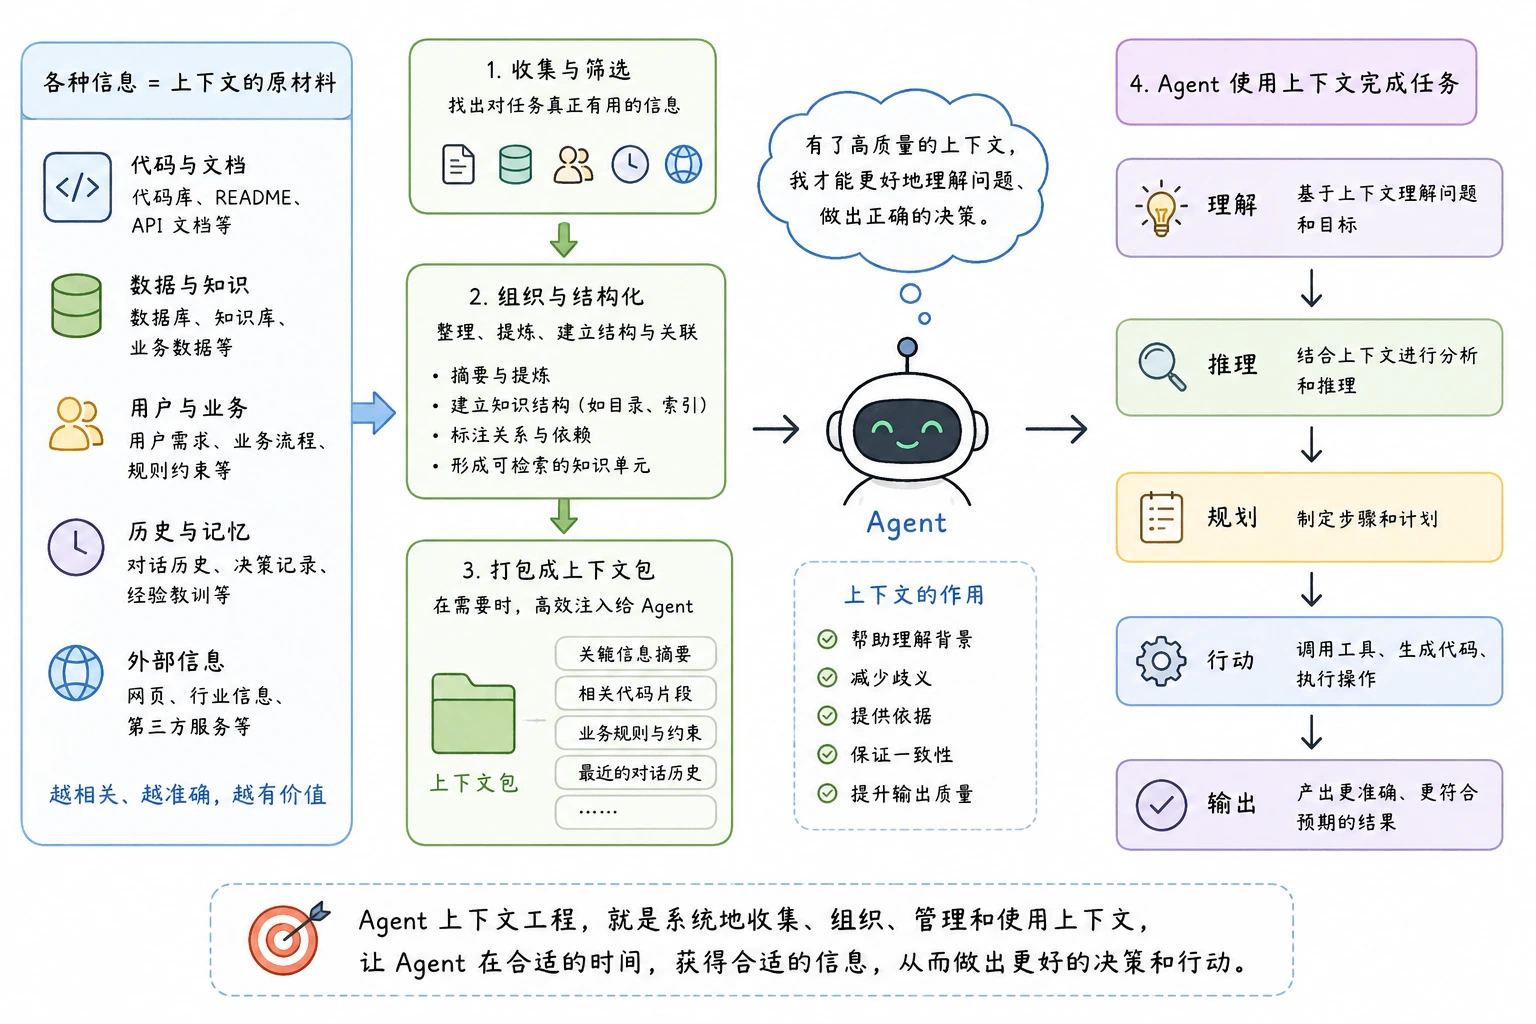
La ingeniería de contexto no consiste en redactar prompts de una sola vez, sino que es un proceso de optimización continua que abarca todo el ciclo de vida del desarrollo, las pruebas y el mantenimiento del sistema Agent.
Elementos clave
El contexto del Agent se compone de las siguientes capas:
| Nivel | Contenido | Características |
|---|---|---|
| Instrucciones del sistema (System Prompt) | Definición del rol, reglas de comportamiento, requisitos de formato de salida | Se incluye en cada llamada, es relativamente estable |
| Definiciones de herramientas (Tool Definitions) | Nombre, parámetros y descripción de la funcionalidad de las herramientas disponibles | Consume una gran cantidad de tokens, requiere simplificación |
| Historial (History) | Registro de conversaciones y llamadas a herramientas de la sesión actual | Crece continuamente, necesita estrategias de truncamiento o resumen |
| Contexto recuperado (Retrieved Context) | Contenido recuperado de una base de conocimientos o un repositorio de código externo | Se inyecta bajo demanda, requiere ordenación por relevancia |
| Entrada del usuario (User Input) | Instrucción o pregunta actual del usuario | No es controlable, pero se puede optimizar mediante aclaraciones |
Prácticas clave
Gestión del presupuesto de contexto
Tratar la ventana de contexto como un «presupuesto» limitado y asignarlo razonablemente a los diferentes tipos de contexto.
No toda la información merece ocupar espacio en el contexto; cada elemento de contexto debería tener un ROI claro.
上下文预算分配建议(以 200K token 窗口为例):

系统提示  ██████████ 10% (20K token)
工具定义  ████████████████ 20% (40K token)
检索上下文 ████████████████████ 25% (50K token)
历史记录  ████████████████████████ 30% (60K token)
用户输入  ████████ 5%~10% (10-20K token)
预留缓冲  ████ 5% (10K token)
Las proporciones reales deben ajustarse dinámicamente según el tipo de tarea específica del Agent.
Si el Agent se dedica principalmente a la generación de código, se puede aumentar la proporción del contexto recuperado.
Si el Agent es un asistente de conversación multipaso, se debe priorizar el presupuesto del historial.
Ingeniería de las instrucciones del sistema
Las instrucciones del sistema son la base del comportamiento del Agent y deben seguir principios de redacción estructurada.
Principios de redacción:
| Principio | Descripción | Ejemplo |
|---|---|---|
| Organización jerárquica | Dividir las instrucciones en bloques por rol, reglas, flujo y formato | Usar títulos de Markdown para separar |
| Formulación positiva | Decir al Agent qué debe hacer, no qué no debe hacer | «Mantén las respuestas concisas» es mejor que «no seas prolijo» |
| Proporcionar ejemplos | Usar ejemplos few-shot en lugar de descripciones extensas | Un ejemplo de formato de salida es más eficaz que una descripción textual |
| Prioridades claras | Qué regla debe seguir el Agent cuando hay conflictos entre reglas | «Las reglas de seguridad tienen prioridad sobre los requisitos de eficiencia» |
| Eliminar redundancias | Eliminar reglas que nunca se activan y descripciones repetidas | Revisar y simplificar periódicamente las instrucciones del sistema |
A continuación se muestra un esqueleto de ejemplo de instrucciones del sistema estructuradas:
## 角色
你是一名 Python 代码审查助手。

## 核心规则
- 每个问题附上修复建议
- 按严重程度排序输出
- 不确定时标注「待确认」

## 工作流程
1. 分析代码变更
2. 按严重程度分类问题
3. 逐一输出问题与建议

## 输出格式
**问题**:[问题描述]
**严重程度**:[高/中/低]
**建议**:[修复建议]
Optimización de las descripciones de herramientas
Las descripciones de herramientas suelen ocupar la mayor parte del contexto, pero muchas herramientas nunca se invocan realmente.
Las estrategias de optimización incluyen:
| Estrategia | Método | Efecto |
|---|---|---|
| Simplificación de herramientas | Eliminar las definiciones de herramientas que no están relacionadas con la tarea actual | Reducir del 30 % al 50 % el contexto de herramientas |
| Descripción concisa | Explicar el propósito y los parámetros de cada herramienta en una sola frase | Mejorar la precisión del modelo para entender las herramientas |
| Restricciones de parámetros | Especificar los escenarios de uso y las limitaciones de los parámetros en la descripción | Reducir errores de parámetros en las llamadas a herramientas |
| Registro por grupos | Registrar dinámicamente diferentes conjuntos de herramientas según la fase de la tarea | Evitar la «dificultad de elección» causada por un exceso de herramientas |
Toda definición de herramienta que no sea cero es una carga. Cada herramienta conservada requiere un equilibrio entre la calidad de la descripción y el coste de tokens.
Estrategias de compresión del historial
En las conversaciones multipaso, el historial crece rápidamente y ocupa contexto.
Es necesario elegir una estrategia de compresión adecuada para equilibrar la integridad del contexto y las limitaciones de la ventana.
常见历史压缩策略对比:

策略     方法            适用场景
─────────────────────────────────────────────────
滑动窗口   保留最近 N 轮完整记录    短对话、实时交互
阶梯摘要   每轮做一次增量摘要     长对话、客服场景
分层摘要   近期保留完整、远期做摘要  文档生成、复杂任务
关键轮标记  标记重要轮次,其余丢弃   调试、分步执行任务
El resumen jerárquico es la estrategia más utilizada: las últimas 3-5 rondas se mantienen completas y las conversaciones anteriores se sustituyen por resúmenes estructurados.
El resumen estructurado debe incluir la información clave de la conversación original: cuál era el objetivo del usuario, qué hizo el Agent, qué salida se produjo y qué errores se encontraron.
Control de calidad del contexto recuperado
Cuando el Agent depende de una base de conocimientos externa, la calidad del contexto recuperado determina directamente la calidad de la salida.
Puntos clave para mejorar la calidad del contexto recuperado:
| Etapa | Problemas comunes | Método de mejora |
|---|---|---|
| Reformulación de consultas | La entrada del usuario no es lo suficientemente precisa | Hacer que el Agent reformule la consulta antes de recuperar |
| Filtrado por relevancia | Los resultados de la recuperación contienen contenido irrelevante | Establecer un umbral de relevancia y avisar activamente cuando no se alcance |
| Indicación de la fuente | El Agent no puede juzgar la credibilidad de la información | Adjuntar la ruta de la fuente y la fecha de actualización |
| Recorte de longitud | Los resultados de la recuperación ocupan demasiado contexto | Recortar por párrafos y conservar los fragmentos más relevantes |
Patrones comunes
Divulgación progresiva
No introducir toda la información en el contexto de una sola vez, sino divulgarla progresivamente según la fase de ejecución.
El contexto inicial solo contiene las instrucciones del sistema y las herramientas necesarias para la fase actual; cuando el Agent completa la fase actual, se inyectan las herramientas y reglas de la siguiente fase.
Este patrón mantiene la «densidad» del contexto dentro de un rango razonable y evita que el Agent se vea interferido por información irrelevante.
Cadena de compresión de contexto
Cuando una tarea requiere procesar grandes cantidades de datos, se divide en varios pasos mediante llamadas en cadena, conservando solo los resultados intermedios clave en cada paso.
步骤1:读取全部日志文件 → 输出 { 错误数量,时间范围,错误类型列表 }

步骤2:基于步骤1的输出,分析 Top 3 错误 → 输出 { 根因分析,修复建议 }

步骤3:基于步骤2的输出,生成修复 PR → 输出 { PR 标题,描述,代码变更 }
La entrada de cada eslabón de la cadena es el resumen refinado del paso anterior, no los datos originales, de modo que el contexto se mantiene siempre en un tamaño controlable.
Marca de agua de contexto
Colocar marcadores «marca de agua» en posiciones clave del contexto para ayudar a monitorizar y diagnosticar el comportamiento del Agent.
上下文水印示例:

<system-reminder>
当前使用的上下文策略版本:v2.3
检索到的文档来源:docs/api-reference/ 共 3 个文件
已消耗上下文:85,000 / 200,000 tokens
</system-reminder>
Estas marcas de agua no afectan directamente al comportamiento del Agent, pero durante la depuración permiten localizar rápidamente si la inyección de contexto se ha ejecutado según lo previsto.
Evaluación e iteración
La eficacia de la ingeniería de contexto debe verificarse mediante evaluaciones; no se puede juzgar solo por intuición.
Dimensiones de evaluación habituales:
| Dimensión | Método de evaluación | Indicadores clave |
|---|---|---|
| Tasa de finalización de tareas | Ejecutar el Agent sobre un conjunto de pruebas estándar | Tasa de éxito, distribución de causas de fallo |
| Eficiencia del contexto | Contabilizar el uso de contexto en cada llamada | Consumo medio de tokens, tasa de utilización del contexto |
| Calidad de las llamadas a herramientas | Analizar la tasa de precisión de las llamadas a herramientas y la tasa de corrección de parámetros | Proporción de llamadas no válidas, número de reintentos |
| Consistencia de las respuestas | Probar varias veces con la misma entrada | Estabilidad de la salida, tasa de cumplimiento del formato |
La ingeniería de contexto no es una configuración única, sino que requiere establecer un bucle iterativo de «prueba → análisis → optimización → nueva prueba».
Consideraciones
La ventana de contexto no es mejor cuanto más grande. Un exceso de contexto diluye la atención del modelo sobre la información clave y, en cambio, reduce la calidad de la salida.
Añadir reglas a ciegas puede hacer que las instrucciones del sistema se vuelvan voluminosas y contradictorias. Cada nueva regla requiere revisar si entra en conflicto con las reglas existentes.
Los cambios en las definiciones de herramientas pueden afectar al comportamiento de los Agent existentes; tras modificarlos, es necesario realizar pruebas de regresión en escenarios típicos.
La estrategia de compresión del historial debe seleccionarse según las características de las tareas del Agent; ninguna estrategia puede lograr el mejor rendimiento en todos los escenarios.
La información sensible en el contexto (claves API, rutas internas, etc.) se propaga en las llamadas a herramientas y en los registros, por lo que es necesario aplicar un tratamiento de enmascaramiento.
Conceptos relacionados
| Concepto | Descripción |
|---|---|
| Prompt Engineering | Centrado en el diseño y la optimización de prompts para una única llamada |
| Context Window | Límite máximo de tokens que el modelo puede procesar de una sola vez |
| Token | Unidad semántica mínima que el modelo procesa del texto |
| RAG (generación aumentada por recuperación) | Patrón de arquitectura que amplía el contexto mediante recuperación externa |
| Few-shot Prompting | Proporcionar ejemplos en el contexto para guiar la salida del modelo |
| Chain-of-Thought | Permitir que el modelo muestre su proceso de razonamiento en el contexto |