Создание агентов на LangChain
LangChain — это фреймворк для создания приложений LLM, который превращает вызовы моделей в компонуемые, управляемые и масштабируемые прикладные системы.
LangChain решает не то, как вызывать модели, а:
- Как организовать многошаговые рассуждения
- Как интегрировать внешние данные
- Как инструменты могут безопасно вызываться моделями
- Как управлять контекстом в долгосрочной перспективе
Репозиторий с открытым исходным кодом:https://github.com/langchain-ai/langchain。
Учебник по LangChain:https://www.example.com/langchain/langchain-tutorial.html
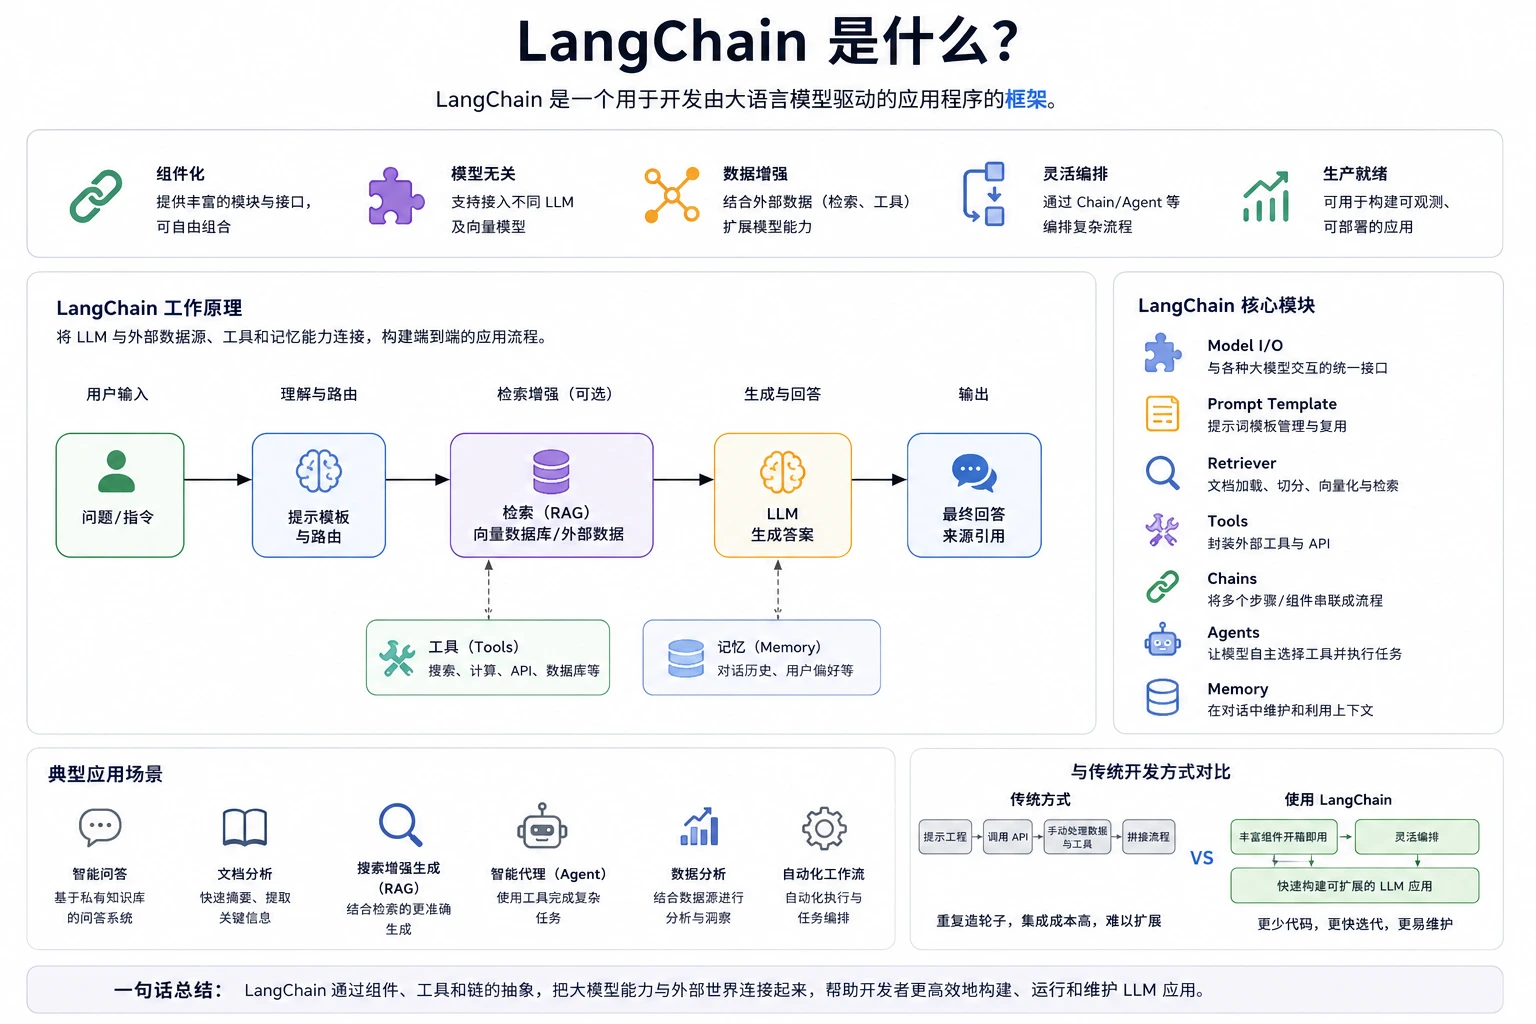
Представьте, что вы создаёте интеллектуального робота-помощника. Этот помощник должен понимать ваши вопросы, искать информацию из различных источников, выполнять логические рассуждения и в конце концов отвечать вам на естественном языке. Использование только языковой модели вроде GPT — это как дать роботу лишь умный мозг, но у него всё ещё нет рук и глаз — он не знает, как получать внешние данные или выполнять конкретные задачи.
LangChainЭто именно такой фреймворк, играющий роль соединителя и координатора.
LangChainОн умело связывает мощные языковые модели (такие как GPT-4, DeepSeek) с внешними источниками данных, вычислительными инструментами и системами памяти для создания мощных и практичных ИИ-приложений.
Проще говоря, основная ценность LangChain заключается в:сделать языковые модели полезными, что решает несколько ключевых ограничений больших языковых моделей (LLM):
- Знания в реальном времени: обучающие данные LLM имеют дату отсечения и не позволяют получать самую свежую информацию.
- Специализация в предметной области: общим LLM не хватает частных знаний, специфичных для отрасли или компании.
- Возможность действий: сами LLM не могут выполнять такие действия, как вычисления, запросы к базе данных, вызовы API и т. д.
- Связность диалога: в многоходовых диалогах LLM должны помнить предыдущую историю чата.
LangChain организует эти возможности через набор стандартизированных цепочек и компонентов, позволяя разработчикам быстро создавать сложные ИИ-приложения, как из строительных блоков.
Обзор модулей LangChain:
- LLMs / ChatModels: Интерфейсы моделей
- Шаблоны промптов: Структурирование промптов
- Цепочки: Оркестрация рабочих процессов
- Память: Управление контекстом
- Ретриверы / Векторные хранилища: Извлечение знаний
- Агенты & инструменты: Автоматическое принятие решений и выполнение
Подготовка окружения
Установите с использованием отечественного зеркала:
pip install langchain langchain-openai langchain-community python-dotenv -i https://mirrors.aliyun.com/pypi/simple/
Если вы используете OpenAI, вы можете настроить переменные среды:
export OPENAI_API_KEY=你的key
Затем проверьте с помощью следующего кода:
Пример
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
resp = llm.invoke("Объясните, что такое LangChain, одним предложением")
print(resp.content)
В Китае мы можем использовать большую модель DeepSeek для тестирования. Если у вас его ещё нет, сначала нужно перейти наhttps://platform.deepseek.com/api_keysСоздайте API-ключ.
Справочник по документации API DeepSeek:https://api-docs.deepseek.com/zh-cn/。
Если вам нужно централизованно управлять несколькими сторонними моделями, вы можете установить LiteLLM в качестве шлюза моделей:
pip install -U litellm
Однако примеры в этой статье напрямую используютChatOpenAIвместе сopenai_api_baseпараметр для подключения к DeepSeek без необходимости отдельно устанавливать LiteLLM.
Пример
from langchain_openai import ChatOpenAI
# Рекомендуется хранить API-ключ в переменной окружения или задать его прямо здесь (не встраивайте его в код в продакшене).
# os.environ["DEEPSEEK_API_KEY"] = "sk-your-DeepSeek-secret-key"
# Инициализация модели
llm = ChatOpenAI(
model="deepseek-v4-pro", # Название модели DeepSeek V4
openai_api_key="sk-your-Key", # Укажите ваш API-ключ DeepSeek
openai_api_base="https://api.deepseek.com", # Эндпоинт API DeepSeek
temperature=0.7,
max_tokens=1024
)
# Проверьте это
response = llm.invoke("Привет, DeepSeek! Пожалуйста, представься кратко.")
print(response.content)
Выполнение приведённого выше кода выведет:
你好!很高兴认识你!

我是DeepSeek,由深度求索公司创造的AI助手。我的特点包括:
。。。
Построение цепочек LCEL (LangChain Expression Language)
Одного вызова модели недостаточно; нужно построить стандартный конвейер обработки:
Prompt -> LLM -> OutputParser
Полный код приведён ниже:
Пример
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI
# 1. Определите модель (Model)
llm = ChatOpenAI(
model="deepseek-v4-pro",
openai_api_key="your_DEEPSEEK_API_KEY",
openai_api_base="https://api.deepseek.com"
)
# 2. Определите шаблон промпта (Prompt)
# system: Установите роль ИИ
# user: Конкретный ввод пользователя
prompt = ChatPromptTemplate.from_messages([
("system", "Вы — старший технический эксперт, который мастерски объясняет сложные технологические концепции простым и понятным языком. Ваше объяснение должно включать яркую аналогию."),
("user", "{concept}")
])
# 3. Определите парсер вывода (Output Parser)
# Напрямую преобразуйте объект Message модели в обычную строку
parser = StrOutputParser()
# 4. Постройте цепочку (Chain) — используйте оператор конвейера | для соединения
# Поток: входной словарь -> заполнить Prompt -> отправить в LLM -> разобрать вывод
chain = prompt | llm | parser
# 5. Вызовите Chain
concept_to_explain = Квантовая запутанность
print(fОбъяснение концепции: {concept_to_explain}...\n")
result = chain.invoke({"concept": concept_to_explain})
print(--- Ответ DeepSeek ---)
print(result)
Потоковый вывод
В реальных приложениях (таких как чат-боты) нам нужно выводить текст символ за символом, как ChatGPT, а не отображать его целиком после завершения генерации.
LangChain поддерживает это очень просто, используя.stream()вместо.invoke():
Пример
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI
# 1. Определяем модель
llm = ChatOpenAI(
model="deepseek-v4-pro",
openai_api_key=your_DEEPSEEK_API_KEY,
openai_api_base="https://api.deepseek.com"
)
# 2. Определяем шаблон промпта
# system: Установите роль ИИ
# user: Конкретный ввод пользователя
prompt = ChatPromptTemplate.from_messages([
("system", "Вы опытный технический эксперт, умеющий объяснять сложные технические концепции простым, легко понятным 'повседневным языком'. Ваше объяснение должно включать яркую метафору."),
("user", "{concept}")
])
# 3. Определяем парсер вывода
# Напрямую преобразуем объект Message модели в обычную строку
parser = StrOutputParser()
# 4. Построение цепочки — используя pipe | для соединения
# Поток: входной словарь -> заполнить Prompt -> отправить в LLM -> разобрать вывод
chain = prompt | llm | parser
# 5. Вызовите Chain
concept_to_explain = Квантовая запутанность
print(fОбъяснение концепции: {concept_to_explain} (потоковый вывод)...\n")
# Здесь chunk — это фрагмент, генерируемый каждый раз
for chunk in chain.stream({"concept": Рекурсивная нейронная сеть}):
print(chunk, end="", flush=True)
Структура кода
Промпт
ChatPromptTemplateЧетко различайтеsystem / user- Промпт — этоструктурированная функция ввода, а не строка
LLM
ChatOpenAIпросто унифицированный интерфейс- LangChain не расширяет возможности модели, а лишь повышаетуправляемость
OutputParser
- Вывод модели всегда
Message StrOutputParserДаявное преобразование типа- Без парсера проект неуправляем.
Объяснение основных компонентов
1. Модели
LangChain предоставляет унифицированный интерфейс абстракции. В настоящее время в основном рекомендуется использоватьChat Models, потому что текущие модели (такие как DeepSeek, GPT-4) в основном оптимизированы для диалога.
- Chat Models: Вход и выход — это структурированные сообщения.
SystemMessage: Установить роль ИИ.HumanMessage: Сообщения, отправленные пользователем.AIMessage: Сообщение, возвращённое ИИ.
2. Промпты
В новой версии рекомендуется использоватьChatPromptTemplateдля создания диалоговых промптов, что лучше соответствует соглашениям вызова современных распространённых LLM.
from langchain_core.prompts import ChatPromptTemplate

# 使用 from_messages 构建结构化模板
prompt_template = ChatPromptTemplate.from_messages([
    ("system", "你是一位专业的{role}。"),
    ("user", "{content}")
])

# 动态填充变量
prompt = prompt_template.invoke({"role": "美食评论家", "content": "评价一下这碗炸酱面"})
# 输出:包含 SystemMessage 和 HumanMessage 的列表
3. Цепочки и LCEL
Важные обновления: LLMChainустарел. Теперь используйтеLCEL (оператор конвейера|)синтаксис. Этот подход более гибкий и поддерживает асинхронный и потоковый вывод.
# 现代写法:Prompt | Model | OutputParser
from langchain_core.output_parsers import StrOutputParser

# 这里的 llm 是 ChatOpenAI(model="deepseek-v4-pro") 的实例
chain = prompt_template | llm | StrOutputParser()

# 调用链
result = chain.invoke({"role": "导游", "content": "介绍一下故宫"})
print(result) # 直接输出字符串
4. Индексы и поиск
В основе этого лежитRAG (генерация, дополненная поиском). Новая версия делает акцент на процессе преобразования документов в "retrievers".
- Process:
DocumentLoaders(Загрузка) ->TextSplitter(Разбиение на фрагменты) ->Embeddings(Векторизация) ->VectorStore(Хранение). - Retriever: это больше не просто поиск по базе данных; это компонент, который можно интегрировать в цепочку.
# 将向量库转为检索器
retriever = vectorstore.as_retriever()
# 在新版链中引用
# chain = {"context": retriever, "question": RunnablePassthrough()} | prompt | llm
Полный практический пример RAG
Ниже мы реализуем полноценное RAG-приложение. Сначала нам нужно установить дополнительные зависимости:
pip install langchain-community faiss-cpu sentence-transformers -i https://mirrors.aliyun.com/pypi/simple/
Пример
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_community.embeddings import HuggingFaceEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
from langchain_community.vectorstores import FAISS
from langchain.text_splitter import RecursiveCharacterTextSplitter
# Загрузить переменные окружения
load_dotenv()
# Инициализация модели и Embedding
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
)
# Использовать бесплатную локальную модель Embedding (автоматически загружается при первом запуске)
embeddings = HuggingFaceEmbeddings(
model_name="sentence-transformers/all-MiniLM-L6-v2"
)
# --- 1. Подготовка документов знаний ---
# В реальных проектах эти документы можно загружать из файлов, веб-страниц, баз данных и т. д.
документы = [
"LangChain — это фреймворк с открытым исходным кодом для создания приложений на основе больших языковых моделей, созданный Харрисоном Чейзом в 2022 году.",
"Основные компоненты LangChain включают: интерфейсы моделей, шаблоны промптов, цепочки, память, поиск и агентов.",
"LCEL (LangChain Expression Language) — это синтаксис построения цепочек нового поколения в LangChain, использующий оператор конвейера | для соединения компонентов.",
"RAG (Retrieval-Augmented Generation) извлекает релевантные документы перед генерацией, что позволяет LLM отвечать на вопросы за пределами обучающих данных.",
"LangGraph — это новый фреймворк, выпущенный командой LangChain специально для создания сложных многошаговых рабочих процессов AI-агентов.",
"LangSmith — это платформа наблюдаемости LangChain для отладки, тестирования и мониторинга LLM-приложений.",
]
# --- 2. Разбиение текста на фрагменты ---
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=100,
chunk_overlap=20
)
# Документы здесь уже короткие; в реальных сценариях длинные документы разбиваются на несколько сегментов
texts = text_splitter.create_documents(documents)
# --- 3. Векторизовать и сохранить в FAISS ---
vectorstore = FAISS.from_documents(texts, embeddings)
# --- 4. Создать retriever ---
retriever = vectorstore.as_retriever(search_kwargs={"k": 2})
# --- 5. Построить RAG-цепочку ---
rag_prompt = ChatPromptTemplate.from_messages([
("system", Вы — помощник по знаниям. Ответьте на вопрос, основываясь на приведённом ниже контексте. Если ответа нет в контексте, скажите, что не знаете.\n\nКонтекст: {context}),
("human", "{question}")
])
# Вспомогательная функция: объединить извлечённые документы в строку
def format_docs(docs):
return "\n".join(doc.page_content for doc in docs)
rag_chain = (
{"context": retriever | format_docs, "question": RunnablePassthrough()}
| rag_prompt
| llm
| StrOutputParser()
)
# --- 6. Тестирование RAG ---
question = Какие основные компоненты LangChain?
print(fВопрос: {question})
print(fОтвет: {rag_chain.invoke(question)})
- FAISSЭто открытая библиотека поиска векторного сходства от Facebook, подходящая для локальной разработки и тестирования; данные хранятся в памяти.
- Производственная средаРекомендуется использовать профессиональные векторные базы данных, такие как Pinecone, Milvus, Chroma и Weaviate, которые поддерживают персистентность и распределённое развёртывание.
- Модель эмбеддингов: : В этом примере используется HuggingFace
all-MiniLM-L6-v2Модель: будет автоматически загружена при первом запуске (примерно 80MB). - Если у вас есть ключ OpenAI API, вы также можете его использовать.
OpenAIEmbeddingsПолучите лучшие результаты на китайском языке. - Рекомендуется для китайских сценариев внутри страны.
BAAI/bge-small-zh-v1.5и т.д. китайские модели эмбеддингов - chunk_sizeиchunk_overlapНужно настраивать в соответствии с фактическими характеристиками документа; слишком большой размер может привести к потере точности, слишком маленький — к потере контекста.
5. Память
Важное обновление:традиционныйConversationBufferMemoryЕго относительно сложно интегрировать в сложные цепочки LCEL. Последняя рекомендация — использоватьChatMessageHistoryвзаимодействиеRunnableWithMessageHistory。
- Основная логикаПамять больше не является свойством цепочки, а независимым хранилищем сообщений, через
session_idРазличать разных пользователей. - персистентностьПоддерживает сохранение в Redis, PostgreSQL или в память.
6. Агенты
Агент — одна из самых мощных возможностей LangChain. В отличие от Chain, агенты могут действовать на основе ввода пользователя.Автономное принятие решенийКакие инструменты вызывать и в каком порядке выполнять — это и есть настоящий "агент".
Основной цикл агента: получить задачу -> подумать (выбрать инструмент) -> выполнить инструмент -> наблюдать результат -> продолжить размышление или дать окончательный ответ.
Использование@toolДекоратор может превратить любую функцию Python в инструмент, вызываемый LLM. LangChain автоматически передаёт имя функции и строку документации модели, позволяя модели узнать, когда и как использовать этот инструмент.
Ниже приведён полный практический пример агента, содержащий три инструмента: запрос погоды, математические вычисления и поиск знаний:
Пример
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.tools import tool
from langchain.agents import AgentExecutor, create_tool_calling_agent
# Загрузить переменные окружения
load_dotenv()
# Инициализация модели DeepSeek
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
)
# --- Определение инструментов ---
# Используя декоратор @tool, LangChain автоматически сообщает модели имя функции и строку документации
@tool
def get_current_weather(city: str) -> str:
"""Получить текущую информацию о погоде для указанного города. Используйте этот инструмент, когда пользователь спрашивает о погоде."""
# В реальных приложениях здесь вызывался бы настоящий API погоды.
weather_data = {
"Пекин": "Солнечно, температура 28°C, влажность 45%",
"Шанхай": "Облачно, температура 25°C, влажность 70%",
"Шэньчжэнь": "Ливни с грозой, температура 30°C, влажность 85%",
}
return weather_data.get(city, f"Извините, для {city} нет данных о погоде.")
@tool
def calculate(expression: str) -> str:
"""Вычисляет математические выражения. Используйте этот инструмент, когда пользователю нужно выполнить математические вычисления.
Поддерживает четыре основные арифметические операции, например, '2 + 3 * 4'."""
import ast
import operator
# Безопасное сопоставление операторов
ops = {
ast.Add: operator.add,
ast.Sub: operator.sub,
ast.Mult: operator.mul,
ast.Div: operator.truediv,
ast.Pow: operator.pow,
ast.USub: operator.neg,
}
def safe_eval(node):
if isinstance(node, ast.Expression):
return safe_eval(node.body)
elif isinstance(node, ast.Constant):
return node.value
elif isinstance(node, ast.BinOp):
left = safe_eval(node.left)
right = safe_eval(node.right)
return ops[type(node.op)](left, right)
elif isinstance(node, ast.UnaryOp):
operand = safe_eval(node.operand)
return ops[type(node.op)](operand)
else:
raise ValueError(f"Неподдерживаемый тип выражения: {type(node)}")
try:
tree = ast.parse(expression, mode='eval')
result = safe_eval(tree)
return f"Результат вычисления: {expression} = {result}"
except Exception as e:
return f"Ошибка вычисления: {e}"
@tool
def search_knowledge(query: str) -> str:
"""Поиск в базе знаний для получения релевантной информации. Используйте этот инструмент, когда пользователь задаёт фактические вопросы."""
# В реальных приложениях это подключалось бы к векторной базе данных или поисковому движку.
knowledge = {
"LangChain": LangChain — это фреймворк с открытым исходным кодом для создания приложений на LLM, поддерживающий цепочки вызовов, управление памятью и интеграцию инструментов.,
"Python": Python — это высокоуровневый язык программирования, известный своей простотой и удобочитаемостью, широко используемый в ИИ, науке о данных и других областях.,
}
for key, value in knowledge.items():
if key.lower() in query.lower():
return value
return f"Информация, связанная с '{query}', не найдена"
# --- Сборка списка инструментов ---
tools = [get_current_weather, calculate, search_knowledge]
# --- Создание промпта агента ---
prompt = ChatPromptTemplate.from_messages([
("system", Вы — мощный ИИ-ассистент, который умеет использовать инструменты для помощи пользователям. Основываясь на вопросе пользователя, определите, нужен ли инструмент, и выберите наиболее подходящий инструмент для получения информации.),
("human", "{input}"),
MessagesPlaceholder(variable_name="agent_scratchpad"),
])
# --- Создание агента ---
agent = create_tool_calling_agent(llm, tools, prompt)
# --- Создание AgentExecutor (исполнитель агента) ---
# verbose=True позволяет увидеть полный процесс размышления агента
agent_executor = AgentExecutor(agent=agent, tools=tools, verbose=True)
# --- Тестовый агент ---
# Тест 1: запрос погоды
print("=" * 50)
response = agent_executor.invoke({"input": Какая сегодня погода в Пекине?})
print(f"\nИтоговый ответ: {response['output']}")
# Тест 2: математическое вычисление
print("\n" + "=" * 50)
response = agent_executor.invoke({"input": Помоги мне вычислить, чему равно (15 * 37 + 228) / 3})
print(f"\nИтоговый ответ: {response['output']}")
# Тест 3: Комплексный вопрос (Агенту нужно решить, какой инструмент использовать)
print("\n" + "=" * 50)
response = agent_executor.invoke({"input": Что такое LangChain? Также помоги мне вычислить 2 в 10-й степени.})
print(f"\nИтоговый ответ: {response['output']}")
Запустите приведённый выше код, и вы увидите(вывод цепочки рассуждений при verbose=True):
==================================================

> Entering new AgentExecutor chain...
Invoking: `get_current_weather` with `{'city': '北京'}`

晴天,气温 28°C,湿度 45%

根据查询结果,北京今天的天气是晴天,气温 28°C,湿度 45%。

> Finished chain.

Final answer: 北京今天天气晴朗,气温 28°C,湿度 45%,适合外出活动。

==================================================

> Entering new AgentExecutor chain...
Invoking: `calculate` with `{'expression': '(15 * 37 + 228) / 3'}`

计算结果:(15 * 37 + 228) / 3 = 261.0

> Finished chain.

Final answer: (15 * 37 + 228) / 3 的计算结果是 261.0

==================================================

> Entering new AgentExecutor chain...
Invoking: `search_knowledge` with `{'query': 'LangChain'}`
Invoking: `calculate` with `{'expression': '2 ** 10'}`

LangChain 是一个用于构建 LLM 应用的开源框架...
计算结果:2 ** 10 = 1024

> Finished chain.

Final answer: LangChain 是一个用于构建 LLM 应用的开源框架,支持链式调用、记忆管理和工具集成。另外,2 的 10 次方等于 1024。
verbose=TrueЭто позволяет увидеть полную цепочку решений агента, что упрощает отладку и понимание его поведения.- Агент автоматически определяет, какие инструменты вызывать, без необходимости вручную указывать порядок вызова.
- Если вопрос не требует инструментов (например, простой светский разговор), Агент ответит напрямую, используя собственные знания.
- Для сложных задач Агент может вызывать инструменты несколько раз или даже вызывать несколько инструментов параллельно.
Быстрый старт: создайте своё первое приложение LangChain
Давайте на простом примере убедимся в удобстве LangChain.
В реальной разработке мы можем сохранять информацию, связанную с API, в корневом каталоге проекта.envв файле, для удобства использования.
# .env 文件内容
DEEPSEEK_API_KEY=sk-xxx
DEEPSEEK_BASE_URL=https://api.deepseek.com
DEEPSEEK_MODEL=deepseek-v4-pro
Пример 1: базовая цепочка вопросов и ответов
Пример
from dotenv import load_dotenv
# Правильный путь импорта
from langchain_core.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_openai import ChatOpenAI
# Загрузить переменные окружения
load_dotenv()
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL'),
)
# Создать шаблон промпта
template = """
Вы — дружелюбный ассистент.
Пожалуйста, ответьте на следующий вопрос:
Вопрос: {question}
Ответ:
"""
prompt = PromptTemplate.from_template(template)
# Создать цепочку с использованием синтаксиса LCEL (рекомендуемый подход)
# Структура: Промпт -> LLM -> преобразование в строку
chain = prompt | llm | StrOutputParser()
# Запустить цепочку
question = "Что такое LangChain? Каковы его основные варианты использования?"
response = chain.invoke({"question": question})
print("Вопрос:", question)
print("-" * 20)
print("Ответ:", response)
Пример 2: цепочка разговора с памятью
Давайте создадим простого чат-бота, который может запоминать историю разговора.
Пример
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_community.chat_message_histories import ChatMessageHistory
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.runnables.history import RunnableWithMessageHistory
# 1. Загрузить конфигурацию
load_dotenv()
# 2. Инициализировать модель DeepSeek
llm = ChatOpenAI(
model=os.getenv('DEEPSEEK_MODEL', 'deepseek-v4-pro'),
openai_api_key=os.getenv('DEEPSEEK_API_KEY'),
openai_api_base=os.getenv('DEEPSEEK_BASE_URL', 'https://api.deepseek.com'),
)
# 3. Определить шаблон промпта
# MessagesPlaceholder будет заполнен историей диалога во время выполнения
prompt = ChatPromptTemplate.from_messages([
("system", "Вы — полезный помощник ИИ."),
MessagesPlaceholder(variable_name="history"),
("human", "{question}"),
])
# 4. Постройте цепочку
chain = prompt | llm
# 5. Управление памятью: создайте словарь для хранения записей истории для разных пользователей
store = {}
def get_session_history(session_id: str) -> BaseChatMessageHistory:
if session_id not in store:
store[session_id] = ChatMessageHistory()
return store[session_id]
# 6. Оберните нашу цепочку с помощью RunnableWithMessageHistory
# Таким образом LangChain будет автоматически обрабатывать чтение и обновление записей истории
with_message_history = RunnableWithMessageHistory(
chain,
get_session_history,
input_messages_key="question",
history_messages_key="history",
)
# 7. Вход в цикл диалога
print("--- Вы вошли в режим чата DeepSeek (введите 'exit' для выхода) ---")
session_config = {"configurable": {"session_id"⟦⟧"user_001": "user_001"}} # Различайте ID разных сессий
while True:
user_input = input("Вы: ")
if user_input.lower() in ["exit", "quit", "exit"]:
break
# Вызов цепочки с памятью
response = with_message_history.invoke(
{"question": user_input},
config=session_config
)
print(f"AI: {response.content}\n")
Запустите приведённый выше код, и вы увидите:
--- 已进入 DeepSeek 聊天模式 (输入 'exit' 退出) ---
You: 你好
AI: 你好!很高兴见到你! 有什么我可以帮助你的吗?无论是回答问题、聊天,还是协助解决问题,我都很乐意为你提供帮助!

You: 我叫小明
AI: 你好,小明!很高兴认识你!
如果你有任何问题、想法,或者需要帮助的地方,随时告诉我哦~

You: 我叫什么记得吗?
AI: 当然记得!你刚刚告诉我你叫**小明**~
我会认真记住我们的对话内容,在之后的交流中尽量保持上下文连贯。不过如果对话过长或间隔太久,我可能需要你提醒一下哦~
有什么想聊的或需要帮助的吗?
Итог
В этой статье представлены основные концепции и практические применения фреймворка LangChain. LangChain позволяет разработчикам быстро создавать мощные ИИ-приложения с помощью стандартизированных компонентов и цепочек вызовов.
В следующей таблице обобщены ключевые моменты, рассмотренные в этой статье:
| Концепция | Описание | Ключевой код |
|---|---|---|
| Цепочка LCEL | Используйте оператор конвейера | для соединения Prompt, Model, Parser | chain = prompt | llm | parser |
| Шаблон промпта | Структурированный промпт с различением ролей system/user | ChatPromptTemplate.from_messages() |
| Потоковый вывод | Пословный вывод для улучшения пользовательского опыта | chain.stream() |
| Память диалога | Управление историей многоходового диалога через session_id | RunnableWithMessageHistory |
| RAG: генерация, дополненная поиском | Интеграция внешних знаний для преодоления границ знаний LLM | retriever | format_docs |
| Агент | Автономное принятие решений о вызове инструментов — важнейшая продвинутая возможность | create_tool_calling_agent() |