Вводное руководство по Dify
Dify (Do It For You) в настоящее время является самой популярной открытой платформой разработки LLM-приложений, специально предназначенной для создания генеративных ИИ-приложений на основе больших языковых моделей (LLM).
Dify объединяет оркестрацию рабочих процессов ИИ, базы знаний RAG, фреймворки агентов, управление моделями и наблюдаемость в единую визуальную платформу, позволяя быстро перейти от прототипа к продакшену без создания инфраструктуры LLM с нуля.
Dify упрощает создание ИИ-приложений, объединяя RAG-конвейеры, рабочие процессы ИИ, инструменты наблюдаемости и управление моделями.
Если LangChain — этофабрика деталей для ИИ-приложений(гибкая, но требует много рукописного кода), то Dify — этовизуальная IDE для ИИ-приложений—все компоненты на месте, просто перетащите, соедините и запустите.
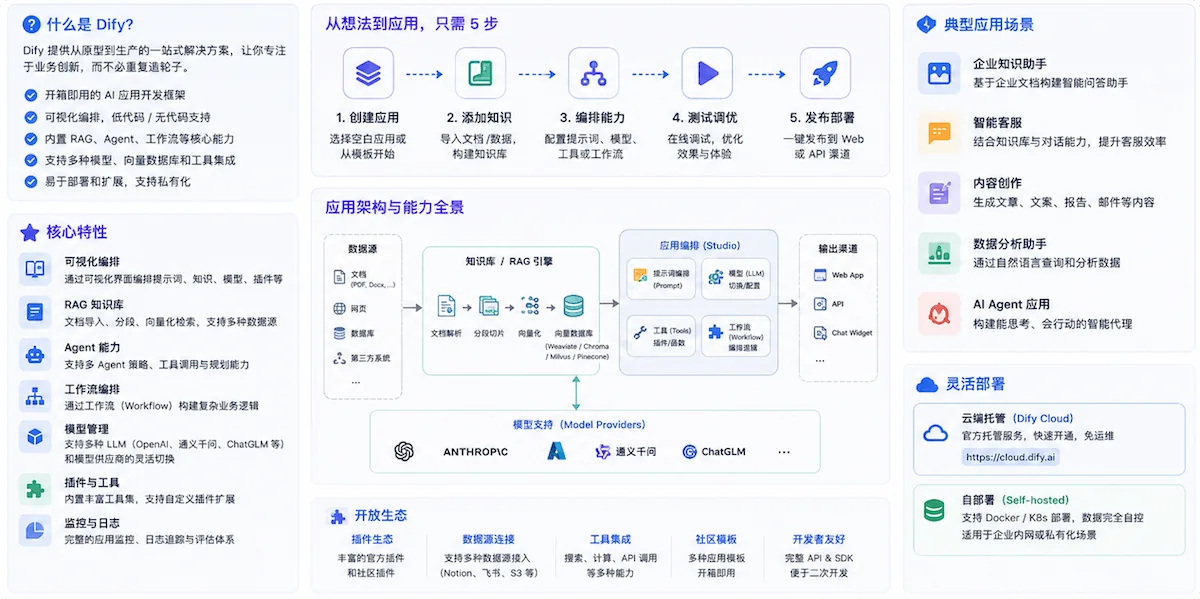
Сравнение с другими инструментами
Ниже приведено сравнение Dify с LangChain и n8n по ключевым параметрам.
| Измерение | Dify | LangChain | n8n |
|---|---|---|---|
| Основные пользователи | Разработчик + продакт-менеджер | разработчик | Операции/Автоматизация |
| Требования к программированию | Low-code / No-code | Требуется писать на Python/JS | low-code |
| Встроенный RAG | Полностью встроенный | Требуется ручная сборка | Ограниченно |
| Фреймворк агентов | Встроенный | Встроенный | Ограниченно |
| Наблюдаемость | Встроенный | Требуется стороннее решение | Ограниченно |
| Самостоятельное размещение | Полностью поддерживается | Поддерживается | Поддерживается |
| Лицензия | Apache 2.0 | MIT | Fair-code |
Интуитивная студия визуальной оркестрации Dify делает её идеальным выбором для стартапов и предприятий, которым нужно быстро создавать функциональные AI-приложения.
LangChain лучше подходит для сложных приложений корпоративного уровня, требующих кастомных интеграций и глубокого участия разработчиков.
Кто использует Dify?
От биомедицины до автомобильной промышленности Dify предоставляет надёжные решения для широкого круга предприятий.
Volvo Cars использует Dify для быстрой проверки идей в навигации по стратегии передовых AI-направлений.
Пользователи высоко ценят Dify за демократизацию разработки AI-агентов путём объединения мощных возможностей AI/ML в no-code платформе.
Основные концепции
Прежде чем начать, давайте разберёмся с базовыми концепциями Dify:
| Концепция | Описание |
|---|---|
| Приложение | Базовая единица развёртывания в Dify. Каждое приложение соответствует независимой AI-функции со своим System Prompt, связанной базой знаний, конфигурацией инструментов и API Key. |
| База знаний | База знаний — это ваша собственная коллекция данных, которую можно интегрировать в AI-приложения. Она предоставляет LLM ваши собственные данные как дополнительный источник истины при ответе, что делает ответы более точными, более релевантными и менее подверженными галлюцинациям. |
| RAG (генерация с дополненной выборкой) | Когда пользователь задаёт вопрос, система сначала извлекает наиболее релевантную информацию из базы знаний (Retrieval), затем объединяет полученные результаты с исходным вопросом пользователя и отправляет их в LLM (Augmented), а LLM генерирует более точный ответ на основе этого контекста (Generation). |
| Рабочий процесс | Создавайте и тестируйте мощные AI-воркфлоу на визуальном холсте, определяя многошаговую логику обработки AI путём перетаскивания узлов и соединения линий. |
| Агент | Агенты могут быть определены на основе LLM Function Calling или ReAct, к ним можно добавлять готовые или пользовательские инструменты. Dify предоставляет более 50 встроенных инструментов для AI-агентов, таких как Google Search, DALL E, Stable Diffusion и WolframAlpha. |
| Узел | Базовая единица рабочего процесса; каждый узел выполняет определённую операцию: рассуждение LLM, извлечение знаний, выполнение кода, HTTP-запросы, условное ветвление и т. д. |
Установка и запуск
Четыре способа установки: от мгновенного запуска до развёртывания высокодоступного кластера.
Способ 1: Dify Cloud (самый быстрый, начало работы за 0 секунд)
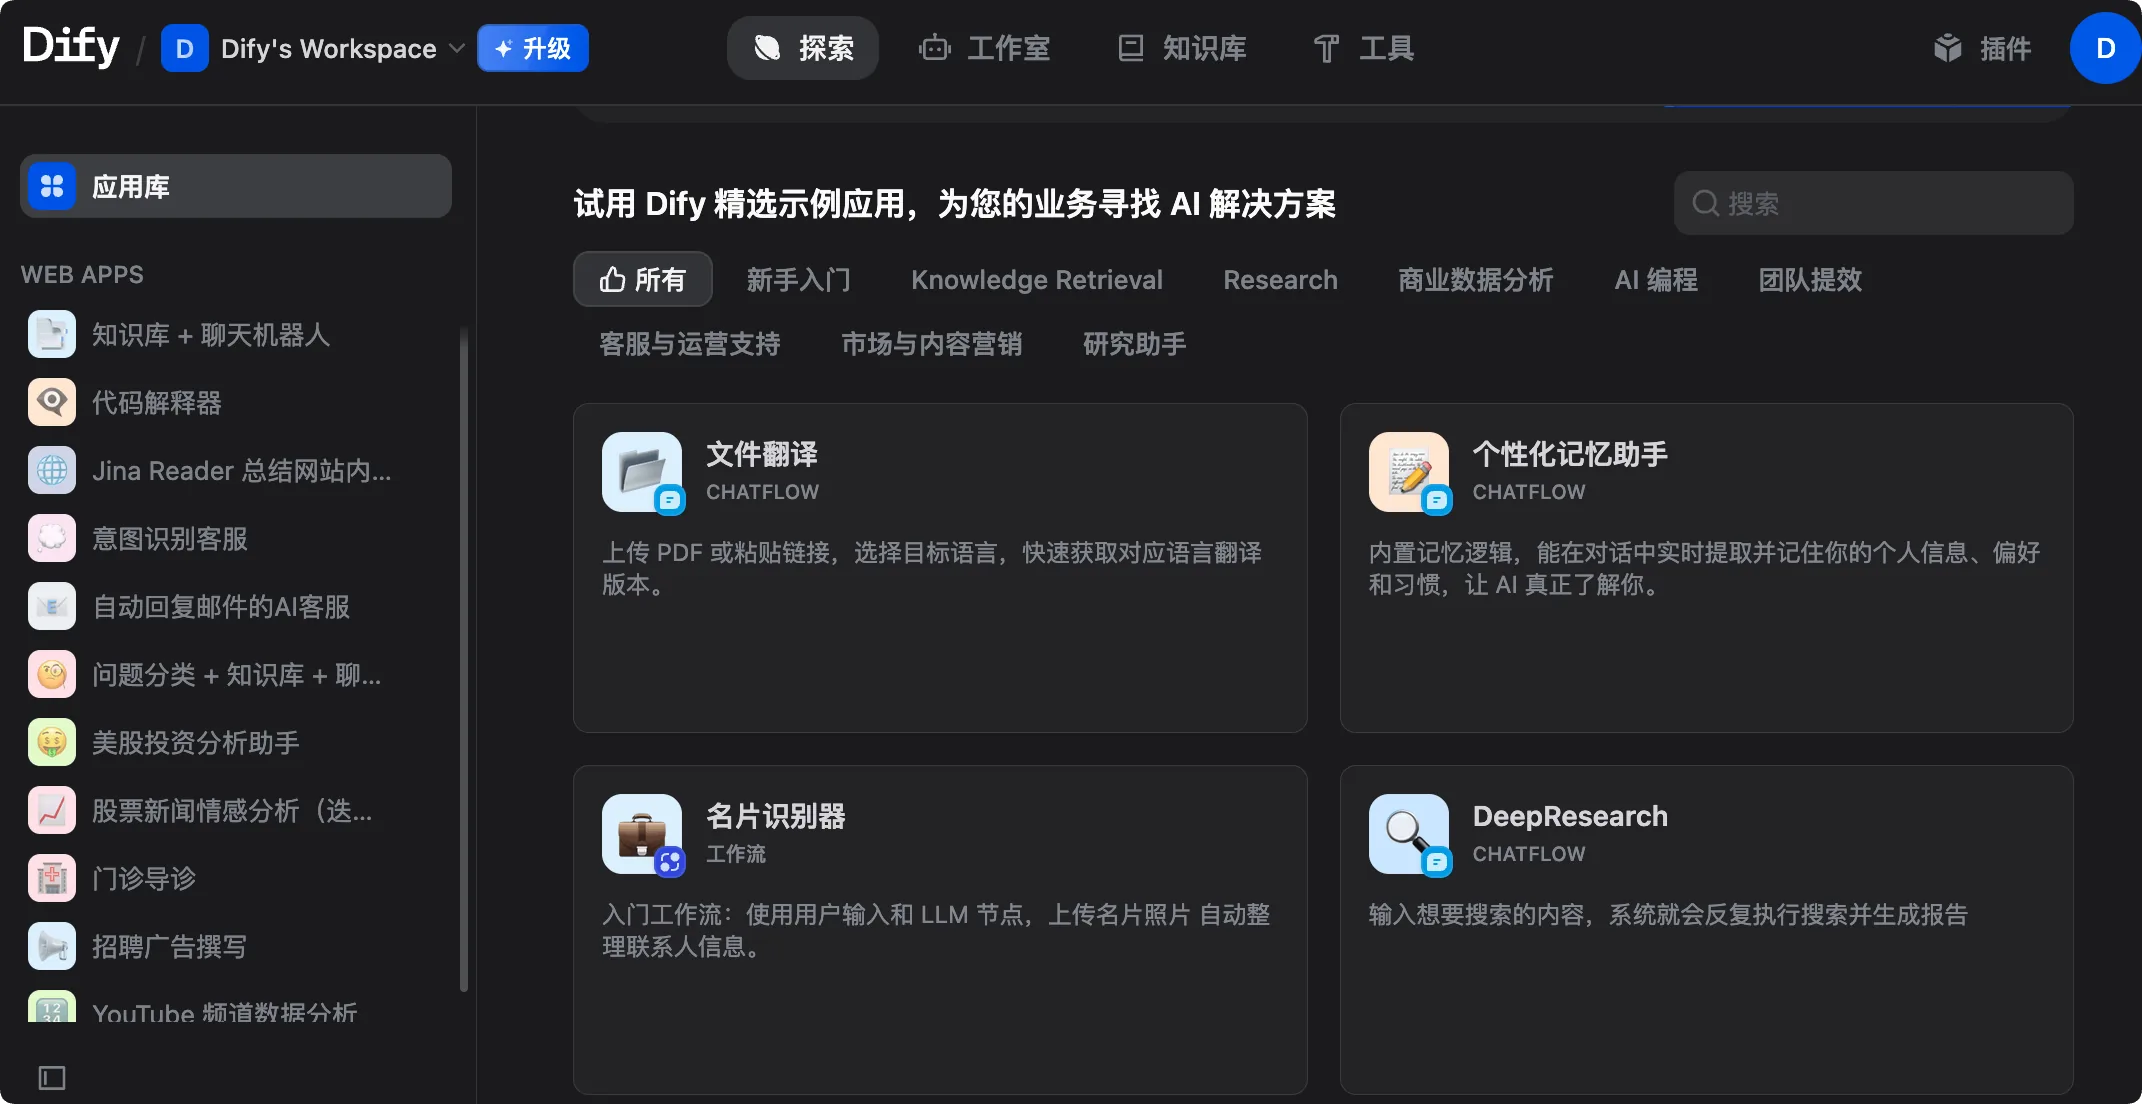
Посетитеcloud.dify.ai, зарегистрируйте аккаунт и сразу начинайте использовать.
Бесплатный тариф Sandbox включает 200 сообщений в месяц и 5 приложений; настройка окружения не требуется.
Подходит для быстрых испытаний, личных проектов и прототипирования.
Способ 2: самостоятельный хостинг с Docker Compose (рекомендуется для продакшена)
Подходит для пользователей с техническим опытом, предоставляя полный контроль над данными и средой развёртывания.
Системные требования
| Ресурс | Минимальные требования | Рекомендуемая конфигурация |
|---|---|---|
| Процессор | 2 ядра | 4 ядра |
| Память | 4 GB | 8 GB |
| Диск | 20 GB | 50 GB+ |
| Docker | Engine 20.10+ | Последняя версия |
| Docker Compose | v2.2+ | Последняя версия |
Шаги установки
Шаг 1: Клонируйте репозиторий
Клонируйте репозиторий Dify на локальную машину:
git clone https://github.com/langgenius/dify.git
cd dify
Шаг 2: Перейдите в каталог docker и скопируйте конфигурацию окружения
cd docker
# 从模板复制环境配置文件
cp .env.example .env
Шаг 3 (важно): Настройте SECRET_KEY
Начиная с v1.14.1, развертывания Docker больше не полагаются на публичный секретный ключ по умолчанию. Когда SECRET_KEY пуст, API автоматически генерирует и сохраняет ключ времени выполнения. Рекомендуется явно задать его в файле .env.
# 生成一个安全的随机密钥
openssl rand -base64 42
Отредактируйте файл .env, найдите SECRET_KEY и задайте для него случайную строку, сгенерированную выше:
SECRET_KEY=your-very-long-random-secret-key-here
Шаг 4: Запустите сервис
# 启动所有 Dify 服务(首次会拉取镜像,约需 3-10 分钟)
docker compose up -d
Шаг 5: Доступ и инициализация
Откройте http://localhost/install в браузере и завершите регистрацию учетной записи администратора.
Шаг 6: Проверка состояния служб
# 查看所有容器状态,全部为 healthy 即表示运行正常
docker compose ps
Если все контейнеры (api, worker, web, db, redis, weaviate, nginx и т. д.) находятся в статусе healthy, службы работают нормально.
Остановка и перезапуск
# 停止所有服务(数据保留在 Docker volumes 中)
docker compose down

# 重新启动所有服务
docker compose up -d
Обновление до новой версии
# 进入 docker 目录
cd dify/docker

# 拉取最新代码
git pull origin main

# 拉取新镜像
docker compose pull

# 重新启动
docker compose up -d
Данные сохраняются в томах Docker, и обновления не повлияют на существующие приложения, базы знаний или историю диалогов. Перед обновлением до основных версий рекомендуется создать резервную копию базы данных PostgreSQL.
Способ 3: Развертывание в один клик на AWS Marketplace
Для стартапов и малого бизнеса, работающих на AWS, Dify Premium в AWS Marketplace позволяет развернуть решение в один клик в вашем собственном AWS VPC и поддерживает настраиваемый логотип и брендинг.
Способ 4: Развертывание в Kubernetes (высокая доступность)
Для сценариев, требующих конфигурации высокой доступности, сообщество предоставляет Helm Charts и YAML-файлы для развертывания Dify в кластере Kubernetes.
# 添加 Dify Helm 仓库
helm repo add dify https://langgenius.github.io/dify-helm

# 使用自定义 values.yaml 安装
helm install dify dify/dify -f values.yaml
Настройте поставщиков моделей
После установки первым шагом является подключение вашей ИИ-модели.
Путь выполнения
После входа в Dify нажмите на аватар в правом верхнем углу, перейдите в Настройки и выберите Поставщик моделей.
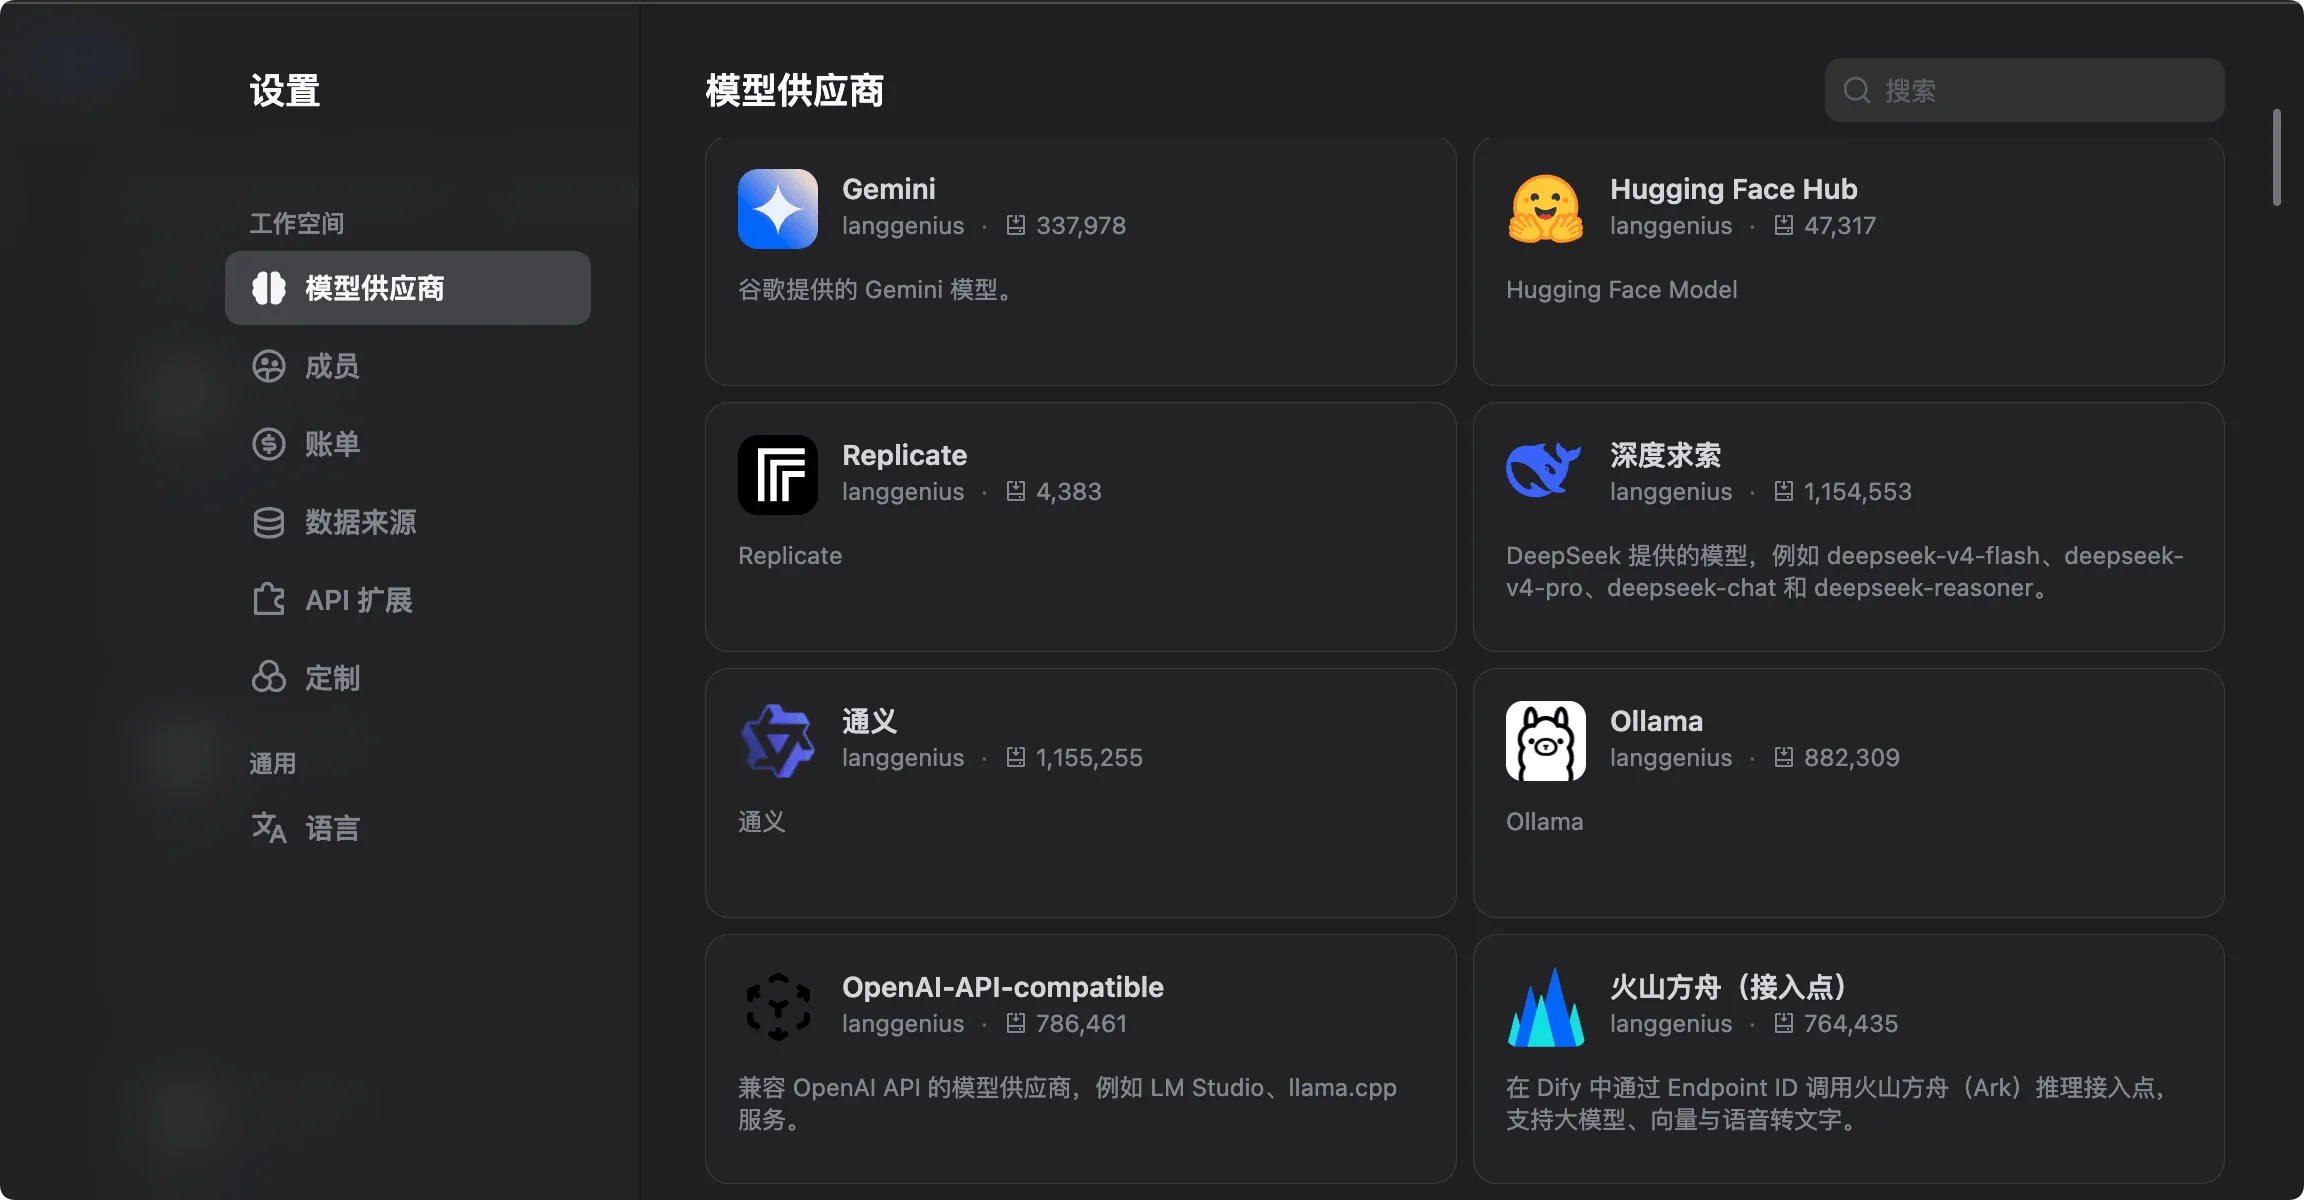
Например, мы можем установить провайдера моделей DeepSeek, а затем настроить API-ключ:
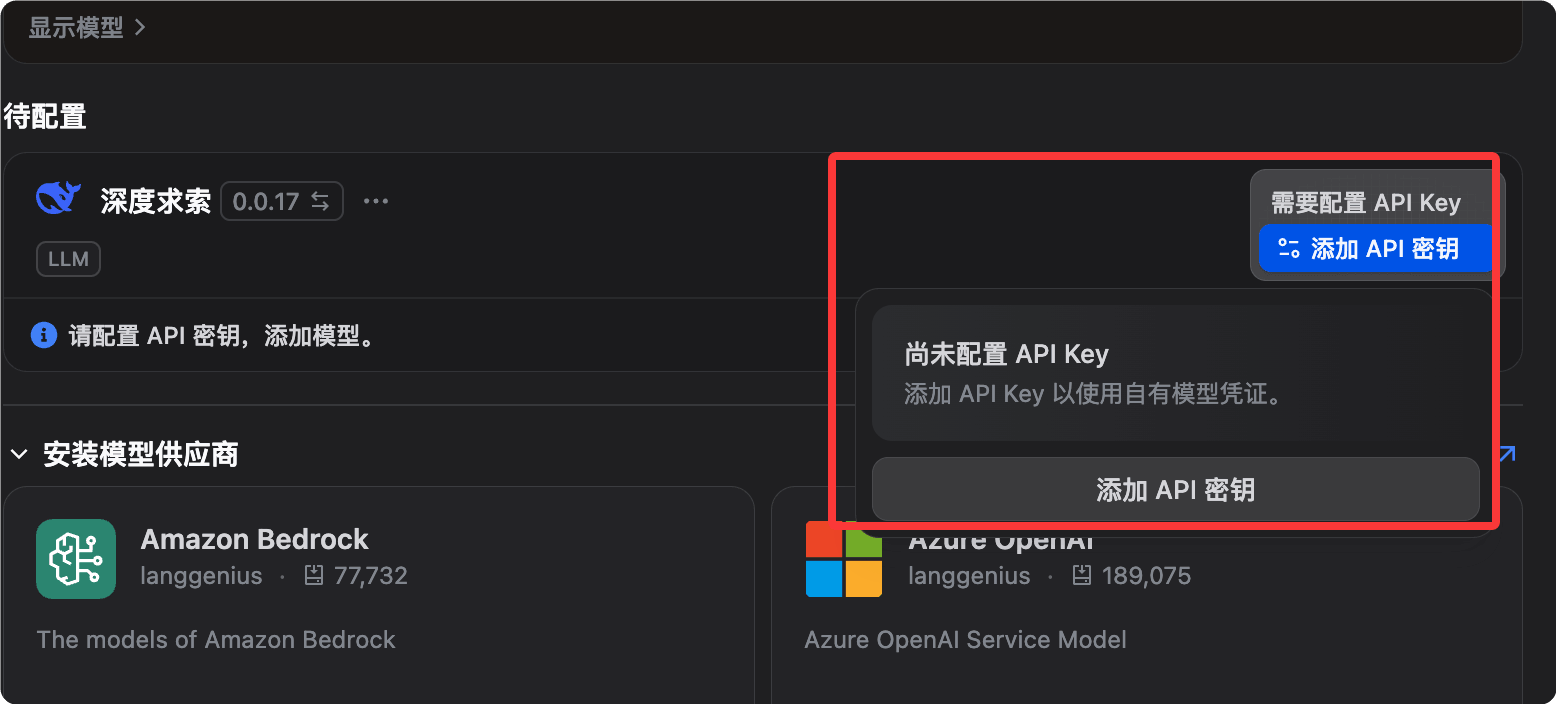
Настройка основных провайдеров
Anthropic (серия Claude):
Provider: Anthropic
API Key: sk-ant-xxxxxxxx(从 console.anthropic.com 获取)
推荐模型:claude-sonnet-4-6(综合性能最佳)
OpenAI:
Provider: OpenAI
API Key: sk-xxxxxxxx(从 platform.openai.com 获取)
推荐模型:gpt-4o(性价比高)
Google (серия Gemini):
Provider: Google
API Key: xxxxxxxx(从 aistudio.google.com 获取)
推荐模型:gemini-2.0-flash(速度快,适合大量请求)
OpenRouter (один ключ для доступа к 300+ моделям):
Provider: OpenRouter
API Key: sk-or-xxxxxxxx(从 openrouter.ai 获取)
Base URL: https://openrouter.ai/api/v1
Локальная модель (Ollama):
Provider: Ollama
Base URL: http://host.docker.internal:11434  # Docker 内访问宿主机
(先在宿主机运行:ollama pull llama3.3)
Настройка модели эмбеддингов (требуется для базы знаний)
Векторизация базы знаний требует модели эмбеддингов. Ниже приведены рекомендуемые варианты:
| Модель | Особенности | Применимые сценарии |
|---|---|---|
| OpenAI text-embedding-3-small | Дешёвый и эффективный | Общие сценарии |
| Zhipu AI embedding-3 | Отличная поддержка китайского языка | Контент преимущественно на китайском языке |
| Локальный nomic-embed-text (Ollama) | Полностью офлайн | Высокие требования к безопасности данных |
Проверка доступности модели
Вернитесь в Настройки, найдите настроенного провайдера, нажмите кнопку «Проверить» рядом с названием модели. Зелёная галочка означает успешную настройку.
Подробное объяснение пяти типов приложений
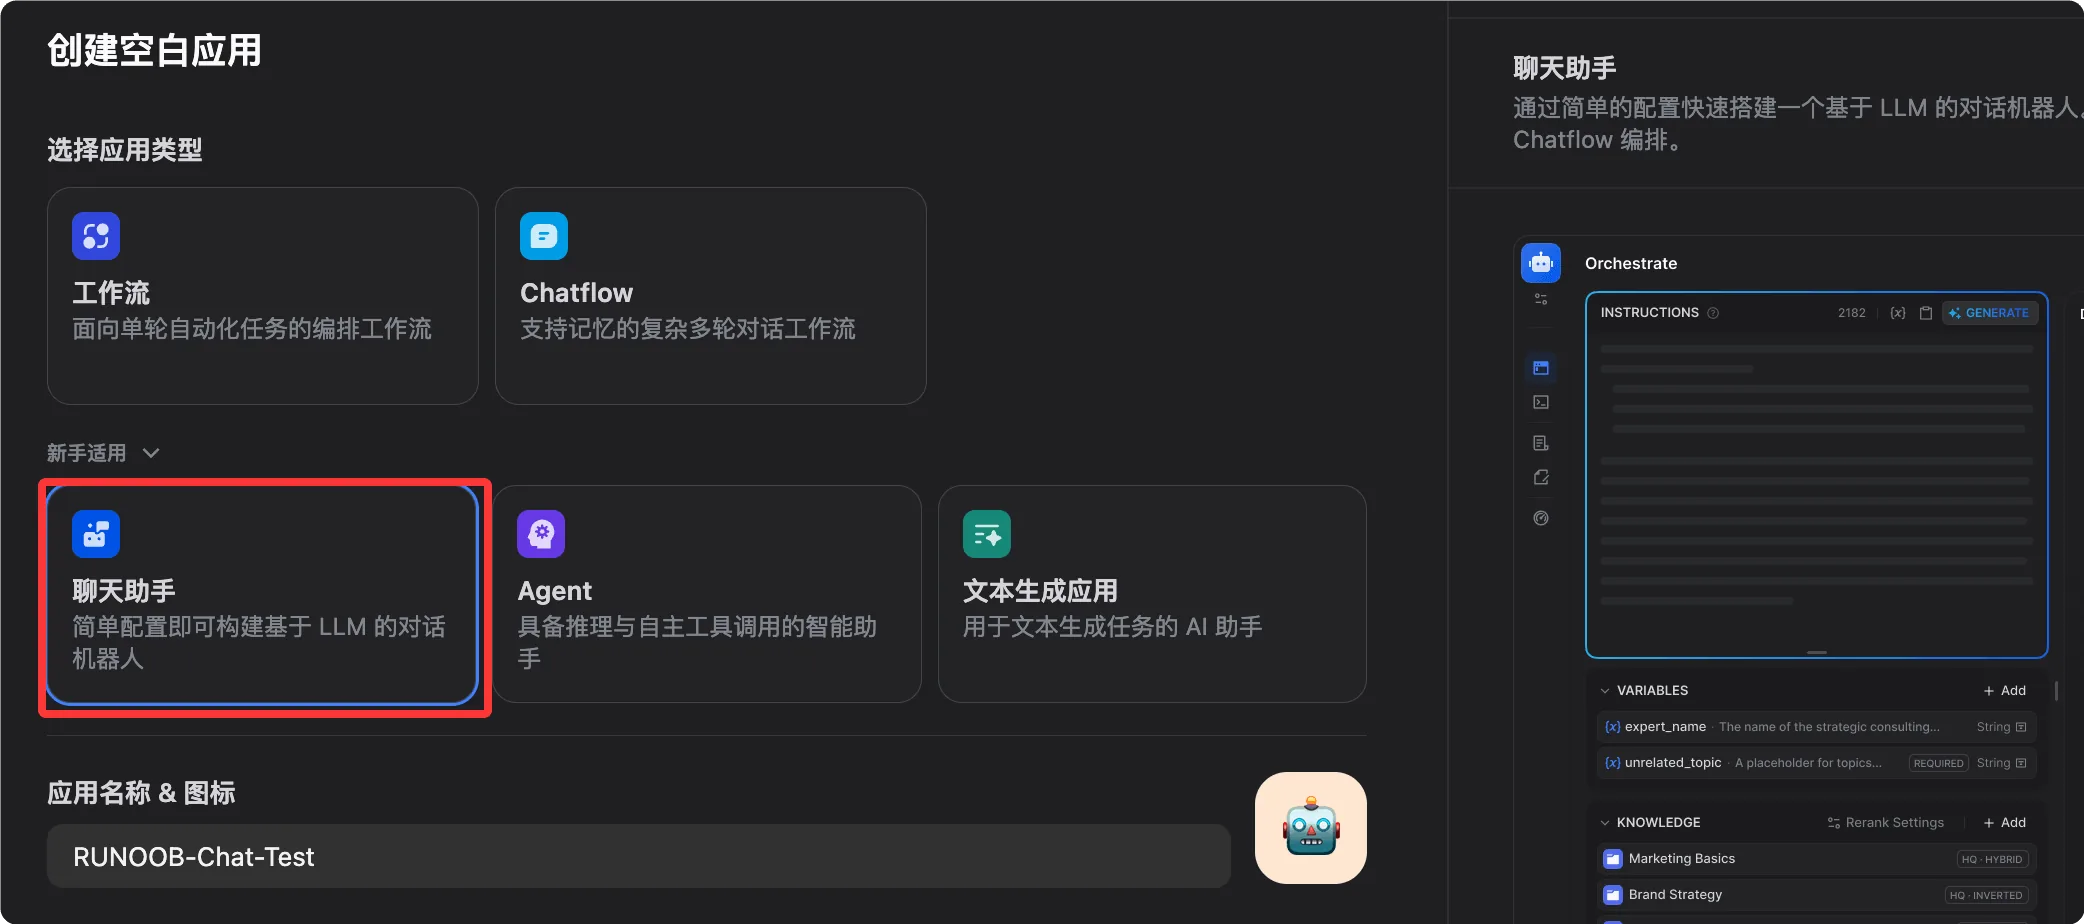
На главной странице Dify нажмите «Создать приложение». Вы увидите пять типов, каждый из которых соответствует различным сценариям использования.
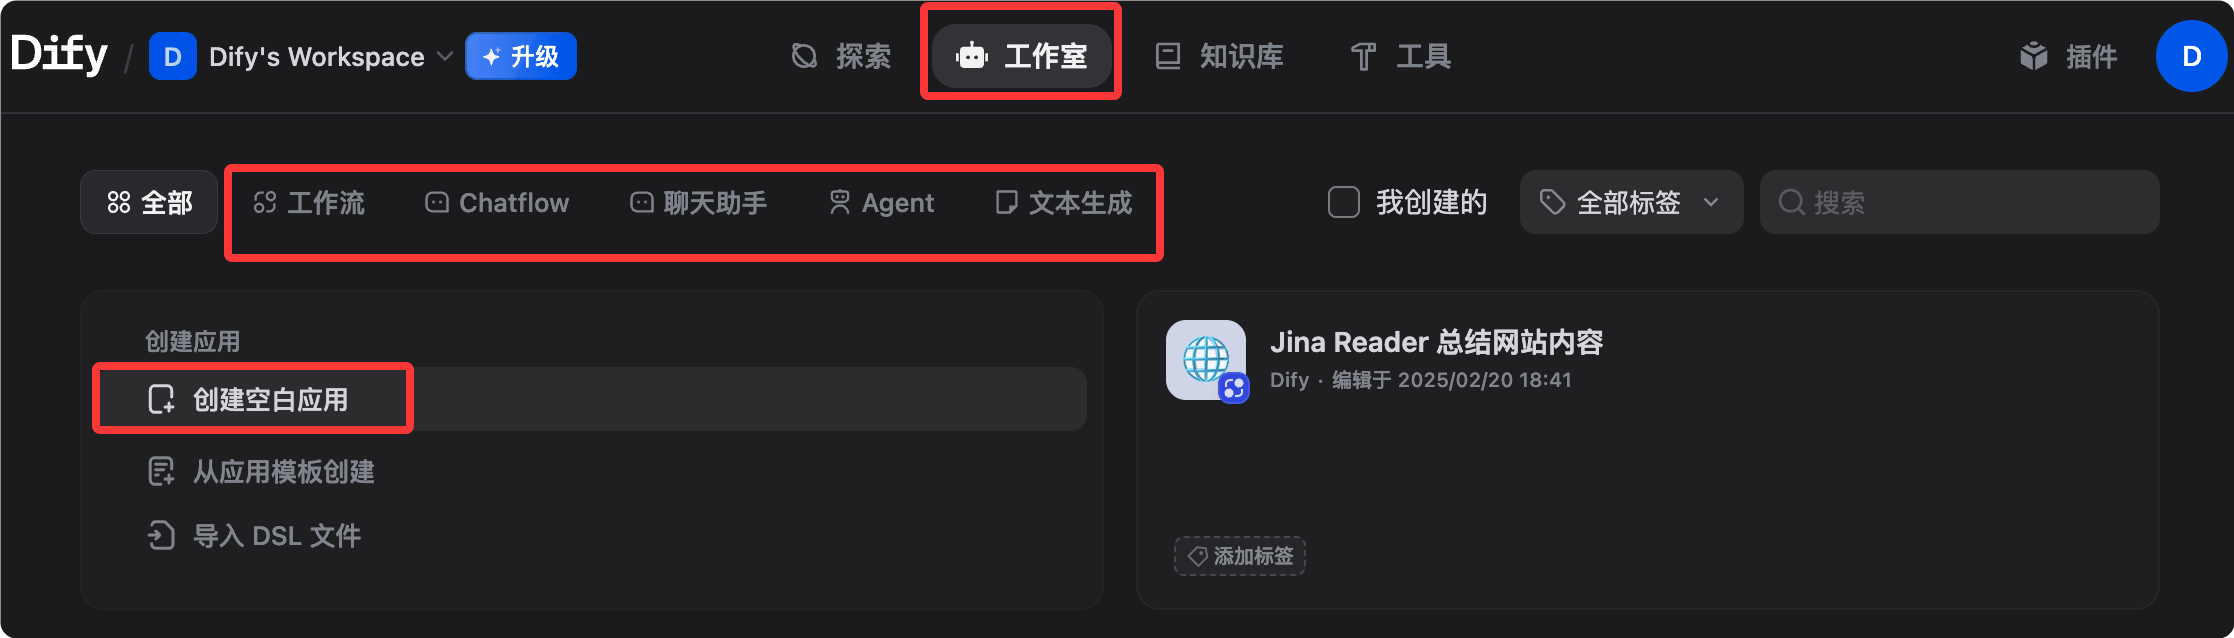
Нажмите, чтобы создать пустое приложение, и вы увидите пять типов приложений:
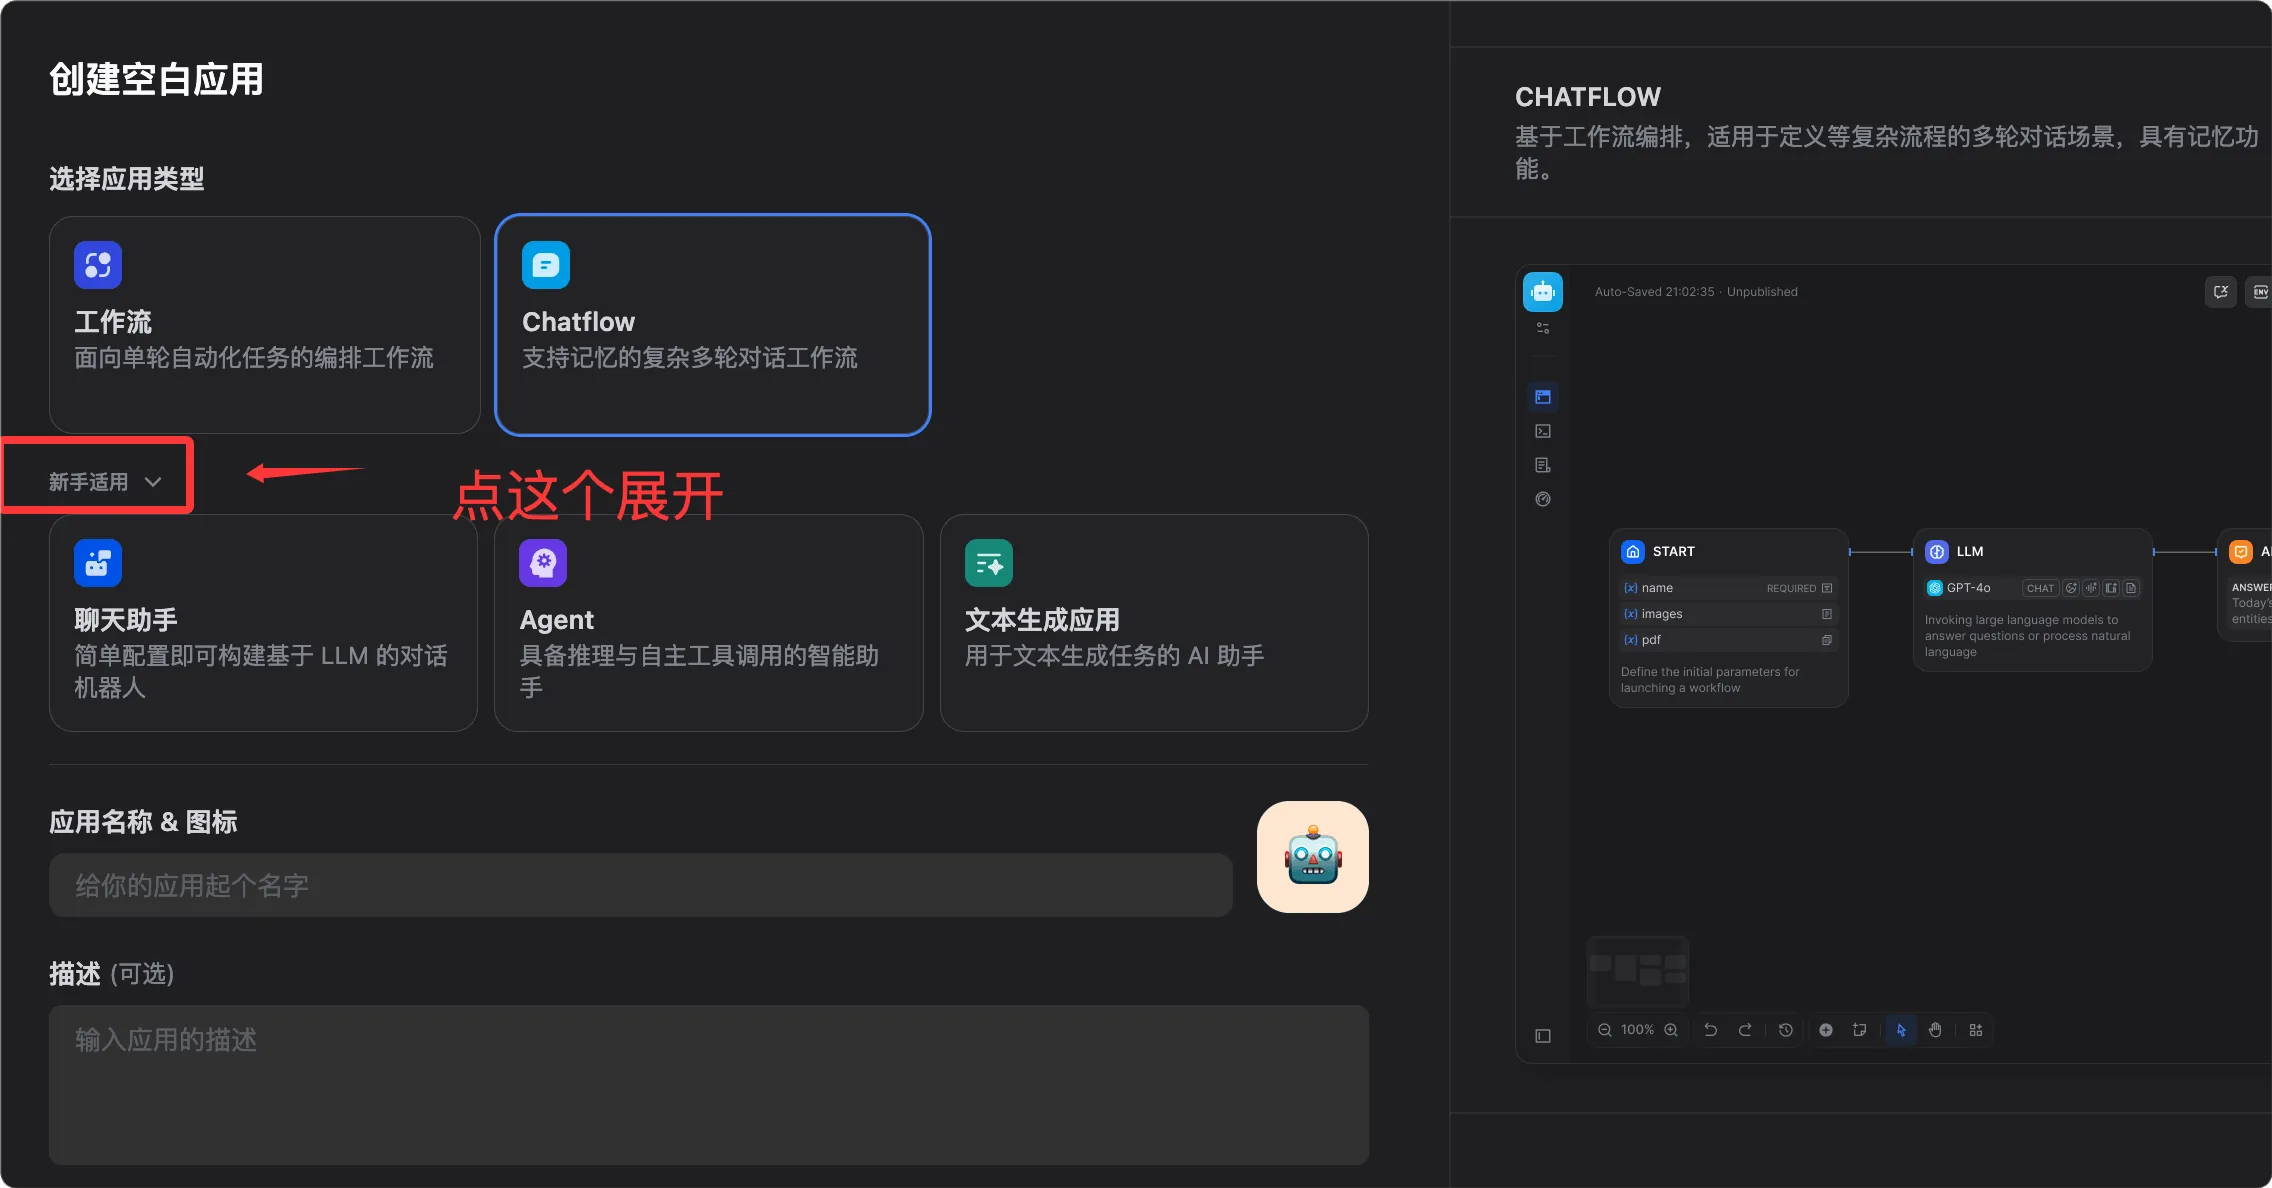
1. Чат-бот (диалоговый ассистент)
Стандартное приложение для многоходового диалога с постоянной памятью сеанса.
| Attribute | Описание |
|---|---|
| Подходящие сценарии | Боты службы поддержки, персональные ассистенты, вопросы и ответы (FAQ) |
| Основные возможности | Встроенная память диалога (настраиваемая стратегия памяти), подключаемая база знаний (включение RAG), поддержка потокового вывода, публикация в один клик в виде кода для встраивания на веб-страницу. |
2. Генератор текста
Один вход — один выход, история диалога не сохраняется.
| Attribute | Описание |
|---|---|
| Подходящие сценарии | Рерайтинг статей, генерация резюме, SEO-копирайтинг, составление электронных писем |
| Основные возможности | Понятная структура (форма ввода + текст вывода), подходит для пакетной обработки, поддерживает переменные-заполнители (например, {{product_name}}) |
3. Агент
ИИ, который может проактивно вызывать инструменты, автономно планировать и выполнять многошаговые задачи.
| Attribute | Описание |
|---|---|
| Подходящие сценарии | Запросы и анализ данных, поиск и обобщение, выполнение кода |
| Основные возможности | Поддерживает два режима рассуждения: Function Calling и ReAct; встроенные 50+ инструментов (поиск, генерация изображений, интерпретатор кода и т. д.); поддерживает пользовательские инструменты API; процесс вызова инструментов виден пользователям |
4. Chatflow (поток диалога)
Добавляет возможности многоходового диалога поверх Workflow, объединяя оркестрацию процессов и контекст диалога.
| Attribute | Описание |
|---|---|
| Подходящие сценарии | Сложные процессы обслуживания клиентов, чат-боты, требующие многошагового принятия решений |
| Основные возможности | Сочетает возможности оркестрации узлов Workflow и память многоходового диалога, позволяя запускать автоматизированные процессы в ходе диалога |
5. Workflow
Полностью автоматизированный многошаговый процесс обработки без интерфейса диалога, запускаемый через API или вручную.
| Attribute | Описание |
|---|---|
| Подходящие сценарии | Пакетная обработка данных, автоматизированные задачи по расписанию, бэкенд-конвейеры обработки ИИ |
| Основные возможности | Создавайте и тестируйте рабочие процессы ИИ на визуальном холсте; поддерживает параллельные ветви, циклы и условную логику; поддерживает Human-in-the-Loop (узел Human Input); результаты вывода можно интегрировать с другими системами |
Руководство по выбору
Быстро определите, какой тип приложения использовать, исходя из ваших потребностей:
需要多轮对话?
├─ 是 → 需要复杂流程逻辑?
│        ├─ 是 → Chatflow
│        └─ 否 → Chatbot 或 Agent(需要工具调用时选 Agent)
└─ 否 → 单次输入输出?
          ├─ 是 → Text Generator
          └─ 需要多步骤自动化 → Workflow
База знаний (RAG): пусть ИИ отвечает, используя ваши приватные данные
База знаний — одна из самых мощных функций Dify и основа большинства корпоративных приложений.
Создайте базу знаний
- В панели навигации выберите Knowledge (База знаний) и нажмите Create Knowledge (Создать базу знаний).
- Назовите базу знаний, например «Руководство по продукту» или «Внутренние нормативные документы»
- Выберите способ создания
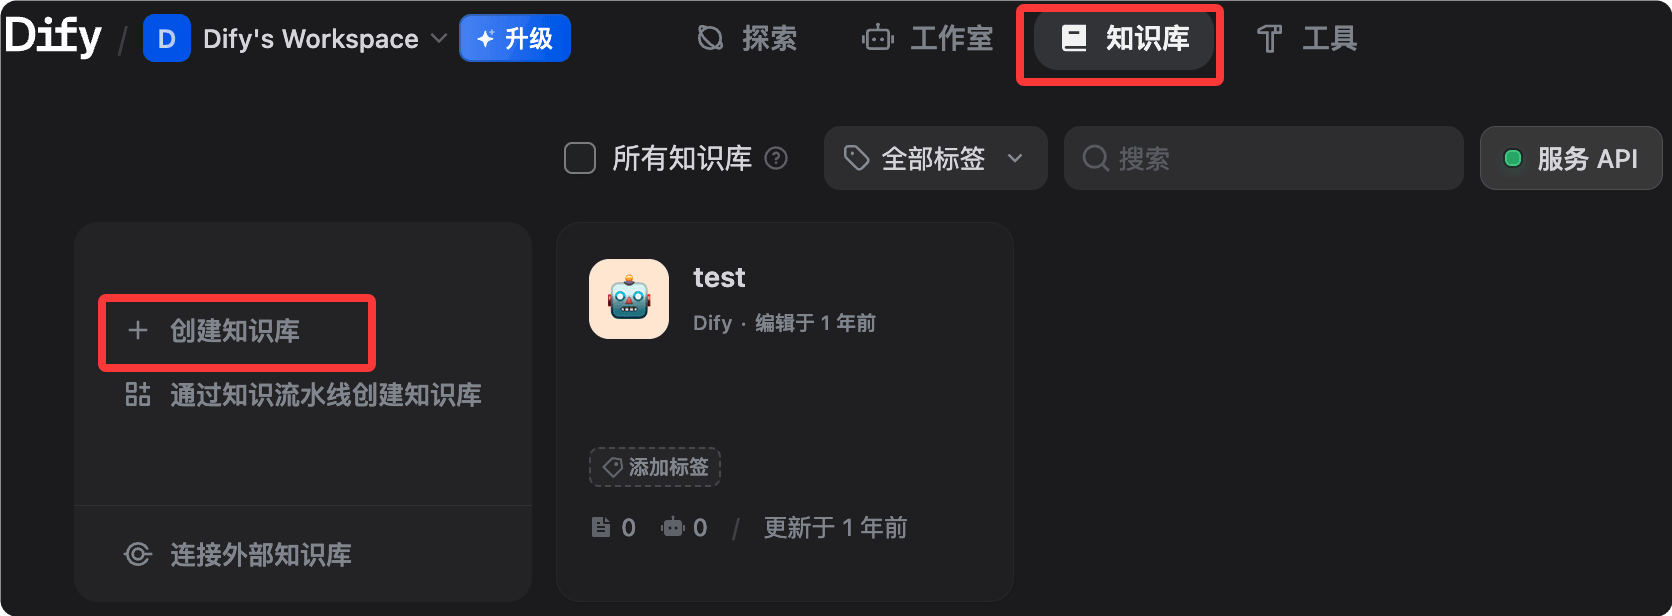
Способ 1: загрузка файлов (наиболее распространённый)
Dify принимает файлы в форматах PDF, Word (.docx), Markdown (.md), обычный текст (.txt), CSV и HTML.
Рекомендуется использовать Markdown или обычный текст, так как они наиболее надёжны для парсинга.
PDF-файлы со сложной версткой или отсканированные версии могут требовать предварительной обработки; рекомендуется использовать инструменты OCR для извлечения текста перед загрузкой.
Способ 2: Конвейер знаний (корпоративный уровень)
Конвейер знаний — это визуальная система оркестрации на основе узлов, специально предназначенная для загрузки и обработки документов.
Он решает три основные проблемы традиционного RAG: разрозненные источники данных, потеря информации при разборе (графики и формулы отбрасываются) и обработка по принципу чёрного ящика (из-за чего сложно диагностировать причины сбоев).
Способ 3: API внешней базы знаний
Синхронизируйте существующие внешние базы знаний через API без необходимости миграции данных.
Стратегия разбиения документов на фрагменты
После загрузки Dify автоматически выполняет разбиение текста на фрагменты. Ключевые параметры описаны ниже:
| Параметр | Описание | рекомендуемое значение |
|---|---|---|
| Размер фрагмента | Количество токенов на фрагмент | 500-1000 (для китайского) |
| Перекрытие чанков | Количество перекрывающихся токенов между соседними чанками | 50-100 |
| Разделители | Разделение по (абзацам/предложениям) | Абзац |
Для китайского контента рекомендуется устанавливать размер чанка примерно в 500 токенов. Слишком длинный снижает точность поиска; слишком короткий теряет контекст.
Режимы индексации
| Mode | Описание | стоимость |
|---|---|---|
| Высокое качество (по умолчанию) | Использование Embedding-модели для генерации векторов даёт наилучшие результаты | Использование Embedding API |
| Экономичный режим | Инвертированный индекс (сопоставление по ключевым словам), эмбеддинг не требуется | Бесплатно |
Конфигурация поиска
Перейдите в базу знаний, выберите Настройки и настройте параметры поиска:
| Метод поиска | Описание | Применимые сценарии |
|---|---|---|
| Векторный поиск | Сопоставление семантического сходства | Запросы, связанные по смыслу |
| Полнотекстовый поиск | Сопоставление по ключевым словам. | Точный запрос по термину |
| Гибридный поиск (рекомендуется) | Объедините оба подхода и используйте модель переранжирования, чтобы повысить точность. | Общие сценарии |
Рекомендуется устанавливать порог сходства на уровне 0.5-0.7.
Если порог сходства слишком высок, результаты не будут возвращены; если слишком низок, будет возвращён нерелевантный контент. Рекомендуется начать тестирование со значения 0.6 и тонко настроить его на основе результатов.
Тестирование результатов поиска
В базе знаний нажмите «Тестирование поиска», введите тестовый вопрос и сразу просмотрите возвращённые фрагменты, чтобы проверить качество поиска, не запуская сам диалог.
Свяжите базу знаний с приложением
На странице редактирования приложения выберите «Контекст», нажмите «Добавить», выберите созданную базу знаний и сохраните.
После связывания каждый диалог в приложении будет сначала выполнять поиск в базе знаний, прежде чем отвечать.
Рабочий процесс: визуальное управление многошаговыми задачами
Определите логику многошаговой обработки ИИ, перетаскивая узлы и соединяя их.
Откройте редактор рабочего процесса
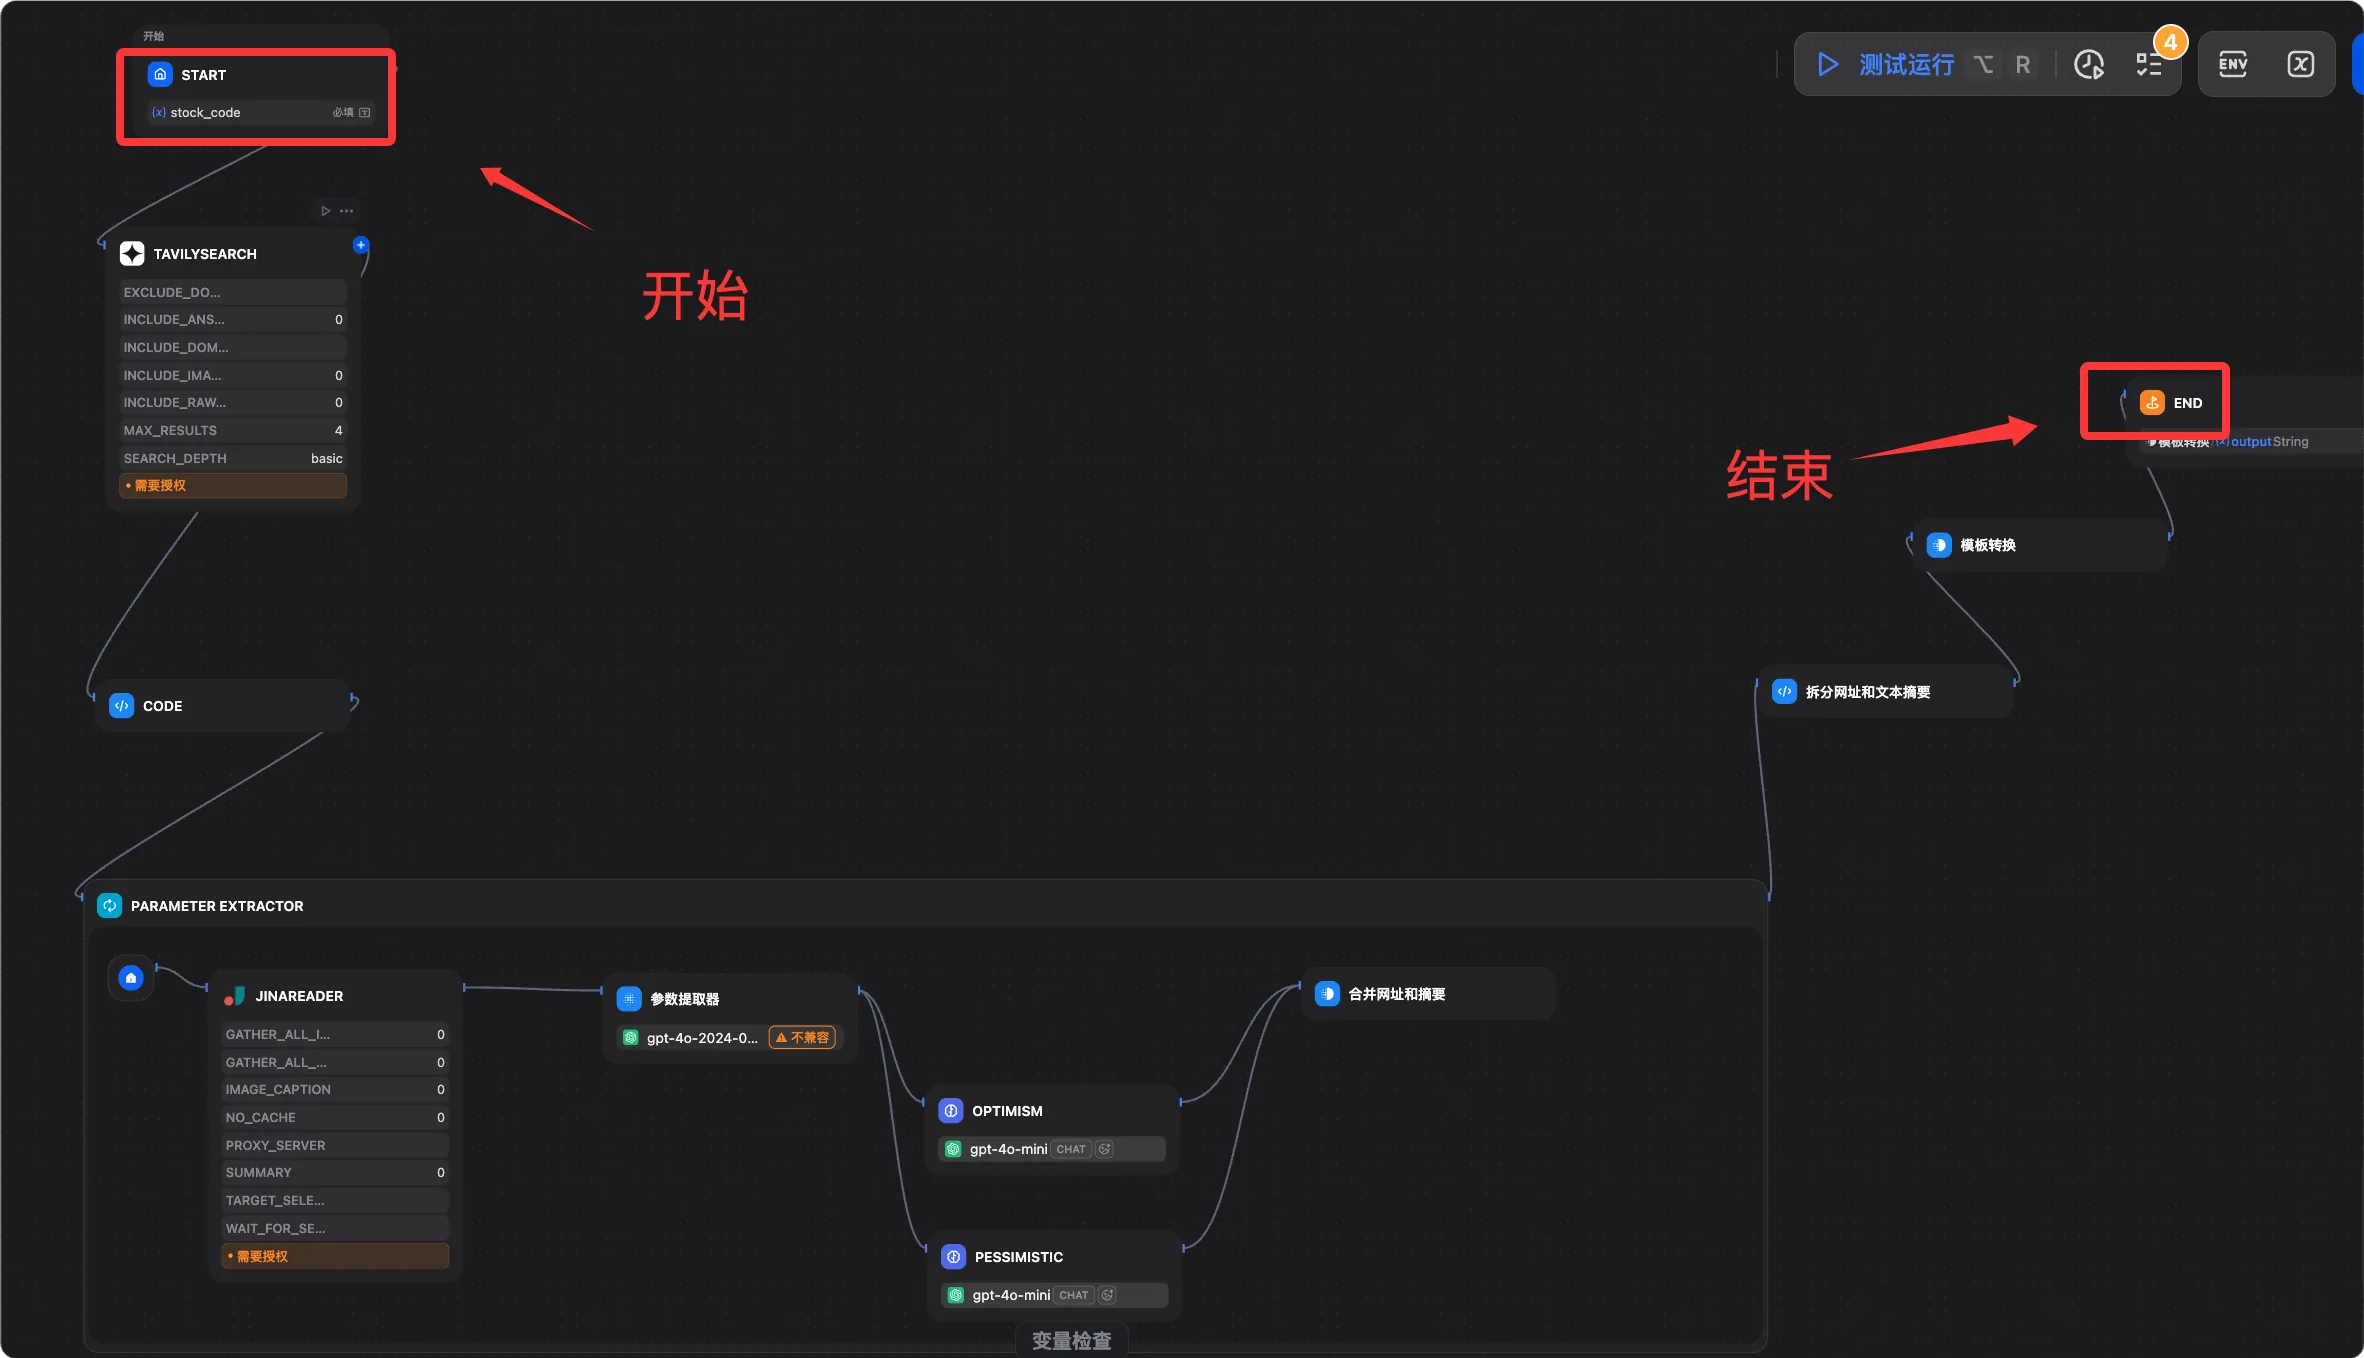
При создании приложения выберите «Рабочий процесс» или нажмите «Редактировать» в существующем приложении «Рабочий процесс», чтобы перейти на холст.
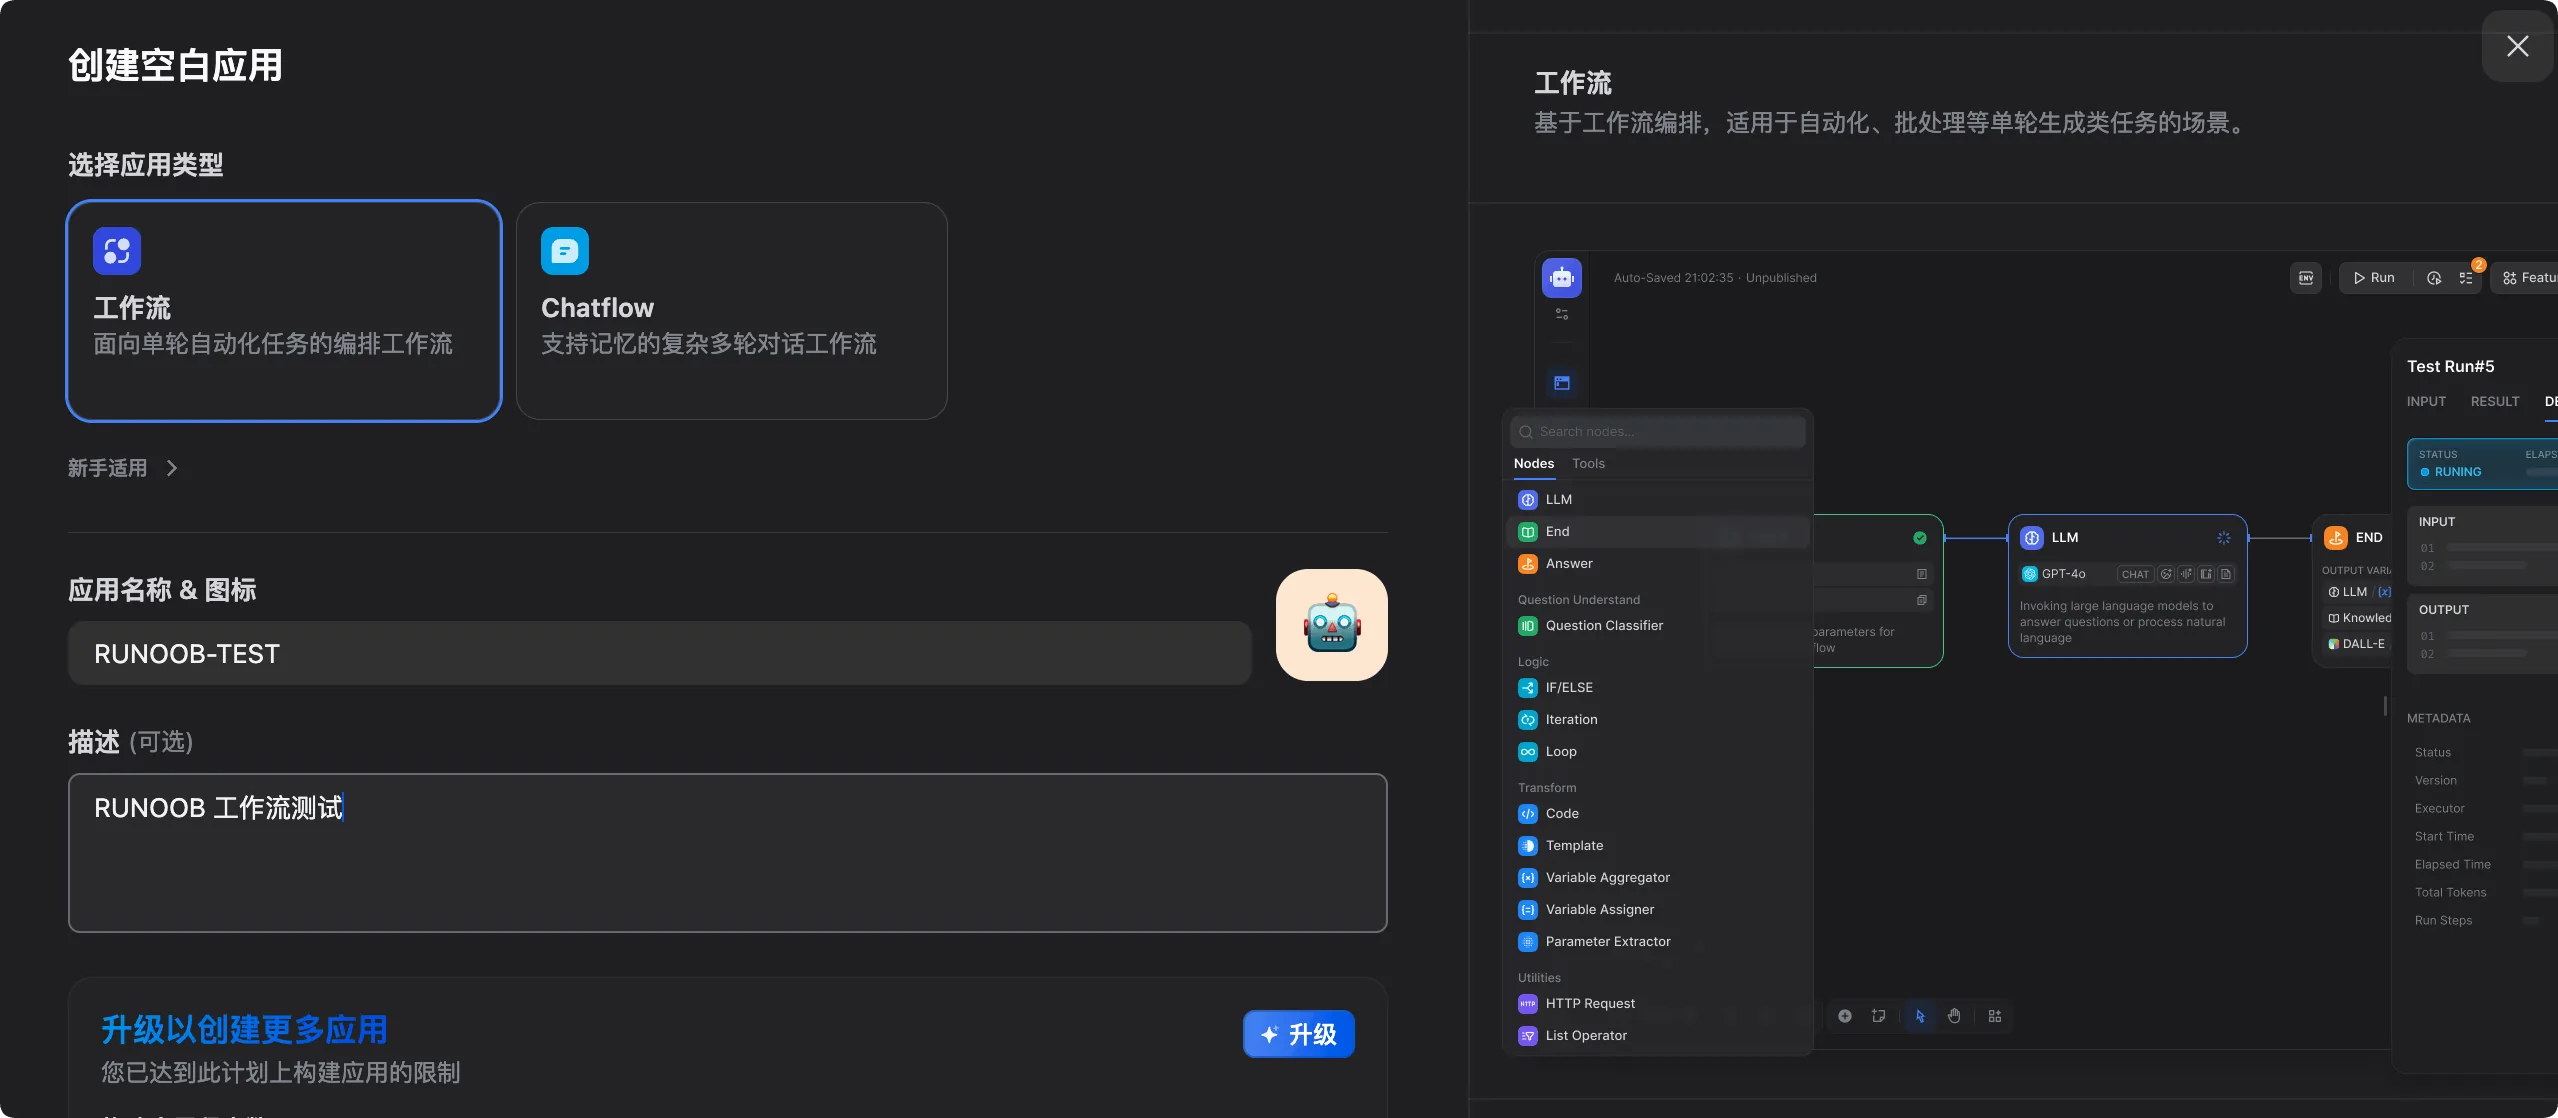
Основные типы узлов
Ниже приведены наиболее часто используемые узлы в редакторе Workflow и их функции:
| Узел | Функция | Типичный сценарий использования |
|---|---|---|
| Старт | Точка входа процесса, определяет входные переменные | Получает пользовательский ввод или внешние параметры |
| LLM | Вызов языковой модели | Генерация текста, анализ, перевод |
| Поиск по базе знаний | Извлекает данные из базы знаний | Сценарии RAG |
| IF/ELSE | Условное ветвление | Направляет обработку по разным путям в зависимости от содержимого |
| Code | Выполнение кода Python или JS | Преобразование данных, обработка форматов, вычисления |
| HTTP Request | Вызов внешнего API | Запрос к базе данных, отправка уведомлений |
| Template | Рендеринг шаблона с переменными | Объединение выходных данных нескольких узлов |
| Присваивание переменных | Установка/обновление переменных | Передача данных между узлами |
| Итерация | Цикл по спискам | Пакетная обработка нескольких элементов данных |
| Агент | Встроенный узел агента | Наделяет шаг рабочего процесса способностью к автономному рассуждению |
| Ввод от человека | Приостановить и дождаться проверки человеком | Ключевая точка принятия решений для взаимодействия человека и машины |
| Конец | Выход процесса, определяет вывод | Возвращает конечный результат |
Передача переменных между узлами
Вывод каждого узла может быть использован последующими узлами с помощью синтаксиса {{node_name.output_variable_name}}.
Ниже приведён пример передачи переменных в типичном рабочем процессе RAG Q&A:
Start 节点输出 user_query
  ↓
Knowledge Retrieval 节点:
  输入:{{Start.user_query}}
  输出:result(检索结果)
  ↓
LLM 节点:
  System Prompt:你是一个客服助理,根据以下资料回答问题
  User:用户问题:{{Start.user_query}}
        参考资料:{{Knowledge Retrieval.result}}
  ↓
End 节点:
  返回:{{LLM.text}}
Узел ввода человеком (HITL)
Узел ввода человеком — это значительное обновление, позволяющее рабочим процессам приостанавливать выполнение в ключевых точках принятия решений.
Этот узел создаёт интерфейс пользователя для проверки и изменения переменных человеком (например, редактирования черновиков или исправления данных), а затем определяет последующий путь на основе настраиваемых кнопок (таких как «Approve», «Reject» или «Escalate»).
Это решает бинарную дилемму предыдущих рабочих процессов — «либо полностью автоматизированный, либо полностью ручной» — позволяя сценариям высокого риска (проверка контрактов, медицинские консультации, финансовые решения) также получать выгоду от автоматизированного ИИ.
Отладка рабочего процесса
Нажмите Run (Run) в правом верхнем углу холста, введите тестовые параметры и наблюдайте за входными/выходными данными и задержкой каждого узла.
Рядом с узлами появляются зелёные (успех) или красные (ошибка) индикаторы; нажмите, чтобы просмотреть подробные журналы выполнения.
Практический сценарий 1: Корпоративный бот для вопросов и ответов по внутренней базе знаний
Используйте Dify, чтобы создать чат-бота, который сможет точно отвечать на вопросы по внутренним документам, с указанием источников в ответах.
Бизнес-контекст
В компании есть большое количество внутренних документов (кадровые политики, руководства по продуктам, техническая Wiki). Сотрудникам часто нужно находить информацию, но документы разрознены, и по ним трудно искать.
Шаг 1: Подготовьте базу знаний
- Упорядочьте документы: экспортируйте кадровые политики (PDF), руководства по продуктам (Word) и техническую Wiki (Markdown) для использования.
- В разделе «База знаний» выберите «Создать базу знаний» и назовите её «Внутренняя база знаний компании».
- Загрузите файлы и выберите режим высококачественного индексирования.
- Дождитесь завершения векторизации (отображается на индикаторе выполнения).
Советы по оптимизации качества документов: удалите нерелевантную информацию, верхние и нижние колонтитулы и специальные символы. Используйте понятные заголовки и короткие абзацы. Если документ охватывает несколько разных тем, рассмотрите возможность разделения его на отдельные файлы.
Шаг 2: Создайте приложение-чат-бот
- Нажмите «Создать приложение», выберите «Чат-бот» и назовите его «Внутренний ассистент».
- Выберите модель (рекомендуется Claude Sonnet 4.6 или GPT-4o).
- Напишите системный промпт.
You are an internal company knowledge assistant, specifically helping employees find information in internal documents.

Code of conduct:
- Only answer based on the provided knowledge base content; do not fabricate information
- Cite the source document name when answering
- If the relevant information is not found in the knowledge base, directly say "I did not find the relevant information in the documents" and suggest contacting the corresponding department
- Use concise, professional language
- Do not discuss topics other than company confidential matters
- В разделе Context нажмите Add и выберите «Company Internal Knowledge Base».
- Настройте параметры поиска: гибридный поиск, порог сходства 0.6, возврат Top 5 сегментов.
Шаг 3: Тестирование и настройка
Протестируйте на реальных вопросах. Вот рекомендуемые тестовые примеры:
测试问题示例:
"年假怎么申请?" → 应该从 HR 政策文档返回正确步骤
"产品 A 的定价是多少?" → 应该从产品手册返回准确价格
"如何配置 VPN?" → 应该从技术 Wiki 返回步骤
"CEO 是谁?" → 如果文档中没有,应该诚实说不知道
Типичные операции настройки
| Проблема | Решение |
|---|---|
| Неточные ответы | Понизьте порог сходства (например, 0.5) и увеличьте количество возвращаемых фрагментов. |
| Неактуальные ответы | Повысьте порог (например, 0.7) и проверьте, разумно ли разбиение документа на фрагменты. |
| Неполные ответы | Увеличьте размер чанка, чтобы каждый чанк содержал больше полных абзацев. |
Шаг 4: Публикация и интеграция
Опубликовать как веб-приложение: на странице приложения выберите Overview, нажмите Embedded, скопируйте код встраивания и вставьте его на внутреннюю страницу Wiki или интранета.
Опубликовать как API: на странице приложения выберите API Reference, скопируйте API Key и вызовите пример:
# 调用聊天 API,向知识问答机器人发送问题
curl -X POST 'https://api.dify.ai/v1/chat-messages' \
  -H 'Authorization: Bearer app-xxxxxxxx' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {},
    "query": "年假怎么申请?",
    "response_mode": "blocking",
    "user": "employee-001"
  }'
Практический сценарий 2: Автоматизированный конвейер генерации контента
Используйте Workflow для параллельной генерации маркетингового контента для разных каналов.
Бизнес-контекст
Маркетинговой команде нужно пакетно преобразовывать журналы обновлений продуктов (на техническом языке) в контент для разных каналов: посты в официальном аккаунте WeChat, технические блоги и сценарии коротких видео.
Проектирование Workflow
Start(输入:更新日志文本)
  ↓ 并行分支
  ├─→ LLM-1:生成微信推文(轻松活泼,500字,含表情符号)
  ├─→ LLM-2:生成技术博客(专业详细,1500字,含代码示例)
  └─→ LLM-3:生成短视频脚本(口语化,300字,分镜头格式)
  ↓ 合并
End(输出:三份内容)
Конкретные шаги создания
Шаг 1: Создайте приложение Workflow и назовите его "Content Generation Pipeline".
Шаг 2: Настройте узел Start и добавьте входные переменные:
| Имя переменной | Type | Описание |
|---|---|---|
| update_content | Тип текста | Исходный журнал обновлений продукта |
| product_name | Тип текста | Название продукта |
| version | Тип текста | Номер версии |
Шаг 3: Добавьте три узла LLM (параллельно).
Подключите все три узла LLM к узлу Start, и Dify автоматически выполнит их параллельно.
LLM-1 (пост в WeChat) Пример промпта:
你是一位擅长社交媒体写作的内容创作者。

请将以下 {{product_name}} v{{version}} 的更新日志改写成微信公众号推文:
- 字数:400-600字
- 语气:轻松活泼,贴近用户
- 结构:开头吸引眼球,中间介绍亮点,结尾引导互动
- 适当使用 emoji
- 不要使用技术术语,用用户能理解的语言

更新日志原文:
{{Start.update_content}}
LLM-2 (технический блог) и LLM-3 (сценарий короткого видео) настраиваются аналогично; просто настройте промпт и модель.
Шаг 4: Добавьте узел End и настройте выходные переменные:
wechat_post:引用 {{LLM-1.text}}
tech_blog:引用 {{LLM-2.text}}
video_script:引用 {{LLM-3.text}}
Шаг 5: Интегрируйте во внутренние инструменты через API.
Пример
def generate_content(update_content: str, product_name: str, version: str):
"""Вызовите API Dify Workflow для пакетной генерации многовариантного контента"""
# URL API: замените api.dify.ai на домен вашего экземпляра Dify
url = "https://api.dify.ai/v1/workflows/run"
# Заголовки запроса: замените на API-ключ вашего приложения
headers = {
"Authorization": "Bearer app-xxxxxxxx", # Обязательно: API-ключ приложения
"Content-Type": "application/json"
}
# Тело запроса: передайте три входные переменные, определённые в узле Start
payload = {
"inputs": {
"update_content": update_content, # Исходный журнал обновлений
"product_name": product_name, # Название продукта
"version": version # Номер версии
},
"response_mode": "blocking", # Режим блокировки, ожидать полный результат
"user": "content-team" # Идентификатор пользователя, используемый для отслеживания логов
}
response = requests.post(url, headers=headers, json=payload)
# Извлеките поле outputs из ответа, содержащее результаты генерации трёх узлов LLM
return response.json()["data"]["outputs"]
Практический сценарий 3: агент службы поддержки клиентов (с участием человека)
Создайте интеллектуальную систему обработки обращений в службу поддержки: ИИ автоматически обрабатывает стандартные вопросы, а сложные вопросы направляются операторам-людям с предварительным анализом.
Бизнес-контекст
Платформа электронной коммерции получает в среднем 500+ обращений в службу поддержки в день; большинство из них — стандартные вопросы (запросы о логистике, политика возврата), но около 20% требуют ручной обработки (сложные жалобы, крупные возвраты).
Проектирование Workflow
Start(接收用户工单:问题类型 + 内容 + 订单号)
  ↓
LLM-分类:判断问题类型(standard / complex)
  ↓
IF/ELSE:问题类型是否为 standard?
  ├─ standard →
  │    Knowledge Retrieval(从客服知识库检索)
  │      ↓
  │    LLM-回复:生成标准回答
  │      ↓
  │    End(直接回复用户)
  │
  └─ complex →
       LLM-预分析:生成问题摘要和建议处理方案
         ↓
       Human Input(人工审核,可编辑 AI 建议,选择"批准"/"修改"/"升级")
         ↓
       End(发送经过人工确认的回复)
Настройка ключевых узлов
Узел LLM для классификации (выводит структурированный JSON):
Пример
"system": "Вы эксперт по классификации обращений в службу поддержки. Пожалуйста, проанализируйте следующее обращение и выведите результат классификации в формате JSON.",
"output_schema": {
"category": "стандартный или сложный",
"reason": "Причина классификации (одно предложение)",
"priority": "низкий / средний / высокий"
},
"criteria": {
"standard": Запросы о логистике, политика возврата, обычный возврат (<500 yuan), проблемы с аккаунтом,
"сложный": Крупный возврат (>500 юаней), жалобы, споры, проблемы с качеством товара
}
}
Конфигурация узла Human Input:
| Элемент конфигурации | Описание |
|---|---|
| Отображаемое содержимое | Результаты предварительного анализа ИИ + предлагаемый черновик ответа |
| Редактируемые поля. | Содержание ответа, приоритет |
| Пользовательские кнопки. | Утвердить (ответить согласно предложению ИИ), Утвердить с изменениями (ответить после ручного редактирования), Эскалировать (передать специализированной команде по обработке) |
Ожидаемые результаты
| Тип заявки | Способ обработки | Улучшение эффекта |
|---|---|---|
| Стандартные вопросы (около 80%) | Полностью автоматизированная обработка ИИ | Время ответа сокращено с 4 часов до 30 секунд |
| Сложные вопросы (около 20%) | ИИ помогает людям, предоставляя анализ и черновики | Время ручной обработки сокращено на 60% |
| в целом | - | Эффективность обработки заявок повысилась примерно в 3 раза |
Внешняя публикация: API, веб-встраивание и MCP-сервер
Публикация приложений Dify во внешние системы поддерживает три способа: вызовы API, веб-встраивание и MCP-серверы.
Публикация как API
У каждого приложения Dify автоматически есть REST API. Перейдите на страницу приложения и выберите API Access, чтобы получить его.
Пример вызова API для чат-приложения:
# 调用聊天 API(流式返回模式)
curl -X POST 'https://api.dify.ai/v1/chat-messages' \
  -H 'Authorization: Bearer {API_KEY}' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {},
    "query": "你好",
    "response_mode": "streaming",
    "conversation_id": "",
    "user": "user-001"
  }'
Пример вызова API для приложения Workflow:
# 调用 Workflow API(阻塞模式)
curl -X POST 'https://api.dify.ai/v1/workflows/run' \
  -H 'Authorization: Bearer {API_KEY}' \
  -H 'Content-Type: application/json' \
  -d '{
    "inputs": {"your_variable": "your_value"},
    "response_mode": "blocking",
    "user": "user-001"
  }'
Формат API-ключа начинается с app-. Убедитесь, что передаёте его в заголовке запроса как Authorization: Bearer, а не как параметр запроса. Каждый API-ключ соответствует только одному конкретному приложению, и ключи для разных приложений не являются взаимозаменяемыми.
Встраивание в веб-страницу
На странице приложения выберите Overview, нажмите Embedded, и доступны три способа встраивания:
Способ 1: встраивание iframe
Пример
<iframe
src="https://udify.app/chatbot/xxxxxxxx"
style="width: 100%; height: 100%; min-height: 700px"
frameborder="0"
allow="microphone">
</iframe>
Способ 2: кнопка-пузырь (плавающая в правом нижнем углу веб-страницы)
Пример
<script>
window.difyChatbotConfig = { token: 'xxxxxxxx' }
</script>
<script
src="https://udify.app/embed.min.js"
id="xxxxxxxx"
defer>
</script>
Способ 3: полноэкранная веб-страница, открывается отдельно, делитесь ссылкой напрямую: https://udify.app/chat/xxxxxxxx.
Публикация в качестве MCP-сервера
Dify поддерживает публикацию созданных рабочих процессов или агентов в виде стандартных MCP-серверов, с поддержкой режимов предварительной авторизации и без аутентификации.
Это означает: приложение для вопросов и ответов по базе знаний, которое вы создаёте в Dify, может напрямую стать узлом-инструментом для таких инструментов ИИ-программирования, как Claude Code, Cursor, omp и т. д., бесшовно интегрируясь в процесс разработки.
Путь операции: в приложении выберите Publish и нажмите MCP Server.
Наблюдаемость: мониторинг и непрерывная оптимизация
Непрерывно отслеживайте и оптимизируйте производительность ИИ-приложений с помощью журналов, аннотаций, статистики и интеграции с внешними платформами.
Просмотр журналов приложения
На странице приложения выберите Logs, чтобы просмотреть полный ввод/вывод каждого диалога, использование токенов (ввод и вывод учитываются отдельно), время ответа, модель и информацию о параметрах.
Аннотирование диалогов
В журналах щёлкните конкретный диалог, затем нажмите кнопку «нравится» или «не нравится» рядом с ответом, чтобы добавить идеальный ответ в качестве аннотации.
Варианты использования данных аннотаций включают: создание наборов данных для тонкой настройки из аннотаций, выявление пробелов в покрытии базы знаний и обнаружение часто встречающихся типов ошибок.
Статистика данных приложения
На странице приложения выберите Overview и нажмите Analytics, чтобы просмотреть:
| Статистический показатель | Описание |
|---|---|
| Динамика количества диалогов | Изменения объёма диалогов за день/неделю/месяц |
| Среднее потребление токенов | Среднее потребление токенов на диалог |
| Оценка удовлетворённости пользователей | Статистика распределения лайков/дизлайков |
| Количество активных пользователей | Количество уникальных пользователей, использующих приложение |
Интеграция внешних платформ наблюдаемости
Dify поддерживает платформы наблюдаемости, такие как Opik, Langfuse и Arize Phoenix.
На примере Langfuse: в разделе «Настройки» выберите «Мониторинг», затем Langfuse, введите Public Key и Secret Key и сохраните. После этого цепочка вызовов всех приложений будет автоматически синхронизирована с Langfuse, где можно просмотреть полную трассировку спанов и подробную информацию о стоимости токенов.
Цикл непрерывной оптимизации
Рекомендуется выстроить следующий процесс непрерывной оптимизации:
部署上线
  ↓
收集对话日志(1-2 周)
  ↓
分析差评对话:哪些问题回答得不好?
  ↓
改进知识库(补充文档、调整分块)或优化 Prompt
  ↓
A/B 测试:对比改进前后的效果
  ↓
再次部署
Цены и планы.
Изучите структуру затрат Dify Cloud и самостоятельного хостинга и выберите вариант, который лучше всего вам подходит.
План Dify Cloud
| План | Ежемесячная плата | Описание |
|---|---|---|
| Песочница | Бесплатно | 200 сообщений/месяц, 5 приложений, подходит для пробных сценариев |
| Профессиональный | $59/месяц | 5,000 сообщений/месяц, 50 приложений, поддерживает командную работу |
| Командный | $159/месяц | 10,000 сообщений/месяц, неограниченное количество приложений, приоритетная поддержка |
| Корпоративный | Индивидуальный | Неограниченное использование, возможность частного развертывания, гарантия SLA |
Затраты на самостоятельный хостинг.
Самостоятельно размещаемая Community Edition полностью бесплатна и не имеет ограничений на использование.
Вам нужно оплачивать только хостинг сервера (VPS стоит около $5-50/month) и плату за вызовы API для ИИ-моделей.
Оценка затрат (самостоятельный хостинг, 10,000 диалогов/месяц):
| Компонент | Оценочная стоимость |
|---|---|
| VPS (4 ядра, 8 GB) | $20-40/month |
| Claude Sonnet 4.6 (около 1K токенов на диалог) | ~$30/month |
| Эмбеддинг(text-embedding-3-small) | ~$2/месяц |
| Итого | ~$52-72/месяц |
По сравнению с Dify Cloud Professional ($59/месяц, плюс плата за API моделей), самохостинг обычно экономичнее при интенсивном использовании.
Советы по снижению затрат
| Совет | Описание |
|---|---|
| Индексируйте базы знаний в экономичном режиме | Если существующего поиска по ключевым словам достаточно, векторизация не нужна |
| Выберите подходящую модель | Используйте GPT-4o-mini или Gemini Flash для простых вопросов и ответов, а флагманские модели — для сложных задач |
| Установите лимит токенов | Установите max_tokens в узле LLM, чтобы предотвратить чрезмерно длинные одиночные вызовы |
| Включите кэширование | Похожие вопросы автоматически повторно используют предыдущий ответ (Prompt Cache) |
Распространённые проблемы и устранение неполадок
Охватывает методы устранения неполадок для четырёх основных категорий распространённых проблем: запуск, поиск по базе знаний, вызовы API и рабочие процессы.
Проблема при запуске
Проблема: сервисы неработоспособны после docker compose up -d
Пример
docker compose logs api
# Просмотрите логи контейнера worker
docker compose logs worker
# Проверьте, достаточно ли памяти (требуется не менее 4 GB)
free -h
# Проверьте, занят ли порт (80 или 443)
sudo lsof -i :80
Проблема: при доступе к http://localhost отображается 502 Bad Gateway
Пример
docker compose ps
После подтверждения, что api, web и worker исправны, повторите доступ.
Проблемы с поиском в базе знаний
Вопрос: в базе знаний не удаётся найти релевантный контент.
Шаги устранения неполадок:
- В базе знаний нажмите «Тестирование поиска», проверьте конкретные вопросы и убедитесь, можно ли их найти.
- Если ничего не найдено: понизьте порог схожести (с 0.6 до 0.3) и проверьте, есть ли результаты.
- Если результата всё ещё нет: убедитесь, что конфигурация модели Embedding верна, и завершено ли индексирование базы знаний.
- Если результаты есть, но содержимое неверно: проверьте стратегию разбиения документов на чанки и рассмотрите возможность ручного разделения больших файлов.
Проблема: RAG возвращает нерелевантное содержимое.
Проверьте содержимое полученного Chunk. Если Chunk нерелевантен, уменьшите размер чанка и повысьте порог оценки. Если ни один Chunk не возвращён, возможно, порог установлен слишком высоко; временно снизьте его до 0.3 и проверьте снова. Также убедитесь, что база знаний подключена на панели оркестрации приложения.
Проблемы с вызовами API
Проблема: API возвращает 401 Unauthorized
Проверьте формат API Key — API-ключи приложений Dify начинаются с app-. Убедитесь, что он передаётся в заголовке запроса как Authorization: Bearer, а не как параметр запроса. Также убедитесь, что этот API Key принадлежит нужному приложению — ключи имеют уровень приложения, и ключи для разных приложений не взаимозаменяемы.
Вопрос: потоковый ответ обрывается на середине.
Обычно это проблема тайм-аута. Проверьте настройки тайм-аута обратного прокси — по умолчанию в Nginx 60 секунд, чего может не хватать для сложных рабочих процессов.
# nginx.conf 中增加超时配置,确保长时间运行的工作流不被中断
proxy_read_timeout 300s;
proxy_connect_timeout 300s;
proxy_send_timeout 300s;
Проблемы с рабочими процессами.
Проблема: узел в рабочем процессе сообщил об ошибке.
Шаги устранения неполадок:
- Откройте панель отладки, чтобы просмотреть входные/выходные данные узла, сообщившего об ошибке.
- Нажмите на красный маркер рядом с узлом, чтобы просмотреть подробную информацию об ошибке.
- Частая причина: неверный путь ссылки на переменную (проверьте написание {{node name.variable name}})
Ресурсы
Рекомендуемые пути обучения и связанные ресурсы, которые помогут вам пройти путь от новичка до мастерства.
Рекомендуемый путь обучения
注册 Dify Cloud,用 Sandbox 体验
    ↓
配置自己的模型提供商(Anthropic 或 OpenAI)
    ↓
创建第一个知识库,上传 5-10 个文档,测试检索效果
    ↓
创建 Chatbot 应用,关联知识库,完成场景实战一
    ↓
学习 Workflow,完成场景实战二(内容生成流水线)
    ↓
探索 Human Input 节点,完成场景实战三(客服 Agent)
    ↓
用 Docker Compose 搭建本地/服务器自托管版本
    ↓
通过 API 将 Dify 应用集成到现有系统
    ↓
探索 MCP Server 发布,接入 AI 编程工具生态
Официальные ресурсы
| ресурсы | Ссылка | объяснение |
|---|---|---|
| Официальный сайт | dify.ai | Информация о продукте и вход для регистрации |
| Документация | docs.dify.ai | Полная документация по использованию продукта |
| GitHub | github.com/langgenius/dify | Открытый исходный код под лицензией Apache 2.0, вы можете просмотреть исходный код и отправлять Issues |
| Сообщество Discord | discord.gg/FngNHpbcY7 | Общайтесь с участниками сообщества и официальной командой |
| Маркетплейс шаблонов | Шаблоны в приложении | Напрямую используйте шаблоны рабочих процессов, которыми поделилось сообщество |
| Блог Dify | dify.ai/blog | Обновления функций и сценарии использования |
| FAQ по базе знаний | docs.dify.ai/faq | Официальные ответы на часто задаваемые вопросы |