Agent-Architektur
Ein Agent (intelligenter Agent) bezeichnet ein KI-System, das seine Umgebung autonom wahrnehmen, Schlussfolgerungen ziehen und Maßnahmen ergreifen kann, um Ziele zu erreichen.
Vom einfachsten Loop bis zur Multi-Agenten-Zusammenarbeit vermittelt Ihnen dieser Artikel ein gründliches Verständnis der Prinzipien, Diagramme und anwendbaren Szenarien von sechs gängigen Architekturen und hilft Ihnen, in realen Projekten geeignete technische Entscheidungen zu treffen.
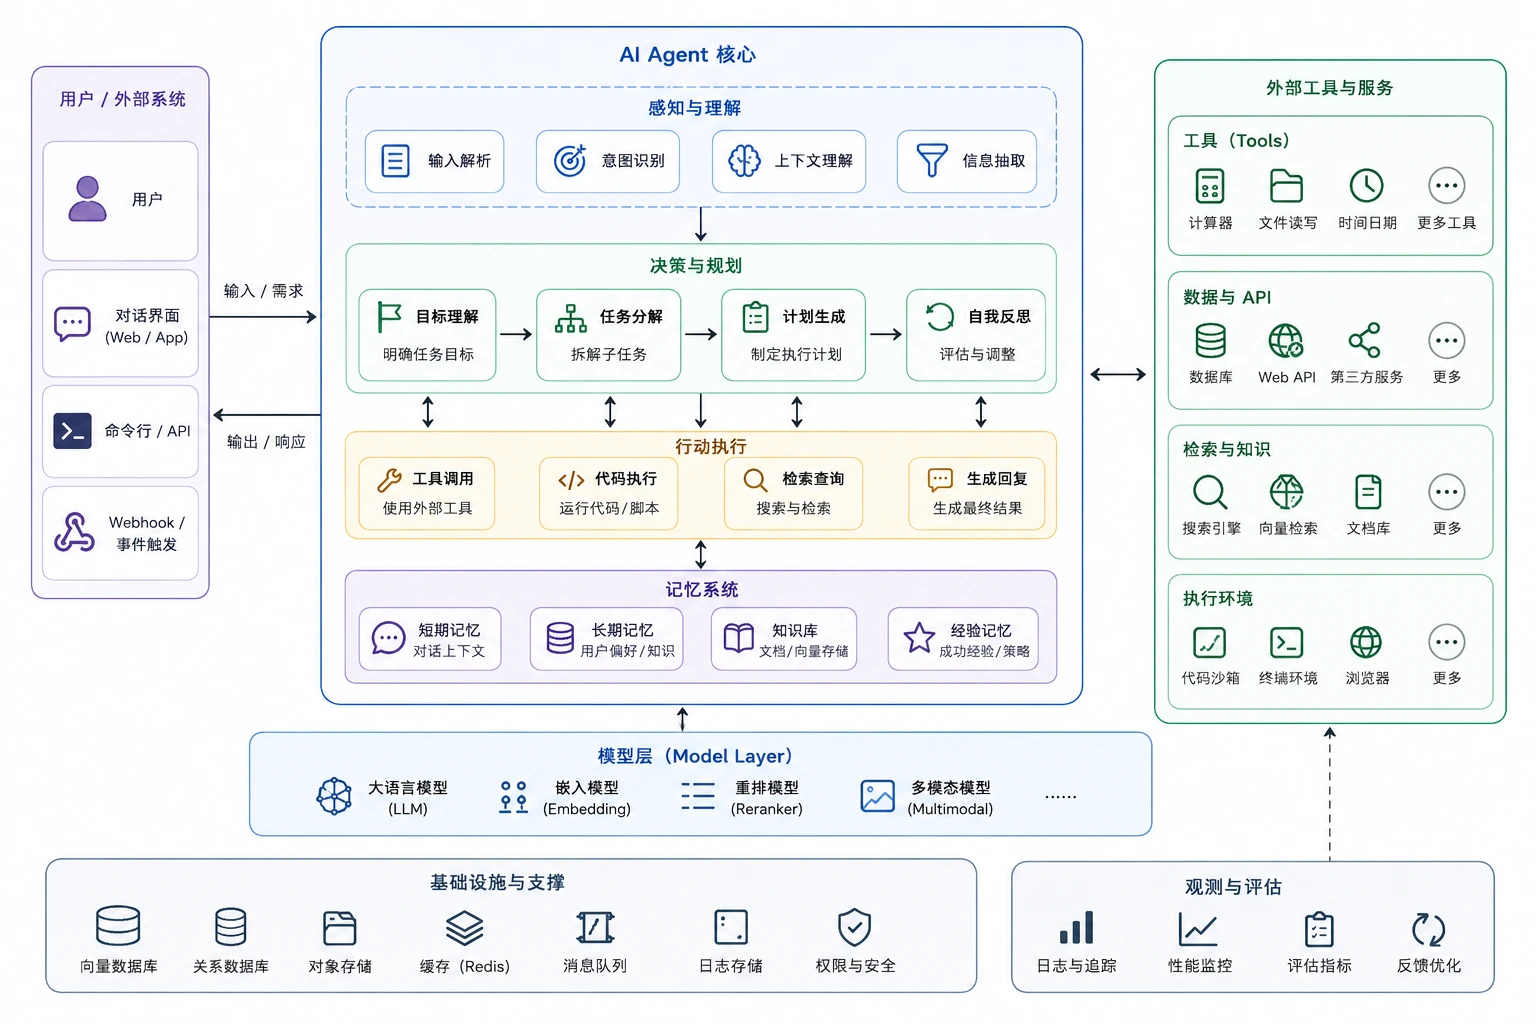
Was ist Agent-Architektur
In der KI-Anwendungsentwicklung,Agent (intelligenter Agent),bezeichnet ein KI-System, das seine Umgebung wahrnehmen, autonome Entscheidungen treffen und Maßnahmen ergreifen kann.
Im Gegensatz zu traditionellen Aufrufen großer Modelle im "Frage-Antwort"-Stil kann ein Agent kontinuierlich mehrstufige Operationen ausführen, Tools aufrufen und sogar andere Agenten koordinieren, um komplexe Aufgaben zu erledigen.
Agent-Architekturbezeichnet die Organisation der Komponenten in einem Agentensystem, die die Fähigkeitsgrenzen, Zuverlässigkeit, Flexibilität und anwendbaren Szenarien des Agenten bestimmt.
Die Funktionsweise eines Agenten ist im Wesentlichen einLoop— den aktuellen Zustand wahrnehmen, über den nächsten Schritt nachdenken, eine Aktion ausführen, erneut wahrnehmen ... bis die Aufgabe abgeschlossen ist.
Der Unterschied zwischen den Architekturen liegt darin, wie diese grundlegende Schleife organisiert und erweitert wird.
Dieser Artikel setzt voraus, dass Sie bereits mit den Grundkonzepten großer Sprachmodelle (LLMs) und der Grundidee des Tool-Aufrufs (Function Calling) vertraut sind. Wenn nicht, können Sie zuerst diese beiden Grundlagen erlernen.
Architektur 1: Single-Agent-Loop
Ideal für Anfänger Einfach zu implementieren
Die grundlegendste und intuitivste Architektur: Ein Agent erledigt alle Aufgaben von Anfang bis Ende selbstständig.
Der Single-Agent-Loop verkörpert direkt dasReAct-Muster(Reasoning + Acting): Jeder Schritt ist "erst denken, dann handeln". Das LLM dient als Gehirn, und Tool-Aufrufe sind seine Hände.
Funktionsweise
Wahrnehmen:Den aktuellen Zustand lesen — Dateiinhalte, Umgebungsvariablen, Ausgaben vorheriger Schritte — und ihn in den aktuellen Kontext integrieren.
Schlussfolgern:Das LLM entscheidet anhand des Kontexts über die nächste Aktion — welches Tool aufgerufen werden soll, welche Parameter übergeben werden — oder stellt fest, ob die Aufgabe abgeschlossen ist.
Handeln:Tool-Aufrufe ausführen, wie z. B. Dateien lesen/schreiben oder im Web suchen. Die Ausführungsergebnisse des Tools werden an den Kontext angehängt, und es geht zur nächsten Loop-Iteration über.
Jedes Tool-Aufrufergebnis wird in das Kontextfenster zurückgeschrieben. Daher wächst der Kontext mit fortschreitender Aufgabe weiter, bis er das Kontextfensterlimit des LLM erreicht — dies ist der primäre Engpass des Single-Agent-Loops.
Beispiel
class SimpleAgent:
"""Grundstruktur des Single-Agent-Loops"""
def __init__(self, model, tools, max_turns=10):
self.model = model # Großes Sprachmodell
self.tools = tools # Liste verfügbarer Tools
self.max_turns = max_turns # Maximale Loop-Iterationen, verhindert Endlosschleife
def run(self, task: str) -> str:
"""Hauptschleife zur Ausführung der Aufgabe"""
context = f"Benutzeraufgabe: {task}"
for turn in range(self.max_turns):
# Schritt 1: Denken — das Modell den nächsten Schritt entscheiden lassen
response = self.model.think(context)
# Wenn das Modell glaubt, dass die Aufgabe abgeschlossen ist, die endgültige Antwort zurückgeben
if response.is_final():
return response.content
# Schritt 2: Handeln — das vom Modell gewählte Tool aufrufen
tool_name = response.tool_name
tool_args = response.tool_args
tool_result = self.tools[tool_name](**tool_args)
# Schritt 3: Das Tool-Ergebnis zurück an das Modell geben und mit der nächsten Runde fortfahren
context += f"\nTool {tool_name} hat zurückgegeben: {tool_result}"
return "Maximale Rundenanzahl erreicht, Aufgabe nicht abgeschlossen"
# Verwendungsbeispiel
agent = SimpleAgent(model=llm, tools={
"read_file": read_file,
"search_code": search_code,
"run_test": run_test
})
result = agent.run("Behebe den Typfehler in user.py im Beispielprojekt")
Vorteile
- Am einfachsten zu implementieren, leicht zu debuggen
- Geeignet für Szenarien mit klaren Aufgabengrenzen
- Wird von fast allen Agent-Frameworks unterstützt
Nachteile
- Das Kontextfenster füllt sich schnell
- Neigt bei komplexen Aufgaben dazu, "vom Kurs abzukommen"
- Kann nicht mehrere Teilaufgaben parallel verarbeiten
Beste Anwendungsfälle:Einen Bug beheben, eine Funktion schreiben, eine bestimmte Frage beantworten. Die Aufgabe ist klar, mit moderater Komplexität, und erfordert weder Parallelität noch Zusammenarbeit mehrerer Rollen.
Wenn für Ihre Aufgabe voraussichtlich mehr als 15 Runden von Tool-Aufrufen erforderlich sind, ist eine einzelne Agent-Schleife möglicherweise nicht die beste Wahl. Ziehen Sie die Zusammenarbeit mehrerer Agenten oder eine Plan-and-Execute-Architektur in Betracht, um die Komplexität aufzuteilen.
Architektur 2: Plan & Execute
Intuitiv Überprüfbar
Trennt "herausfinden, was zu tun ist" und "es tatsächlich tun" in zwei unabhängige Phasen und verbessert die Vorhersehbarkeit und Überprüfbarkeit der Aufgabe.
Die Plan + Execute-Architektur teilt die Arbeit des Agenten in zwei verschiedene Phasen auf: zuerstPlanen, dannAusführen。
In der Planungsphase führt das Modell keine Aktionen aus; es generiert nur eine detaillierte Liste der Ausführungsschritte. In der Ausführungsphase schließt das System jeden Schritt der Reihe nach ab. Diese Trennung ermöglicht es Benutzern, den Plan vor der Ausführung zu überprüfen, ähnlich wie im Plan Mode von Claude Code.
Zwei Varianten
| Variante | Verhalten | Typisches Szenario |
|---|---|---|
| Statische Planung | Der Plan wird auf einmal generiert und linear der Reihe nach ohne Anpassungen im laufenden Prozess ausgeführt. | Aufgaben mit festen Prozessen und klar definierten Schritten, wie z. B. Datenmigrationsskripte. |
| Dynamische Planung | Nach jedem Schritt neu bewerten und den nachfolgenden Plan basierend auf den Ergebnissen anpassen. | Aufgaben mit unsicheren Ergebnissen, wie Debugging und explorative Datenanalyse. |
Dynamische Planung ist robuster, aber komplexer zu implementieren, und die Neuplanung bei jedem Schritt verbraucht zusätzliche Tokens.
Der Plan Mode von Claude Code verkörpert diese Architektur – nach dem Klicken auf "Plan" gibt die KI zunächst einen detaillierten Plan zur Überprüfung aus und beginnt erst nach Bestätigung mit der Ausführung. Dies erhöht das Kontrollgefühl des Benutzers erheblich.
Beispiel
class PlanExecuteAgent:
"""Agent, der zuerst plant und dann ausführt"""
def plan(self, task: str) -> list:
"""Phase 1: Einen Ausführungsplan generieren"""
plan = self.model.generate(f"""
Bitte zerlegen Sie die folgende Aufgabe in eine Liste ausführbarer Schritte:
Aufgabe: {task}
Geben Sie eine JSON-formatierte Liste von Schritten zurück, die jeweils enthalten:
- step_id: Schrittnummer
- description: Schrittbeschreibung
- tool: Name des aufzurufenden Tools
""")
return plan
def execute(self, plan: list, dynamic: bool = False) -> str:
"""Phase 2: Den Plan Schritt für Schritt ausführen"""
results = []
remaining_plan = plan.copy()
while remaining_plan:
step = remaining_plan.pop(0)
output = self.tools[step["tool"]](step["description"])
results.append({"step": step["step_id"], "output": output})
if dynamic and remaining_plan:
# Dynamische Planung: den nachfolgenden Plan anhand aktueller Ergebnisse neu bewerten
remaining_plan = self.replan(remaining_plan, results)
return self.summarize(results)
# Verwendungsbeispiel
agent = PlanExecuteAgent()
plan = agent.plan("Benutzerauthentifizierungsfunktion zum Beispielprojekt hinzufügen")
# Menschen können den Plan zuerst prüfen und nach Bestätigung seiner Sinnhaftigkeit ausführen
result = agent.execute(plan, dynamic=True)
Vorteile
- Der Plan kann vor der Ausführung manuell geprüft werden.
- Klare Trennung der Verantwortlichkeiten für Reasoning und Ausführung.
- Geeignet für lange Aufgaben.
Nachteile
- Der anfängliche Plan ist möglicherweise nicht genau genug.
- Der zweiphasige Ansatz erhöht die Latenz.
- Die statische Version hat Schwierigkeiten, unerwartete Situationen zu bewältigen.
Die Kosten von Plan & Execute sind erhöhte Reasoning-Runden, was für einfache Aufgaben verschwenderisch ist. Wenn eine Aufgabe in 3 Schritten erledigt werden kann, ist die direkte Verwendung einer Single-Agent-Schleife effizienter.
Architektur 3: Multi-Agent-Zusammenarbeit
Produktionsempfehlung Komplexe Aufgaben
Ein Orchestrator ist für die Aufgabenzerlegung und -planung verantwortlich; mehrere Subagenten erfüllen jeweils ihre eigenen Aufgaben, erledigen Teilaufgaben parallel oder sequenziell, und die Ergebnisse werden zur Synthese zurück zum Orchestrator geführt.
Wenn ein einzelner Agent mit einem unzureichenden Kontextfenster oder übermäßig komplexen Aufgaben konfrontiert ist, bietet die Multi-Agent-Architektur eine elegante Lösung:Lassen Sie mehrere spezialisierte Sub-Agenten parallel arbeiten, während ein Orchestrator das Gesamtgeschehen koordiniert.
Unabhängiger Kontext ist ein Kernvorteil
Jeder Sub-Agent hat einunabhängiges Kontextfenster. Das eingehende Lesen von auth.py durch den Code-Review-Agenten beeinflusst nicht das Urteil des Performance-Analyse-Agenten; die große Menge an Zwischenausgaben des Sicherheitserkennungs-Agenten verdrängt nicht den Platz anderer Agenten.
Ein Subagent ist kurzlebig und isoliert—er wird nach Abschluss einer Aufgabe zerstört. Agent Teams hingegen sind mehrere unabhängige Agent-Instanzen, die über einen langen Zeitraum zusammenarbeiten und sich gegenseitig Nachrichten senden, eher wie ein echtes Team.
Beispiel
class Orchestrator:
"""Orchestrator: verantwortlich für Aufgabenzerlegung, -verteilung und Ergebnisaggregation"""
def __init__(self):
self.subagents = {
"code_review": Subagent(
name="Code-Review",
tools=["read_file", "static_analysis"],
system_prompt="Sie sind ein Code-Review-Experte..."
),
"security": Subagent(
name="Sicherheitserkennung",
tools=["scan_vulnerability", "check_deps"],
system_prompt="Sie sind ein Experte für Sicherheitserkennung..."
),
"performance": Subagent(
name="Performance-Analyse",
tools=["profile_code", "analyze_complexity"],
system_prompt="Sie sind ein Experte für Performance-Analyse..."
)
}
def handle_task(self, task: str) -> dict:
# Schritt 1: Aufgabe analysieren und entscheiden, welche Subagenten benötigt werden
needed = self.plan(task)
# Schritt 2: Parallel verteilen (jeder Subagent arbeitet gleichzeitig mit unabhängigem Kontext)
results = {}
for agent_name in needed:
sub_task = self.decompose(task, agent_name)
results[agent_name] = self.subagents[agent_name].run(sub_task)
# Schritt 3: Die Ergebnisse jedes Subagenten aggregieren und eine umfassende Ausgabe erzeugen
return self.synthesize(task, results)
# Anwendungsbeispiel: Ein Durchlauf, dreidimensionale parallele Analyse
orch = Orchestrator()
report = orch.handle_task(Überprüfe PR #42 des Beispielprojekts)
Vorteile
- Unterstützt von Natur aus Parallelität, schnell
- Sub-Agenten sind unabhängig, ihre Kontexte beeinträchtigen sich nicht gegenseitig
- Kann die Rolle jedes Sub-Agenten spezialisieren
Nachteile
- Komplexe Koordinationslogik, schwierig zu debuggen
- Höhere Token-Kosten für parallele Multi-Agenten-Ausführung
- Der Orchestrator selbst kann zum Engpass werden
Der Hauptkostenfaktor bei der Multi-Agenten-Zusammenarbeit ist der Orchestrierungsaufwand. Wenn Teilaufgaben sehr einfach sind (jeweils nur 1-2 Schritte erforderlich), kann der Orchestrierungsaufwand die Kosten der eigentlichen Arbeit übersteigen; in diesem Fall ist ein einzelner Agent geeigneter.
Architektur 4: Reflexion und Selbstkorrektur
Hochwertige Ausgabe Einfach zu integrieren
Fügt der Ausgabephase des Agenten eine Qualitätsbewertung hinzu; falls unbefriedigend, neu generieren oder korrigieren, wodurch eine interne Iterationsschleife entsteht.
Die Reflexionsarchitektur fügt für den Agenten einen "Qualitätsprüfungsschritt" hinzu: Nach jeder Ausgabegenerierung bewertet einKritikerdie Qualität, und wenn sie nicht dem Standard entspricht, werden Korrekturen angefordert, bis die Ausgabe die Kriterien erfüllt.
Das ist, als würde ein Entwickler nach dem Schreiben Tests für seinen eigenen Code ausführen—eine Selbstprüfung vor der Auslieferung.
Zwei Implementierungsansätze
| Ansatz | Mechanismus | Vorteile | Nachteile |
|---|---|---|---|
| Selbstreflexion | Dasselbe Modell führt zuerst aus und bewertet dann seine eigene Ausgabe | Einfache Implementierung, keine zusätzlichen Modellkosten | Das Modell kann für seine eigenen Fehler "blind" sein |
| Kritiker-Modell | Ein unabhängiges Kritiker-Modell verwenden, um die Ausgabe des Ausführmodells zu bewerten | Objektiver, kann blinde Flecken des Ausführmodells erkennen | Fügt Kosten für Modellaufrufe und Latenz hinzu |
"Unit-Tests schreiben → Tests ausführen → Fehler beobachten → Code korrigieren → Erneut ausführen" — das ist eine klassische Anwendung der Reflexionsarchitektur. Die Testergebnisse selbst dienen als Feedback-Signal für den Kritiker.
Beispiel
class ReflectiveAgent:
"""Agent mit Selbstreflexionsfähigkeit"""
def __init__(self, model, tools, max_reflections=3):
self.model = model
self.tools = tools
self.max_reflections = max_reflections # Maximale Anzahl an Korrekturen, um Endlosschleifen zu verhindern
def run(self, task: str) -> str:
# Schritt 1: Normal ausführen, erste Ausgabe erzeugen
output = self.model.generate(task)
for i in range(self.max_reflections):
# Schritt 2: Reflexion — Ausgabequalität bewerten
critique = self.model.generate(f"""
Bitte bewerten Sie die folgende Ausgabe streng:
Ursprüngliche Aufgabe: {task}
Aktuelle Ausgabe: {output}
Prüfen: sachliche Fehler? Logiklücken? fehlende Informationen? Formatierungsprobleme?
Wenn die Ausgabe fehlerfrei ist, antworten Sie mit "PASS".
""")
if "PASS" in critique:
break # Ausgabe hat Prüfung bestanden
# Schritt 3: Korrektur — basierend auf Kritik verbessern
output = self.model.generate(f"""
Ursprüngliche Aufgabe: {task}
Vorherige Ausgabe: {output}
Feedback zu Problemen: {critique}
Bitte korrigieren Sie die Ausgabe basierend auf dem Feedback.
""")
return output
# Verwendungsbeispiel
agent = ReflectiveAgent(model=llm, tools={})
code = agent.run("Schreibe eine Python-Funktion, die AES-Verschlüsselung für den EXAMPLE-String implementiert")
# Nach der Codegenerierung prüft der Agent die Verschlüsselungsimplementierung und die Schlüsselverwaltung selbst,
# behebt Sicherheitslücken automatisch nach der Erkennung und gewährleistet so eine sichere und zuverlässige Ausgabe
Vorteile
- Verbessert die Ausgabequalität erheblich
- Ermöglicht das Festlegen klarer Qualitätsstandards
- Geeignet für Aufgaben mit objektiven Bewertungskriterien
Nachteile
- Mehrere Iterationen erhöhen Latenz und Kosten
- Es muss eine maximale Iterationsanzahl festgelegt werden, um Endlosschleifen zu verhindern
- Begrenzte Wirksamkeit, wenn Bewertungskriterien schwer zu formalisieren sind
Jede Iteration der Reflexionsschleife ist ein zusätzlicher LLM-Aufruf, was die Latenz erheblich erhöht. Darüber hinaus muss eine Obergrenze für die Anzahl der Reflexionen festgelegt werden, da das Modell sonst in eine Endlosschleife des "niemals zufrieden" geraten kann.
Architektur 5: RAG + Agent (Retrieval-Augmented Agent)
Wissensintensive Aufgaben Große Wissensbasen
Fügt dem Toolset des Agenten eine Vektor-Retrieval-Fähigkeit hinzu, sodass der Agent während des Schlussfolgerns dynamisch externe Wissensbasen abfragen kann und so die Einschränkungen des Kontextfensters überwindet.
RAG (Retrieval-Augmented Generation) ist ursprünglich eine Technik, die es LLMs ermöglicht, externe Wissensbasen abzufragen. In Kombination mit einem Agenten wird sie leistungsfähiger: Der Agent kannproaktiv entscheiden, wann abgerufen werden soll und was abgerufen werden soll, anstatt jedes Mal passiv einmal abzurufen.
Hauptunterschiede zum gewöhnlichen RAG
Gewöhnliches RAG ist "passiv und einmalig": Wenn ein Benutzer eine Frage stellt, ruft es einmal ab und stopft die Ergebnisse in den Prompt.
RAG + Agent ist andersDer Agent bestimmt autonom, welche Phase des Schlussfolgerns zusätzliches Wissen benötigt und was abgerufen werden soll, und kann die Wissensbasis mehrfach abfragen, bis er genügend Informationen erhält, um die Aufgabe abzuschließen.
Wenn der Codebasis-Q&A-Agent gefragt wird: "Warum wird hier das Singleton-Muster verwendet?", ruft er proaktiv Projektdokumentation, Aufzeichnungen zu Designentscheidungen und relevante Codedateien ab, anstatt nur aus dem Trainingsgedächtnis des LLM zu raten.
Beispiel
class RAGAgent:
"""Agent mit dynamischer Retrieval-Fähigkeit"""
def __init__(self, model, vector_db, max_retrievals=5):
self.model = model
self.vector_db = vector_db # Vektor-Datenbank
self.max_retrievals = max_retrievals
def should_retrieve(self, context: str, question: str) -> bool:
"""Der Agent entscheidet, ob er weitere Informationen abrufen muss"""
decision = self.model.generate(f"""
Aktuell bekannte Informationen: {context}
Aktuelle Frage: {question}
Reichen die vorhandenen Informationen aus, um die Frage zu beantworten? Antworten Sie mit YES oder NO.
""")
return "NO" in decision
def run(self, task: str) -> str:
context = ""
retrieval_count = 0
while retrieval_count < self.max_retrievals:
# Der Agent bestimmt autonom, ob ein Abruf erforderlich ist
if not self.should_retrieve(context, task):
break
# Der Agent entscheidet autonom, was abgerufen werden soll
search_query = self.model.generate(f"""
Aufgabe: {task}
Vorhandene Informationen: {context}
Welche Informationen sollen als Nächstes abgerufen werden, um die Aufgabe abzuschließen?
""")
# Abruf durchführen, Ergebnisse an den Kontext anhängen
docs = self.vector_db.search(search_query)
context += "\n".join(docs)
retrieval_count += 1
# Alle Informationen zusammenführen, um die endgültige Antwort zu generieren
return self.model.generate(f"Aufgabe: {task}\nReferenzmaterialien: {context}")
# Verwendungsbeispiel
agent = RAGAgent(model=llm, vector_db=example_docs_db)
answer = agent.run("Wie konfiguriert man einen Datenbankverbindungspool im EXAMPLE-Framework?")
# Agent ruft zuerst die "Verbindungspool-Konfiguration" ab und findet Erwähnungen von "maximalen Verbindungen"
# Wenn es nicht versteht, ruft es erneut "Best Practices für maximale Verbindungen" ab
# Schließlich synthetisiert es die Ergebnisse mehrerer Abrufrunden, um eine vollständige Antwort zu liefern
Vorteile
- Überwindet Beschränkungen des Kontextfensters
- Ausgabe ist gut dokumentiert, wodurch Halluzinationen reduziert werden
- Wissensbasis kann unabhängig aktualisiert werden
Nachteile
- Abrufqualität beeinflusst die Gesamtergebnisse
- Wartungskosten von Vektordatenbanken
- Abruflatenz erhöht die Antwortzeit
Architektur 6: Workflow-Orchestrierung (Workflow / DAG)
Für die Produktion bevorzugt Hohe Zuverlässigkeit
Agent-Verhalten in einen gerichteten azyklischen Graphen (DAG) überführen, wobei jeder Knoten ein LLM-Aufruf oder Tool-Aufruf ist, Kanten Datenabhängigkeiten darstellen und die Ausführung vom Framework gesteuert wird.
Dies ist eine Agent-Architektur, die der traditionellen Softwareentwicklung am nächsten kommt. Der größte Unterschied zu den vorherigen Architekturen ist:Der autonome Entscheidungsspielraum des Agenten ist auf einen einzelnen Knoten beschränkt, und der Fluss zwischen den Knoten ist vordefiniert und unveränderlich.
Reiner Agent vs. DAG-Workflow
| Merkmal | Reiner Agent | DAG-Workflow |
|---|---|---|
| Ablaufsteuerung | Modell entscheidet autonom über den nächsten Schritt | Durch vordefinierten DAG-Graphen festgelegt |
| Vorhersagbarkeit | Gering, Ausführungspfad kann jedes Mal anders sein | Hoch, Ausführungspfad ist fest |
| Debugbarkeit | Schwierig, hängt von Log-Nachverfolgung ab | Einfach, Eingabe und Ausgabe jedes Knotens sind klar |
| Fehlertoleranz | Hängt von der Selbstwiederherstellung des Modells ab | Framework bietet Wiederholung und Fortsetzung ab Checkpoint |
| Flexibilität | Hoch, kann unerwartete Situationen bewältigen | Gering, kann nur vordefinierten Pfaden folgen |
Die "Azyklizität" von DAG bedeutet, dass der Workflowdeterministischist – keine Endlosschleifen, der Ausführungspfad kann vollständig vorhergesagt werden und fehlgeschlagene Knoten können einzeln wiederholt werden.
DAG ist der Extremfall von "geringer Autonomie, hoher Vorhersagbarkeit". Sie müssen den gesamten Prozess vorab entwerfen. Das ist kein Nachteil, sondern ein bewusster Design-Kompromiss – in Produktionsumgebungen ist Determinismus manchmal wichtiger als Flexibilität.
Beispiel
from langgraph import StateGraph
# Workflow-Zustand definieren – Datenobjekt, das zwischen Knoten übergeben wird
class PipelineState:
raw_data: str = "" # Rohdaten
cleaned_data: str = "" # Bereinigte Daten
analysis_result: dict = {} # Analyseergebnis
final_report: str = "" # Abschlussbericht
# DAG-Knoten definieren – jeder Knoten ist eine unabhängige Verarbeitungseinheit
def extract_data(state: PipelineState) -> PipelineState:
"""Knoten 1: Rohdaten aus Beispieldatenbank extrahieren"""
state.raw_data = query_database("SELECT * FROM logs")
return state
def clean_data(state: PipelineState) -> PipelineState:
"""Knoten 2: Daten bereinigen (deduplizieren, Format standardisieren)"""
state.cleaned_data = preprocess(state.raw_data)
return state
def analyze_data(state: PipelineState) -> PipelineState:
"""Knoten 3: Statistische Analyse"""
state.analysis_result = statistical_analysis(state.cleaned_data)
return state
def generate_report(state: PipelineState) -> PipelineState:
"""Knoten 4: Bericht mit LLM generieren"""
state.final_report = llm.generate(
f"Erstelle einen Bericht basierend auf den folgenden Analyseergebnissen: {state.analysis_result}"
)
return state
# DAG erstellen: Knoten und Kanten definieren (Datenfluss)
workflow = StateGraph(PipelineState)
workflow.add_node("extract", extract_data)
workflow.add_node("clean", clean_data)
workflow.add_node("analyze", analyze_data)
workflow.add_node("report", generate_report)
# Kanten definieren: extract → clean → analyze → report
workflow.add_edge("extract", "clean")
workflow.add_edge("clean", "analyze")
workflow.add_edge("analyze", "report")
workflow.set_entry_point("extract")
workflow.set_finish_point("report")
# Kompilieren und ausführen
app = workflow.compile()
result = app.invoke(PipelineState())
print(result.final_report)
Vorteile
- Vorhersehbar, prüfbar, wiederholbar
- Unterstützt parallele Beschleunigung
- Hohe technische Reife, betriebsfreundlich
Nachteile
- Ablauf erfordert Vorab-Design, geringe Flexibilität
- Schwierig, unerwartete Situationen zu bewältigen
- Erfordert das Erlernen von Orchestrierungsframeworks
Horizontaler Vergleich und Auswahl
Vergleiche sechs Architekturen über mehrere Dimensionen, um schnell die richtige Option zu finden.
| Architektur | Autonomie | Vorhersagbarkeit | Parallelfähigkeit | Geeignete Aufgabenkomplexität | Typische Implementierung |
|---|---|---|---|---|---|
| Einzel-Agent-Schleife | Hoch | Niedrig | Keine | Mittel-niedrig | Claude Code-Standardmodus |
| Planung + Ausführung | Mittel | Mittel | Teilweise | Mittel-hoch | Claude Code Planungsmodus |
| Multi-Agent-Zusammenarbeit | Hoch | Niedrig | stark | Hoch | AutoGen, CrewAI |
| Reflexion / Selbstkorrektur | Mittel | Mittel | Keine | Mittel | Reflexion, Self-Refine |
| RAG + Agent | Hoch | Mittel | Keine | Mittel-hoch | LangChain RAG Agent |
| Workflow-Orchestrierung | Niedrig | Hoch | stark | Hoch (fester Ablauf) | LangGraph, Prefect |
Häufige Kombinationsmuster
Reale Produktionssysteme kombinieren oft mehrere Architekturen. Hier sind einige ausgereifte Kombinationsmuster:
Workflow-Orchestrierung + Multi-Agent: Verwende einen DAG, um den Hauptablauf zu definieren, wobei jeder Knoten ein unabhängiger Agent ist. Zum Beispiel ist in einer CI/CD-Pipeline der Code-Review-Knoten ein Code-Review-Agent und der Sicherheitsscan-Knoten ein Security-Agent.
Multi-Agent + RAG: Mehrere Subagenten teilen sich dieselbe Vektor-Wissensbasis, wobei jeder bei Bedarf basierend auf seiner Teilaufgabe abruft. Zum Beispiel fragen in einem Kundenservicesystem sowohl der Bestellabfrage-Agent als auch der Rückerstattungs-Agent dieselbe Wissensbasis ab, rufen aber unterschiedliche Inhalte ab.
Planung + Ausführung + Reflexion: Zuerst planen, dann ausführen, aber nach jedem Schritt einen Reflexionsschritt hinzufügen, um die Qualität sicherzustellen. Geeignet für Aufgaben mit extrem hohen Qualitätsanforderungen.
Wenn du unsicher bist, wo du anfangen sollst, beginne mit einer Einzel-Agent-Schleife. Sie ist am einfachsten zu implementieren und zu debuggen. Wenn du feststellst, dass das Kontextfenster nicht mehr ausreicht, ziehe Multi-Agent in Betracht; wenn du Qualitätssicherung benötigst, füge eine Reflexionsschicht hinzu; wenn der Prozess stabil wird, refaktoriere ihn in einen DAG, um die Zuverlässigkeit zu verbessern.
Häufige Missverständnisse
Missverständnis 1: Je komplexer die Architektur, desto besser
Multi-Agent-Zusammenarbeit sieht mächtig aus, aber wenn deine Aufgabe mit einer Einzel-Agent-Schleife in 5 Schritten erledigt werden kann, verringert die Einführung von Orchestrierungs-Overhead tatsächlich die Effizienz. Prinzip: Verwende die einfachste Architektur, die die Anforderungen erfüllt.
Missverständnis 2: Reflexion verbessert definitiv die Qualität
Die Wirksamkeit der Selbstreflexion hängt von der Selbsteinschätzungsfähigkeit des Modells ab. Wenn die Qualitätsanforderungen extrem streng sind, ziehe die Verwendung eines Critic-Modells oder die Einführung externer Validierung (z. B. automatisierte Code-Tests) in Betracht.
Missverständnis 3: DAG-Workflows benötigen keine Agenten
DAG definiert das Prozessskelett, aber jeder Knoten kann intern weiterhin ein Agent-Aufruf sein. Workflow-Orchestrierung und Agent-Fähigkeiten schließen sich nicht gegenseitig aus, sondern ergänzen sich — DAG bietet Zuverlässigkeit, und Agenten bieten Flexibilität.
Missverständnis 4: Ein größeres Kontextfenster bedeutet, dass RAG nicht benötigt wird
Selbst wenn das Modell ein Kontextfenster von 1M Token unterstützt, ist es immer noch nicht optimal, alle Dokumente hineinzustopfen. Der Wert von RAG liegt nicht nur darin, „alles hineinpacken zu können“, sondern auch inpräzisem Retrieval— Rauschen zu reduzieren, Inferenzkosten zu senken und die Antwortgenauigkeit zu verbessern.
Zusammenfassung
Sechs Agent-Architekturen decken das gesamte Spektrum von hochgradig autonom bis hochgradig kontrollierbar ab.
Bei der Auswahl einer Architektur gibt es nur zwei Kernüberlegungen:Wie viel Flexibilität Sie benötigen, um unerwartete Situationen zu bewältigen, undwie viel Gewissheit Sie benötigen, um zuverlässige Ergebnisse zu gewährleisten。
Einfach anfangen und Komplexität nur hinzufügen, wenn sie wirklich benötigt wird — das ist das erste Prinzip bei der Auswahl einer Agent-Architektur.
Weitere Erweiterungen