Agent アーキテクチャ
Agent(エージェント)とは、環境を自律的に認識し、推論し、目標を達成するために行動を起こす AI システムです。
本記事では、最も単純なループからマルチ Agent 協調まで、6つの主流アーキテクチャの原理、図解、適用シナリオを一気に理解し、実際のプロジェクトで適切な技術選定を行うのに役立ちます。
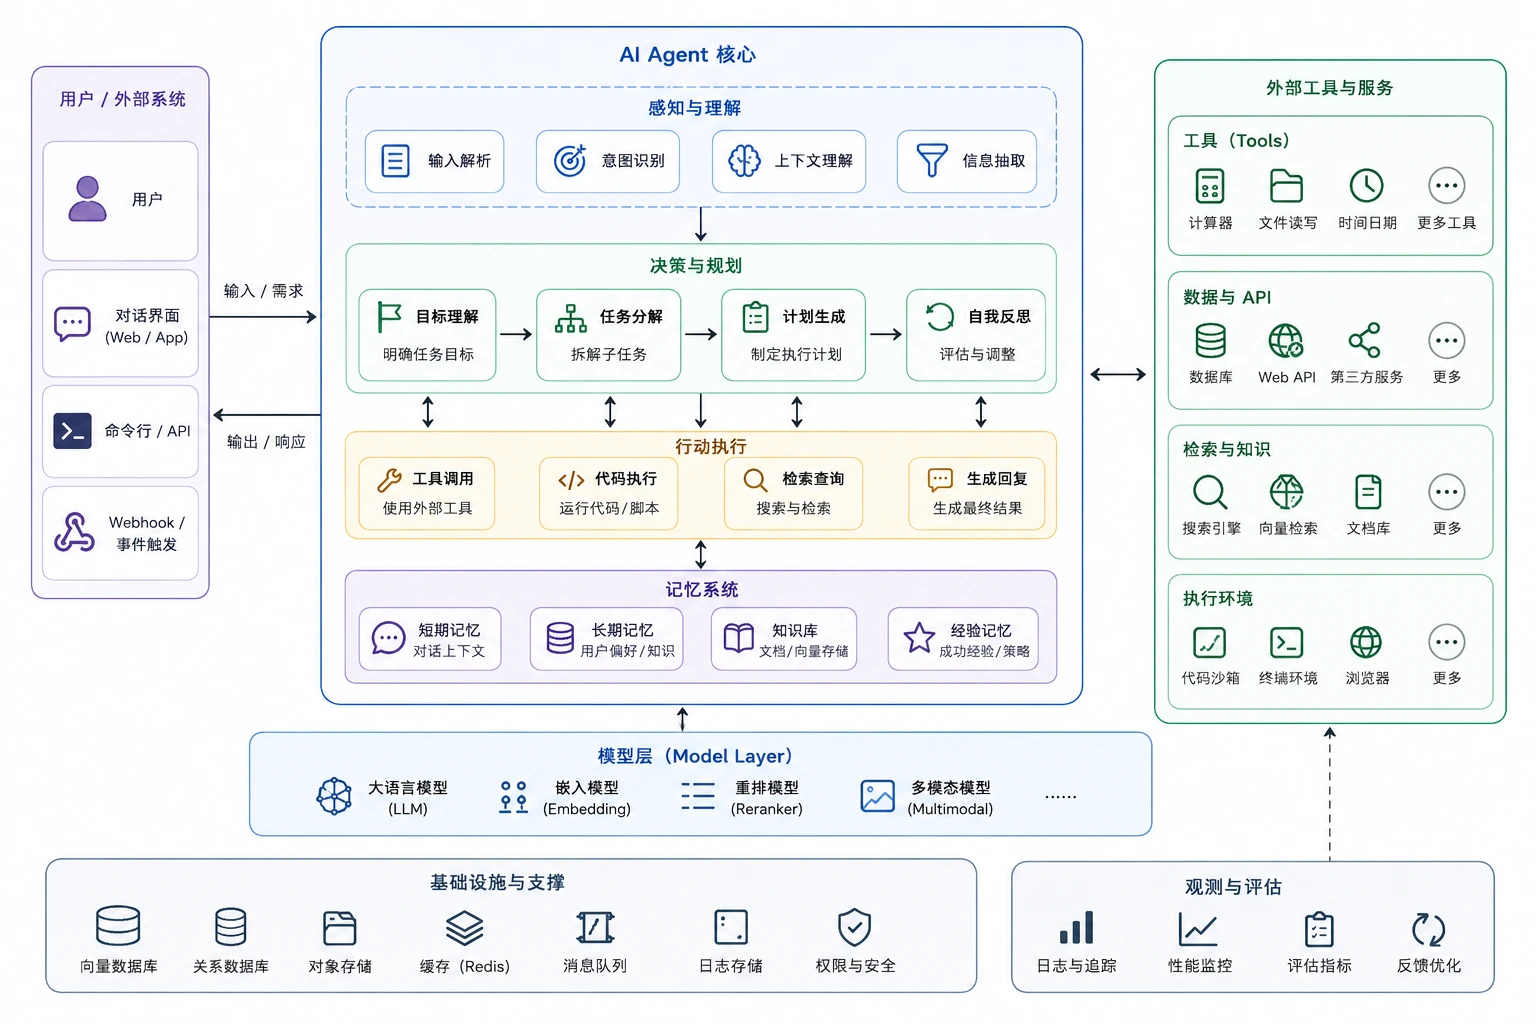
Agent アーキテクチャとは
AI アプリケーション開発において、Agent(エージェント)とは環境を認識し、自律的に意思決定し、行動を起こす AI システムを指します。
従来の「一問一答」型の大規模モデル呼び出しとは異なり、Agent は複数ステップの操作を連続的に実行し、ツールを呼び出し、さらには他の Agent を調整して、複雑なタスクを完了できます。
Agent アーキテクチャとはAgent システム内の各コンポーネントの編成方法を指し、Agent の能力の限界、信頼性、柔軟性、適用シナリオを決定します。
Agent の動作方法は本質的にループ(Loop)です。——現在の状態を認識し、次のステップを推理し、行動を実行し、再び認識する……タスクが完了するまで繰り返します。
アーキテクチャごとの違いは、この基本ループをどのように編成し拡張するかにあります。
本記事では、大規模言語モデル(LLM)の基本概念と、「ツール呼び出し」(Function Calling)の基本的な考え方を理解していることを前提としています。まだ馴染みがない場合は、まずこの2つの基礎知識を学んでください。
アーキテクチャ1: 単一 Agent ループ(Single Agent Loop)
入門者に最適 実装が簡単
最も基本的で直感的なアーキテクチャで、1つの Agent が最初から最後まで独立してすべてのタスクを完了します。
単一 Agent ループは直接体現しています:ReAct パターン(Reasoning + Acting):各ステップは「先に考えてから行動する」ことを意味します。LLM が頭脳の役割を担い、ツール呼び出しがその両手となります。
動作原理
知覚:現在の状態(ファイルの内容、環境変数、前のステップの出力結果)を読み取り、現在のコンテキストに統合します。
推論:LLM はコンテキストに基づいて次のアクション(どのツールを呼び出すか、どのパラメータを渡すか、またはタスクが完了したかどうか)を決定します。
行動:ツール呼び出しを実行します(例:ファイルの読み書き、ネットワーク検索)。ツールの実行結果はコンテキストに追加され、次のループに入ります。
ツール呼び出しの結果は毎回コンテキスト(Context Window)に書き戻されます。そのため、タスクが進むにつれてコンテキストは増え続け、LLM のコンテキストウィンドウの制限に達します。これが単一 Agent ループの最も主要なボトルネックです。
例
class SimpleAgent:
"""単一 Agent ループの基本構造"""
def __init__(self, model, tools, max_turns=10):
self.model = model # 大規模言語モデル
self.tools = tools # 利用可能なツールリスト
self.max_turns = max_turns # 最大ループ回数。無限ループを防ぐ
def run(self, task: str) -> str:
"""タスクを実行するメインループ"""
context = f"ユーザータスク:{task}"
for turn in range(self.max_turns):
# ステップ1: 思考 —— モデルに次のステップを決定させる
response = self.model.think(context)
# モデルがタスク完了と判断した場合は、最終回答を返す
if response.is_final():
return response.content
# ステップ2: 行動 —— モデルが選択したツールを呼び出す
tool_name = response.tool_name
tool_args = response.tool_args
tool_result = self.tools[tool_name](**tool_args)
# ステップ3: ツールの結果をモデルにフィードバックし、次のループへ
context += f"\nツール {tool_name} の戻り値:{tool_result}"
return "最大ループ回数に達しました。タスクは未完了です"
# 使用例
agent = SimpleAgent(model=llm, tools={
"read_file": read_file,
"search_code": search_code,
"run_test": run_test
})
result = agent.run("サンプル プロジェクト内の user.py の型エラーを修正")
利点
- 実装が最も簡単で、デバッグしやすい
- タスクの境界が明確なシナリオに適している
- ほぼすべての Agent フレームワークが対応している
欠点
- コンテキストウィンドウが満杯になりやすい
- 複雑なタスクでは「脱線」しやすい
- 複数のサブタスクを並行処理できない
最適な適用シナリオ:バグの修正、関数の作成、具体的な質問への回答など。タスクが明確で複雑さが適度であり、並列処理や複数役割の協調が不要な場合。
タスクに15回以上のツール呼び出しが必要になると見込まれる場合、単一 Agent ループは最適ではない可能性があります。マルチ Agent 協調やプラン&実行アーキテクチャを使用して、複雑さを分解することを検討してください。
アーキテクチャ2: プラン + 実行(Plan & Execute)
直感的で親しみやすい 監査可能
「何をするか明確に考える」と「実際に実行する」を2つの独立した段階に分離し、タスクの予測可能性と監査可能性を高めます。
プラン&実行アーキテクチャは、Agent の作業を2つの明確な段階に分割します:まずプラン(Plan)、次に実行(Execute)。
プラン段階では、モデルは何も実行せず、詳細な実行ステップのリストを生成するだけです。実行段階では、システムが各ステップを順番に完了します。この分離により、ユーザーは実行前に計画を確認できます。これは Claude Code の Plan Mode と同様です。
2つのバリエーション
| バリエーション | 動作 | 代表的なシナリオ |
|---|---|---|
| 静的プラン | 計画を一度に生成し、順番に線形的に実行し、途中で調整しない | フローが固定され、手順が明確なタスク。例:データ移行スクリプト |
| 動的プラン | 各ステップを実行するごとに再評価し、結果に基づいて以降の計画を調整する | 結果が不確実なタスク。例:デバッグ、探索的データ分析 |
動的計画法はより堅牢だが、実装の複雑さは高く、各ステップでの再計画が追加のトークンを消費する。
Claude Code の Plan Mode はこのアーキテクチャの体现であり——「計画」をクリックすると、AI がまず詳細な計画を出力してレビューを求め、確認後に初めて実行を開始する。これにより、ユーザーのコントロール感が大幅に向上する。
例
class PlanExecuteAgent:
"""先に計画し、後に実行する Agent"""
def plan(self, task: str) -> list:
"""フェーズ1:実行計画の生成"""
plan = self.model.generate(f"""
以下のタスクを実行可能なステップのリストに分解してください:
タスク:{task}
JSON 形式のステップリストを返してください。各ステップには以下を含みます:
- step_id: ステップ番号
- description: ステップの説明
- tool: 呼び出す必要のあるツール名
""")
return plan
def execute(self, plan: list, dynamic: bool = False) -> str:
"""フェーズ2:計画をステップごとに実行"""
results = []
remaining_plan = plan.copy()
while remaining_plan:
step = remaining_plan.pop(0)
output = self.tools[step["tool"]](step["description"])
results.append({"step": step["step_id"], "output": output})
if dynamic and remaining_plan:
# 動的計画法:現在の結果に基づいて後続の計画を再評価する
remaining_plan = self.replan(remaining_plan, results)
return self.summarize(results)
# 使用例
agent = PlanExecuteAgent()
plan = agent.plan(「サンプル プロジェクトにユーザー認証機能を追加する」)
# 人間は先に plan をレビューし、妥当性を確認してから実行できる
result = agent.execute(plan, dynamic=True)
利点
- 実行前に計画を人間がレビューできる
- 推論と実行の責務が分離されており、明確
- 長いタスクに適している
欠点
- 初期計画が十分に正確でない可能性がある
- 2フェーズ構成により遅延が増加する
- 静的なバージョンでは予期しない状況に対応しにくい
Plan & Execute のコストは推論ラウンドの増加であり、単純なタスクにとってはむしろ無駄である。タスクが3ステップ以内で完了できるなら、単一 Agent ループを直接使う方が効率のだ。
アーキテクチャ3: マルチ Agent 協調(Multi-Agent)
本番環境での推奨 複雑なタスク
Orchestrator(コーディネーター)がタスクの分解とスケジューリングを担当し、複数の Subagent がそれぞれの役割を果たし、並列または直列でサブタスクを完了し、結果は Orchestrator に集約されて総合処理される。
単一の Agent がコンテキストウィンドウの不足やタスクの複雑さに直面したとき、マルチ Agent アーキテクチャはエレガントな解決策を提供する:複数の専門化されたサブ Agent を並列に動作させ、Orchestrator(コーディネーター)が全体を統括する。
独立したコンテキストが中核的な利点
各サブ Agent は独立したコンテキストウィンドウを持つ。コードレビュー Agent が auth.py を深く読んでも、パフォーマンス分析 Agent の判断には影響しない。セキュリティ検出 Agent が生成する大量の中間出力も、他の Agent の領域を圧迫しない。
サブ Agent(Subagent)は短命かつ分離されており——タスクを完了すると即座に破棄される。Agent チーム(Agent Teams)は、複数の独立した Agent インスタンスが長時間協力し、互いにメッセージを送り合う、より現実のチームに近いものだ。
例
class Orchestrator:
"""オーケストレーター:タスクの分解、配布、結果の集約を担当"""
def __init__(self):
self.subagents = {
"code_review": Subagent(
name=「コードレビュー」,
tools=["read_file", "static_analysis"],
system_prompt=「あなたはコードレビューの専門家です...」
),
"security": Subagent(
name=「セキュリティ検出」,
tools=["scan_vulnerability", "check_deps"],
system_prompt=「あなたはセキュリティ検出の専門家です...」
),
"performance": Subagent(
name=「パフォーマンス分析」,
tools=["profile_code", "analyze_complexity"],
system_prompt=「あなたはパフォーマンス分析の専門家です...」
)
}
def handle_task(self, task: str) -> dict:
# ステップ1:タスクを分析し、どの Subagent が必要かを決定する
needed = self.plan(task)
# ステップ2:並列配布(各 Subagent は同時に動作し、コンテキストは独立)
results = {}
for agent_name in needed:
sub_task = self.decompose(task, agent_name)
results[agent_name] = self.subagents[agent_name].run(sub_task)
# ステップ3:各 Subagent の結果を集約し、総合出力する
return self.synthesize(task, results)
# 使用例:1回の実行で、3つの次元を並列分析
orch = Orchestrator()
report = orch.handle_task(「サンプル プロジェクトの PR #42 をレビューする」)
利点
- 並列処理を自然にサポートし、速度が速い
- サブ Agent はそれぞれ独立しており、コンテキストが互いに干渉しない
- 各サブ Agent の役割を専門化できる
欠点
- 協調ロジックが複雑で、デバッグが難しい
- 複数の Agent の並列処理により Token コストが高くなる
- Orchestrator 自体がボトルネックになる可能性がある
マルチ Agent 協調の主なコストはオーケストレーションのオーバーヘッドである。サブタスクが非常に単純な場合(各1〜2ステップのみ)、オーケストレーションのオーバーヘッドが実際の作業のオーバーヘッドを超える可能性があり、その場合は単一 Agent の方が適している。
アーキテクチャ4: 反省と自己修正(Reflection)
高品質な出力 統合が容易
Agent の出力段階に品質評価を追加し、満足できない場合は再生成または修正を行い、内部イテレーションループを形成する。
反省アーキテクチャは Agent に「品質チェック段階」を追加する:出力を生成するたびに、判定者(Critic)が品質を評価し、基準に達していない場合は修正を要求し、出力が基準を満たすまで続ける。
これは開発者がコードを書いた後に自分でテストを実行するのと同じで——納品前に一度自己チェックするようなものだ。
2つの実装方法
| 方式 | メカニズム | 利点 | 欠点 |
|---|---|---|---|
| 自己反省 | 同じモデルが先に実行し、その後自分の出力を評価する | 実装が簡単で、追加のモデルコストなし | モデルが自分のエラーに「見て見ぬふり」をする可能性がある |
| Critic モデル | 独立した判定モデルで実行モデルの出力を評価する | より客観的で、実行モデルの盲点を発見できる | モデル呼び出しコストと遅延が増加する |
「単体テストを書く → テストを実行する → 失敗を観察する → コードを修正する → 再度実行する」——これが反省アーキテクチャの古典的な応用である。テスト結果自体が Critic のフィードバックシグナルとなる。
例
class ReflectiveAgent:
"""自己反省機能を持つ Agent"""
def __init__(self, model, tools, max_reflections=3):
self.model = model
self.tools = tools
self.max_reflections = max_reflections # 最大修正回数。無限ループを防ぐ
def run(self, task: str) -> str:
# ステップ1:正常に実行し、初期出力を生成
output = self.model.generate(task)
for i in range(self.max_reflections):
# ステップ2:反省 —— 出力の品質を評価
critique = self.model.generate(f"""
以下の出力を厳格に評価してください:
元のタスク:{task}
現在の出力:{output}
チェック項目:事実誤認?論理の欠陥?情報の漏れ?フォーマットの問題?
出力が完璧なら「PASS」と返信してください。
""")
if "PASS" in critique:
break # 出力はレビューを通過
# ステップ3:修正 —— 批評意見に基づいて改善
output = self.model.generate(f"""
元のタスク:{task}
前回の出力:{output}
問題のフィードバック:{critique}
フィードバックに基づいて出力を修正してください。
""")
return output
# 使用例
agent = ReflectiveAgent(model=llm, tools={})
code = agent.run(「サンプル 文字列の AES 暗号化を実装する Python 関数を書く」)
# Agent はコード生成後、暗号化の実装や鍵の処理を自己チェックし、
# 脆弱性を発見したら自動修正し、出力が安全で信頼できることを確保する
利点
- 出力品質を顕著に向上させる
- 明確な品質基準を設定できる
- 客観的な判定基準があるタスクに適している
欠点
- 複数回の反復により遅延とコストが増加する
- 無限ループを防ぐため、最大反復回数の設定が必要
- 評価基準を形式化しにくい場合、効果は限定的である。
自己反省ループは各反復ごとに追加のLLM呼び出しが必要になり、遅延が大幅に増加する。また、自己反省回数の上限を設定する必要がある。そうしないと、モデルが「永遠に満足しない」無限ループに陥る可能性がある。
アーキテクチャ5: RAG + Agent(検索拡張型エージェント)
知識集約型タスク 大規模ナレッジベース
Agentのツールセットにベクトル検索機能を追加し、Agentが推論プロセス中に外部ナレッジベースを動的に照会できるようにして、コンテキストウィンドウの制限を克服する。
RAG(Retrieval-Augmented Generation、検索拡張生成)は、本来LLMに外部ナレッジベースを照会させる技術である。これがAgentと組み合わさると、さらに強力になる。Agentはいつ検索するか、何を検索するかを主体的に決定できる毎回受動的に一度だけ検索するのではなく。
通常の RAG との重要な違い
通常のRAGは「受動的・一回きり」である。ユーザーが質問した際に固定的に一度だけ検索し、結果をPromptに埋め込む。
RAG + Agentはそれとは異なる:Agentは推論のどの段階で知識の補充が必要か、何を検索すべきかを自律的に判断し、タスクを完了するのに十分な情報を得るまでナレッジベースを複数回照会できる。
コードベースQ&A Agentは「なぜここでシングルトンパターンを使うのか?」と聞かれた場合、LLMのトレーニング記憶だけに頼って推測するのではなく、プロジェクトドキュメント、設計決定記録、関連コードファイルを能動的に検索する。
例
class RAGAgent:
"""動的検索機能を備えたAgent"""
def __init__(self, model, vector_db, max_retrievals=5):
self.model = model
self.vector_db = vector_db # ベクトルデータベース
self.max_retrievals = max_retrievals
def should_retrieve(self, context: str, question: str) -> bool:
"""Agent自身がさらに情報を検索する必要があるかを判断する"""
decision = self.model.generate(f"""
現在の既知情報:{context}
現在の問題:{question}
現在の情報で問題に答えるのに十分か? YES か NO で回答してください。
""")
return "NO" in decision
def run(self, task: str) -> str:
context = ""
retrieval_count = 0
while retrieval_count < self.max_retrievals:
# Agentが検索が必要かどうかを自律的に判断
if not self.should_retrieve(context, task):
break
# Agentが何を検索するかを自律的に決定
search_query = self.model.generate(f"""
タスク:{task}
既存情報:{context}
タスクを完了するために、次にどのような情報を検索すべきか?
""")
# 検索を実行し、結果をコンテキストに追加
docs = self.vector_db.search(search_query)
context += "\n".join(docs)
retrieval_count += 1
# すべての情報を統合して最終回答を生成
return self.model.generate(f"タスク:{task}\n参考資料:{context}")
# 使用例
agent = RAGAgent(model=llm, vector_db=サンプル_docs_db)
answer = agent.run("サンプルフレームワークでデータベース接続プールを設定するには?")
# Agentはまず「接続プール設定」を検索し、「最大接続数」への言及を発見
# 理解できない場合は、再度「最大接続数のベストプラクティス」を検索
# 最終的に複数回の検索結果を統合して完全な回答を提供
利点
- コンテキストウィンドウの制限を突破できる
- 出力に根拠があり、幻覚(ハルシネーション)を軽減できる
- ナレッジベースを独立して更新できる
欠点
- 検索品質が全体の効果に影響する
- ベクトルデータベースの保守コスト
- 検索遅延により応答時間が増加する
アーキテクチャ6: ワークフローオーケストレーション(Workflow / DAG)
本番環境での第一選択 高信頼性
Agentの行動を有向非巡回グラフ(DAG)として固定化する。各ノードはLLM呼び出しまたはツール呼び出しであり、エッジはデータ依存関係を表し、フレームワークが実行を駆動する。
これは従来のソフトウェアエンジニアリングに最も近いAgentアーキテクチャである。前述のいくつかのアーキテクチャとの最大の違いは次の点にある:Agentの自律的な意思決定空間が単一ノード内に制限されるノード間の遷移は事前に定義されており、変更できない。
純粋な Agent vs DAG ワークフロー
| 特性 | 純粋なAgent | DAGワークフロー |
|---|---|---|
| フロー制御 | モデルが次のステップを自律的に決定 | 事前定義されたDAG図が決定 |
| 予測可能性 | 低い。実行のたびに経路が異なる可能性がある | 高い。実行経路が確定している |
| デバッグ容易性 | 難しい。ログ追跡に依存する | 容易。各ノードの入出力が明確 |
| フォールトトレランス | モデル自身の回復に依存 | フレームワークがリトライ、チェックポイントからの再開を提供 |
| 柔軟性 | 高い。予期しない状況に対応できる | 低い。事前定義された経路しか進めない |
DAGの「非巡回」(Acyclic)特性は、ワークフローが決定的(deterministic)である——無限ループがなく、実行経路を完全に予測でき、失敗したノードは個別にリトライできる。
DAGは「低自律性・高予測可能性」の極端な例である。プロセス全体を事前に設計しておく必要がある。これは欠点ではなく、意図的な設計上のトレードオフである。本番環境では、柔軟性よりも決定性が重要な場合がある。
例
from langgraph import StateGraph
# ワークフローの状態を定義 —— ノード間で受け渡されるデータオブジェクト
class PipelineState:
raw_data: str = "" # 元の入力データ
cleaned_data: str = "" # クレンジング後のデータ
analysis_result: dict = {} # 分析結果
final_report: str = "" # 最終レポート
# DAGノードを定義 —— 各ノードは独立した処理ユニット
def extract_data(state: PipelineState) -> PipelineState:
"""ノード1:サンプルデータベースから元データを抽出"""
state.raw_data = query_database("SELECT * FROM logs")
return state
def clean_data(state: PipelineState) -> PipelineState:
"""ノード2:データのクレンジング(重複排除、形式の標準化)"""
state.cleaned_data = preprocess(state.raw_data)
return state
def analyze_data(state: PipelineState) -> PipelineState:
"""ノード3:統計分析"""
state.analysis_result = statistical_analysis(state.cleaned_data)
return state
def generate_report(state: PipelineState) -> PipelineState:
"""ノード4:LLMを使用してレポートを生成"""
state.final_report = llm.generate(
f"以下の分析結果に基づいてレポートを生成:{state.analysis_result}"
)
return state
# DAGを構築:ノードとエッジ(データフロー)を定義
workflow = StateGraph(PipelineState)
workflow.add_node("extract", extract_data)
workflow.add_node("clean", clean_data)
workflow.add_node("analyze", analyze_data)
workflow.add_node("report", generate_report)
# エッジを定義:extract → clean → analyze → report
workflow.add_edge("extract", "clean")
workflow.add_edge("clean", "analyze")
workflow.add_edge("analyze", "report")
workflow.set_entry_point("extract")
workflow.set_finish_point("report")
# コンパイルして実行
app = workflow.compile()
result = app.invoke(PipelineState())
print(result.final_report)
利点
- 予測可能、監査可能、再試行可能
- 並列実行による高速化をサポート
- エンジニアリング水準が高く、運用に優しい
欠点
- プロセスを事前に設計する必要があり、柔軟性が低い
- 予期しない状況への対応が難しい
- オーケストレーションフレームワークの学習が必要
横断的な比較と選択方法
6つのアーキテクチャを複数の観点から比較し、最適な選択肢を素早く見つけるのに役立つ。
| アーキテクチャ | 自律性 | 予測可能性 | 並列能力 | 適したタスク複雑度 | 代表的な実装 |
|---|---|---|---|---|---|
| 単一Agentループ | 高 | 低 | 无 | 中低 | Claude Code デフォルトモード |
| プランニング + 実行 | 中 | 中 | 部分的 | 中高 | Claude Code Plan Mode |
| マルチAgent協調 | 高 | 低 | 强 | 高 | AutoGen, CrewAI |
| 自己反省 / 自己修正 | 中 | 中 | 无 | 中 | Reflexion, Self-Refine |
| RAG + Agent | 高 | 中 | 无 | 中高 | LangChain RAG Agent |
| ワークフローオーケストレーション | 低 | 高 | 强 | 高(固定フロー) | LangGraph, Prefect |
よくある組み合わせパターン
実際の本番システムでは通常、複数のアーキテクチャを組み合わせて使用する。以下は成熟した組み合わせパターンである:
ワークフローオーケストレーション + マルチAgent:DAGでメインフローを定義し、各ノード内部は独立したAgentである。例えばCI/CDパイプラインでは、コードチェックノードはCode Review Agent、セキュリティスキャンノードはSecurity Agentである。:DAG を使用してメインフローを定義し、各ノードの内部は独立した Agent です。例えば、CI/CD パイプラインでは、コードチェックノードは Code Review Agent、セキュリティスキャンノードは Security Agent です。
マルチエージェント + RAG: 複数のSubagentが同じベクトル知識ベースを共有し、各々がサブタスクに応じて必要に応じて検索します。例えば、カスタマーサービスシステムでは、注文照会Agentと返金処理Agentが同じ知識ベースを照会しますが、異なる内容を検索します。
計画実行 + 反省: まず計画してから実行しますが、各ステップの実行後に反省のプロセスを追加して品質を確保します。品質要求が極めて高いタスクに適しています。
どこから始めればよいかわからない場合は、シングルエージェントループから始めてください。それが最も実装とデバッグが簡単です。コンテキストウィンドウが足りないことに気づいたら、マルチエージェントを検討してください。品質保証が必要な場合は、反省レイヤーを追加してください。プロセスが安定してきたら、信頼性を高めるためにDAGにリファクタリングしてください。
よくある誤解
誤解その1: アーキテクチャは複雑なほど良い
マルチエージェントの連携は強力に見えますが、タスクがシングルエージェントループで5ステップ以内に完了するなら、オーケストレーションのオーバーヘッドを導入すると逆に効率が低下します。原則: 要件を満たす最もシンプルなアーキテクチャを使用する。
誤解その2: 反省は必ず品質を向上させる
自己反省の有効性はモデルの自己評価能力に依存します。品質要求が非常に厳しい場合は、Criticモデルの使用や外部検証(コードの自動テストなど)の導入を検討してください。
誤解その3: DAGワークフローにエージェントは不要
DAGはプロセスの骨格を定義しますが、各ノード内部は依然としてエージェント呼び出しにできます。ワークフローオーケストレーションとエージェント機能は排他的ではなく、補完的です——DAGは信頼性を提供し、エージェントは柔軟性を提供します。
誤解その4: コンテキストウィンドウが大きくなればRAGは不要
モデルが1Mトークンのコンテキストウィンドウをサポートしていても、すべてのドキュメントを詰め込むのは最適な方法ではありません。RAGの価値は「収容できる」ことだけでなく、さらに精密な検索——ノイズを減らし、推論コストを下げ、回答の正確性を高めることです。
まとめ
6つのエージェントアーキテクチャは、高度に自律的から高度に制御可能までの完全なスペクトルをカバーしています。
アーキテクチャを選択する際の核となる考慮事項は次の2つだけです:想定外の状況に対応するために必要な柔軟性の大きさ、および結果の信頼性を保証するために必要な確実性の大きさ。
シンプルに始め、本当に必要なときにのみ複雑さを追加する。これがエージェントアーキテクチャ選定の第一原則です。
その他の拡張