Expressions régulières -Introduction
Une expression régulière (regex ou regexp en abrégé) est un puissant outil de traitement de texte. Elle utilise une chaîne spéciale pour décrire et faire correspondre une série de chaînes qui obéissent à une certaine règle syntaxique.
Vous pouvez le considérer comme unsuper joker. Les jokers ordinaires (tels que*représentant n'importe quel caractère) ont des fonctionnalités limitées, tandis que les expressions régulières peuvent définir des modèles de texte extrêmement complexes et précis, de la simple correspondance de mots à l'extraction complexe de données structurées—presque n'importe quoi.
Par exemple, vous utilisez probablement?et*des jokers pour trouver des fichiers sur votre disque dur.?Le joker correspond à 0 ou 1 caractère dans un nom de fichier, tandis que le*joker correspond à zéro ou plusieurs caractères. Un modèle commedata(\w)?\.dattrouvera les fichiers suivants :
En utilisant le*caractère au lieu du?caractère, le nombre de fichiers trouvés augmente.data.*\.datIl correspond à tous les fichiers suivants :
Bien que cette méthode de recherche soit utile, elle reste limitée. En comprenant comment*les caractères génériques fonctionnent, les concepts sur lesquels reposent les expressions régulières sont introduits, mais les expressions régulières sont plus puissantes et plus flexibles.
L'utilisation d'expressions régulières permet d'obtenir des fonctionnalités puissantes de manière simple. Voici un exemple simple :
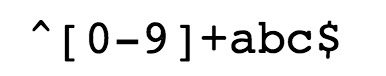
-
^Correspond au début de la chaîne d'entrée.
-
[0-9]+Correspond à plusieurs chiffres,[0-9]correspond à un seul chiffre,+correspond à un ou plusieurs.
-
abc$Correspond à la lettreabcet se termine parabcfin,$correspond à la fin de la chaîne d'entrée.
Lors de l'écriture d'un formulaire d'inscription utilisateur, si nous n'autorisons les noms d'utilisateur à contenir quedes caractères, des chiffres, des traits de soulignement et des tirets -, et si nous définissons la longueur du nom d'utilisateur, nous pouvons utiliser l'expression régulière suivante pour le définir.
^[a-zA-Z0-9_-]{3,15}$
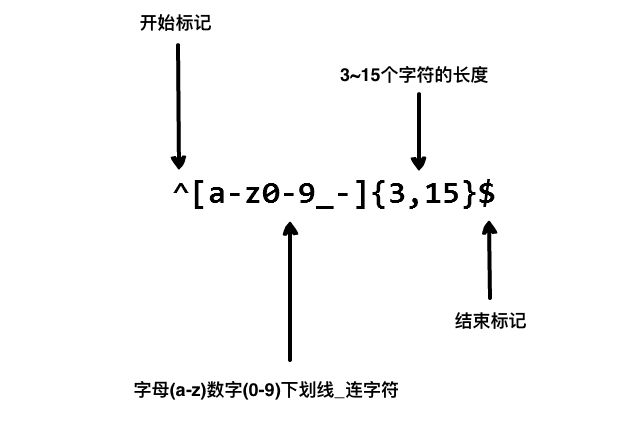
^Correspond au début de la chaîne.[a-zA-Z0-9_-]Indique un jeu de caractères contenant des lettres minuscules, des lettres majuscules, des chiffres, des traits de soulignement et des tirets-。{3,15}Indique que le jeu de caractères précédent doit apparaître au moins 3 fois et au plus 15 fois, limitant ainsi la longueur du nom d'utilisateur entre 3 et 15 caractères.$Correspond à la fin de la chaîne.
L'expression régulière ci-dessus peut correspondre àexample、example1、run-oob、run_oob, mais ne correspond pas àrucar il contient des lettres trop courtes—moins de 3 caractères—, donc il ne peut pas correspondre. Elle ne correspond pas non plus àexample$, car il contient des caractères spéciaux.

Exemple
Correspond aux chaînes qui commencent par un chiffre et se terminent par "abc".:
Le texte marqué ci-dessous est l'expression qui a obtenu la correspondance :
Essayez-le »
Métacaractères et fonctionnalités des expressions régulières
Correspondance de caractères
- Caractères ordinaires : les caractères ordinaires sont mis en correspondance littéralement. Par exemple, faire correspondre la lettre "a" correspondra au caractère "a" dans le texte.
- Métacaractères : les métacaractères ont des significations spéciales. Par exemple,
\dcorrespond à n'importe quel chiffre,\wcorrespond à n'importe quel caractère alphanumérique,.correspond à n'importe quel caractère (sauf le saut de ligne), etc.
Quantificateurs
*: Correspond au motif précédent zéro fois ou plus.+: Correspond au motif précédent une fois ou plus.?: Correspond au motif précédent zéro ou une fois.{n}: Correspond au motif précédent exactement n fois.{n,}: Correspond au motif précédent au moins n fois.{n,m}: Correspond au motif précédent au moins n fois et pas plus de m fois.
Classes de caractères
[ ]: Correspond à un caractère quelconque à l'intérieur des crochets. Par exemple,[abc]correspond aux caractères "a", "b" ou "c".[^ ]: Correspond à n'importe quel caractère sauf ceux entre crochets. Par exemple,[^abc]correspond à n'importe quel caractère sauf "a", "b" ou "c".
Correspondance de limites
^: Correspond au début de la chaîne.$: Correspond à la fin de la chaîne.\b: Correspond à une limite de mot.\B: Correspond à une limite de non-mot.
Groupement et capture
( ): Utilisé pour regrouper et capturer des sous-expressions.(?: ): Utilisé pour regrouper sans capturer les sous-expressions.
Caractères spéciaux
\: Caractère d'échappement, utilisé pour faire correspondre le caractère spécial lui-même..: Correspond à n'importe quel caractère (sauf le saut de ligne).|: Utilisé pour spécifier un choix parmi plusieurs motifs.
Définition et utilisations des expressions régulières
Techniquement, une expression régulière est une chaîne composée de caractères ordinaires (comme les lettres a à z) et de caractères spéciaux (appelés métacaractères). Cette chaîne constitue unmotif de recherche, qui est utilisé pour rechercher, faire correspondre, remplacer ou fractionner du texte.
Utilisations principales
Les expressions régulières ont trois utilisations principales :
- Recherche et correspondance de texte: Déterminer rapidement si un texte contient une sous-chaîne conforme à un motif spécifique. Par exemple, vérifier si une chaîne est au format valide d'une adresse e-mail.
- Remplacement de texte: Remplacer toutes les parties du texte qui correspondent à un motif spécifique par un nouveau contenu. Par exemple, remplacer tous les formats de date d'un document de
YYYY-MM-DDuniformément àMM/DD/YYYY。 - Extraction et découpage de texte: Extraire précisément les parties qui nous intéressent d'un grand texte, ou découper le texte en un tableau selon des délimiteurs spécifiques. Par exemple, extraire toutes les adresses IP d'un fichier journal, ou découper une chaîne CSV avec des virgules.
Scénarios d'application des expressions régulières
Les expressions régulières imprègnent presque tous les aspects de la programmation et du traitement de texte quotidien. Voici quelques-uns des scénarios d'application les plus courants :
1. Validation des données
Il s'agit de l'une des applications les plus classiques des expressions régulières, garantissant que la saisie de l'utilisateur est conforme au format attendu.
- Validation des adresses e-mail: Vérifier si l'entrée ressemble à
username@domain.com。 - Validation des numéros de téléphone: Vérifier s'il est conforme au format de numéro de téléphone mobile du pays/de la région (comme le numéro à 11 chiffres de la Chine).
- Validation de la robustesse des mots de passe: Exiger que les mots de passe contiennent des lettres majuscules et minuscules, des chiffres et des caractères spéciaux.
- Validation des formats de date: S'assurer que la date est dans des formats valides tels que
2023-12-25ou12/25/2023. - Validation des numéros de carte d'identité: Faire correspondre les numéros de carte d'identité qui sont conformes à des règles d'encodage spécifiques.
2. Recherche et filtrage de texte
Localiser rapidement des informations dans de grandes quantités de texte.
- Analyse des journaux: Rechercher dans les journaux du serveur tous les enregistrements à l'
ERRORouWARNniveau. - Recherche de code: Dans un IDE ou un éditeur, utiliser des expressions régulières pour rechercher toutes les définitions de fonctions (telles que
function xxx(...)) ou des noms de variables spécifiques. - Recherche de contenu dans un document: Trouver toutes les occurrences de numéros de téléphone ou d'URL dans un long document.
3. Remplacement et nettoyage de texte
Modifier en lot le contenu textuel pour le normaliser.
- Formatage des données: Formater les numéros de téléphone à partir de
12345678901à123-4567-8901。 - Nettoyage des données: Supprimer les caractères d'espacement superflus d'un texte (comme plusieurs espaces ou tabulations consécutifs).
- Masquage des informations sensibles: Remplacer les numéros de carte d'identité dans le texte par
***, tel que110101199001011234->110101********1234。 - Refactorisation du code: Renommer en lot des variables ou des noms de fonctions.
4. Extraction et analyse de texte
Extraire des données structurées à partir d'un texte non structuré.
- Robots d'exploration web: Extraire tous les liens du code HTML (
href="...") ou l'adresse d'une image (src="...")。 - Analyser un fichier de configuration: lire
key = valueun fichier de configuration au format de. - Extraire des données spécifiques: extraire toutes les occurrences de montants d'un texte (comme
¥100.50ou$99.99)。
5. Découpage de chaînes
Utiliser des règles complexes, et non un simple caractère, pour découper des chaînes.
- Divisez une phrase en utilisant un ou plusieurs espaces, des virgules ou des points-virgules.
- En fonction de différents délimiteurs (tels que
,、;、\t) pour analyser des données CSV ou TSV.
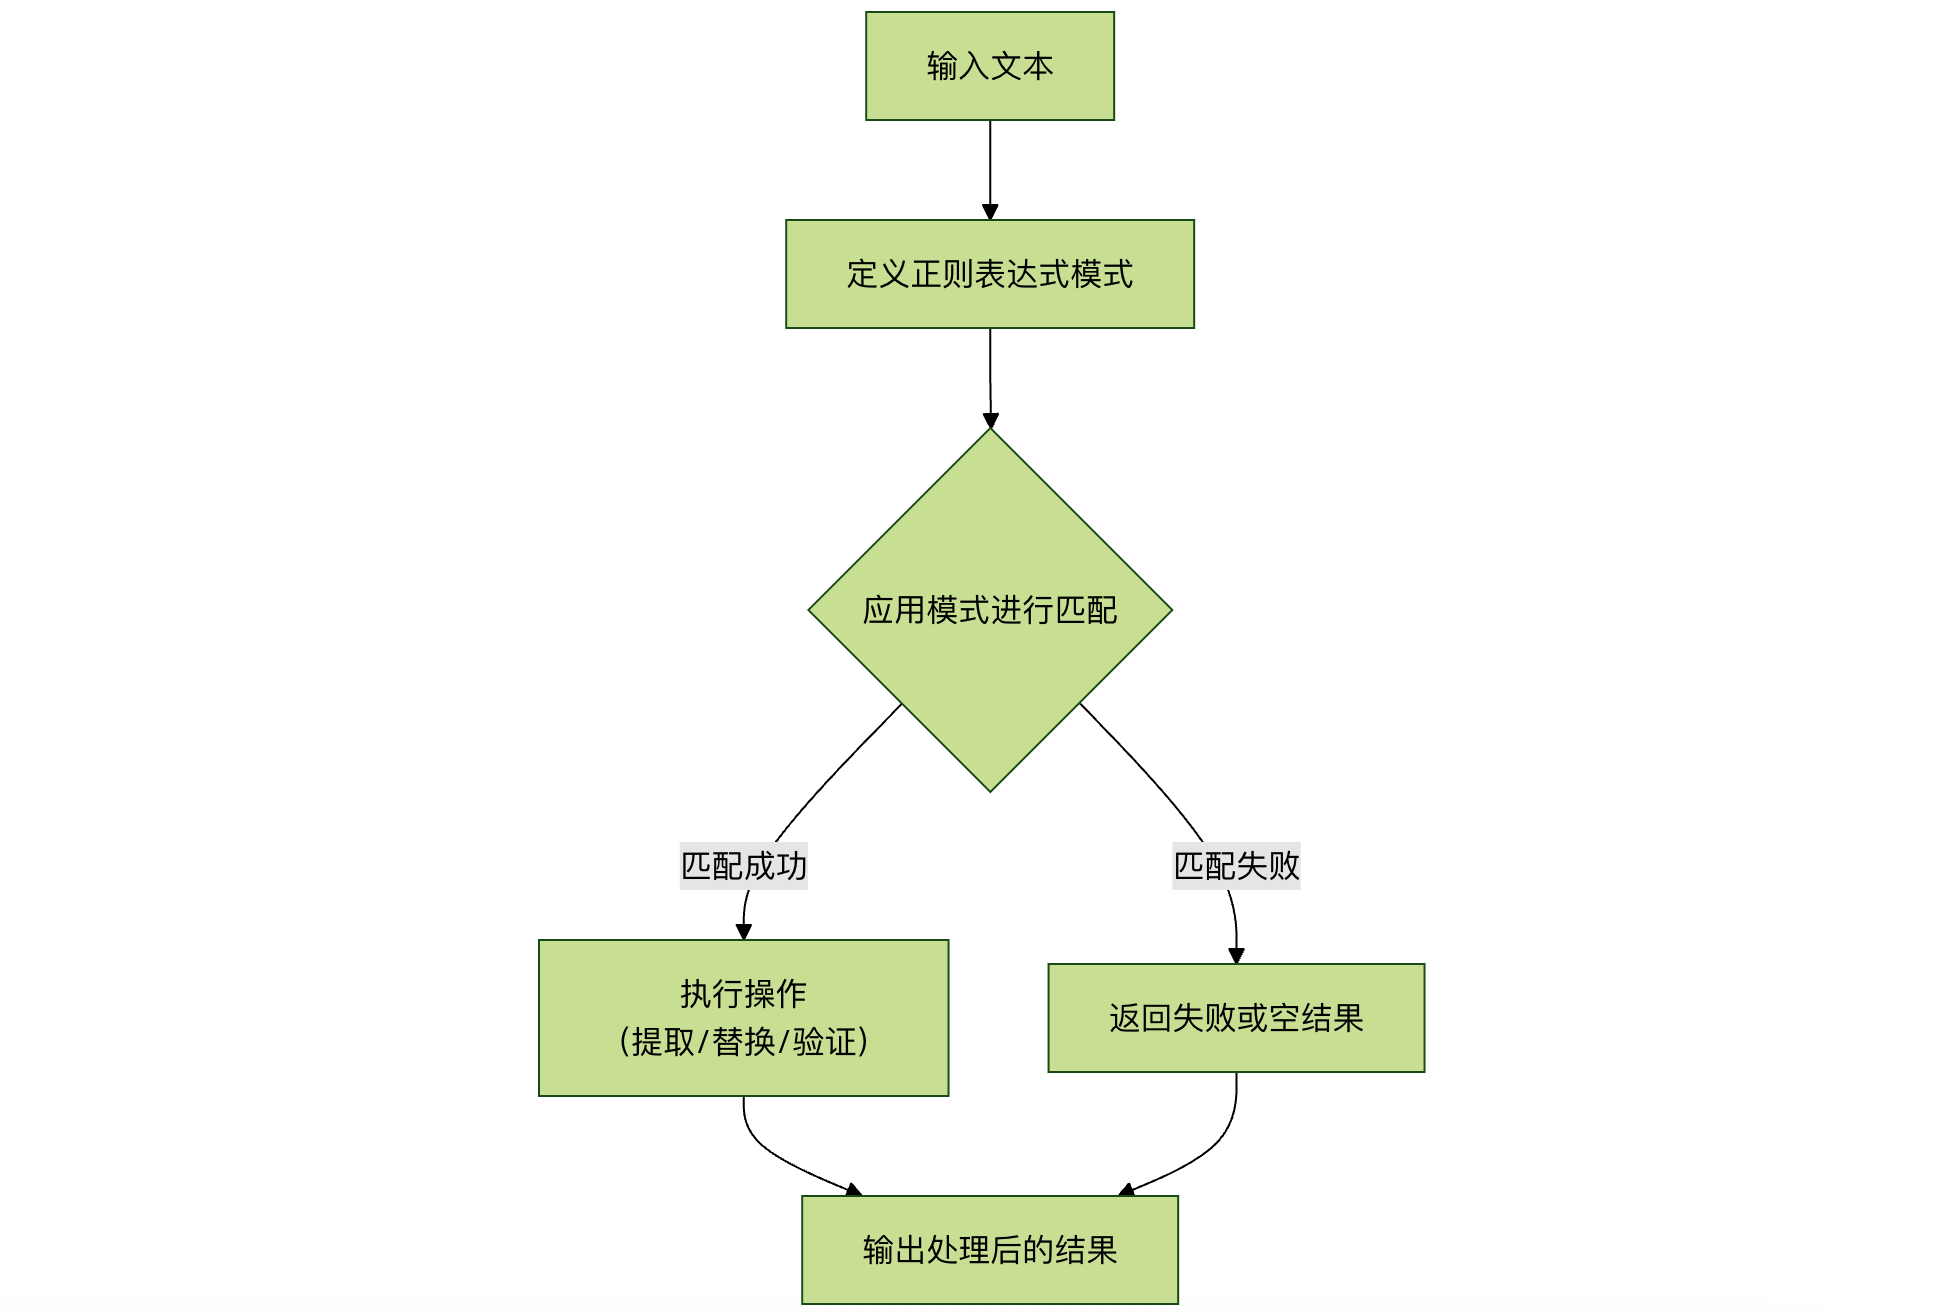
L'organigramme suivant résume le flux de travail essentiel des expressions régulières dans le traitement des données :
Historique du développement
Les origines des expressions régulières remontent aux premières recherches sur le fonctionnement du système nerveux humain. Warren McCulloch et Walter Pitts, deux neurophysiologistes, ont développé une méthode mathématique pour décrire ces réseaux neuronaux.
En 1951, un mathématicien nommé Stephen Kleene, s'appuyant sur les premiers travaux de McCulloch et Pitts, a publié un article intitulé « Representation of Events in Nerve Nets », introduisant le concept d'expressions régulières. Les expressions régulières sont des expressions utilisées pour décrire ce qu'il appelaitl'algèbre des ensembles réguliers, d'où l'adoption du termeexpression régulière.
Par la suite, il a été découvert que ces travaux pouvaient être appliqués à certaines recherches précoces utilisant les algorithmes de recherche informatique de Ken Thompson. Ken Thompson était l'un des principaux inventeurs d'Unix. La première application pratique des expressions régulières a été l'éditeur grep d'Unix.
L'historique approximatif du développement est le suivant :
1951 : Stephen Kleene, l'un des fondateurs de la théorie de la calculabilité et informaticien américain, a proposé pour la première fois le concept de langages réguliers et a utilisé des méthodes formelles pour décrire ce langage. Cela a posé les fondements théoriques du développement des expressions régulières.
Années 1960 : Ken Thompson, l'un des cofondateurs du système d'exploitation Unix, a développé le premier programme à appliquer réellement les expressions régulières, qui faisait partie de la commande grep d'Unix. Cela a marqué l'application pratique des expressions régulières.
Années 1970 : Ken Thompson et Rob Pike ont développé le premier moteur d'expressions régulières, largement utilisé dans les systèmes Unix, qui a joué un rôle clé dans la popularisation des expressions régulières.
1986 : Philip Hazel a développé la bibliothèque PCRE (Perl Compatible Regular Expressions), une bibliothèque d'expressions régulières qui permet d'utiliser des expressions régulières de style Perl dans différents langages de programmation.
1997 : l'IEEE a publié la norme POSIX.2, qui inclut la spécification standard des expressions régulières, rendant le comportement des expressions régulières plus cohérent entre différents systèmes Unix.
Après les années 2000 : les expressions régulières sont devenues de plus en plus populaires dans la programmation informatique et le traitement de texte. Les langages de programmation et les outils prenant en charge les expressions régulières sont devenus plus riches et plus puissants, comme Perl, Python, Java, JavaScript, etc.
Actuellement : les expressions régulières restent un outil important pour le traitement de texte et l'extraction de données, avec de larges applications dans des domaines tels que la science des données, l'analyse de texte, les robots d'exploration web, la recherche et le remplacement de chaînes, etc.
Domaines d'application
Actuellement, les expressions régulières sont largement utilisées dans de nombreux systèmes logiciels, notamment *nix (Linux, Unix, etc.), HP et d'autres systèmes d'exploitation, des environnements de développement tels que PHP, C#, Java, ainsi que de nombreux logiciels applicatifs ; on trouve des traces d'expressions régulières partout.
Expressions régulières C#
Dans notre tutoriel C#,Expressions régulières C#ce chapitre est consacré à la présentation des connaissances sur les expressions régulières C#.
Expressions régulières Java
Dans notre tutoriel Java,Expressions régulières Javace chapitre est consacré à la présentation des connaissances sur les expressions régulières Java.
Expressions régulières en JavaScript
Dans notre tutoriel JavaScript,Objet RegExp JavaScriptce chapitre est consacré à la présentation des connaissances sur les expressions régulières JavaScript, et nous fournissons également uneRéférence de l'objet RegExp JavaScript。
Expressions régulières Python
Dans notre tutoriel de base Python,Expressions régulières Pythonce chapitre est consacré à la présentation des connaissances sur les expressions régulières Python.
Expressions régulières Ruby
Dans notre tutoriel Ruby,Expressions régulières Rubyce chapitre est consacré à l'introduction des connaissances sur les expressions régulières Ruby.
| Commande ou environnement | . | [ ] | ^ | $ | \( \) | \{ \} | ? | + | | | ( ) |
| vi | √ | √ | √ | √ | √ | |||||
| Visual C++ | √ | √ | √ | √ | √ | |||||
| awk | √ | √ | √ | √ | awk prend en charge cette syntaxe ; ajoutez simplement le paramètre --posix ou --re-interval sur la ligne de commande. Voir l'expression d'intervalle dans man awk. | √ | √ | √ | √ | |
| sed | √ | √ | √ | √ | √ | √ | ||||
| delphi | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| python | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ |
| java | √ | √ | √ | √ | √ | √ | √ | √ | √ | √ |
| javascript | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| php | √ | √ | √ | √ | √ | |||||
| perl | √ | √ | √ | √ | √ | √ | √ | √ | √ | |
| C# | √ | √ | √ | √ | √ | √ | √ | √ |
Ce qui suit est une comparaison de la prise en charge des expressions régulières dans les principaux langages de programmation :
| Langage de programmation | Méthode de prise en charge | Classes/modules courants | Exemple simple (correspondance de chiffres) |
|---|---|---|---|
| JavaScript | Prise en charge de la langue maternelle | RegExpobjet, ou en utilisant un littéral/.../ |
/\d+/ounew RegExp("\\d+") |
| Python | Bibliothèque standardreModule |
reModule |
re.compile(r"\d+") |
| Java | Bibliothèque standardjava.util.regexPaquet |
PatternetMatcherClasse |
Pattern.compile("\\d+") |
| PHP | Fonctions PCRE intégrées | preg_série de fonctions (telles quepreg_match) |
preg_match("/\d+/", $text) |
| C# | System.Text.RegularExpressionsnamespace |
RegexClasse |
new Regex(@"\d+") |
| Go | Bibliothèque standardregexpPaquet |
regexpPaquet |
regexp.MustCompile(\d+) |
| Ruby | Prise en charge de la langue maternelle, classe principale | RegexpClasse |
/\d+/ |