Expression régulière -Syntaxe
Une expression régulière est un outil puissant pour faire correspondre et manipuler du texte. Elle se compose de caractères ordinaires et de caractères spéciaux (appelés « métacaractères ») et sert à décrire les motifs de texte à mettre en correspondance.
Les expressions régulières peuvent être utilisées pour rechercher, remplacer, extraire et valider des motifs spécifiques dans du texte.
Par exemple :
runoo+b, peut correspondre àexample、runooob、runoooooobetc.,+Le signe indique que le caractère précédent doit apparaître au moins une fois (1 fois ou plus)。
runoo*b, peut correspondre àrunob、example、runoooooobetc.,*Le signe indique que le caractère précédent peut ne pas apparaître, ou apparaître une fois ou plusieurs fois (0 fois, ou 1 fois, ou plusieurs fois)。
colou?rpeut correspondre àcoloroucolour,?Le point d'interrogation indique que le caractère précédent peut apparaître au plus une fois (0 ou 1 fois)。
La méthode de construction des expressions régulières est la même que celle de la création d'expressions mathématiques — en combinant de petites expressions avec divers métacaractères et opérateurs, vous pouvez créer des expressions plus grandes. Les composants d'une expression régulière peuvent être un caractère unique, un ensemble de caractères, une plage de caractères, un choix entre des caractères, ou toute combinaison de tous ces composants.
En tant que modèle, une expression régulière fait correspondre un certain motif de caractères à la chaîne recherchée.
Caractères ordinaires
Les caractères ordinaires incluent tous les caractères imprimables et non imprimables qui ne sont pas explicitement désignés comme métacaractères, y compris toutes les lettres majuscules et minuscules, tous les chiffres, tous les signes de ponctuation et certains autres symboles.
| Caractère | Description | Exemple |
|---|---|---|
| [ABC] | Correspond à[...]tous les caractères listés dans .... Par exemple,[aeiou]Correspond à toutes les lettres e, o, u et a dans la chaîne "google example taobao". 
|
|
| [^ABC] | Correspond à tous les caractères sauf[...]tous les caractères autres que ceux dans .... Par exemple,[^aeiou]Correspond à tous les caractères de la chaîne "google example taobao" sauf les lettres e, o, u et a. 
|
|
| [A-Z] | [A-Z] représente une plage et correspond à toutes les lettres majuscules ; [a-z] correspond à toutes les lettres minuscules ; [0-9] correspond à tous les chiffres. 
|
|
| . | Correspond à tout caractère unique sauf les caractères de nouvelle ligne (\n, \r), équivalent à [^\n\r]. 
|
|
| [\s\S] | Correspond à tous les caractères (y compris les caractères de nouvelle ligne).\sCorrespond à tous les caractères d'espacement (y compris les sauts de ligne),\SCorrespond à tous les caractères non blancs (à l'exclusion des sauts de ligne) ; la combinaison des deux peut correspondre à n'importe quel caractère. 
|
|
| \w | Correspond aux lettres, aux chiffres et aux traits de soulignement, équivalent à [A-Za-z0-9_]. 
|
|
| \d | Correspond à tout chiffre arabe (0 à 9), équivalent à[0-9]。 
|
Outils de test
Modificateurs :
[0-9]+
Texte correspondant :
123abc456edf789
Caractères non imprimables
Les caractères non imprimables peuvent également être des composants d'expressions régulières. Le tableau suivant répertorie les séquences d'échappement qui représentent des caractères non imprimables :
| Caractère | Description |
|---|---|
| \cx | Correspond à un caractère de contrôle désigné par x. Par exemple, \cM correspond à un Control-M ou à un retour chariot. La valeur de x doit être l'une de A-Z ou a-z ; sinon, c est traité comme un caractère 'c' littéral. |
| \f | Correspond à un saut de page, équivalent à \x0c et \cL. |
| \n | Correspond à un caractère de nouvelle ligne, équivalent à \x0a et \cJ. |
| \r | Correspond à un retour chariot, équivalent à \x0d et \cM. |
| \s | Correspond à tout caractère d'espace blanc, y compris l'espace, la tabulation, le saut de page, etc., équivalent à [ \f\n\r\t\v]. Notez que les expressions régulières Unicode correspondent aussi aux caractères d'espace pleine largeur. |
| \S | Correspond à tout caractère autre qu'un espace blanc, équivalent à [^ \f\n\r\t\v]. |
| \t | Correspond à un caractère de tabulation, équivalent à \x09 et \cI. |
| \v | Correspond à un caractère de tabulation verticale, équivalent à \x0b et \cK. |
Caractères spéciaux
Les caractères dits spéciaux sont des caractères ayant une signification particulière, comme celui mentionné ci-dessusrunoo*bdans le*, signifiant « n'importe quel nombre de caractères ».*Si vous voulez trouver le ... dans une chaîne*symbole lui-même, il est alors nécessaire de\l'échapper en ajoutant une barre oblique inversée devant luiruno\*ob, c'est-à-direruno*ob。
correspond à la chaîne\avant eux. Le tableau suivant répertorie les caractères spéciaux dans les expressions régulières :
| Caractères spéciaux | Description |
|---|---|
| $ | Correspond à la position de fin de la chaîne d'entrée. Si la propriété Multiline de l'objet RegExp est définie, $ correspond aussi à '\n' ou '\r'. Pour faire correspondre le caractère $ lui-même, utilisez \$. |
| ( ) | Marque les positions de début et de fin d'une sous-expression. La sous-expression peut être capturée pour une utilisation ultérieure. Pour faire correspondre ces caractères, utilisez \( et \). |
| * | Correspond à la sous-expression précédente zéro ou plusieurs fois. Pour faire correspondre le caractère * lui-même, utilisez \*. |
| + | Correspond à la sous-expression précédente une ou plusieurs fois. Pour faire correspondre le caractère + lui-même, utilisez \+. |
| . | Correspond à n'importe quel caractère unique sauf le caractère de nouvelle ligne \n. Pour faire correspondre . lui-même, utilisez \. |
| [ | Marque le début d'une expression entre crochets. Pour faire correspondre [, utilisez \[. |
| ? | Correspond à la sous-expression précédente zéro ou une fois, ou indique un quantificateur non gourmand. Pour faire correspondre le caractère ? lui-même, utilisez \?. |
| \ | Marque le caractère suivant comme un caractère spécial, un caractère littéral, une rétroréférence ou un échappement octal. Par exemple, 'n' correspond au caractère 'n' ; '\n' correspond à une nouvelle ligne ; '\\' correspond à "\" ; '\(' correspond à "(". |
| ^ | Correspond à la position de début de la chaîne d'entrée. Lorsqu'il est utilisé dans une expression entre crochets, il indique que le jeu de caractères à l'intérieur des crochets n'est pas accepté (négation). Pour faire correspondre le caractère ^ lui-même, utilisez \^. |
| { | Marque le début d'une expression de quantificateur. Pour faire correspondre {, utilisez \{. |
| | | Indique un choix entre deux éléments. Pour faire correspondre |, utilisez \|. |
Quantificateurs
Les quantificateurs spécifient combien de fois un composant donné d'une expression régulière doit apparaître pour qu'une correspondance soit satisfaite. Il y a*、+、?、{n}、{n,}、{n,m}6 types au total.
| Caractère | Description | Exemple |
|---|---|---|
| * | Correspond à la sous-expression précédente zéro ou plusieurs fois. Par exemple,zo*peut correspondre à"z"et"zoo"。*équivalent à{0,}。 | Essayez-le » |
| + | Correspond à la sous-expression précédente une ou plusieurs fois. Par exemple,zo+peut correspondre à"zo"et"zoo", mais ne peut pas correspondre à"z"。+équivalent à{1,}。 | Essayez-le » |
| ? | Correspond à la sous-expression précédente zéro ou une fois. Par exemple,do(es)?peut correspondre à"do"et"does", mais ne peut pas correspondre à"dog"。?équivalent à{0,1}。 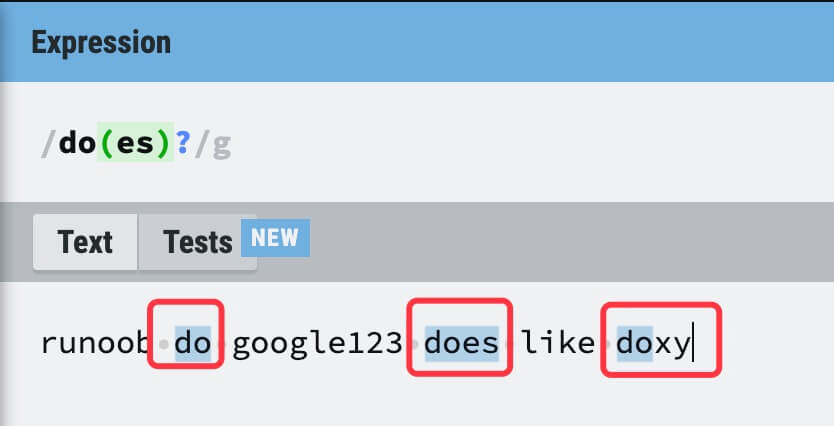 |
Essayez-le » |
| {n} | n est un entier non négatif, correspondant exactement n fois. Par exemple,o{2}ne peut pas correspondre à"Bob"le o dans ..., mais peut correspondre à"food"les deux o dans ... | Essayez-le » |
| {n,} | n est un entier non négatif, correspondant au moins n fois. Par exemple,o{2,}ne peut pas correspondre à"Bob"le o dans ..., mais peut correspondre à"foooood"tous les o dans ...o{1,}équivalent ào+,o{0,}équivalent ào*。 | Essayez-le » |
| {n,m} | m et n sont tous deux des entiers non négatifs, où n <= m. Correspond au moins n fois et au plus m fois. Par exemple,o{1,3}correspondra à"fooooood"les trois premiers o dans ...o{0,1}équivalent ào?. Remarque : il ne doit y avoir aucun espace entre la virgule et les deux nombres. | Essayez-le » |
L'expression régulière suivante correspond à un entier positif,[1-9]garantit que le premier chiffre n'est pas 0,[0-9]*représente un nombre quelconque de chiffres :
/[1-9][0-9]*/
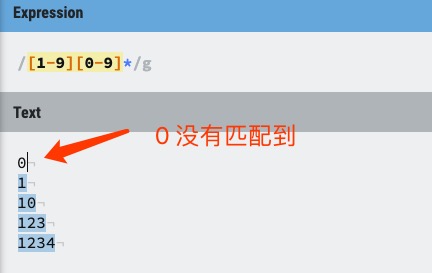
Veuillez noter que le quantificateur vient après l'expression de plage, donc il s'applique à l'expression de plage entière, qui dans ce cas ne spécifie que les chiffres de 0 à 9 (y compris 0 et 9).
Le quantificateur + n'est pas utilisé ici, car un chiffre n'est pas nécessairement requis dans la deuxième position ou les suivantes. Le caractère ? n'est pas non plus utilisé, car utiliser ? limiterait l'entier à seulement deux chiffres.
Si vous souhaitez faire correspondre des nombres à deux chiffres de 0 à 99, vous pouvez utiliser l'expression suivante pour spécifier au moins un chiffre et au plus deux chiffres :
/[0-9]{1,2}/
L'expression ci-dessus présente un inconvénient : elle ne peut correspondre qu'à des nombres de deux chiffres au maximum, et elle correspondra à des valeurs inattendues telles que 0 et 00. Après amélioration, l'expression pour faire correspondre des entiers positifs de 1 à 99 est la suivante :
/[1-9][0-9]?/
ou
/[1-9][0-9]{0,1}/
*et+Les quantificateurs sont gourmands, car ils correspondent au plus de texte possible. Ajoutez un?après eux pour obtenir une correspondance non gourmande ou minimale.
Par exemple, vous pourriez rechercher dans un document HTML le contenu à l'intérieur des balises h1. Le code HTML est le suivant :
<h1>EXAMPLE-Example</h1>
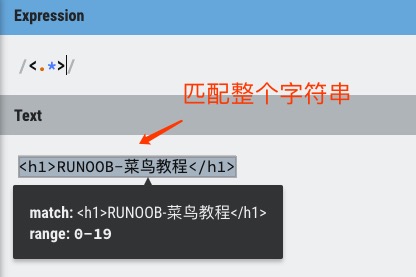
Gourmand :L'expression suivante correspond à tout ce qui se trouve entre le signe inférieur d'ouverture (<) et le signe supérieur de fermeture (>) de la balise h1 :
/<.*>/
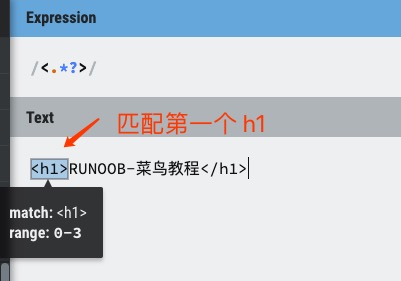
Non gourmand :Si vous avez seulement besoin de faire correspondre les balises h1 d'ouverture et de fermeture, l'expression non gourmande suivante ne correspond qu'à <h1> :
/<.*?>/
Vous pouvez également utiliser l'expression régulière suivante pour faire correspondre les balises h1 :
/<\w+?>/
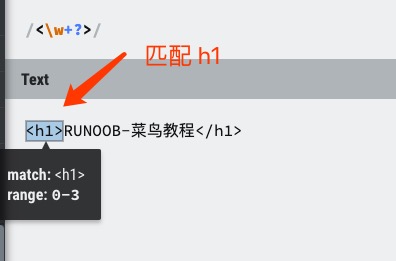
En plaçant*、+ou?après le quantificateur?, l'expression passe de « gourmande » à « non gourmande » (correspondance minimale).
Ancres
Les ancres permettent de fixer une expression régulière au début ou à la fin d'une ligne, et peuvent aussi décrire les positions limites d'un mot.
^et$font respectivement référence au début et à la fin d'une chaîne.\bdécrivent la limite de début ou de fin d'un mot,\Breprésente une limite de non-mot.
| Caractère | Description | Exemple |
|---|---|---|
| ^ | Correspond au début de la chaîne d'entrée. Si la propriété Multiline de l'objet RegExp est définie, ^ correspond aussi aux positions après \n ou \r. | Essayez-le » |
| $ | Correspond à la fin de la chaîne d'entrée. Si la propriété Multiline de l'objet RegExp est définie, $ correspond aussi aux positions avant \n ou \r. | Essayez-le » |
| \b | Correspond à une limite de mot, c'est-à-dire la position entre un mot et un espace. | Essayez-le » |
| \B | Correspond à une limite non-mot, c'est-à-dire une position qui n'est ni au début ni à la fin d'un mot. | Essayez-le » |
Remarque :Les quantificateurs ne peuvent pas être utilisés avec des ancres. Comme il ne peut pas y avoir plus d'une position immédiatement avant ou après un saut de ligne ou une limite de mot, les expressions telles que^*ne sont pas autorisées.
Pour faire correspondre du texte au début d'une ligne de texte, utilisez le caractère^au début de l'expression régulière. Veillez à ne pas^confondre cette utilisation avec l'utilisation de la négation à l'intérieur des expressions entre crochets.
Pour faire correspondre la fin d'une ligne de texte, utilisez le caractère$à la fin de l'expression régulière.
Pour utiliser des ancres lors de la recherche de titres de section, l'expression régulière suivante correspond à un titre de section qui ne contient que deux chiffres à la fin et apparaît au début d'une ligne :
/^Chapter [1-9][0-9]{0,1}/
Un véritable titre de section n'apparaît pas seulement au début d'une ligne, mais est également le seul texte sur cette ligne. L'expression suivante, en ancrant à la fois le début et la fin de la ligne, garantit que la correspondance spécifiée ne correspond qu'aux titres de section et non aux références croisées :
/^Chapter [1-9][0-9]{0,1}$/
Les limites de mot peuvent contrôler précisément la portée de la correspondance. L'expression suivante correspond aux trois premiers caractères du mot Chapter, car ces trois caractères apparaissent après une limite de mot :
/\bCha/
\bLa position est très importante : lorsqu'elle est au début d'une chaîne, elle trouve une correspondance au début d'un mot ; lorsqu'elle est à la fin d'une chaîne, elle trouve une correspondance à la fin d'un mot. Par exemple, l'expression suivante correspond à la chaîne ter dans le mot Chapter, car elle apparaît avant une limite de mot :
/ter\b/
L'expression suivante correspond à la chaîne apt dans Chapter, mais ne correspond pas à apt dans aptitude :
/\Bapt/
La chaîne apt apparaît à une limite de non-mot dans le mot Chapter, mais apparaît à une limite de mot dans le mot aptitude. Pour l'\Bopérateur de limite de non-mot, il ne peut pas correspondre au début ni à la fin d'un mot, donc l'expression suivante ne correspond pas à Cha dans Chapter :
/\BCha/
Alternance
Utilisez des parenthèses()pour encadrer toutes les alternatives, et séparez les alternatives adjacentes avec||.
()Indique un groupe de capture,()qui enregistre la valeur correspondante dans chaque groupe. Plusieurs valeurs correspondantes peuvent être consultées via le nombre n (n est un chiffre représentant le contenu du n-ième groupe de capture).
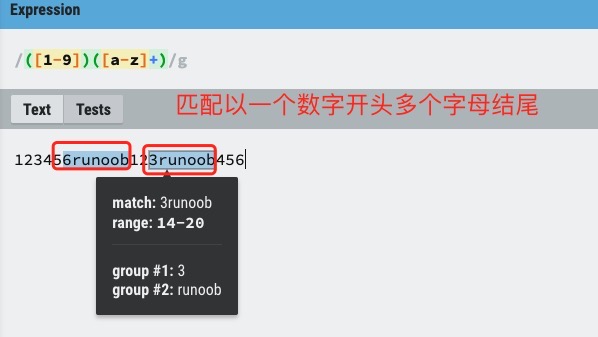
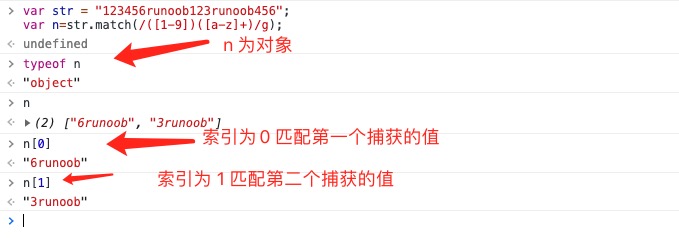
L'utilisation de parenthèses a un effet secondaire : le contenu correspondant associé sera mis en cache (capturé). Si la capture n'est pas nécessaire, vous pouvez utiliser?:avant la première alternative pour éliminer cet effet secondaire. À ce stade, les parenthèses sont utilisées uniquement pour le regroupement et ne stockent pas le contenu correspondant.
Où?:est l'un des métacaractères non capturants, et les deux autres métacaractères non capturants sont?=et?!: le premier est un lookahead positif, qui correspond à la chaîne de recherche à toute position où le modèle d'expression régulière à l'intérieur des parenthèses commence à correspondre ; le second est un lookahead négatif, qui correspond à la chaîne de recherche à toute position où ce modèle d'expression régulière ne commence pas à correspondre.
Différences d'utilisation de ?=, ?<=, ?!, ?<!
exp1(?=exp2): Trouver exp1 avant exp2 (lookahead positif).
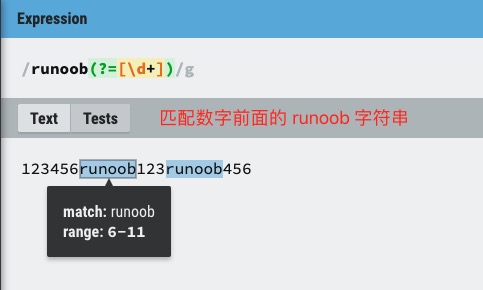
(?<=exp2)exp1: Trouver exp1 après exp2 (lookbehind positif).
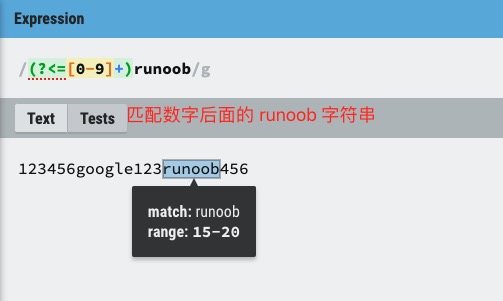
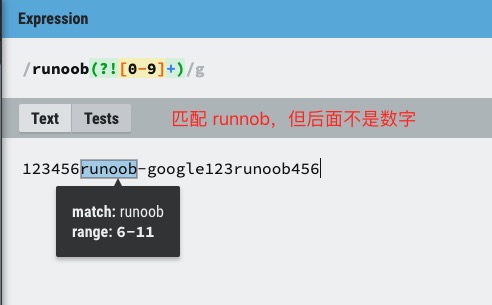
exp1(?!exp2): Trouver exp1 qui n'est pas suivi par exp2 (lookahead négatif).
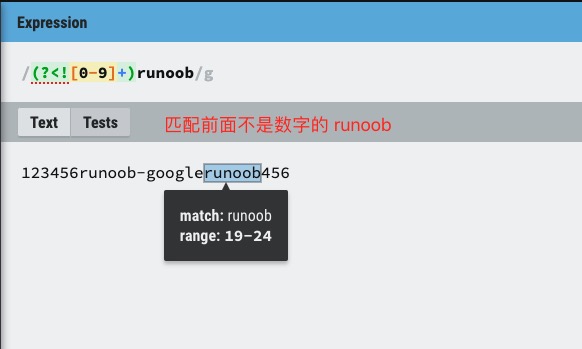
(?<!exp2)exp1: Trouver exp1 qui n'est pas précédé par exp2 (lookbehind négatif).
Pour plus d'informations, voir :Assertions lookahead et lookbehind dans les expressions régulières
Références arrière
L'ajout de parenthèses autour d'un motif d'expression régulière ou d'une partie d'un motif fait que la correspondance associée est stockée dans un tampon temporaire. Chaque sous-correspondance capturée est stockée dans l'ordre dans lequel elle apparaît de gauche à droite dans le motif d'expression régulière. Les numéros de tampon commencent à 1, et jusqu'à 99 sous-expressions capturées peuvent être stockées. Chaque tampon est accessible à l'aide de\noù n est un nombre décimal à un ou deux chiffres qui identifie un tampon spécifique.
Vous pouvez utiliser le métacaractère non capturant?:、?=ou?!pour réécrire la capture, en ignorant l'enregistrement de la correspondance associée.
L'une des applications les plus simples et les plus utiles des références arrière consiste à trouver deux mots adjacents identiques dans un texte. Prenons la phrase suivante comme exemple :
Is is the cost of of gasoline going up up?
La phrase ci-dessus contient plusieurs mots répétés. L'expression régulière suivante utilise une seule sous-expression pour localiser ces doublons :
Exemple
Trouver les mots répétés :
var patt1 = /\b([a-z]+) \1\b/igm;
document.write(str.match(patt1));
Essayez-le »
L'expression capturée[a-z]+correspond à une ou plusieurs lettres. La deuxième partie de l'expression régulière\1est une référence arrière à la première sous-correspondance (le contenu capturé entre parenthèses), exigeant que le même mot que le premier mot suive immédiatement.
Le métacaractère de limite de mot\bgarantit que seuls des mots entiers sont détectés ; sinon, des phrases telles que "is issued" ou "this is" ne seront pas correctement identifiées.
À la fin de l'expression, l'optiong(global) spécifie que l'expression est appliquée à toutes les correspondances trouvées dans la chaîne d'entrée ; l'optioni(ignore case) spécifie une correspondance insensible à la casse ;mL'option (multiline) spécifie que les correspondances potentielles peuvent apparaître de chaque côté d'un saut de ligne.
Les références arrière peuvent également décomposer un URI en ses composants. Supposons que vous souhaitiez décomposer l'URI suivant en protocole (ftp, http, etc.), adresse de domaine et chemin :
https://www.example.com:80/html/html-tutorial.html
L'expression régulière suivante fournit cette fonctionnalité :
Exemple
Afficher toutes les données correspondantes :
var patt1 = /(\w+):\/\/([^/:]+)(:\d*)?([^# ]*)/;
arr = str.match(patt1);
for (var i = 0; i < arr.longueur; i++) {
document.write(arr[i]);
document.write("<br>");
}
Essayez-le »
str.match(patt1)Renvoie un tableau contenant 5 éléments : l'indice 0 correspond à la chaîne correspondante entière, les indices 1 à 4 correspondent aux groupes de capture entre parenthèses respectifs, et ainsi de suite.
- La première sous-expression entre parenthèses(\w+) : capture la partie protocole de l'adresse web, en faisant correspondre tout mot avant les deux-points et les deux barres obliques. Résultat :https
- La deuxième sous-expression entre parenthèses([^/:]+) : capture la partie correspondant à l'adresse du domaine, correspondant à un ou plusieurs caractères qui ne sont ni : ni /. Résultat :www.example.com
- La troisième sous-expression entre parenthèses(:\d*) : capture le numéro de port (le cas échéant), correspondant à zéro ou plusieurs chiffres après les deux-points. Résultat ::80
- La quatrième sous-expression entre parenthèses([^# ]*) : capture le chemin et les informations de page, correspondant à toute séquence de caractères qui ne comprend ni # ni espaces. Résultat :/html/html-tutorial.html